专题:中国国际服务贸易交易会 物理AI与具身智能机器人创新生态交流会
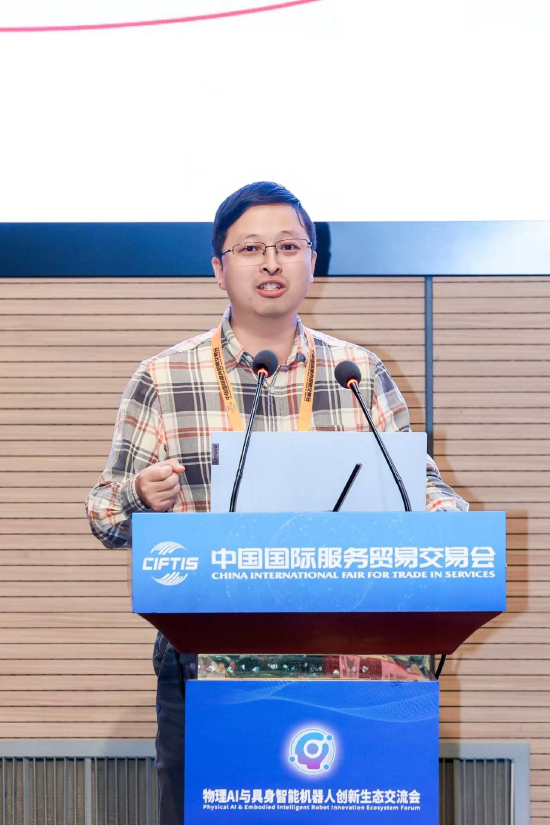
服贸会专题活动“物理AI与具身智能机器人创新生态交流会”于2026年9月11日在京举办。影身智能创始人兼CEO闵伟出席并演讲。
以下为演讲实录:
闵伟:尊敬的张峰书记,尊敬的各位领导、各位来宾、各位企业家、各位媒体朋友,大家上午好。
我今天给大家带来的演讲题目是《共建原生4D世界模型,迈向通用物理智能》,我觉得咱们主办方安排得非常好,第一个演讲讲的是本体,第二个马上就到模型了。
我先解释一下,我们想要做的这个模型是一个原生4D的世界模型,未来做4D呢?4D是三维的空间+一维的时间,其实是符合第一性原理的,因为我们所在的物理世界是四维的,它是三维的空间+一维的时间。我们讲的具身AI,或者通用的物理智能,核心要有一个基座,这个基座一定是四维的,其他的触觉、听觉,各种摩擦,它本质上是四维时空组合的一个物理的现象,我们只需要对最基础的四维时空做重建、理解、生成和预测,就能够得到一个4D的基座,承载更多的物理规律。
从历史上看每一次关键的技术变革都是数据推动的,我们看最早的imageNet,因为海量数据的打标,第一次实现了标注的图片从1万量级到100万这个量级,100倍的跃升,带来了整个人工智能的起点。后面到一维的大语言模型、二维的视频生成模型,都是解决了海量数据的问题。因为大语言模型是解决了无标注的问题,二维是因为互联网上已经有海量的视频了,到4D时代,进入物理世界,最大的挑战是什么呢?我们是缺4D数据的,目前对于机器人来讲为什么我们的机器人经过3年的发展还在马拉松的赛场上没有真正进入生活、进入工厂、进入到大家真正需要它干活的地方,最主要的原因是因为它缺乏泛化能力。泛化能力我们理解最核心的关键点是数据,我们的机器人在4D的世界里面,训练它用的是一维的语言和二维的视频,但是它干活需要处理的信息是四维的,这也是我们特别关注的一点,为什么我们人有这么好的泛化能力?我们理解人是用4D数据来训练的。
现有整个行业4D数据是非常稀缺的,整个行业4D数据有Demo演示的,包括最近半年特别火的生成式数据、无标注的数据,它的核心还是以视频为主,以人工标注的作业的4D的数据集,但是非常的稀缺,整个行业只有1500小时。另外还有仿真和虚拟的数据,这个数据它有一个Sim2Real GAP的行业难题很难解决。
我们对数据的看法,从今天开始整个数据行业比数据的采集来讲更重要的是数据的演练。采集是劳动密集型行业,在自动驾驶时代我们已经经历过了,海量的车在上面跑需要标注,海量数据收集回来。在具身智能时代比数据的采集更重要的一点是什么呢?是数据的演练能力,从海量的各种视频也好,或者是语言也好,低维的数据里面如何抽取演练出高维的信息,这是当前更重要的一点。所以我们现在提出了我们自己要通过模型的能力来演练出高维的数据,这一点也特别赞同前一位演讲者提到的,要用大模型去解决问题,所以我们自己提出了环绕多视角、稀疏视角的数据采集和演练,通过在一个场景架几个摄像头,然后实现无切入的采集,进一步降低成本,比一个生成数据的成本会更低。因为采集真实数据如果需要人员佩戴头环设备,就要向佩戴头环人员支付费用。第二个做多视角的对齐,最后我们把物理信息通过模型做一个演练,像中国的稀土一样。我们中国的稀土,全世界都有稀土,但是演练能力最好的是中国。数据也是一样,数据在全世界任何一个地方都能够采集,但是对于数据来说,最核心的是数据的演练和复刻的能力。
4D数据的优势就是一条完整的4D数据可以当作一次物理实验,那么它信息的丰富度大大超过用语言或者视频的。一个二维的图片或视频数据,那么记录的内容是像素和轨迹,对于模型来讲,它自己要升维、要理解,非常困难,但对我们人来说很容易,你看一个视频很快能在你的大脑中复原这个视频到底怎么回事儿,模型是很困难的。所以我们采集4D数据能够更好的记录几何空间、几何结构、遮挡关系、接触过程,相当于是完整的物理实验。
今天是来到了首钢园,我们放了一个首钢园的光场数据,也是今年春晚的时候刘浩存跳舞,这个节目叫《梦底》,它是4D数据非常好的在生活中的应用,用4D数据做了分身,就在首钢园。
这个的主要问题是什么呢?这个奢侈品,采集设备需要80个摄像头,需要巨大的算力。为了解决这个问题,相当于在封建社会去炼钢,产量很低。刚好咱们在首钢,也是炼钢的高炉,我们做了一个技术能够去工业化,大规模的把数据4D化。我们现在已经做到了用6个摄像头就可以实现4D数据的采集和演练。首钢的高炉,我们把类似于封建社会的手工的小作坊做到大规模工业化生产,4D数据采集做了4D直播的Demo,就在服贸会的12号馆,欢迎大家去看。
第二个是模型,我们对模型的理解是?具身的模型是什么?是新一代适配具身的基座。具身的话,上一位嘉宾也讲了我们现在有很多开源的模型,为什么大家开源了呢?开源的意思就是这个东西还不成熟,只能够发布出来让全世界一起去测试去完善,不成熟的本质原因是什么?本质原因我觉得只有一条,没有针对具身的基座。现有的两个路线,第一个VLA,它的基座是大语言模型。
最近关注新闻大家可以看到GPT6以后,网上有人说VLA已死,为什么呢?你会发现GPT6就是最好的VLA。基座能力已经把VLA的能力覆盖掉了。第二个就是今年特别火的WAM,WAM的基座是视频生成模型,因为基座能力的提升带来了模型整体能力的提升,所以今年基于视频生成的世界模型的概念特别火。但我们想要说的是针对具身应该是4D的基座,基于对物理世界的理解,而不是视频的生成,因为我们所在的世界不是由像素组成的,是由4D分子运动的点云组成的。
我们做了一个实验,这个是Seedance2.5,目前是字节最新发布的一个视频生成模型。我们做了一个实验,发现让它生成一个非常简单的系鞋带的视频,一头一尾是对的,中间各种步骤都是错的。目前预训练最充分、性能最强的2D视频模型也难以建模精细的、灵巧的操作任务,本质上是对底层的理解是有巨大的问题的。
今年上半年整个学术界也纷纷向3D、4D方向转,出了很多3D、4D的文章。这里有一篇比较有代表性的,是李飞飞的PointWorld,也是通过4D的点云来作为技术的表征,但是没有解决海量的4D数据怎么来的问题。我们自己是有一个方法论的,我们做4D世界模型分4步:重建、理解、生成和预测,通过4D的重建实现4D的理解,通过理解实现生成,然后能够补齐各种没有看到的视角。非常有意思的是,这两天李飞飞发了一个Atlas,里面提到了Next Token变成了下一个视角的预测,和我们的想法不谋而合。
我们通过4D的数据建立一个4D的基座,最终实现超长的泛化,实现对世界的因果的理解,最终去理解物理规律。我们之前基于视频或者基于语言的基座,他们最大的问题就是,模范学会了不等于理解了。最近有一个相当火的技术,也是最近半年一个生成的数据或物理数据特别重大的成果就是ICL上下文学习。它把原文理解的泛化变成了更多信息的模仿,我们的目标是用更少的收入实现更多的泛化实现更底层的理解。
最后就是我们需要一条能够形成贯穿数据、模型与机器人的训练闭环,通过多视角的采集实现4D的重建,实现物理信息的复现,在最后真机执行落到现实场景里去。这是我们最近做的Demo,能够实现一张图片+多视角的收入+一句话实现4D的生成。
这个是另外一个Demo,一句话和一张图片生成6个视角的视频,加一个稠密的点云。
这是我们和其他家单纯做视频生成的对比,与单纯的视频生成的对比来说,因为我们同步生成了稠密的点云,所以能更好地保持时空的一致性,解决了视频生成的幻觉问题。这个是我们很有意思的Demo,我们让进入生活,做了一个切辣椒,只需要输入一句话加一张图片,能够生成6个视角的视频和一个稠密的点云,实现毫米级的精度,准确的展现出切辣椒这个日常生活中常见的动作。
因为我们做这些行业,所以我们做了一个系鞋带。
在目的方面,我们选择了双柔性物体操作,开展柔性生产环节里柔性物体的操作,第一个行业是制鞋。另外我们还有一个数字娱乐的赛道,源头赛道:一套底座、两条航道、一个飞轮。相比于两年前我们刚创业的时候选择4D这条路线,今年整个行业也快速地向我们靠拢,特别是World Labs发布了Atlas,国内也有头部大厂在大力开发空间视频生成模型。
这个地方我们是划了一个二维的坐标图,两条轴,第一条轴是横轴,我觉得整个行业的发展都会从低维到高维,从一维的语言到二维的视频,到真实的4D。纵轴是规模化交付,从演示到规模化进入真实世界,真正创造生产力。对于行业来讲,我们觉得4D具身破局的关键是四件事情:数据、模型、真实场景、规模化交付。
下一阶段,我们会继续做4D数据的规模化采集,迭代原生的世界模型,并且在服装鞋帽数据飞轮、数字娱乐的数据飞轮转起来之后进入到更多的场景。
所以我们的理念是原生4D模型将成为与大语言模型、视频生成模型并列的下一代的基座。
最后邀请与会的各位,我们一起来共建一个生态,就在石景山,我们站在石景山的潮头,我们将开放4D采集、数据演练与基座模型能力,邀请大家一起共建物理阵容的世界基座。
谢谢大家!