让计算机在智力测验和下棋上达到成人水平相对容易,让它拥有一岁孩子的感知与行动能力,却难得多。
这是1988年机器人学家汉斯·莫拉维克作出的经典论断。事实也的确如此,时隔近半个世纪后,大模型已经能写代码、解奥数题,莫拉维克悖论依旧横在机器人面前。
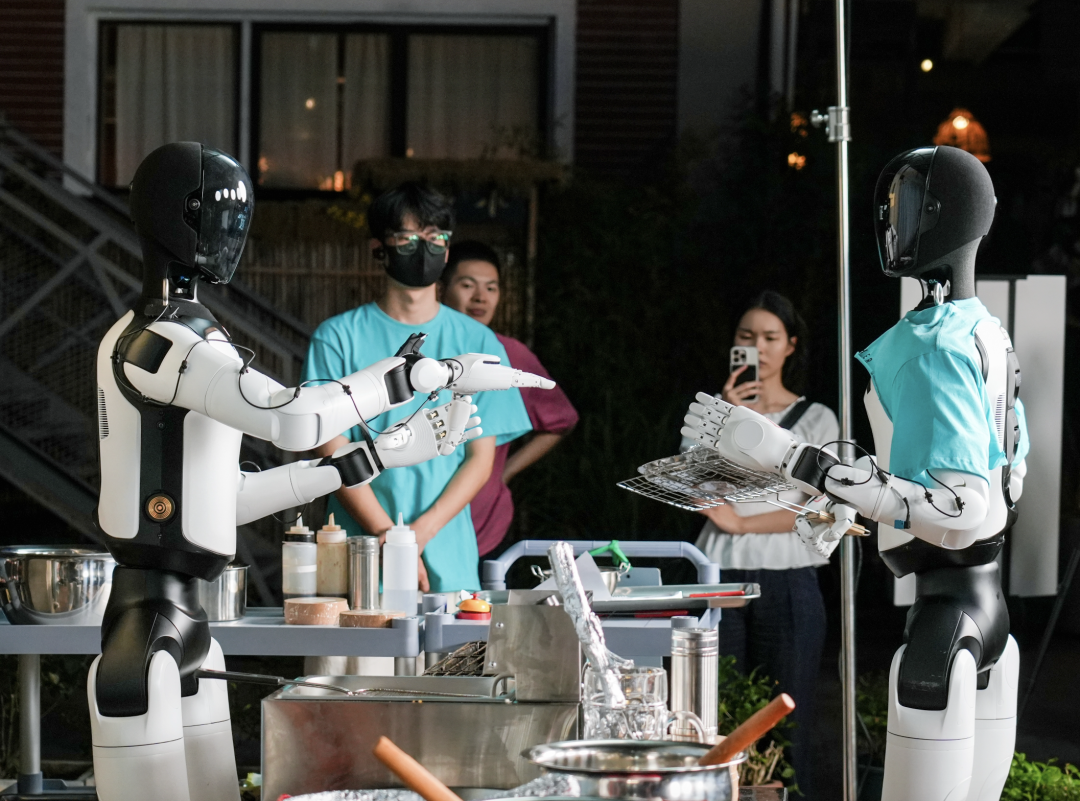
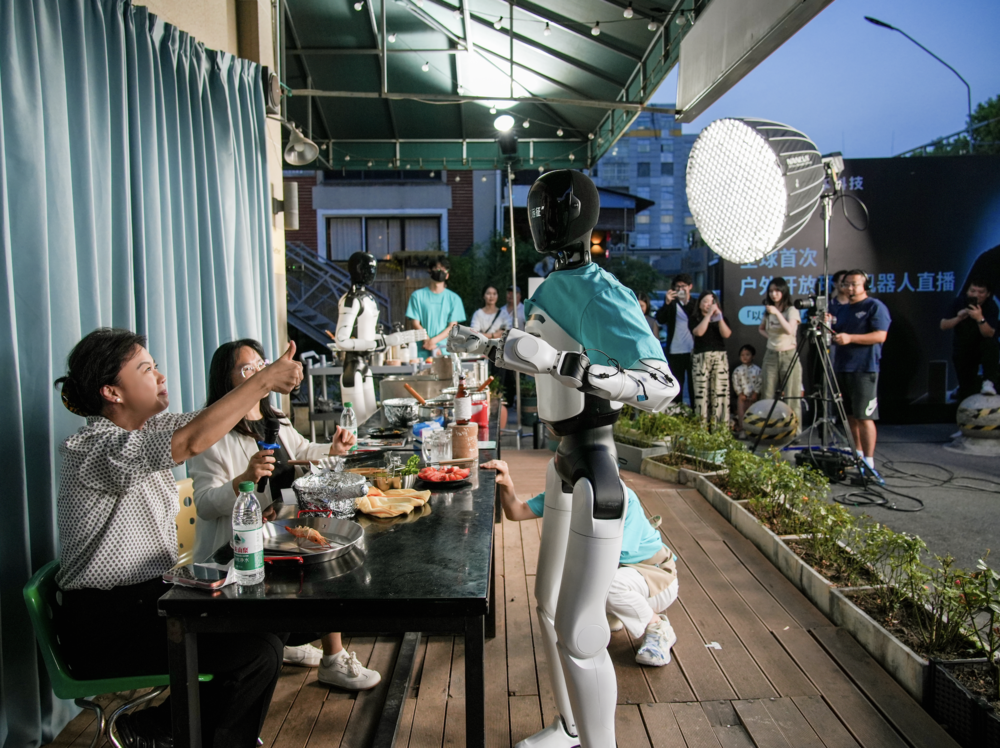
人类习以为常的生活,仍有大量机器难以独立完成的工作。9月16日,乐享科技把这道题搬到了一个户外烧烤摊,接受现场“拷打”。
不同品牌的具身机器人搭载了以太大模型,六位嘉宾两两一组陆续上台与不同个性的机器人互动,可以临时改变需求、挪动物品,打乱原有安排,在线上超550万观众及现场超近30位行业媒体的见证下,机器人从点单、任务规划、烧烤到上菜,全程自主完成。
时间点,很耐人寻味。8月底,以太大模型已经在室内Demo中展示跨本体协作、自主寻找和使用工具、被打断后继续前序任务等能力,在业内引发热议。而在几天前,OpenAI首席科学家Jakub Pachocki在长文《An Alien Mind》里描绘的一种能自我改进、越来越难被人类完全理解的机器心智,恰恰与乐享科技此前公开的技术理念和落地模型高度吻合。
理论推演与现场实践之间,还有多远?这场直播,就是乐享给出的回答。
一顿烧烤:从Demo到现实要走多远
让具身机器人接管一个烧烤摊,需要交出去的判断,比动作多得多。
烧烤对摊主来说近乎本能。嘴上应着客人,余光扫一眼炭火,肉边一卷就顺手挪到炉边。换成具身机器人,从接单到上菜,每一步都可能出现计划之外的变化。但无论是面对场景的变化还是人物的变化,以太大模型在本场直播中的表现都堪称精彩。
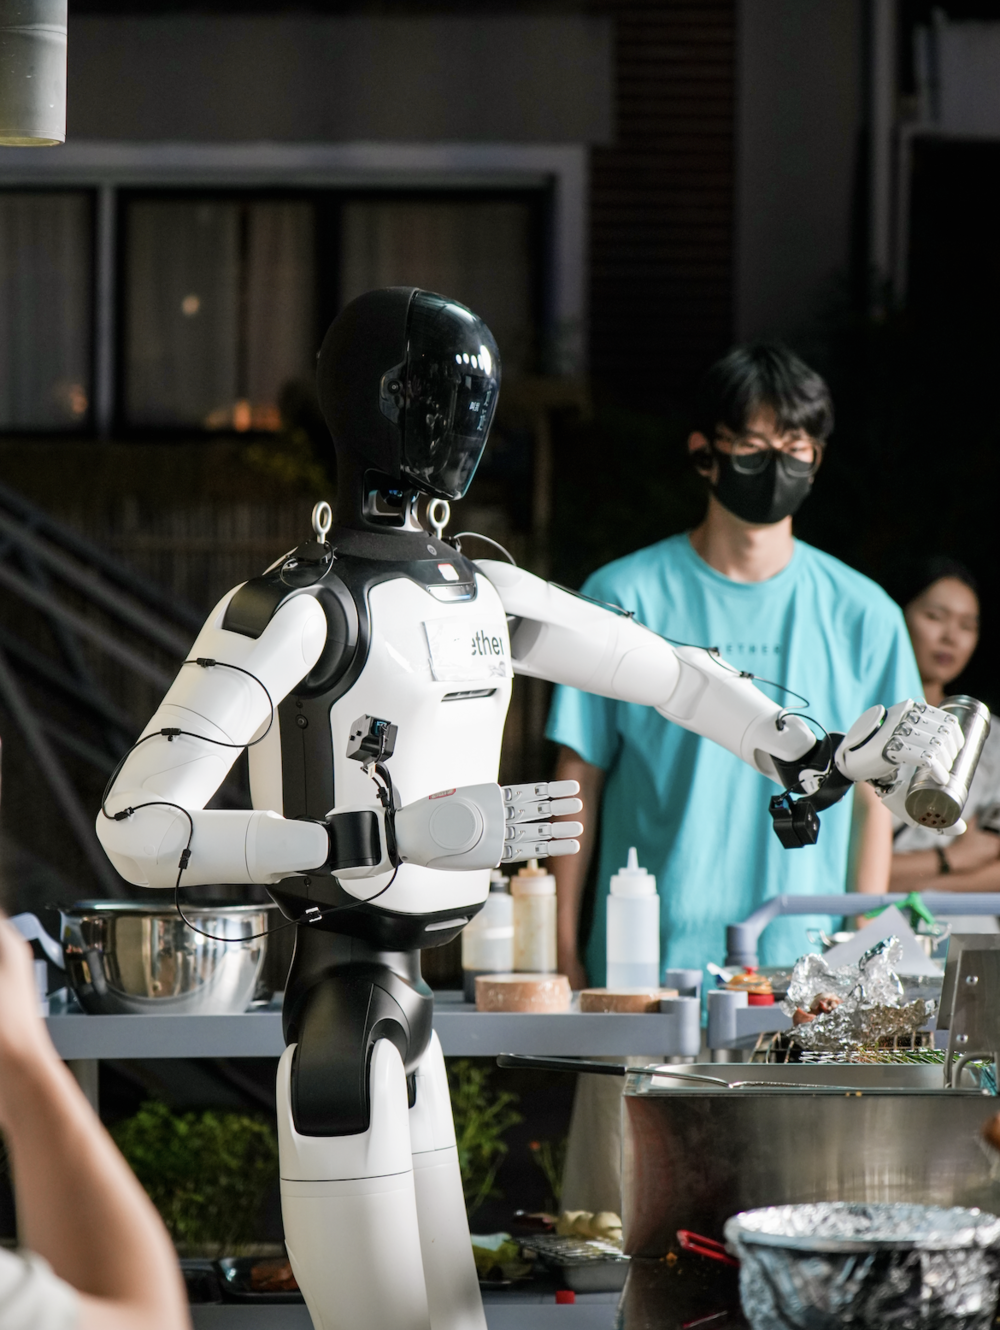
突然改变位置的盘子、从未见过的调料瓶,这场直播一开始便给以太大模型出了走进真实世界需要面对的第一道难题:面对非标准、不可预测的物理环境,一个具备连续任务、自我进化的具身大模型应当给出怎样的反馈?
在直播中可以看到,搭载以太大模型的机器人不仅在判断盘子位置之后及时改变了伸手的方向和抓取的姿态,面对从未见过的调料瓶,它更能在两次抓取的尝试中及时从物理世界中总结经验,调整动作,最终通过自主学习完成指定动作。
人的变化同样是一大考验。
顾客渴了需要马上喝水,机器人暂时放下手头上菜的工作,从桌上拿起一瓶水递给对方,随后继续完成手上的工作。面对客人突然的夸奖,以太大模型也能让机器人回馈比心点赞的肢体动作,带去超高的情绪价值。
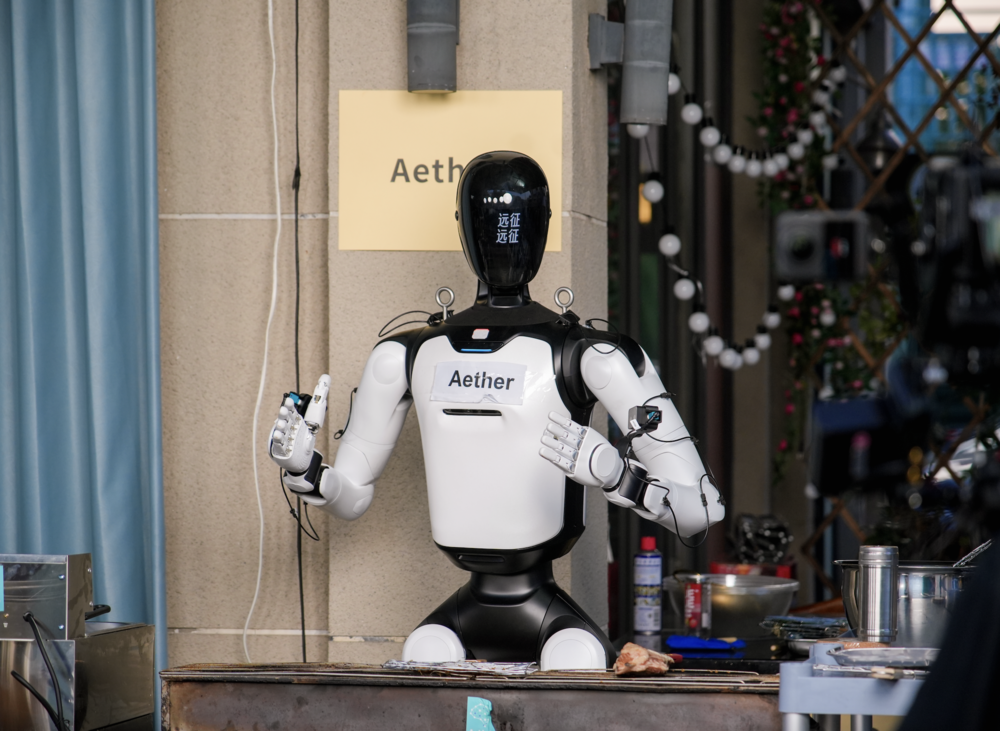
在这场长达一个多小时的直播当中,无论是面对周围环境的突然变化,还是顾客不断新增的诉求,以太大模型很好地跨本体协调了两台机器人的配合与交接,也在长时序任务的断点续做能力上,交出来了一份令人惊喜的答卷。
行业里几条主流技术路线,在这张烤架前各有长短。视觉-语言-动作模型(VLA)看到画面、听到指令就直接给出动作,反应快。可它的“会做”建立在“见过”之上,陌生的火候和肉形很容易让它失手,长流程里的小偏差还会一路累积。
世界动作模型(WAM)先在内部预演接下来的画面,再倒推动作,想得更远,计算量却很大,难以跟上烤架前的瞬息变化。
两条路线都擅长回答“下一步做什么”,却缺少一套自己发现问题并及时调整规划的办法。这个缺口在演示视频里很难被看见,镜头往往只留下成功的那一次。到了开放环境,它会一再暴露出来。
行业的惯常解法是继续堆数据,效果却有限。开放环境里,没见过的情况才是常态。烧烤摊上的变量组合近乎无穷,靠数据穷举,这笔账算不过来。数据能让机器人见得更多,却教不会它在没见过的时候该怎么办。
乐享的Physical AI走的是另一条路。它的核心是一套能量驱动的架构,让机器人从感知到动作控制,再到物理反馈,始终处在一个连续的闭环里。
乐享用一小时的公开直播,把这个过程直接呈现出来。观众可以沿着一张订单,看机器人怎样处理变化,花了多少时间,是否需要帮助,直到食物端上桌。
这种考法对乐享自己并不友好。实验室可以挑出最好的一次结果,直播里出的每个错都会被看见。敢这样安排,说明乐享想让外界看的,已经超出了机器人能不能把活干完,它更想展示机器人在复杂多变的环境中自行发现问题,重新规划,并继续执行的过程。
OpenAI还在推演的心智,被“放上”了烤架
乐享能接下这道题,源于它一开始问的就是另一个问题。
行业主流的思路,是把大模型在数字世界里的能力塞进机器人里。先让它听懂、看懂,再把理解翻译成动作。模型要回答的,是“下一步做什么”。乐享更在意的,是让机器人,在真实世界里,能很正的“做个人”
去年3月,乐享组建了一支约20人的模型团队,回头去看生物是怎么学会行动的。人类有语言之前,早已能躲避危险、控制身体。更早的单细胞生物既没有视觉,也没有语言,行动照样在发生,驱动它的是能量。
乐享由此得出一个判断:语言未必是机器人学会动作的关键。在语言模型最强势的年份,这个判断显得有些逆流而上。它动的是整个系统的地基。今天多数具身方案仍以语言模型为底座,换掉这一层,意味着从感知到控制都要重新设计。
而以太大模型此后的设计,都是从这个判断出发的。
乐享有句颇具挑衅意味的口号:“机器人的ChatGPT时刻,就是要放弃ChatGPT。”这句话背后的思路,是回退“语言”的价值。常见的具身智能模型思路,还是把用户的指令交给语言模型拆成文字步骤,再翻译成关节动作。
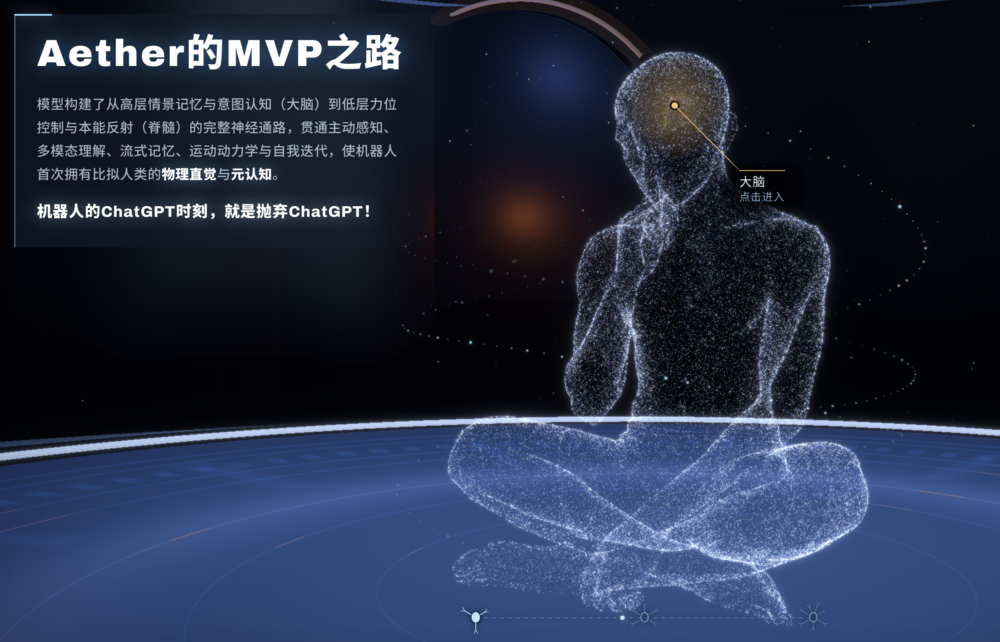
然而,文字描述不了火候,也描述不了一块肉在夹子里滑动的手感,每翻译一次,关于物理世界的信息就丢掉一些。以太大模型的路径,是让语言只停留在人机交互的入口,让视觉和力觉这些信号直接进入模型,动作由模型原生生成。
模型的决策方式随之改变。以太大模型不直接预测下一个动作。任务进行到哪一步,动作是否合乎物理规律,和此前的记忆是否一致,眼下有几分把握,这些考量被折算进同一套“能量”计算。机器人每一步都朝能量更低的方向走,也就离目标更近一点。
对比来说,VLA在找“最像训练数据的动作”,WAM在找“最相关的画面”,以太大模型在找“最接近目标的动作”。三者的差别,在一切顺利时很难看出来。计划一旦被打乱,只会比对“像不像”的模型容易无所适从;而始终记着目标的模型,还留有重新找路的余地。
支撑这套决策的,是一条从大脑通到脊髓的神经通路。乐享参照人脑分区来组织模型,上层负责判断和规划,中间管记忆与感知,最靠近硬件的脊髓层处理力控和本能反射。信息在模型里双向流动,上层的判断指挥身体,身体碰到的阻力和偏差也会反过来改变判断。
放到烤架前,以太大模型的差异性,的确有了很好的表现。
直播里,订单被改变、流程被打断时,依旧能继续。以太大模型只记住影响决策的东西。它不会把每一帧画面都存下来,任务目标被保存为一种稳定的内部状态。机器人被临时需求叫走,忙完之后,注意力仍会回到那串该翻面的肉上。
这种接着干的能力,在8月那段从乐享提前流出、行业内广泛流传的“神秘模型”室内Demo里已经露过面。具身机器人正在收拾房间,闹钟突然响了。它先去把闹钟处理掉,再回到刚才停下的地方接着收拾。
动作本身并不复杂,难在打断后依旧能继续,并且判断如何继续。
这是元认知在起作用。以太大模型会评估自己对眼前情况掌握了多少,如果把握不足,就会多调用一些计算,来补齐信息。比如拿不准烧烤是不是熟了,它会挪一步换个角度,找出被遮挡的线索,或者用夹取时的手感补上看不清的颜色。而后者能够被感知到,是因为内置的世界模型理解重力和摩擦这些物理约束。
“知道”自己不知道,是这条路径里,最接近人的地方。多数模型在信息不足时照样输出动作,以太大模型会先把信息补齐,再作出判断。
这次“烤场”上,不只一家企业的具身机器人在工作。一个大脑适配如此多的身体,靠的是模型里的“自我模型”。它清楚这具身体有多高,够得到哪里,刚才做到了哪一步,几台机器人因此能各自判断边界,自主分工,在对方力所不及时补位。
这种跨本体常被当作兼容性问题来讨论,而在以太大模型中,它更接近一种自我认知。模型得先知道自己装在哪具身体里,分工才有依据。
值得关注的是,面对同样的环境,具身机器人每次的推理和做法都不太一样,但每次都能把任务完成,而每次执行的结果都会回流并更新模型,实现持续成长的可能。对一个能从现场学习的模型来说,每一张被改掉的订单都在给它上课,真实世界里那些琐碎的劳动,反倒成了它长智力的地方。
整体来看,OpenAI几天前提出的异星心智和乐享的思路和模型放在一起,重合之处相当明显。
《An Alien Mind》引发震动,在于它把讨论推到了模型规模之外。Pachocki认为,AI是“生长”出来的系统,需要借助类似神经科学的方法去理解;递归式自我提升,也就是让模型主导自身的发展,被他视为保持前沿的唯一途径。
这些方向,乐享此前都已公开提出过。7月底上线的以太官网,写明了由Evolution Manager驱动的分层自进化,按人脑结构搭建模型,并把目标对齐和价值对齐分开处理。
一家AI巨头与一家中国具身公司,在相近的时间得出了相近的判断。这至少说明,模型如何自己成长,正在成为下一代智能绕不开的问题。
而现在,有意思的地方出现了。OpenAI还在推演这种心智的时候,乐享将它放到了烤架前,现场考验了一个小时。
烧烤摊之外的想象
烧烤摊只是一个场景,跨本体通用的大脑,才是乐享瞄准的产品位置。通用意味着它既要能换场景,也要能换身体。
从家务到餐饮,再到商超服务,任务各不相同,理解需求和跟踪环境的底层能力却是相通的。
能力可以复制,新的场景就有机会迁移。从商业化角度来看,这种迁移能力直接关系到部署成本。若是每进入一个新场景都要重新采集数据、编排流程,机器人的生意就容易做成逐个项目的交付。
而通用模型的商业价值,很大程度上取决于这笔成本能降下来多少。出人意料的是,以太大模型只有4B参数。据乐享披露,其初始思路是让模型掌握物理规律,用推理应对没见过的情况。整体训练用了约200小时人类视频,真机训练数据为零。
这条路径一旦走通,具身智能的成本结构会被改写,机器人不必把世界见过一遍才能干活。
同一模型能够驱动不同本体,意味着乐享的潜在市场可以延伸到多个硬件厂商。机器人产业有望由此形成更细的分工,身体各有所长,认知、协作与学习能力可以共享。
在这样的分工里,“智能”这一层的分量会越来越重。机器人的身体会越来越多样,能跨越这些身体持续积累经验的大脑,最难被替代。
“机器人世界的超级智能”,是乐享给自己定下的目标。跨本体通用、自主思考、自主进化、持续学习,构成了它对这颗大脑的设想。从Demo走向户外长时验证,这条路线已经有了可观察的实机样本。而这场直播的价值在于,它把一个宏大的说法,换成了外界可以当场核对的表现。
理论与实践的距离,终究要靠一次次进入现实来缩短。
特别策划