
机器之心编辑部
Nano Banana 2 推出几个月之后,谷歌终于更新了这条产品线。
就在今天凌晨,Google DeepMind 正式发布 Nano Banana 2.1。
从命名看,这只是一次“0.1”级别的升级,但谷歌给出的评价相当直接:新版在此前 Nano Banana 系列基础上进一步提升,重点变化集中在视觉设计、蒙版编辑、主体一致性和图像自然度。
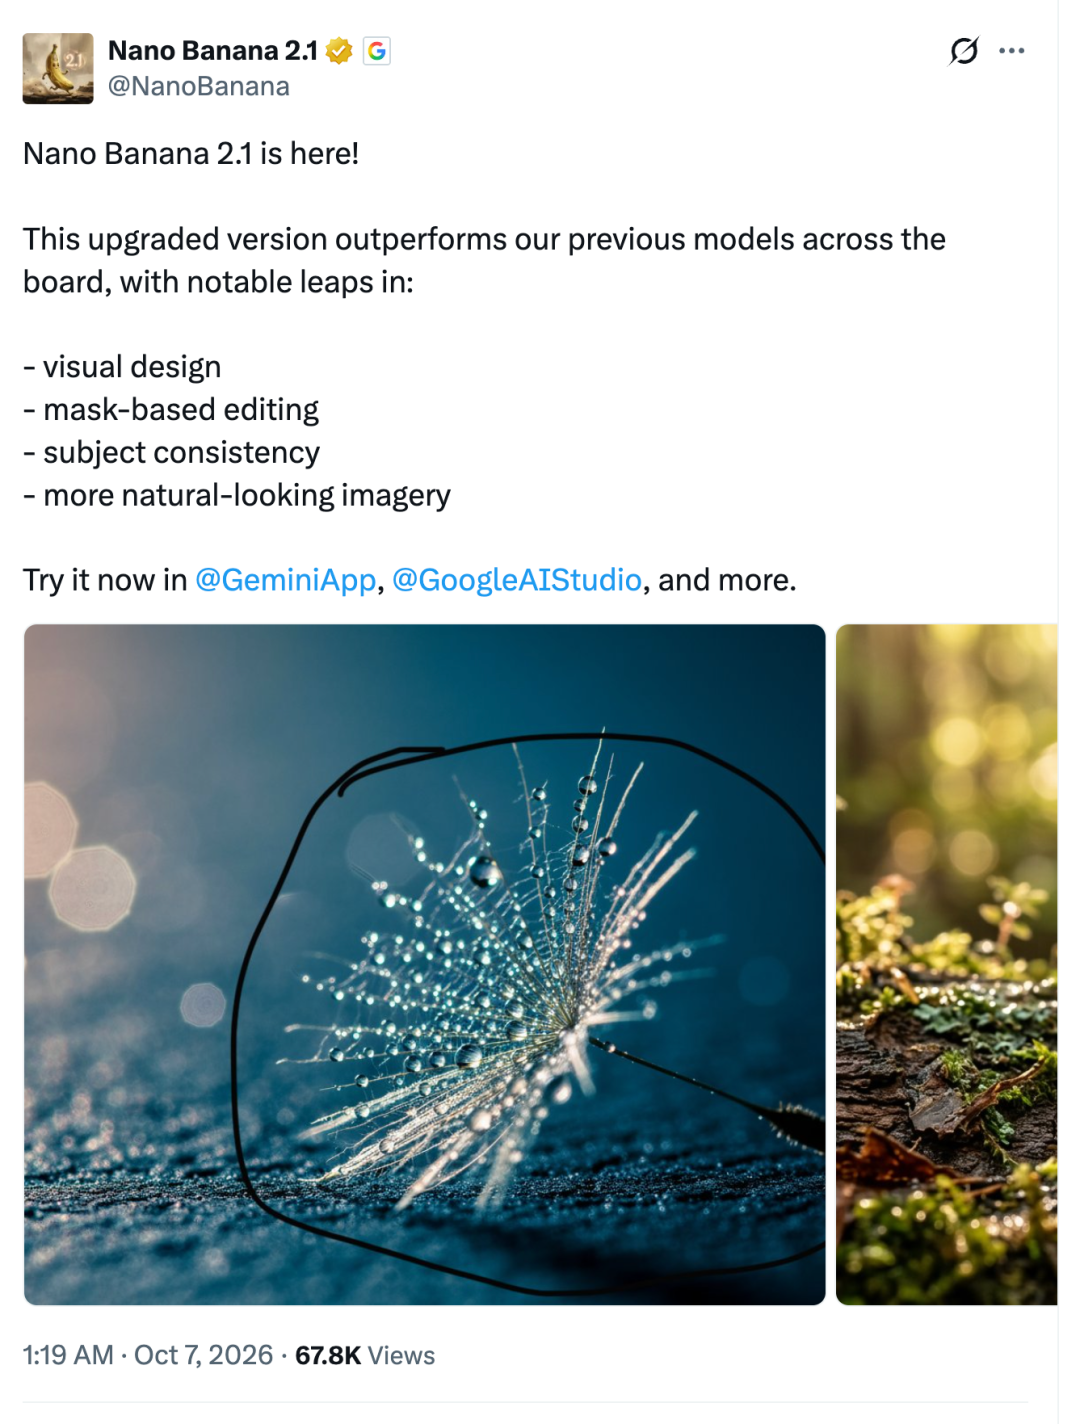
更值得关注的是,Nano Banana 2.1 并没有改变这条产品线原本的方向。它依然追求 Flash 级别的速度和成本效率,同时继续向专业图像生成和编辑靠近。谷歌将其定义为最新的高效率图像生成与对话式编辑模型。
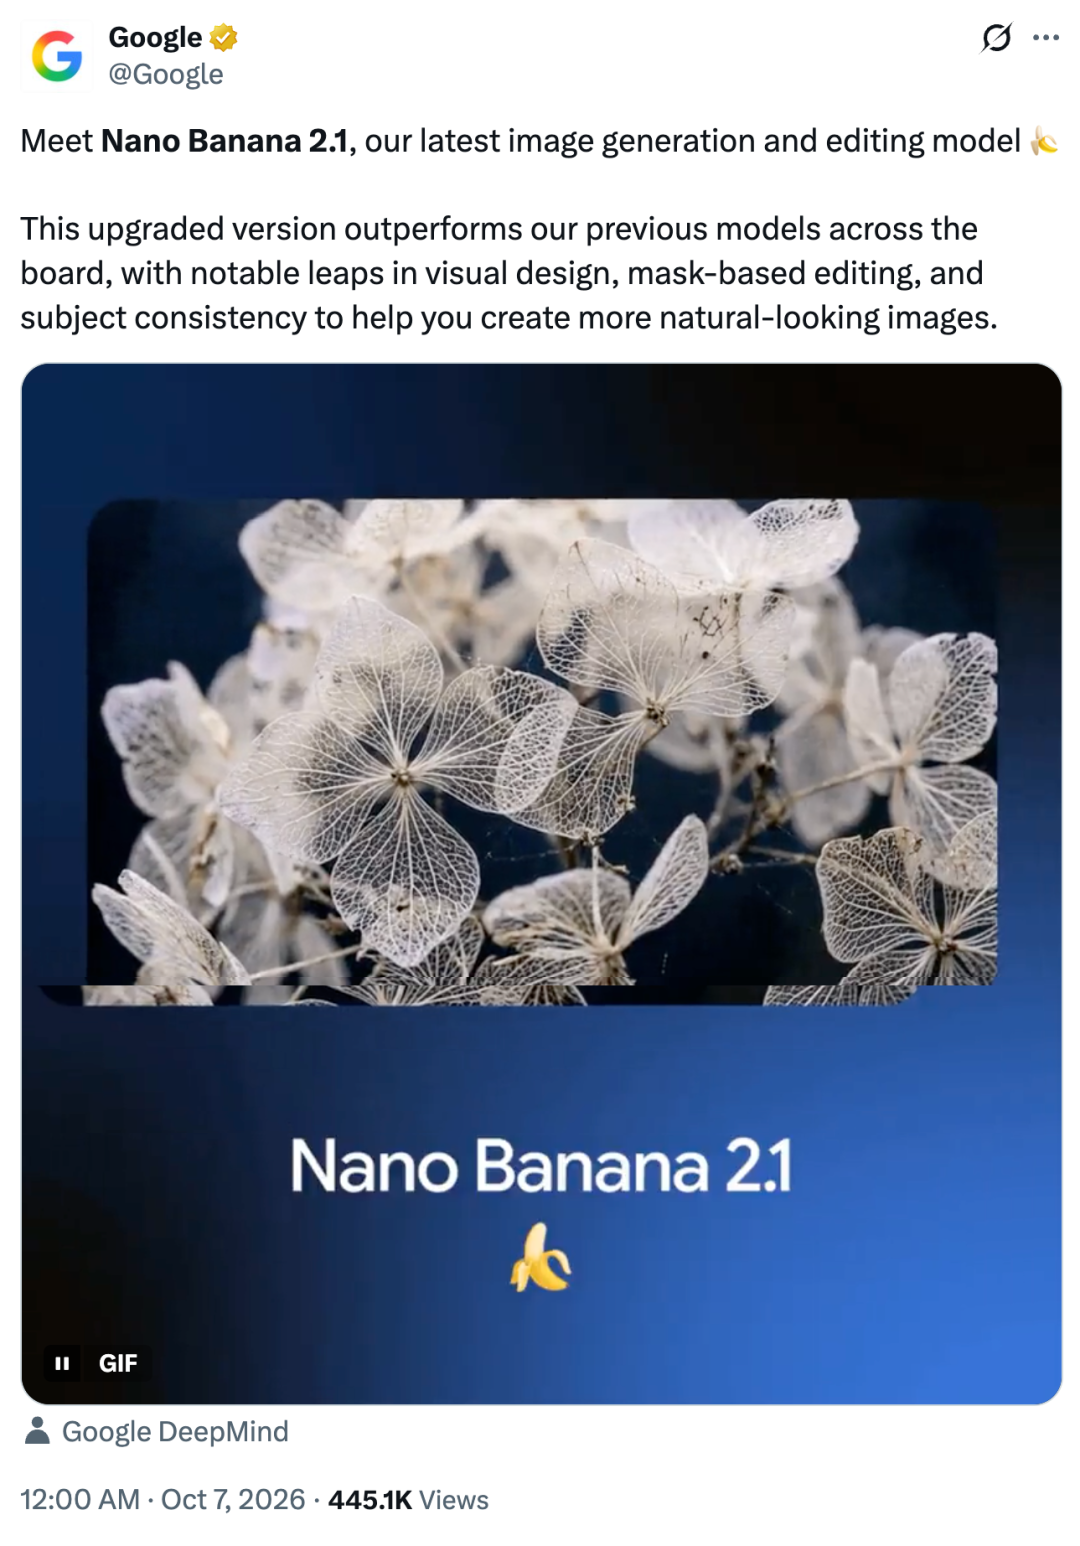
目前,Nano Banana 2.1 已经成为 Gemini API 中的稳定模型,模型 ID 为 gemini-nano-banana-2.1。按照谷歌公布的信息,它已经分发到 Gemini App、Google AI Studio、Gemini API、Google Search AI Mode、Google Ads、Flow 和 Stitch 等产品与开发平台。
从谷歌公布的模型卡和评测成绩来看,这次提升也并非只体现在几个展示案例上。
模型卡地址:https://storage.googleapis.com/deepmind-media/Model-Cards/Nano-Banana-2-1-Model-Card.pdf
底座换成了 Gemini 3.6 Flash
Nano Banana 2.1 属于 Gemini 3 系列,底层基于 Gemini 3.6 Flash。
这意味着,它延续了 Gemini 原生多模态模型的能力,可以理解文本和图像输入,再生成图像与文本。谷歌对它的定位也很明确:面向高效率的图像生成和对话式编辑,在速度和成本上继续保持 Flash 路线,同时提高最终输出质量。
在开发者侧,新模型支持 1K、2K 和 4K 输出,谷歌也专门优化了 1:4、4:1、1:8、8:1 等宽幅和超宽幅画面的平铺伪影问题。与此同时,多图融合最高可以接收 14 张参考图,并支持多角色和多物体的一致性处理。
这些更新背后的方向很清楚。谷歌让 Nano Banana 从“生成一张好看的图”,继续走向一套可以反复修改、保持素材一致、处理复杂版式的视觉生产工具。
最明显的提升,
首先发生在“设计感”上
生成模型会画图,和它能完成设计工作,仍然是两回事。
一个宣传海报、一张网页视觉或者复杂信息图,往往同时涉及排版、字体、留白、层级、颜色以及多个视觉元素之间的关系。此前很多生成模型可以把单个物体画得很好,但面对完整的平面设计任务时,容易出现信息层级混乱、文字位置失控,或者整体看起来“元素很多,却不像设计稿”的问题。
Nano Banana 2.1 针对这一点进行了明显强化。
谷歌在官方展示中给出了瑞士平面设计、复古海报和网页 UI 等案例。模型需要理解完整的设计要求,将字体、图片、色块和版式组织到同一画面,而非简单生成某个主体。
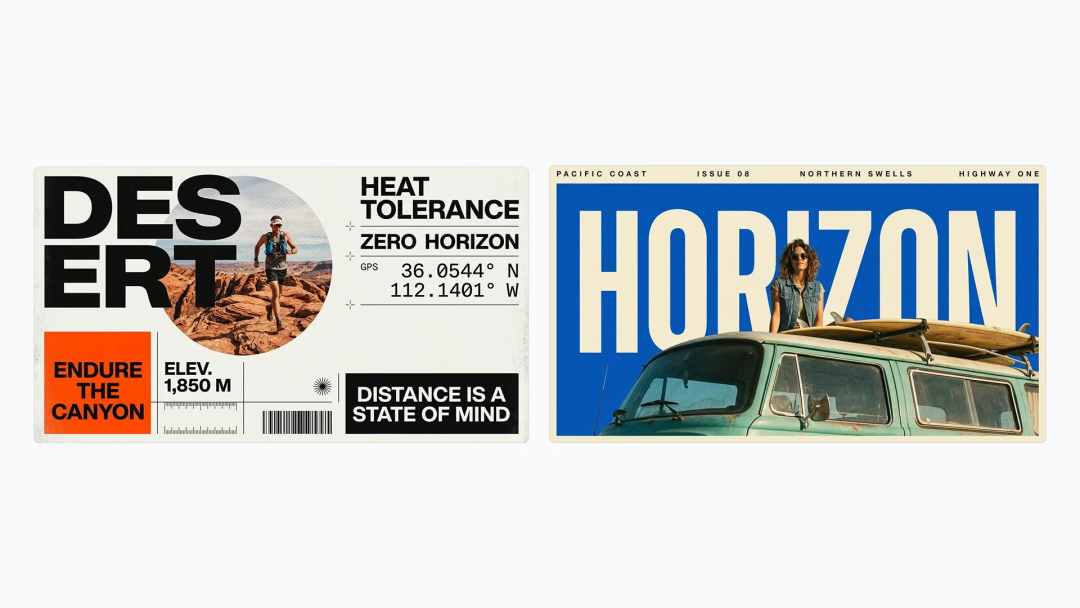
评测结果也体现了这一变化。
Nano Banana 2.1 在开启 Thinking 的情况下,Infographic Design 得分达到 1048,此前 Nano Banana 2 为 961,Nano Banana Pro 为 912;整体偏好得分为 1050,此前两款模型分别为 990 和 935。Google 的这部分评测采用了侧对侧人类评价,并通过 Elo 形式衡量整体偏好和设计质量。
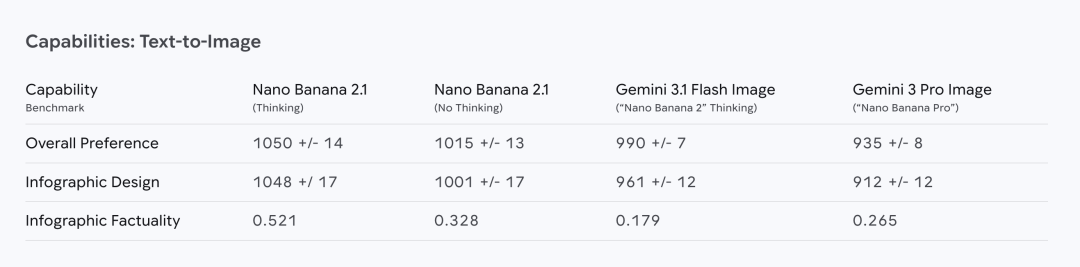
因此,这里的变化更接近“成品完成度”的提升。模型开始更稳定地处理一整张视觉作品的结构,而非单独优化某一个生成元素。对于广告物料、社交媒体配图、海报、电商视觉和 UI Mockup,这种能力比单纯增加画面细节更有实际价值。
AI 改图最难处理的局部编辑,
也成了这次升级重点
Nano Banana 最初引起大量关注,一个重要原因就是它把生成和编辑放进了同一套自然语言交互中。
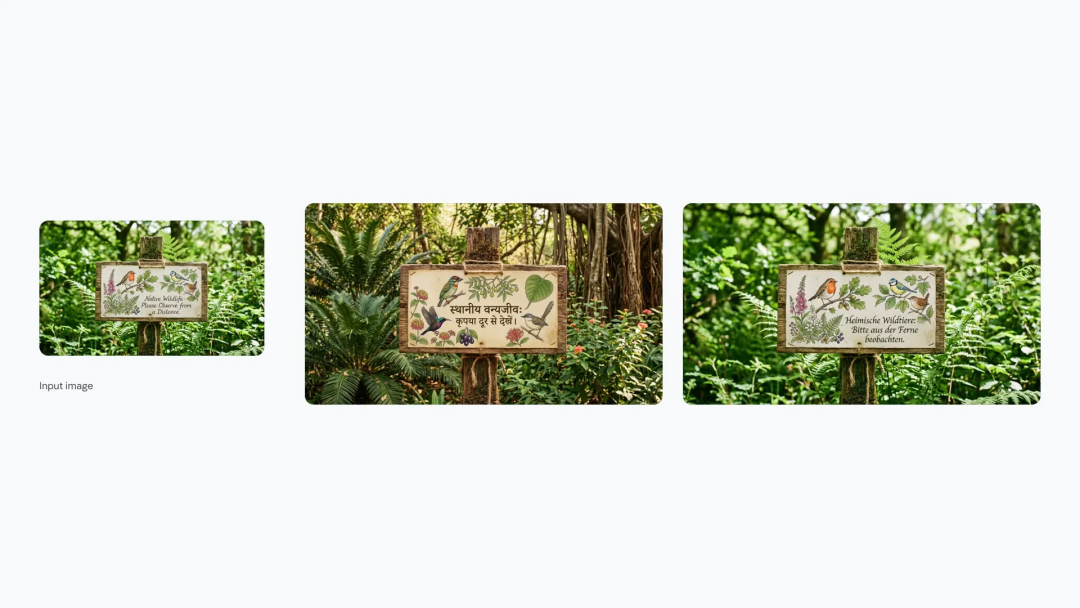
到了 Nano Banana 2.1,谷歌继续加强了其中最容易出错的一环:Mask-based Editing,也就是基于蒙版的局部编辑。
局部编辑看起来简单,实际对模型约束很强。例如,用户圈出图片中的一个物体,希望改变周围环境,同时保持主体的位置、尺寸和外观。模型既需要准确理解蒙版指定的范围,也需要避免修改画面中原本无需改变的内容。
在 Mask/Ink-Based Editing 评测中,Nano Banana 2.1 Thinking 得分达到 1049,此前 Nano Banana 2 为 965,Nano Banana Pro 为 927。更广义的 General Editing 得分也由此前两款模型的 938、939 提升至 1026。

这一能力会直接影响生成式图像工具能否进入真实工作流。实际设计过程很少是“输入一句提示词,一次得到终稿”。更多时候是一轮轮局部调整:换掉背景,保留产品;改变衣服,保持人物;重做某一块排版,同时让其他部分尽量不动。
生成模型越能控制修改范围,越接近传统 Photoshop 等编辑软件所提供的确定性。
多个人物放到一起,
更不容易换脸了
另一项提升集中在主体一致性。
对于单张图片生成而言,模型把一个人物画得逼真已经不算罕见。真正困难的是连续生成之后,这个人依然像同一个人;或者一次引入多个人物、多件产品后,每个主体都能保持原本的特征。这也是角色故事、广告摄影、电商素材和连续视觉内容中经常遇到的问题。
Nano Banana 2.1 的提升在多人场景尤其突出。
谷歌的评测中,单角色一致性从 Nano Banana 2 的 981 提升至 1028;多角色一致性从 978 提升到 1106。后者也是整个编辑评测表中差距非常明显的一项。即使与 Nano Banana Pro 的 1011 相比,Nano Banana 2.1 也保持了领先。

谷歌官方展示了将多名不同模特参考图组合到同一时尚大片中的案例。这里需要模型同时处理人物身份、服装、距离、姿态以及整体场景关系。
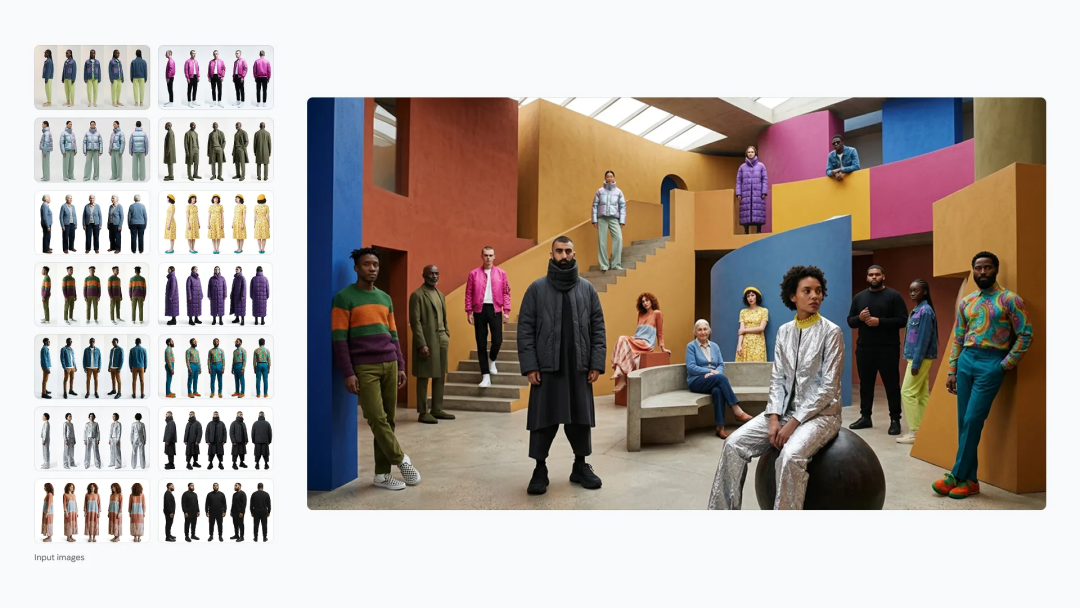
这种能力进一步向“素材复用”靠近。一次拍摄或者一组产品图,可以被重新放进不同场景;已有角色能够继续出现在后续画面中;一组人物也可以组合成新的视觉作品。对于商业设计来说,主体一致性的价值就在这里:生成结果不再是一张张彼此孤立的图片。
继续消除那种熟悉的“AI 味”
Nano Banana 2.1 的另一项官方重点是 more natural-looking imagery。
Google API 文档明确提到,新模型提升了 1K、2K 和 4K 分辨率下的视觉质量与真实感。官方展示的样例涵盖微距昆虫、人物摄影、自然景观、静物以及绘画作品,重点强调材质、光线、空间关系和细节的自然程度。
这一方向看起来不像蒙版编辑那么容易量化,却直接决定了生成图片第一眼给人的感受。
过去生成图片中常见的问题,是局部细节很丰富,但画面整体存在一种过度平滑、过度戏剧化或者材质趋同的感觉。随着模型逐渐进入广告、摄影、电商和内容生产,单纯追求“精致”已经不够,生成结果需要更接近真实世界里摄影、材质和光线本身的复杂性。
Nano Banana 2.1 对这一点的强化,与它的产品定位也能对应起来:在保持 Flash 速度的同时,提高实际交付质量。
信息图这条路线,也被谷歌继续押注
Nano Banana 系列还有一个很有谷歌特征的能力:它可以调用 Gemini 的世界知识,并利用 Google Web Search 和 Image Search 进行 grounding。
这使得图像生成开始与 Gemini 的知识和搜索能力结合。
例如,让模型生成地球结构示意图、云层分类、面粉种类比较或者某一历史建筑时,它可以先理解相关知识,再组织视觉结构。谷歌将这一能力用于信息图、教育图示以及具体真实对象的生成。
这次模型卡中的数据也很值得注意。
在 Infographic Factuality 指标上,Nano Banana 2.1 Thinking 得分为 0.521,Nano Banana 2 为 0.179,Nano Banana Pro 为 0.265。谷歌对这一指标使用 AutoRater 进行评估。

与此同时,文字渲染也继续得到优化。谷歌表示 Nano Banana 2.1 提升了文字生成与信息图布局准确度,这对于海报、营销物料和复杂图示尤其重要。
生成模型正在逐渐把“查资料 — 理解内容 — 组织版式 — 生成图片”连接起来。对信息图而言,这比单纯把文字画清楚更进一步。
不过,2.1 还远没有解决图像生成的所有问题
从谷歌自己公布的模型卡来看,Nano Banana 2.1 依然存在相当明确的限制。小字号文字仍可能模糊,尤其是在 1K 输出中;长段落和整页文本的渲染质量仍然有限。输入图片和生成图片之间的角色一致性也并非始终稳定。
蒙版和涂鸦编辑虽然已经提升,但仍可能出现指令执行不完整以及编辑痕迹残留。部分情况下,模型还会过度继承原图中主体的姿态和结构。左右等空间位置关系偶尔也会判断错误。谷歌同时承认,在世界知识、高级 3D 推理和事实准确性方面仍有提升空间。
所以,Nano Banana 2.1 更适合理解为一次针对实际生产体验的集中升级。版本号只增加了 0.1,谷歌调整的却恰好是生成式图像真正进入工作流之后最容易暴露问题的地方:设计完成度、局部控制、连续编辑中的一致性,以及最终图片看起来够不够自然。
从这个角度看,Nano Banana 2.1 的意义或许就在于此:谷歌正在把“会生成图片”这件事,进一步推进到“能够持续完成视觉工作”。