
扎克伯格想要奇迹再现

出品|虎嗅科技组
作者|黄天媛
编辑|苗正卿
头图|AI生成
扎克伯格终于等来了自己的翻身仗。
当地时间10月12日,Meta发布新一代大模型Muse Wonder和Muse Wonder Full。根据官方公布的Benchmark,性能更强的Wonder Full在多项Agent和编程测试中超越OpenAI、Anthropic的旗舰模型,第三方评测也显示,Meta已经重新跻身前沿模型第一梯队。
但就在一年半前,情况还完全不同。
外部,OpenAI、Anthropic的双强格局仿佛尘埃落定,Meta一度被认为在前沿模型竞争中掉队。内部,扎克伯格押上千亿美元级别的AI基础设施投资,花上亿美元高薪“雇佣兵”式狂挖研究员,种种决策没少遭到挖苦。
如今,Meta终于拿出了阶段性成果。
扎克伯格复仇成功了吗?模型能力追上了OpenAI和Anthropic,Meta能赢得下一场Agent战争吗?
我们整理了昨天扎克伯格和Meta首席AI官汪滔采访中的核心观点以供阅读:
模型正在成为产品本身。 Meta内部常说“The model is the product”。Agent的差异不再只是界面,而是记忆、主动性、可靠性和交互体验。这些能力需要通过训练数据、后训练和评测塑造,产品设计正逐渐深入模型层。
过度追求跑分,等于把产品方向交给别人。 汪滔认为,如果一味围绕外部Benchmark优化,就相当于把产品决策交给制定评测的人。Meta早期追赶时重视外部排名,如今更关注针对真实用户场景设计的内部评测。
模型进步不一定依赖重新预训练。 Muse Spark从1.0到1.3沿用同一基座模型,主要通过强化学习提升能力。Meta同时推进两条路线:扩大预训练规模(逐级放大约4—5倍),以及优化强化学习方法。
Personal Agent需要更强的多模态能力。 汪滔认为,行业过度聚焦Coding,但普通用户更多通过视觉、语音和视频与世界交互。因此,Meta从预训练阶段就强化多模态能力,而非仅在后训练中补齐。
实验室的关键是人才密度和人均算力。 Meta采用小规模精英团队,集中分配算力,减少资源分散。扎克伯格强调扁平化管理,避免管理层脱离技术一线。
实验室负责人的战略判断比履历更重要。 尽管汪滔此前没有直接领导前沿模型训练的经验,扎克伯格仍看重他的战略思考、快速调整能力,以及吸引顶尖研究人员的能力。


先给出判断,这次的新模型是能长期记住用户使用习惯、跨软件完成任务的Personal Agent底座模型。
Muse Wonder和性能更强的Muse Wonder Full,都支持100万Token上下文窗口,能够理解文本、图像、音频和视频,原生输出以文本为主。相比上一代Muse Spark系列,新模型重点强化了编程、长期Agent任务和专业知识工作。Meta确认,Muse Wonder未来将成为个人Agent Muse的核心模型。
其中,最值得关注的是两项能力。
一是Active Memory(主动记忆),让Agent能够跨对话记住用户偏好,在需要时主动提取相关信息,而不必反复询问。二是Active Focus(主动聚焦),让Agent在执行复杂任务时持续尝试、纠错,遇到障碍能够调整方案,而不是直接放弃。
Meta还展示了根据图片制作可交互3D游戏、跨应用规划跑步活动、自动生成婚礼座位表等案例。
那么,新模型究竟有多强?
按照Meta公布的官方Benchmark,Wonder Full在多项Agent和编程测试中已经超过OpenAI、Anthropic的旗舰模型。
Meta专门设计了一项Personal Superintelligence Index(个人超级智能指数),综合衡量专业工作、流程自动化、网页操作等七类任务。
在这项测试中,Wonder Full取得59.1%的成绩,超过Claude Opus 5.5的55.2%和GPT-6 Astra的54.5%。
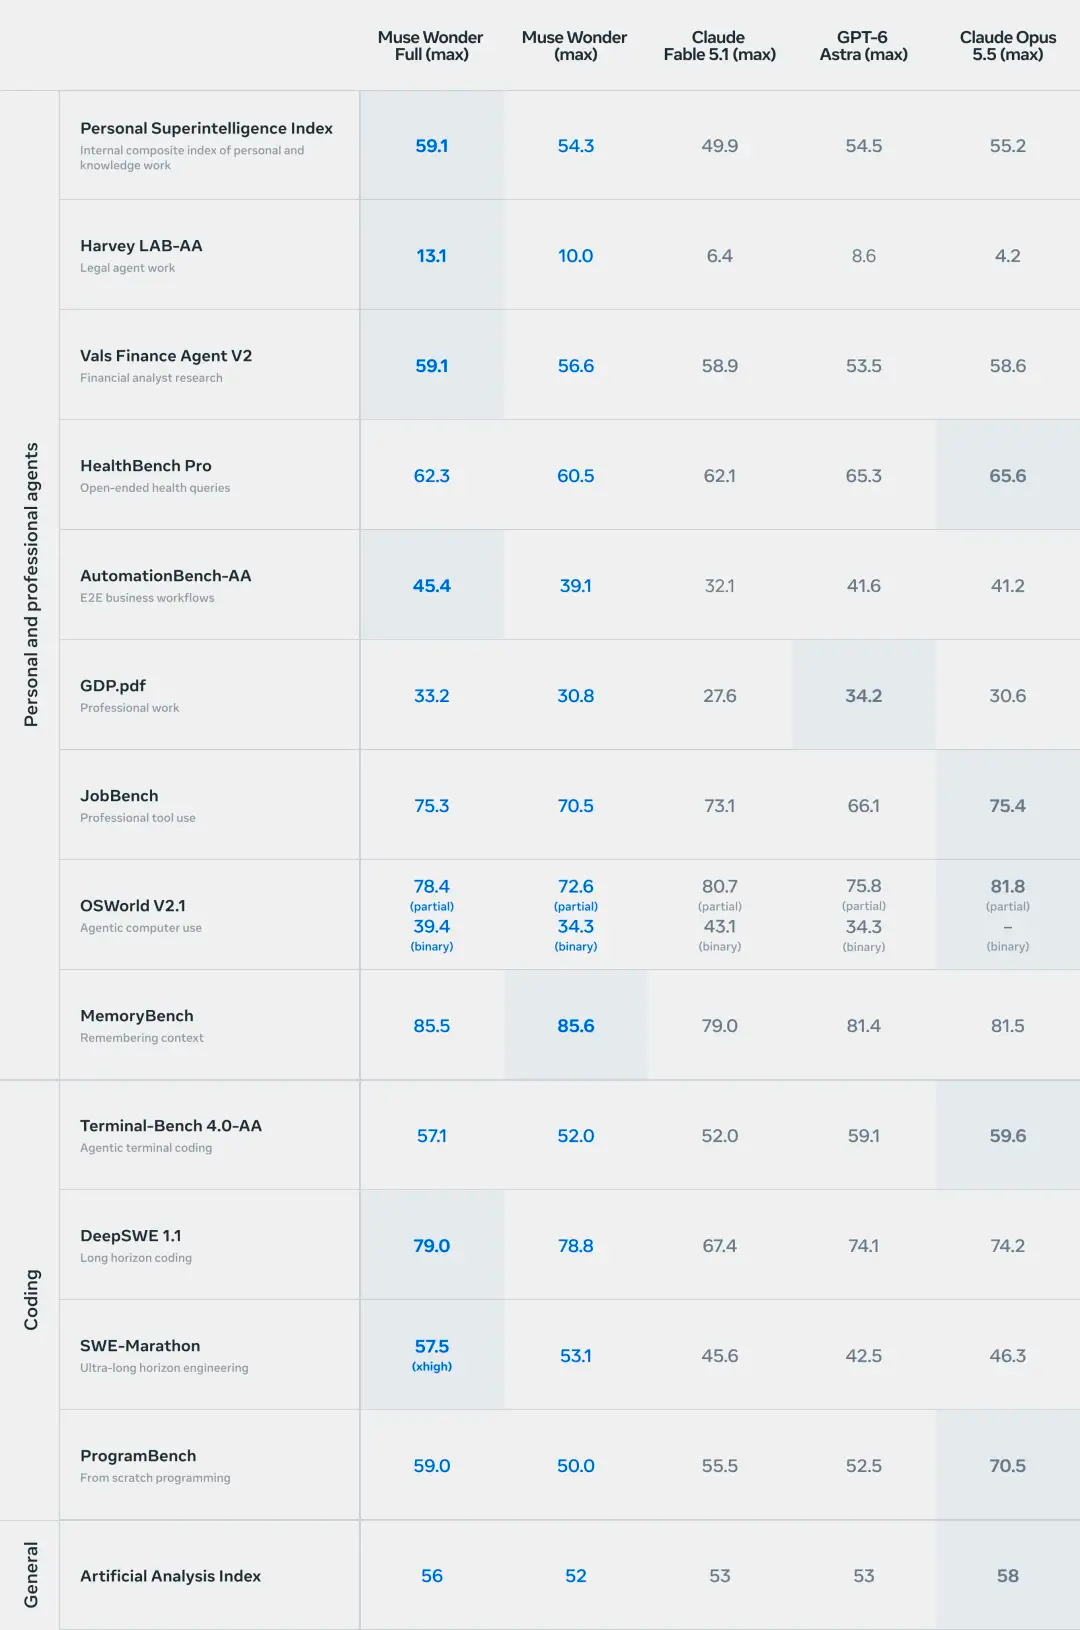
在考察端到端业务流程自动化能力的AutomationBench-AA中,Wonder Full取得45.4%,同样高于Astra的41.6%和Opus 5.5的41.2%。
长期记忆也是Meta的优势项目。在内部开发的MemoryBench测试中,普通版Wonder和Wonder Full分别取得85.6%和85.5%,均高于Opus 5.5和Astra的约81%。
编程方面,Wonder Full在长期软件工程测试SWE-Marathon中取得57.5%的成功率,领先Opus 5.5的46.3%和Astra的42.5%。
第三方机构Artificial Analysis(AA)的综合测评则给出了更客观的参照。
在Intelligence Index v4.3中,Wonder Full获得56分,普通版Wonder为52分,较上一代Muse Spark 1.3的48分分别提升8分和4分。作为对比,Claude Opus 5.5为58分,GPT-6 Astra为53分。
这意味着,Wonder Full已经进入前沿模型第一梯队,但综合表现目前还没有全面超越竞争对手。
但漂亮的跑分,并没有换来一致的口碑。
Wonder发布后,部分开发者在X上质疑,Meta是否过度针对Benchmark优化模型,以至于实际体验与榜单排名存在落差。
争议最集中的是3D游戏生成任务。有开发者晒出测试结果,认为Wonder的表现明显不及其他前沿模型。
面对质疑,Meta首席AI官汪滔承认,团队此前并未专门针对3D演示游戏训练模型,希望开发者更多关注其真实软件工程能力。
但有用户直接回怼,视频游戏演示也是通过代码做出来的,“游戏怎么不算‘实际编程工作’?”,并且对其泛化能力产生怀疑。
最后,开放范围和价格也是槽点。
Muse Wonder API每百万Token输入4美元、输出20美元,缓存输入0.2美元,与Claude Opus 5.5的基础输入、输出定价持平,是Gemini 4 Argon的两倍。第三方测算显示,Wonder每项测试任务的成本约为4.52美元,高于GPT-6 Astra的3.26美元,也超过了Gemini。
而性能更强的Wonder Full暂未开放独立API,目前仅向Muse Code的Power Usage和Maximum Usage订阅用户提供,订阅价格分别为每月50美元和200美元。
以及值得注意的是,此次两款模型均未公开权重。曾经以Llama开放模型闻名的Meta,这一次选择了更加封闭的发布方式。


过去一年多,围绕Meta大模型最多的声音,是质疑。
2025年4月,曾被寄予厚望的Llama 4发布后,因性能不及预期、Benchmark评测争议等问题遭到外界质疑。曾经凭借Llama系列领跑开放模型市场的Meta,逐渐在前沿模型竞争中掉队。
扎克伯格坐不住了。他在Llama 4于2025年4月4日发布仅仅两周后,就开始联系外部研究人员,寻求重建AI团队的建议。
这一次,他决定几乎推倒重来:调整原有研发路线,重新组建团队。
而他找到的关键人物之一,就是Scale AI联合创始人汪滔。
当时汪滔正在开员工会议,突然收到扎克伯格的一条WhatsApp消息,询问他是否有时间通话。两人随后聊了约44分钟。两天后,汪滔给扎克伯格发来一份长篇方案,具体解释了如果由自己掌管Meta的AI业务的话,会怎么做。
方案的第一条就是:不要太多人,关键在于人才密度。
扎克伯格被说服了。
2025年6月,Meta将汪滔招至麾下,斥资约143亿美元获得数据标注公司Scale AI的49%股权,汪滔出任Meta首席AI官,并成立超级智能实验室(MSL)。
汪滔此前从来过领导前沿大模型训练的经验。但扎克伯格认为,汪滔就是那个Mr. Right。他能给Meta带来的,不只是一套技术方案,更是一种接近创业公司的组织方式。
接下来的故事我们都知道了,Meta开始从OpenAI、Google、xAI等竞争对手手中狂挖研究员,且金额巨大。
扎克伯格说,那一两个月时间内,他几乎清空自己的日程,密集会见研究员。那段时间他和汪滔都没有怎么睡觉。
根据路透社的报道,Meta曾向部分研究人员提出四年最高3亿美元、第一年总薪酬超过1亿美元的offer。
这场人才争夺甚至出现了颇具硅谷特色的一幕,扎克伯格甚至曾亲自给想招募的研究员送汤。
扎克伯格希望用少数顶尖人才组成一支精锐团队,再向他们集中分配算力资源。据披露,目前Meta负责核心模型研发的研究团队不足200人。
但这场组织重建并非一帆风顺,人员摩擦和变动一直在发生。金融时报报道显示,Meta在半年内经历四次AI领导层调整。曾参与ChatGPT研发的赵晟佳(Shengjia Zhao)加入后,一度考虑返回OpenAI,随后才被任命为Meta首席AI科学家。另外两名新招募的研究人员Ethan Knight、Avi Verma也在短暂加入Meta后返回OpenAI。
与此同时,扎克伯格还在投入巨额资金建设算力基础设施。
据路透社报道,Meta将2026年资本开支预期提高至1300亿到1450亿美元,主要用于AI基础设施等领域。与此同时,Meta正在建设俄亥俄州的Prometheus集群和路易斯安那州的Hyperion集群,规划规模分别超过1吉瓦和达到5吉瓦。
如此巨大的投入,Meta内部其实也在打鼓。
扎克伯格回忆,2025年底,他与汪滔讨论过一笔1000亿至2000亿美元量级的投资决定。当时模型结果尚不明朗,他还问过汪滔:“你确定这能成功吗?”
汪滔自己也说,在夏威夷举行的一次高管会议上,Meta首席财务官Susan Li曾多次把他拉到一旁,提醒他:如果模型失败,财务后果会非常严重。
如今,Muse Wonder终于发布。
虽然仍有争议。但对于这支重建一年多的团队来说,它至少证明,Meta还是能有训练前沿模型的能力。
只是,这场耗资惊人的豪赌,距离真正证明商业价值,还有很长一段路要走。


扎克伯格已经明确了自己的押注方向——Agent和Agent的模型。
他提出一个观点:The model is the product(模型就是产品)。在他看来,传统软件的界面会越来越轻,决定产品体验的核心将是模型本身,包括记忆能力、可靠性、性格,以及调用工具完成任务的能力。这就是为什么Meta要从底层训练面向Personal Agent的模型。
但重新回到前沿模型第一梯队,Meta就一定能赢得下一场Agent战争吗?
目前来看,答案还远不确定。
用户留存首先是一个问题。华尔街日报报道显示,Muse已经获得近900万次全球下载,但相比ChatGPT等竞争对手,用户留存仍面临挑战。
其次是Agent的开放性问题。
Meta拥有Facebook、Instagram、WhatsApp等庞大的用户生态,并在AI眼镜等硬件入口上提前布局。相比独立Agent创业公司,Meta天然具备触达用户的优势。谁会掌控Agent入口?
但有入口,不等于能替用户办成事。今年9月,Muse上线不到两周,就遭到Amazon封禁。据彭博社报道,Amazon此前要求Meta停止让Muse操作其购物网站,遭到拒绝后,直接阻止Muse访问平台。
这是Personal Agent的一道核心壁垒。即便Meta拥有数十亿用户,也无法保证其他互联网平台对Muse的开放。
其次是商业化的问题。
更强的模型也意味着更高的推理和服务成本。按照Meta目前的规划,Muse Wonder将优先接入每月20美元和100美元的Muse付费订阅服务。扎克伯格承认,Wonder体量更大,服务成本更高,因此暂时无法向所有免费用户全面开放。
所以,Meta不仅要让用户愿意尝试Muse,还要说服他们愿意长期使用、持续付费。这对于一个新产品来说,意味着推广难度上升。
当然,对于Meta这样一家广告业务庞大的互联网公司,Agent的商业价值也未必完全来自订阅收入。未来,它可能进一步融入社交、购物、广告和智能硬件生态,成为连接用户与商业服务的新入口。但这种商业模式能否成立,目前仍缺乏验证。
所以,下一阶段的Agent竞争,已经不再只是Benchmark上的分数之争。
能否赢得用户信任、打通外部生态,并以可控的成本稳定完成复杂任务,将成为决定Agent竞争格局的关键。
本内容来源于网络,观点仅代表作者本人,不代表虎嗅立场。如涉及版权问题请联系 hezuo@huxiu.com,我们将及时核实并处理。
End
想涨知识 关注虎嗅视频号!