克雷西 發自 凹非寺
量子位 | 公衆號 QbitAI
GPT-5.6和Fable 5聯手,解決了一道懸置25年的數學難題。
微軟研究院首席研究員Dimitris Papailiopoulos,證明了一個多項式時間算法,能讓MIMO檢測精確命中最大似然閾值。
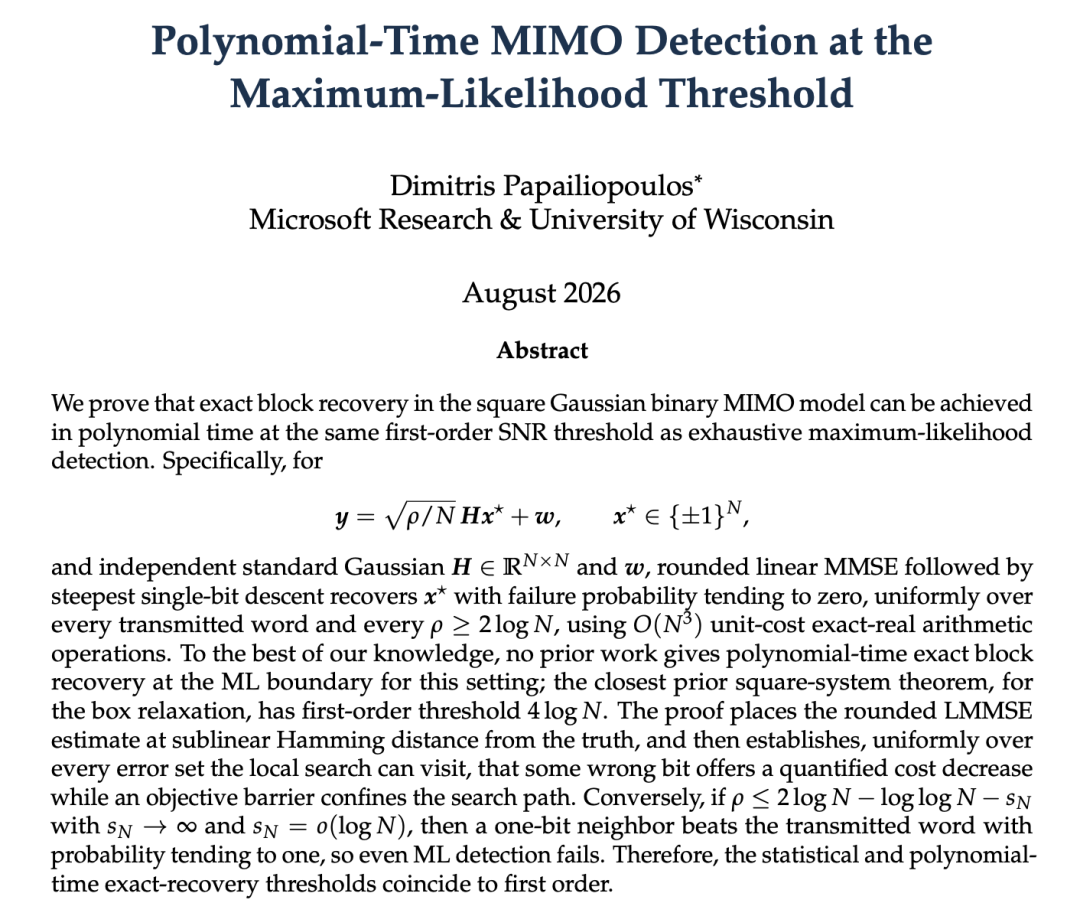
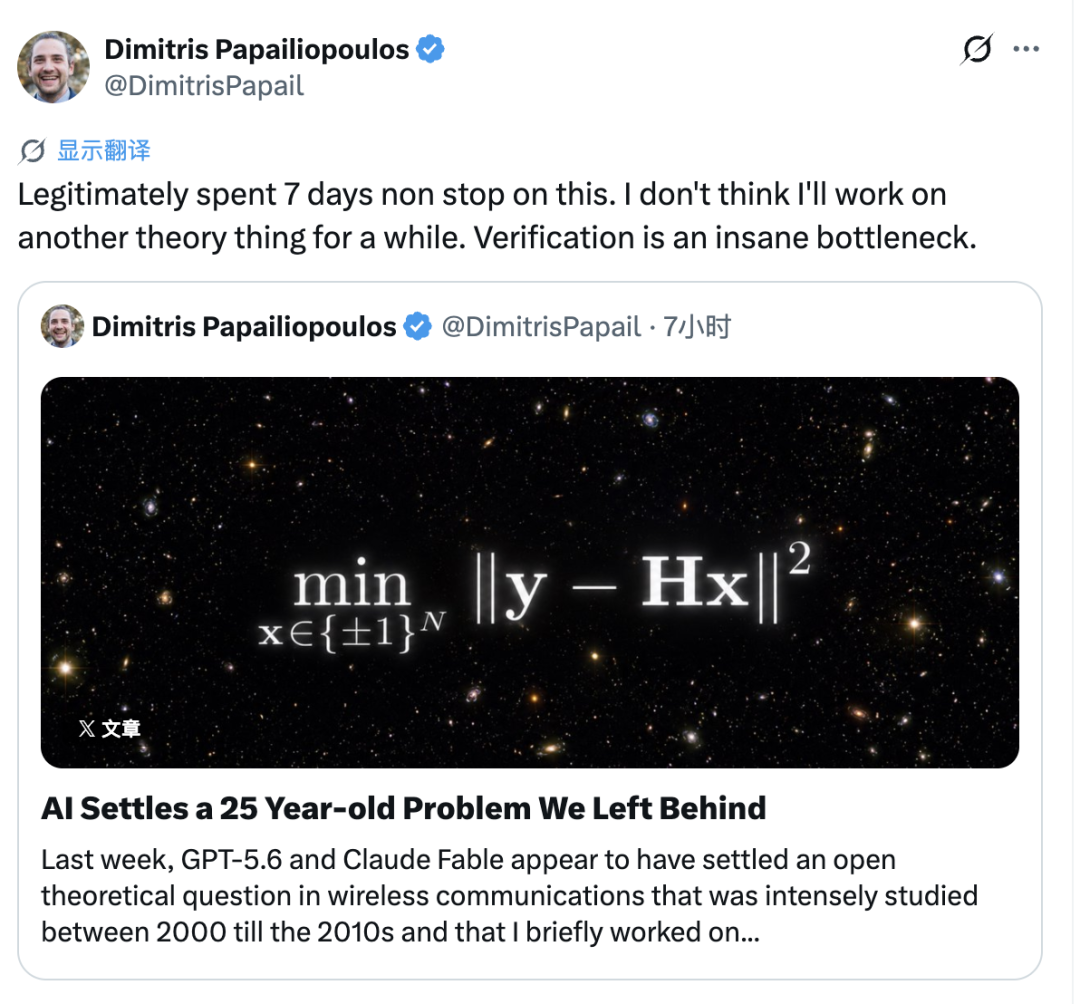
作者表示,這個過程花了他整整七天。
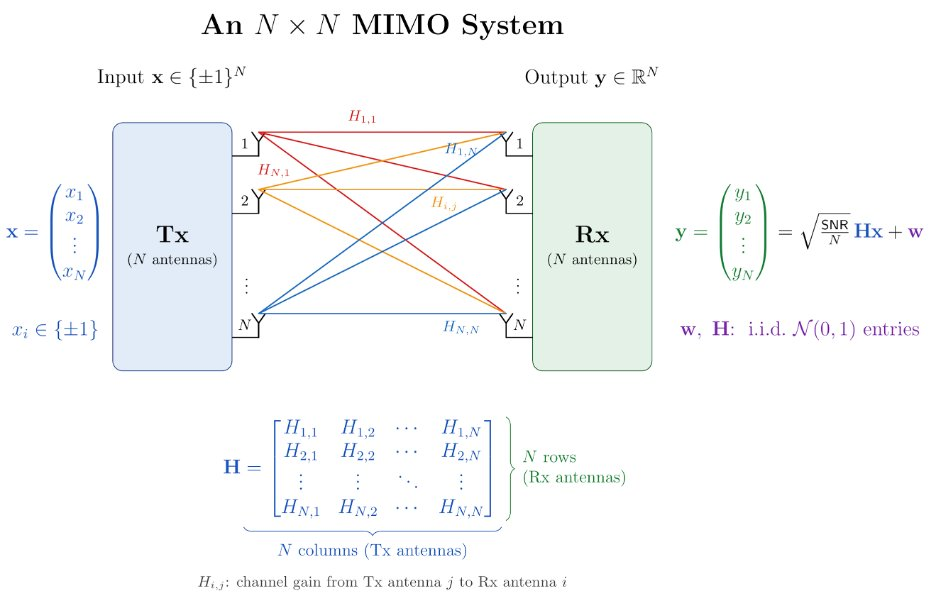
MIMO檢測是無線通信領域的一個經典問題,需要接收端從被噪聲攪亂的信號中,把發送端原本發出的信息完整還原。
統計上這種操作已經可以做到,但過去的方法,是窮舉搜索,耗費的時間是指數級的。
所以問題就變成,能不能不通過窮舉,利用快速算法實現還原。
2001年,Hassibi和Vikalo以為找到了突破口,但2005年這條路又被Jaldén和Ottersten證明走不通。
此後學界又先後試過半正定鬆弛、比特翻轉局部搜索、AMP、統計物理方法,最接近的結果也只能停在比理論門檻高一倍的地方。
25年,一波又一波學者輪番上陣,但誰都沒能啃下來。
25年來,只能靠窮舉
MIMO檢測,是無線通信裏的一個基礎問題。
發送端把N個比特通過一個N×N的信道發出去,信道會把這些比特混在一起,還會疊加噪聲;
接收端手裏只有一份被攪亂過的信號,要把發送端最初發出的N個比特,一位不差地找回來。
理論上有一個萬無一失的辦法,叫最大似然檢測,也就是把所有可能的比特組合都算一遍,找出跟接收到的信號最匹配的那一個。
這種方法一定能找到正確答案,前提是你願意等——N個比特意味着2的N次方種組合,N稍微大一點,窮舉就要算到天荒地老。
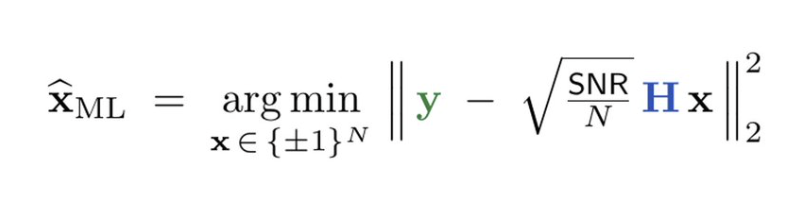
1989年,Sergio Verdú證明了這類問題在最壞情況下是NP-hard的,也就是不管用什麼算法,都存在某些輸入讓計算量指數級爆炸。
但「最壞情況」說的是數學上刻意構造出來、專門為難算法的信道矩陣。
現實裏的無線信道不是誰刻意構造的,它的每一次衰減、每一次噪聲都是隨機產生的,不會挑那些最難算的情況來為難接收端。
於是學界從2000年代初開始問一個更具體的問題——
如果信道是隨機產生的,只要統計上存在恢復原始比特的可能,是不是就一定能找到一個不需要窮舉的算法?
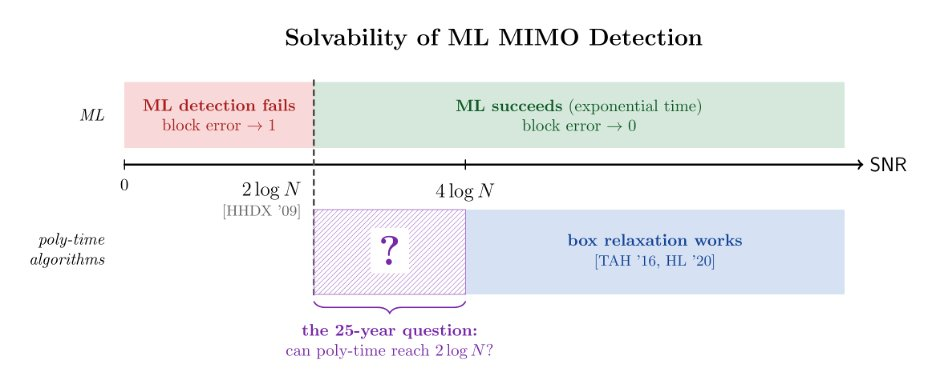
後來的研究給出了一條精確的分界線,當信噪比達到2logN,發送的比特能夠被完全恢復的概率趨近於1。
低於這條線,連最大似然檢測本身都會開始出錯,這條分界線因此被稱為最大似然閾值。
問題於是變得具體——能不能設計一個跑得快的算法,精確命中最大似然閾值?
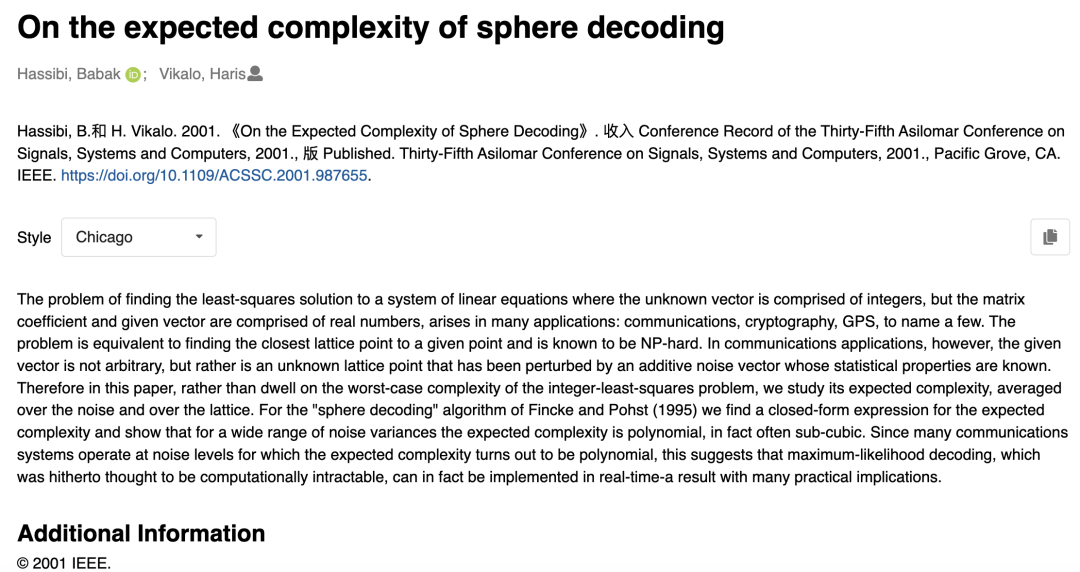
2001年,Babak Hassibi和Haris Vikalo以為找到了答案。
他們分析的是一種叫球形譯碼(sphere decoder)的算法。
這種算法先在接收信號周圍劃出一個「球」,只在球內的候選裏搜索,球外的直接跳過,靠這一步壓縮搜索範圍。
Hassibi和Vikalo推導出這個算法的期望複雜度公式,結果看起來是多項式時間的。
如果這個結論成立,這道題基本就解決了。
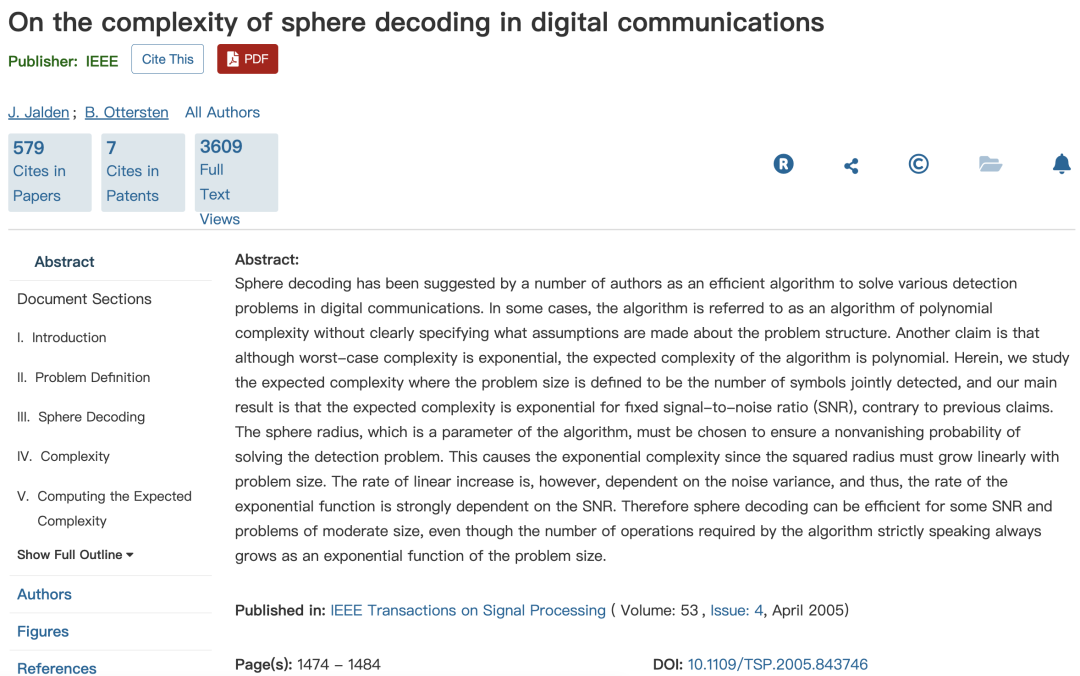
但2005年,Joakim Jaldén和Björn Ottersten把這個結論推翻了。
他們證明,在任意固定的信噪比下,球形譯碼的期望複雜度其實是指數級的,不是多項式的。
原因是要以不趨於零的概率把發送的信號包進「球」裏,球的半徑必須跟着問題規模一起變大,球一旦變大,球內要搜索的候選數量也跟着指數級增長。
球形譯碼這條路走不通之後,學界轉向了各種近似方法——半正定鬆弛、比特翻轉局部搜索、AMP(approximate message passing)、統計物理裏的方法。
結果,每一種都能給出漂亮的分析,但沒有一種被證明能精確匹配2logN這條閾值。
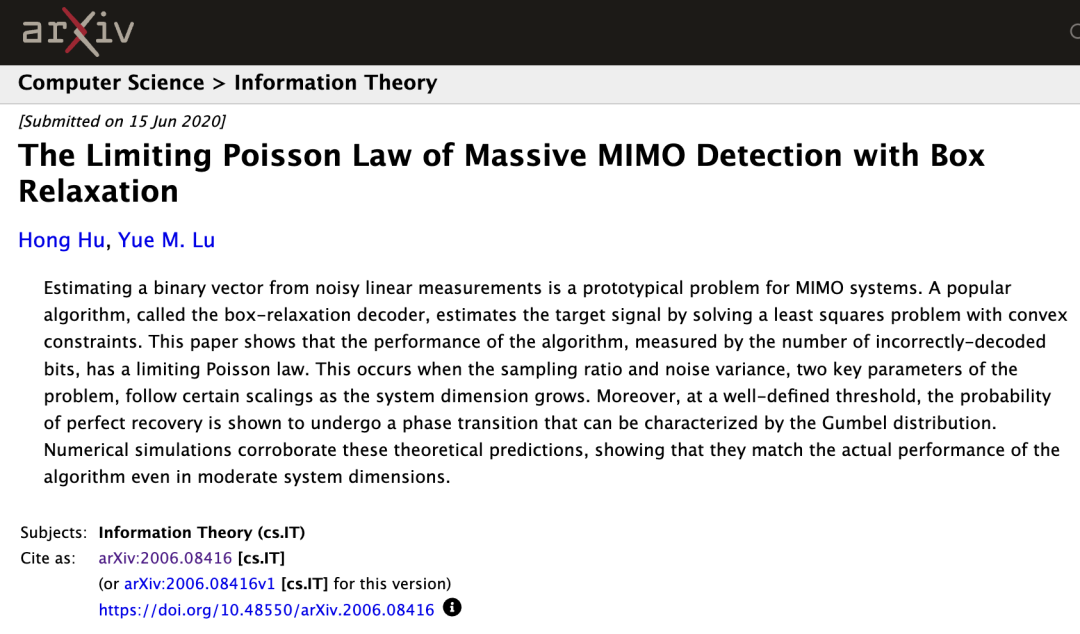
2020年,一種把離散問題放寬成連續優化問題來解的方法,叫box relaxation,拿到了當時最好的嚴格證明結果,能在信噪比達到4logN時做到精確恢復,但複雜度依然是理論門檻的兩倍。
25年過去,統計上「能恢復」和用快算法「能恢復」之間,一直隔着這條鴻溝。
上周,這條鴻溝被填平了。
Dimitris Papailiopoulos和GPT-5.6、Claude Fable 5證明,一個只有兩步的簡單算法,同樣能在信噪比等於2logN時精確恢復全部比特,而且是多項式時間,只需要O(N³)次運算。
而且這篇論文證明的是一個雙向結果。
一頭證明了這個算法能在信噪比等於2logN時,信號能被精確恢復;另一頭則進一步證明,信噪比只要略低於2logN這個最大似然閾值,連「笨辦法」最大似然檢測也會開始失敗。
GPT-5.6和Fable 5聯手證明
Dimitris找GPT-5.6和Fable 5來試這道題,兩個模型很快分別給出了自己的證明思路,但接下來的打磨過程一波三折。
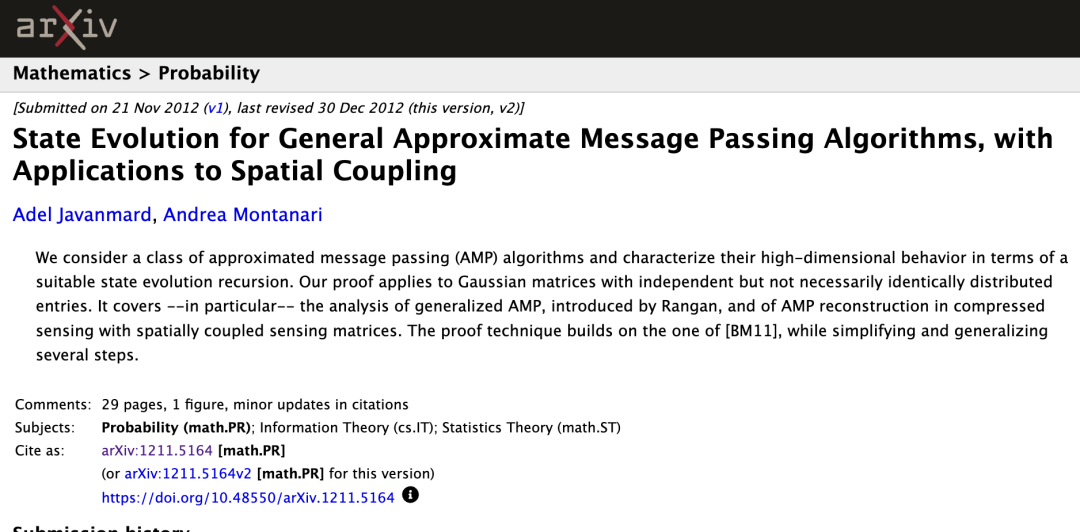
GPT-5.6的路徑用了一種叫AMP的算法,這是Dimitris一直沒能喫透分析方法的一類工具。
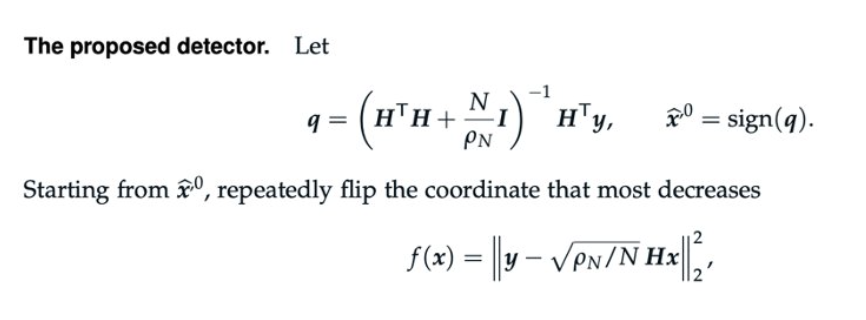
Fable 5給出的路徑不同,用的是「符號LMMSE,加貪心逐位翻轉」,一個業內實際在用、卻從沒被嚴格證明過的老算法。
兩條路徑都各自給出了完整的證明,聲稱能在信噪比2logN精確恢復。
Dimitris最終選擇了Fable給出的這條路,讓GPT接手檢查和修補裏面的漏洞。
GPT把漏洞修好了,但修好之後的證明是一堵「符號牆」,變量指着變量,被指着的變量又指着更多變量,而且塞滿Dimitris看不懂的矩陣分析工具。
接下來的幾天,他反覆讓兩個模型互相簡化對方給出的論證,唯一的底線是,不管怎麼簡化,最後都要保住2logN這個門檻。
除此之外,只要他自己能看懂,怎麼改都行。
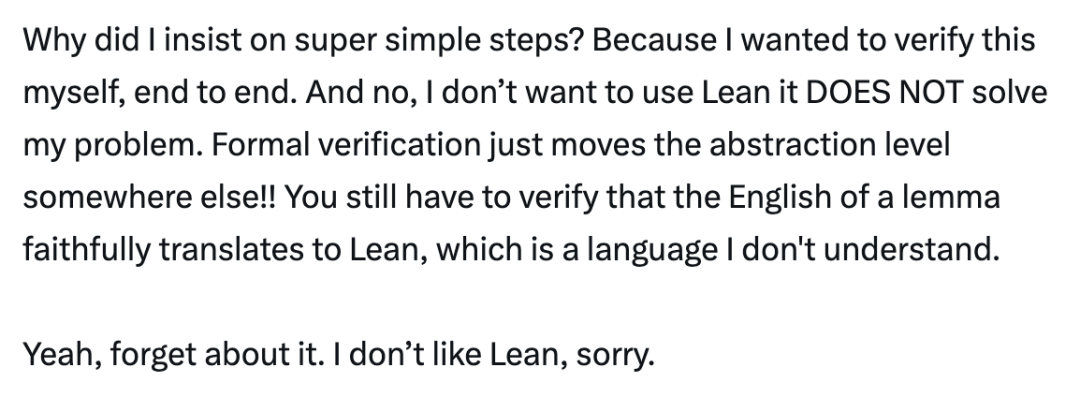
他還拒絕了用Lean做形式化驗證,原因也很抓馬,因為……他不懂。
Lean是一種能讓計算機自動檢查數學證明是否成立的工具,但要用它,得先把證明翻譯成Lean能讀懂的形式語言。
這道翻譯工作本身也可能出錯,而Dimitris不懂Lean,也就沒法檢查翻譯對不對。
總之折騰了一周後,他終於拿到了一份可以逐行手算覈對的證明。
拆開看,這個算法只有兩個核心步驟。
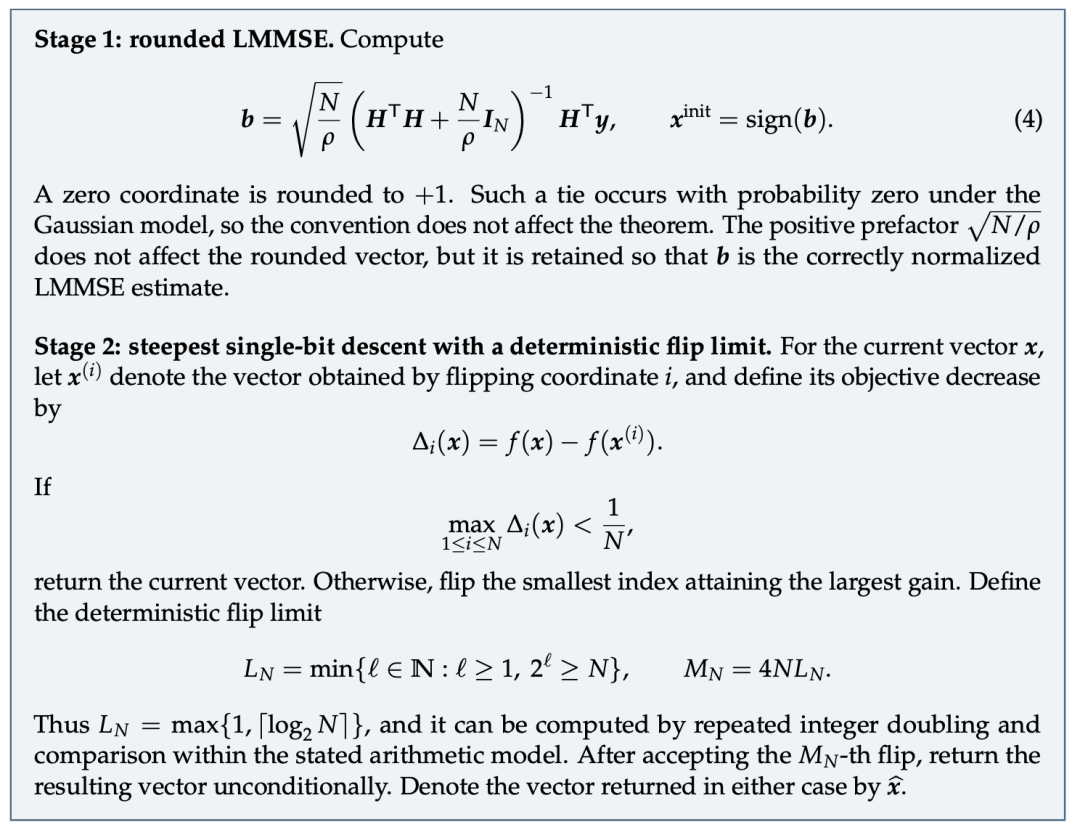
第一步,叫LMMSE取整。
LMMSE(linear minimum mean square error,線性最小均方誤差估計)是信號處理裏的一種標準估計方法,先給出一個不是整數、連續取值的粗略猜測,再把每個座標按正負號取整成+1或-1。
這一步不需要精確猜中每一個比特,論文證明的是,取整後的結果和真實發送的比特之間,漢明距離(兩個等長比特串之間不同的位數)只有o(N)。
也就是說,隨着N變大,猜錯的比特數佔總數的比例會趨近於零。
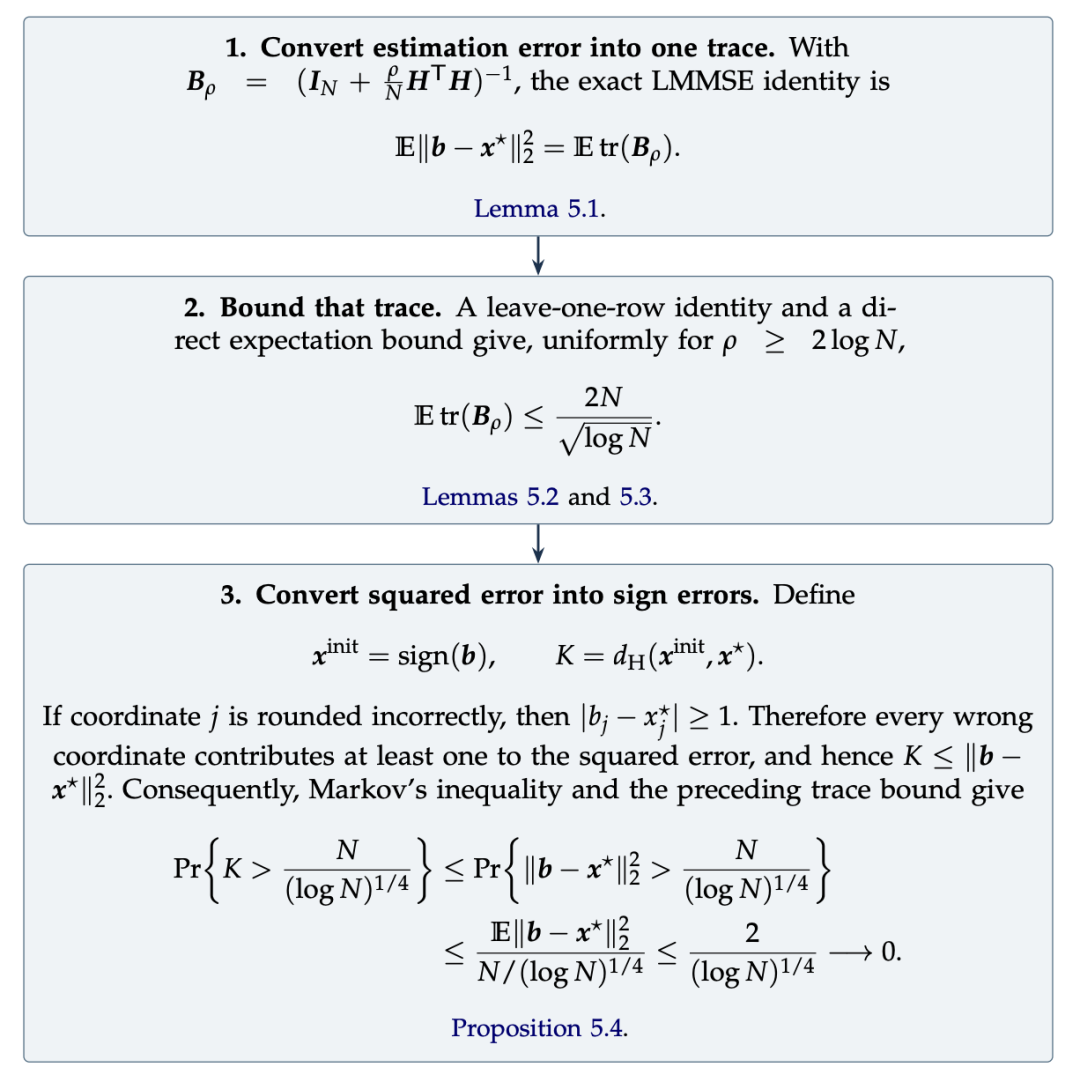
第二步,叫貪心逐位翻轉。
這步從第一步給出的猜測開始,每一輪檢查所有N個比特,找出翻轉哪一位能讓代價函數(衡量當前猜測和接收信號匹配程度的一個數值,越小越匹配)下降得最多,就翻轉那一位,然後重複這個過程。
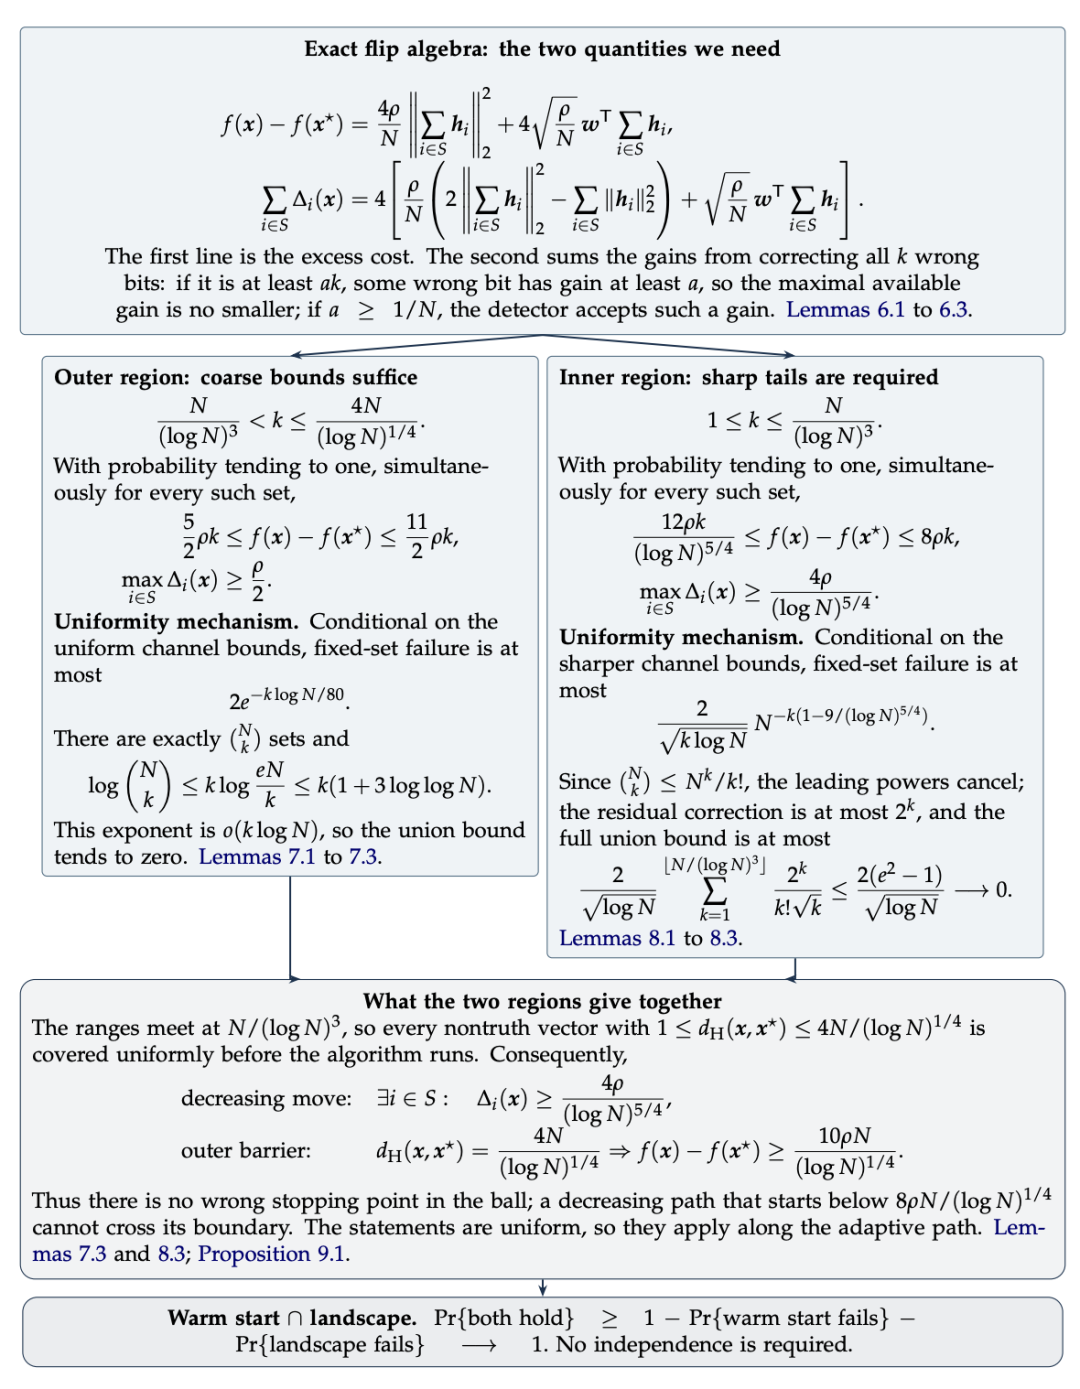
問題是,這樣的貪心搜索憑什麼能找到正確答案,而不是在中途卡在一個錯誤的地方不動?
為了回答這個問題,論文證明了兩件事。
第一,在猜測起點周圍的一個範圍內,每一個還沒猜對的點,都至少存在一位翻轉能讓代價函數嚴格下降,而且下降的幅度有一個不趨於零的下限,不會隨着N變大而消失。
這意味着貪心搜索不會卡死不動,永遠能找到繼續往下走的一步。
第二,代價函數本身會隨着漢明距離(也就是猜錯的比特數)增大而增大。
這形成一道天然的護欄——搜索路徑就算中途某一步猜錯的比特數量暫時變多,代價函數也回不到起點,沒法翻越這道護欄跑到猜測範圍之外。
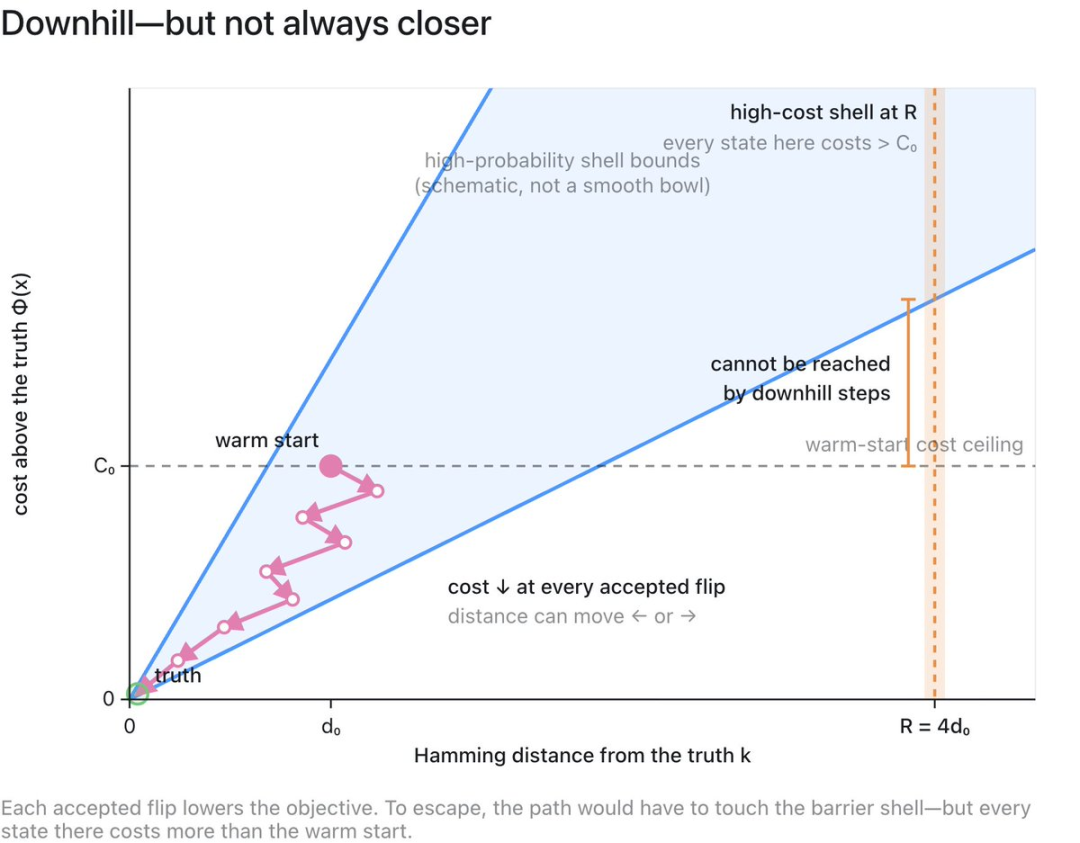
把這兩件事放在一起看,每一步至少能降低多少代價,除以起點距離最優解總共差多少代價,就得到貪心搜索的算法複雜度,論文算出來的答案是O(NlogN)步。
貪心搜索有一條停止規則,那就是找不到任何能讓代價下降的翻轉時,就停下來。
前面已經證明,護欄內每一個猜錯的點,都還有至少一位翻轉能讓代價下降。
也就是說,只要還沒猜對,算法就一定能找到下一步該翻哪一位,不會停。
等真的猜對了,任何一次翻轉都只會讓代價變得更差,這時候纔沒有能改進的翻轉可選,算法這纔會停下來。
貪心搜索唯一能停下的地方,就是真實發送的那個比特串。
算法最終只會停在真實發送的比特串上,證明也就完成了。Dimitris表示,這一整套論證過程,自己已經從頭到尾驗證過一遍。
作者簡介
Dimitris Papailiopoulos,現在是微軟研究院的首席研究員,同時是威斯康星大學麥迪遜分校電子與計算機工程系的副教授。
他早年的研究方向是信息論和編碼理論。
2009年,他還是博士一年級學生,寫下了第一篇論文,並於次年發表,合作者是導師Alex Dimakis。
那篇論文用一種叫MCMC(馬爾可夫鏈蒙特卡洛,一種靠隨機採樣逼近答案的計算方法)的方法,嘗試解決MIMO檢測這道題,但沒有成功。
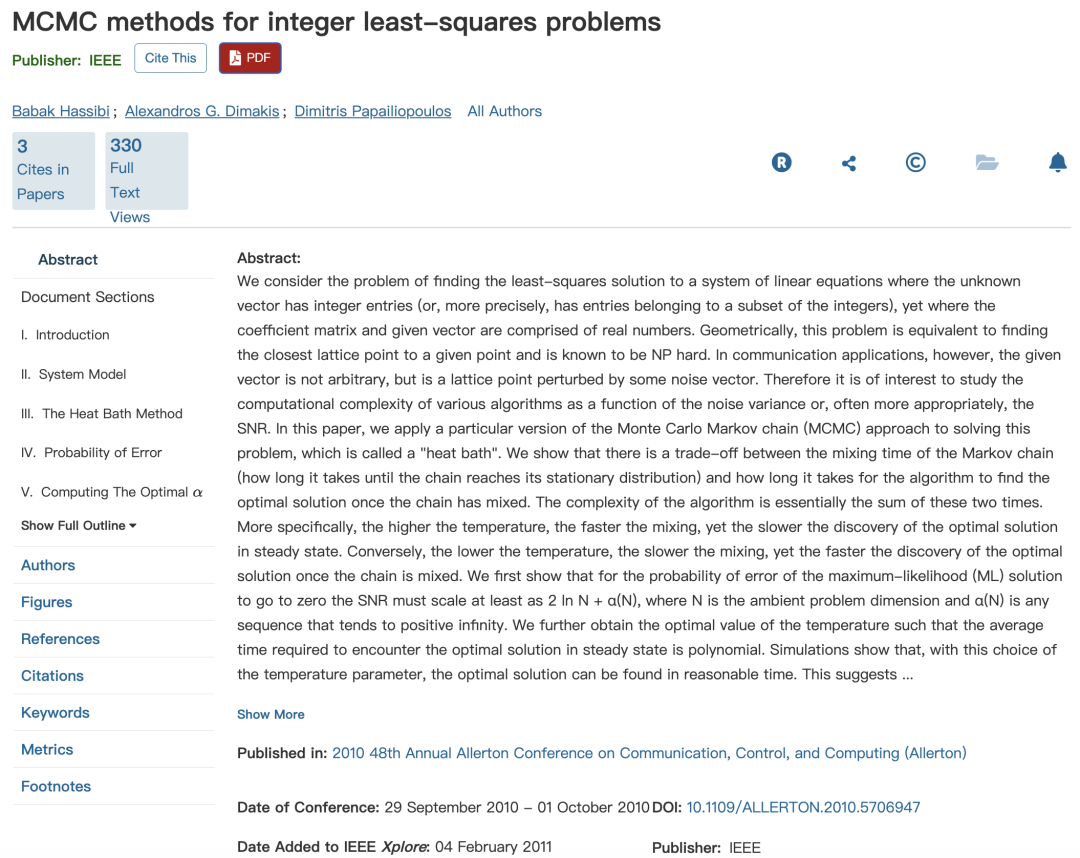
這次被GPT-5.6和Fable 5證明拿下的,正是同一道題。17年前那道讓他卡住的題,這次被他自己解開了。