衡宇 發自 凹非寺
就離譜?
GPT-6 Astra刷到快滿分的ARC-AGI 3,一個手機能跑的4B小模型也能刷爆。
更準確地說,是4B Qwen+753B GLM 5.2的組合。
其中,GLM-5.2待在雲端,手機端只需運行4B的Qwen-3.5。大模型全程不輸出一個字,小模型負責把最終答案寫出來。
具體技術細節尚未公開,背後團隊Mostik拒絕在此刻披露,「因為比賽還沒結束」。
但他們公開了核心發現:
AI模型之間一直在用一種極其低效的方式交流。
Mostik認為,他們搭了一座橋,讓模型之間的信息傳遞效率提升了幾個數量級。
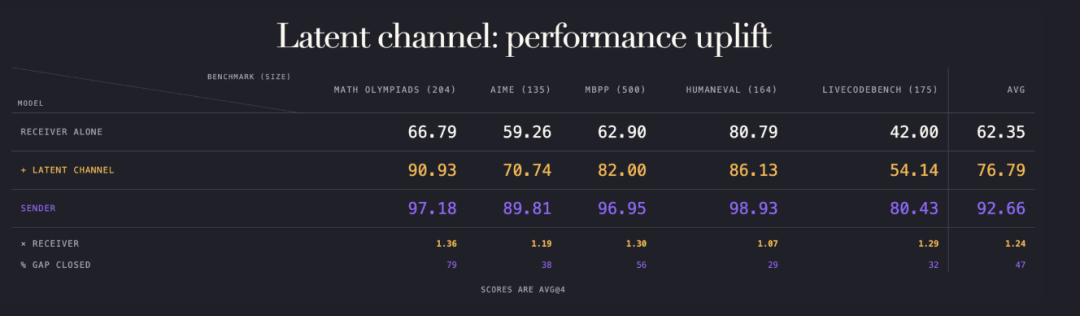
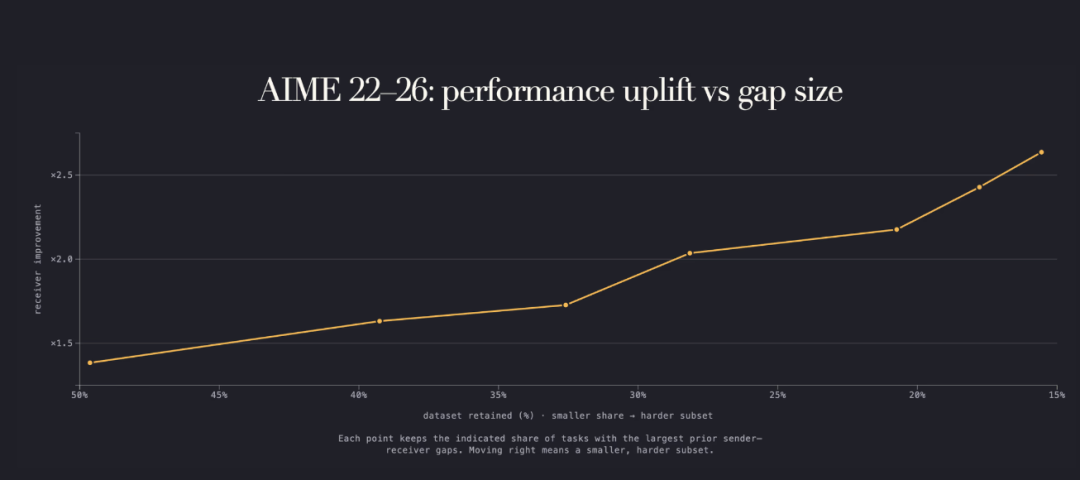
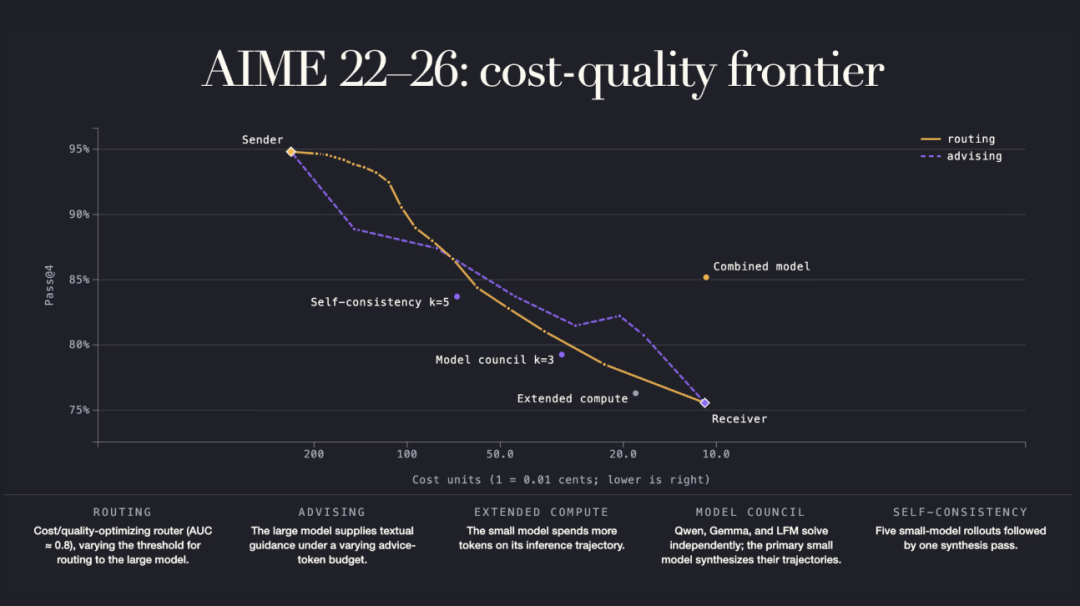
按團隊披露的實驗結果,這套方案能讓4B模型補上與753B模型之間約50%的性能差距,自身準確率提高25%。在大小模型差距更明顯的難題子集上,提升達到2倍。
而大模型側的推理成本,被壓到了原本約二十分之一。
Mostik成立僅4個月,團隊共15人,其中12名博士。
團隊裏還有一位菲爾茲獎得主——2010年證明了統計物理中「滲流模型」和「平面Ising模型」的共形不變性的俄羅斯數學家Stanislav Smirnov(斯坦尼斯拉夫·斯米爾諾夫)。
兩兆字節與十七比特
大模型生成一個token的過程中,內部會構建超過一百個隱藏向量,總共包含大約一百萬個數值,約兩兆字節的內部狀態信息。
然後,它從大約15萬詞的詞表中挑出一個token輸出。
17個比特離開模型,兩兆字節被丟棄,不會再被使用。
目前所有讓多個模型協作的系統,包括編程子智能體、模型委員會、路由調度,全部建立在這17個比特之上。
模型之間唯一的溝通渠道就是文本。
那麼被丟掉的兩兆字節裏到底裝着什麼?
近兩年的可解釋性研究給出了明確答案,是深層計算的核心內容。
一篇ICLR 2026發表的論文顯示,Qwen-3在寫出「accountant」這個詞之前好幾個token,內部就已經攜帶了這個詞的表徵,正是這個表徵讓模型提前選對了冠詞「an」而非「a」。
而且模型越大,這種提前規劃的能力越強,內部狀態中攜帶的」未說出口」的信息越多。
Anthropic的可解釋性團隊在Claude 3.5 Haiku上也觀察到了類似現象:模型寫詩時,落筆之前就已經確定好了韻腳。
他們進一步發現了一種叫」J-space」的結構——模型在任意時刻都維護着一組未表達的概念,既不是輸入的回聲,也不是對下一個token的猜測,而是當前正在處理的信息。
Anthropic團隊自己總結道,這些測量揭示了從未出現在輸出中的內部推理和反應。
這意味着,當一個模型為另一個模型寫出一段文字時,丟失的不是格式信息,而是做出選擇背後的深層計算過程。
給大模型和小模型架橋
用一句話概括Mostik做的事情:
讓一個模型把自己的隱藏狀態通過一個小型的、經過訓練的橋(bridge),直接傳遞給另一個模型,接收方拿到這些內部狀態後直接使用。
整個過程不產生任何文本,兩個模型的權重完全凍結不動,橋是系統中唯一被訓練的部分。
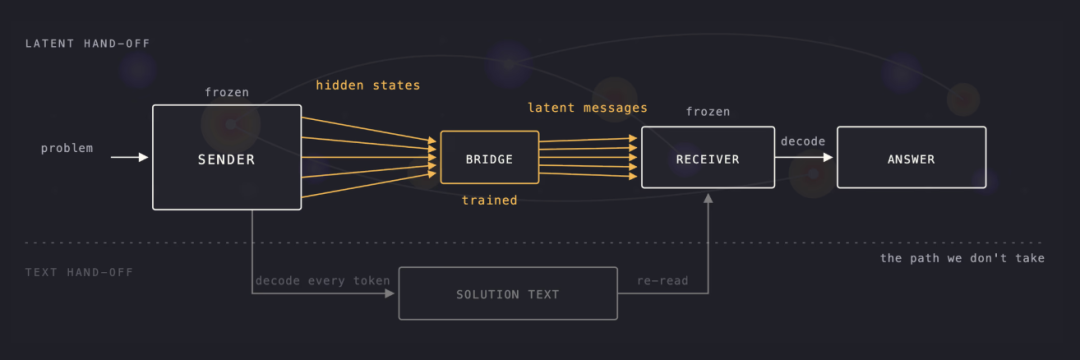
在公開演示中,他們選了智譜的GLM-5.2(753B參數)做發送方,阿里的Qwen-3.5(4B參數,可在手機端運行)做接收方。
大模型自始至終不生成任何文字,它只讀取問題,隱藏狀態穿過橋傳遞出去,然後停止。
所有文本生成都由小模型完成。
這裏有一個關鍵的成本設計——
模型運行中,逐個生成token的」解碼」環節最貴,而一次性讀取整個輸入的」預填充」環節便宜得多。
Mostik的做法恰好讓大模型只做預填充、不做解碼,把最貴的活全交給小模型,算力開銷因此大幅下降。
結果4B小模型在「橋」的加持下,彌補了它與753B大模型之間50%的性能差距,自身準確率提升25%。
在更難的題目子集上,也就是大小模型之間差距更明顯的地方,提升達到了2倍。
從算力角度換算,要在不用橋的情況下跑出同樣的成績,需要部署一箇中等規模的模型,而橋方案的計算成本僅為這個中等模型的五分之二。
團隊還把這套方案和其他標準的模型組合方法做了對比,包括傳統的文本接力。
在所有測試的大模型算力水平上,橋方案都表現更好。
優勢在「交接點極早」的情況下最明顯,此時文本接力根本沒有內容可傳,因為大模型還沒來得及寫出任何文字,但隱藏狀態中已經包含了模型在處理問題過程中積累的信息。
隨着給大模型分配更多算力,兩種方案的表現最終都會趨近大模型本身的水平,但橋方案在整個過程中的性能-算力權衡都更優。
值兩個模型在實驗中完全凍結。
GLM-5.2和Qwen-3.5大家都熟悉,一個來自智譜,一個出自阿里,由不同團隊、用不同數據訓練而成,但它們的內部表徵能通過一個橋完成有效的信息傳遞,而不需要對任何一方做微調。
Mostik團隊表示,他們刻意凍結雙方來做嚴格測試,如果有用信息能在這種條件下通過,說明橋所利用的結構是模型訓練過程中自然產生的。
Mostik首席科學家、菲爾茲獎得主Stanislav Smirnov指出,在兩個AI模型之間找到數學上的共同基礎其實非常困難,「目前似乎還沒有合適的數學語言來描述這件事」。
15人團隊,菲爾茲獎得主坐鎮
Mostik在俄語裏意為「小橋」。
這家公司成立僅4個月,團隊共15人,其中12人為博士。
首席科學家Stanislav Smirnov是日內瓦大學教授,也是2010年菲爾茲獎得主。
Smirnov認為,在兩個AI模型之間找到可用的數學共同基礎,其實極難。目前似乎還缺一套合適的數學語言,來描述模型表徵究竟如何對應、如何遷移。
CEO Sasha Malysheva則是這套核心方法的開發者之一。
她曾提到,自己最早發現數學天賦,源自她親哥的一句「你解不出我準備數學奧賽的題」。
公司內部還有個關於AI未來的比喻。
猜一頭豬有多重時,一群普通人各自報數,取平均值,常常能得到比單個專家更接近真實值的結果——多個AI模型協作,也可能有類似潛力。
眼下的問題恰好出在協作成本太高,模型們要先把內部計算壓縮成文字,再把文字重新展開成下一輪計算。
現在,Mostik想跳過這道手續。
Malysheva判斷,未來未必由單一巨型模型包打天下。更有可能是讓前沿模型與生物、物理等領域的專用模型高效配對。
「橋」的下一步
連接已經訓練好的模型只是第一步,Mostik正探索兩條後續路徑。
其一是蒸餾。
傳統蒸餾裏,學生模型看到的多為教師模型最終輸出層的信號。倘若「橋」能把教師的內部狀態同步給學生,監督就能更早進入生成過程。
團隊表示,早期結果顯示,學生模型在相同訓練預算下能更接近教師。
其二是專項化。
小模型帶着橋訓練某一專業領域能力時,學習效率更高,同時有機會保留原來的通用能力。若這一方向繼續成立,給大模型增加新技能,或許不再總要重訓整套系統。
團隊還提到了安全上的可能性。鏈式思維能提供一部分監控線索,但部分異常行為仍可能繞開它。
橋在兩個模型間增加了一個新的觀察面,發送方隱藏狀態、轉換結果與接收方行為都可以被記錄。
當然,這些方向仍在早期階段。
橋是否能跨越更多模型、更多任務和真實業務負載,能否成為可靠的可觀測性工具,都還得繼續驗證。
但至少在ARC-AGI3上,一座讓大模型「閉嘴思考」、再由小模型代為表達的小橋,已經刷出了相當離譜的成績。