作者 | 江宇
編輯 | 漠影
2026年,世界模型正在快速升溫,尤其是在具身智能賽道。
今年5月至8月,至少10傢俱身智能公司先後拿出了各自的世界模型方案;剛結束不久的世界機器人大會上,世界模型也成為多家機器人廠商集中展示的技術方向。
短短幾個月,這條此前仍在持續探索中的技術路線,迅速成為具身智能公司的重點佈局之一。
問題也隨之而來:這麼多公司扎進世界模型,究竟是技術發展走到了這裏,還是一個新的熱門概念正在被快速「複製」?
並且對於機器人來說,世界模型真正要解決的,已經逐漸超出預測「未來會發生什麼」。它還需要幫助機器人建立對環境變化的內部理解,並進一步服務於動作生成、規劃和決策。
也正因如此,不同公司雖然都在講世界模型,實際選擇的技術路徑和目標並不相同。
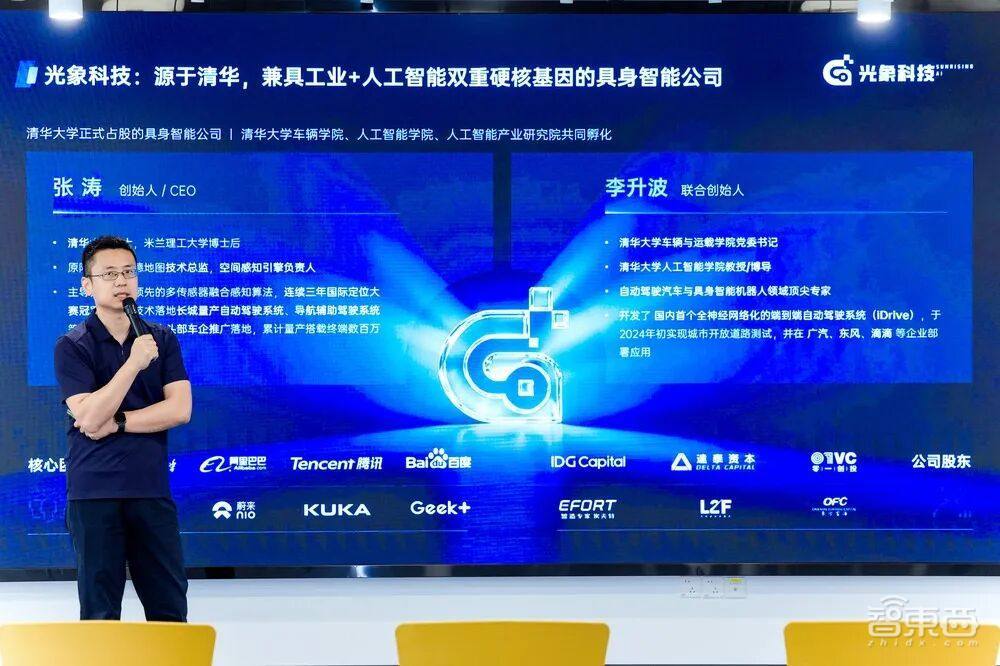
8月25日,光象科技聯合清華大學李升波教授課題組發布物理原生世界模型Phi-WM 1.0 ActEffect。這是其「物理原生智能」技術路線的首個模型化成果。
與此同時,這款模型對於光象科技還有另一層意義。
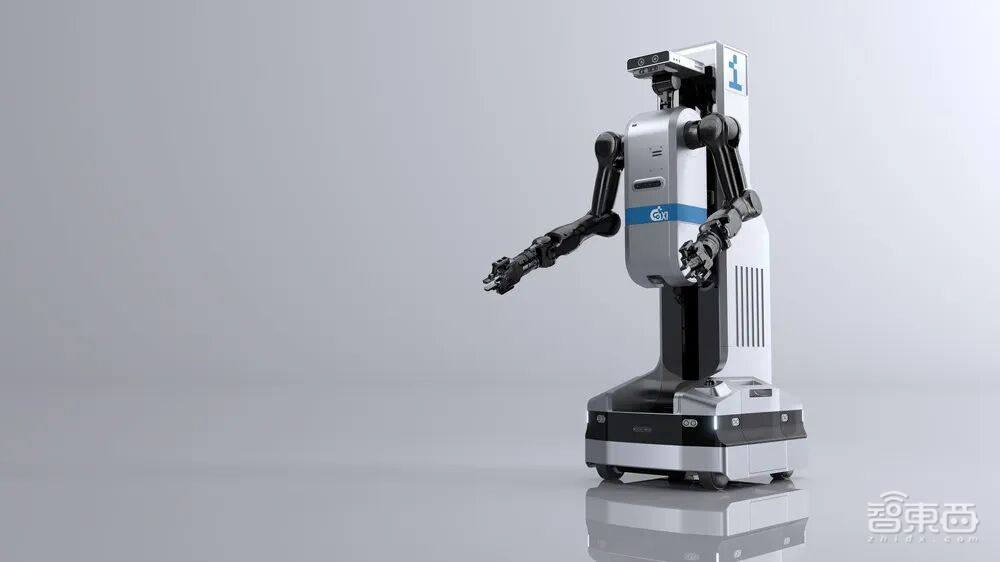
兩個月前,光象科技啱啱把工業級自進化具身智能機器人Phi-Bot X1帶進汽車製造場景。如今,其正在繼續補上機器人背後的通用具身大腦,並嘗試把世界模型、數據、算法、機器人本體和真實工業產線放進同一套循環裏。
當越來越多具身智能公司湧向世界模型,或許更值得關注的是:這些模型能力最終能不能在真實世界裏兌現?
一、世界模型擠爆2026,具身智能開始補課「世界理解」
2026年,世界模型進入集中爆發期。
一邊是具身智能公司快速跟進,另一邊是視頻生成、自動駕駛等領域持續加碼。世界模型正在成為AI進入物理世界時繞不開的一條技術路線。
背後的原因並不複雜。
當前不少具身智能模型仍大量依賴模仿學習。機器人看過人類怎樣完成任務,再根據輸入生成相應動作。這種路徑在固定任務上已經展現出不錯效果,但真正進入複雜環境後,問題會迅速增加。
同一個零件,位置可能發生變化;同一個動作,接觸角度、速度和力度略有不同,結果也可能完全不同。更長的任務裏,前面一個微小偏差還可能不斷向後累積。
因此,僅僅學會「看到什麼就做什麼」,很難覆蓋現實世界不斷變化的環境和長尾任務。
世界模型提供了一條新的思路:讓AI在內部建立對環境狀態和變化規律的表徵,並據此預測未來、輔助規劃和決策。
但「世界模型」本身已經不是一個統一概念。
機器人面對的要求則更加直接——一個動作執行以後,真實物體到底會怎麼變化。
光象科技對這一問題的判斷還要再往前一步。
VLA更擅長學習「看到什麼就做什麼」,普通世界模型更擅長回答「未來會變成什麼樣」。機器人真正進入現實環境後,還需要理解另一層關係:我採取這個動作以後,世界為什麼會這樣變化?
汽車上下料就是一個典型例子。
傳送帶會自行運動,光照會發生變化,零件也可能因為振動產生輕微位移。與此同時,機械臂的推、抓、抬、放又會主動改變物體狀態。
如果這些變化全部被混在一起,模型即便可以較準確地預測下一步狀態,也未必能夠分辨哪些變化來自環境本身,哪些來自自己的動作,更難回答:「如果換一個動作,結果會怎樣」。
這也成為光象科技切入世界模型的核心問題。具身智能對世界模型的需求,正在進一步落到「動作—後果—世界變化」這條因果鏈上。
二、預測未來還不夠,機器人還要理解「動作後果」
圍繞這一判斷,光象科技將整套技術路線定義為「物理原生智能」(Physics-native Intelligence,Phi)。
其目標是讓機器人在持續物理交互中學習世界底層運轉規律、動作帶來的行為後果,以及物理準則和安全約束,並最終形成可以閉環自進化的智能體系。
這套體系包含三個基本特徵。
第一個是狀態解耦表徵。
對於機器人的關節角、速度、物體位置、姿態、接觸力等可以直接刻畫的顯式物理狀態,光象希望更多利用已有物理知識描述。
其次,對於圖像、視頻、點雲裏難以直接建模的隱式狀態,交給神經網絡學習。
第二個是時序因果驅動。
物理世界裏的動作和後果存在先後關係。夾爪提前閉合幾毫米、移動速度變化、接觸角度偏一點,後續狀態都應該發生相應變化。而世界模型需要對這種動作干預保持敏感。
第三個是物理定律約束。
物體不能瞬移,接觸不能憑空消失,長時間推演也不能不斷產生偏離現實的狀態。
光象科技利用對稱、守恒和結構保持等底層約束,提高了模型長期運行的穩定性。
簡單來說,其最終目標可被進一步概括為三個更直觀的目標:看得更準、想得更清、運行得更穩。
ActEffect就是這套路線的第一代模型實現,將「動作因果」放進訓練過程。傳統世界模型關心下一幀預測,ActEffect則進一步要求模型判斷:如果機器人採取不同動作,未來狀態是否會按照正確的物理關係變化。
訓練過程中,模型會產生三個精細程度不同的動作提案,可以理解為快速方案、初步修正和最終方案。
隨後,受控世界模型分別預測三個動作執行後可能產生的結果,再比較哪一套方案更好,並用這些反饋繼續優化策略。
放到工廠裏,這相當於機器人不再只學習「師傅的手怎麼抓」,還需要逐漸理解:夾爪早閉合一點會發生什麼,速度變快會發生什麼,角度偏一點又會帶來怎樣的結果。
這種設計直接指向具身智能最難解決的能力之一——泛化。
光象科技創始人兼CEO張濤在交流中舉了一個例子。
如果讓機器人不斷學習把不同物體扔進一個筐裏,傳統方法可以通過大量數據反覆擬合,最終學會處理十種、幾十種不同物體。但第50種、第100種陌生物體出現以後,仍可能需要繼續嘗試和訓練。
如果機器人已經掌握了重量、形狀、速度、重力等底層物理規律,新物體出現後,就有機會利用已經壓縮出來的知識更快適應,而不用完全依賴重新擬合。
這也解釋了光象科技為什麼沒有簡單複製當前最流行的「視頻預測型世界模型」。
光象實驗室首席科學家呂堯認為,純視頻預測能夠很好地利用Scaling Law,數據越多,生成能力通常越強。但機器人最終面對的是高成功率的真實執行任務。如果模型依靠統計相關性擬合未來,中間缺少物理約束和因果關係,「99%到100%」之間仍可能存在難以消除的失敗。
因此,光象科技更關注隱狀態空間裏的物理信號,以及動作驅動的狀態轉移規律。世界模型需要回答的,也由「未來長什麼樣」進一步走向「採取這個動作以後,世界為什麼這樣變化」。
三、世界模型先「退場」,機器人上崗才能輕裝運行
具身智能模型最終要裝進機器人,本身就意味着另一套約束。
訓練階段可以消耗更多算力,真正部署以後,推理速度、算力成本和數據成本都會成為硬指標。
ActEffect在這裏做了一個比較特殊的設計:世界模型主要承擔訓練階段的角色。
訓練過程中,它不斷預測不同動作可能帶來的後果,並用這些反饋優化動作策略。
當訓練完成後,對「動作後果」的理解會被進一步蒸餾到策略模型中。機器人真正部署時,不需要繼續循環生成未來狀態,也不用反覆進行候選動作規劃,只需要策略網絡一次前向計算輸出動作。
換句話說,大量「想清楚這個動作會發生什麼」的過程,被提前放進了訓練階段。這樣做帶來的一個直接結果,是世界模型不會持續成為機器人實際運行時的額外算力負擔。
這一設計直接對應具身智能規模落地中的推理成本——將世界模型移出推理鏈路後,ActEffect的推理算力成本不會隨着訓練成本線性增長。
對於需要連續運行數小時甚至更久的工業機器人而言,這一點很關鍵。
除此以外,數據也面臨類似問題。
目前具身智能行業的一大爭論,是究竟需要多少真實機器人數據。而光象為不同類型數據分配了不同任務。
互聯網視頻和沒有動作標註的數據,可以幫助模型建立基礎世界先驗;
帶有動作信息的數據,則用於學習動作與狀態變化之間的關係;
大量仿真數據負責提供低成本、可控的反事實動作探索;
最後,再將模型放到真實機器人和具體任務環境中做真機後訓練。
張濤透露,目前按照這條訓練路徑,具體任務所需的真機後訓練數據大約為十幾個小時到幾十個小時,最多不超過100小時。這對於機器人複製到更多任務具有直接影響。
工業場景高度碎片化。如果一台機器人每進入一個新工位,都需要重新採集海量數據、重新訓練很長時間,那麼無論模型單點效果多好,規模化都會非常困難。
因此,數據效率、訓練效率和部署成本,實際上與所謂「泛化能力」是連在一起的。
與此同時,在公開Benchmark中,ActEffect目前也給出了一組階段性結果。
在LIBERO、LIBERO-PLUS和RoboCasa-GR1三個機器人操作基準上,其平均成功率分別達到98.8%、80.3%和67.5%。
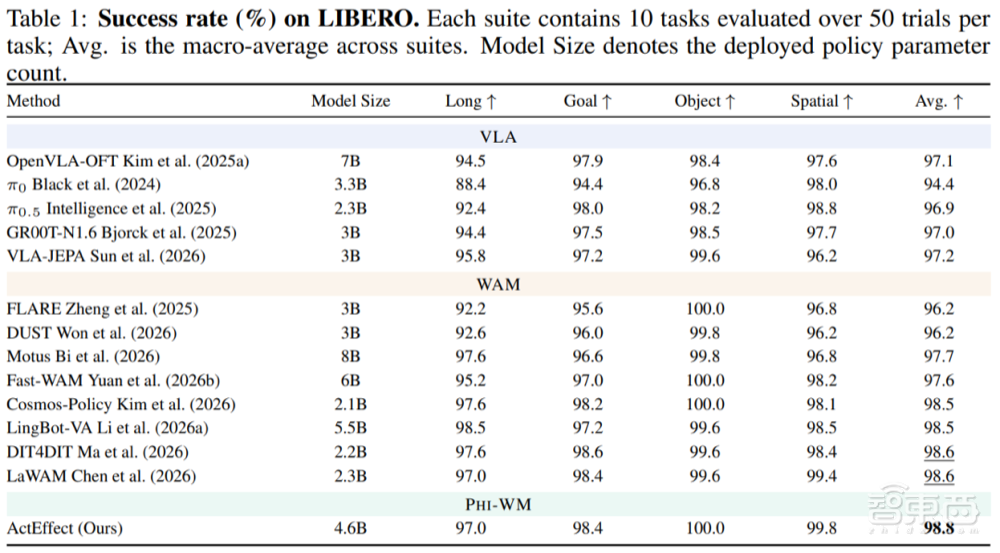
▲LIBERO單臂多任務操作基準,包含空間關係、物體操作、目標條件和長時序四類共四十個任務。ActEffect達到 98.8%的平均成功率,在四組任務(Long、Goal、Object、Spatial)上均取得領先性能。
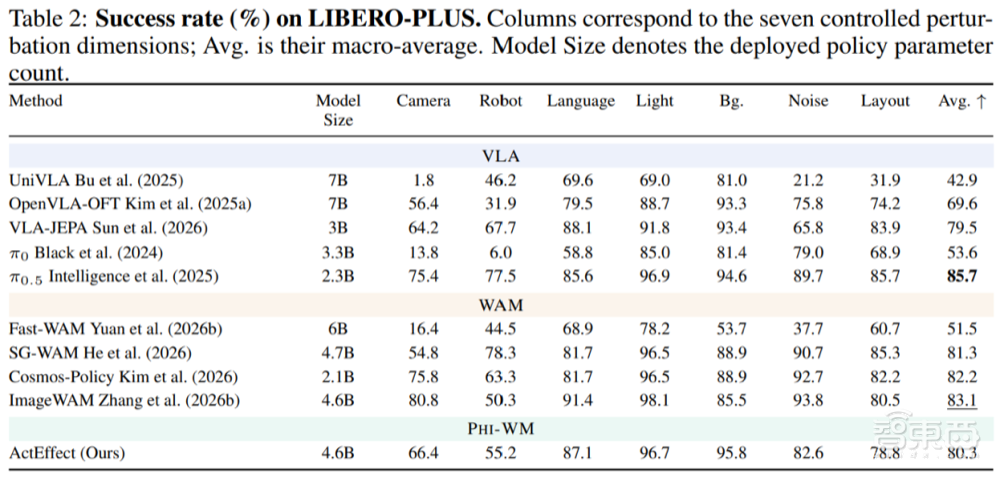
▲LIBERO-PLUS 引入七種受控擾動:相機、機器人初始狀態、語言、光照、背景、噪聲、佈局。ActEffect平均成功率為80.3%
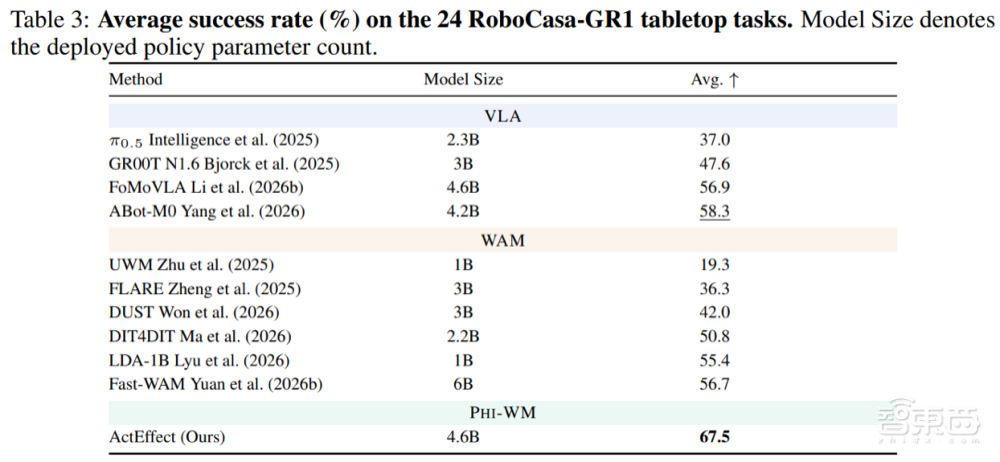
▲RoboCasa-GR1面向Fourier GR-1形態的類人雙臂操作,包含二十四個靈巧任務,每個任務同樣獨立測試五十次,總計一千二百次。ActEffect達到67.5%的平均成功率。
但光象科技自己也對跑分保持了剋制。
呂堯認為,Benchmark最終仍需要回到真實機器人和真實產線驗證,看具體任務成功率和實際創造的客戶價值。
四、車廠驗證之後,光象科技繼續加碼「具身大腦」
對於光象科技而言,物理原生智能的意義還在於把此前已經進入工廠驗證的機器人,與更長期的模型路線連接了起來。
今年6月,光象科技發布工業級自進化具身智能機器人Phi-Bot X1。
當時,我們曾報道過這家成立僅一年左右的清華系具身智能公司——由清華大學車輛與運載學院、人工智能學院等聯合孵化,創始人兼CEO張濤長期從事自動駕駛感知定位和產業化工作。
與不少先做模型、再尋找落地場景的團隊不同,光象科技從創業早期就把汽車製造作為重要切入口。目前,Phi-Bot X1已經在不止一家豪華品牌車廠的真實正式工位上完成產品、功能和性能驗證,並進入真機部署階段。預計今年年底前,我們還會看到這些機器人正式上崗。
在剛結束不久的世界機器人大會上,其則進一步展示了「一套機器人跨工位」的雛形。
同一台Phi-Bot X1、同一套模型,可以分別完成新能源汽車焊接車間的高精度上下料,以及汽車表面的移動質檢。在WRC期間,Phi-Bot X1還完成了5天累計36小時的焊接上下料與移動質檢雙工位自主循環作業。
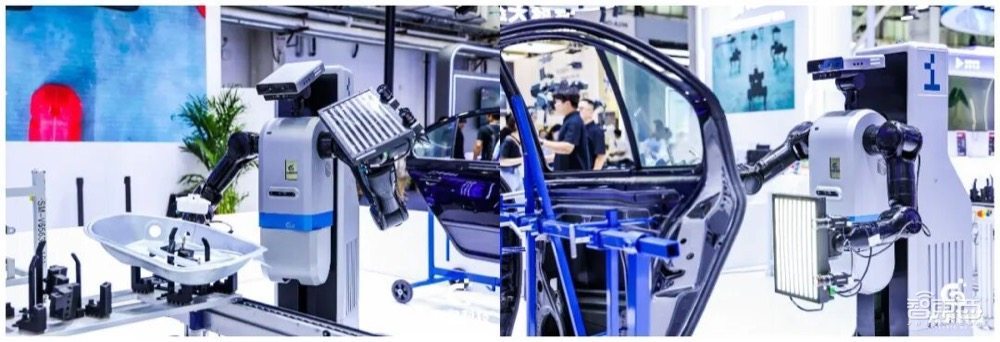
這些場景也讓世界模型和機器人本體之間的關係更加清晰。光象科技希望建立的是一套具身大腦、本體、數據和真實場景共同演進的體系。
機器人進入真實工業環境,可以幫助團隊不斷獲得新的任務、數據和反饋。世界模型和算法則繼續吸收這些信息,再把新的能力遷移到機器人上。
這也對應光象科技一直堅持的軟硬一體路線。
只做大腦難以獲得足夠真實的行業入口和數據閉環,只做本體又容易陷入硬件同質化,具身大腦、本體和產業場景需要同時推進。
結語:世界模型熱潮之後,真正的分水嶺在真實世界
2026年的世界模型熱潮還遠沒有結束。
隨着更多機器人公司加入,這個概念很可能很快失去今天的新鮮感,逐漸成為具身智能公司的基礎技術配置。
屆時,評價一款世界模型的標準也會更加落地。
因為對於機器人而言,物理世界還有一套比Benchmark更嚴格的評分體系。零件有沒有抓住,位置有沒有放準,連續運行會不會中斷,投入以後能不能創造足夠的價值,這些最終都會給模型能力打分。
如今,光象科技選擇用「物理原生智能」回答這道題,並將世界模型、工業機器人和真實產線綁在同一條線上。