新智元報道

驚天大瓜!
GPT-6 Astra的跑分,竟翻車了......
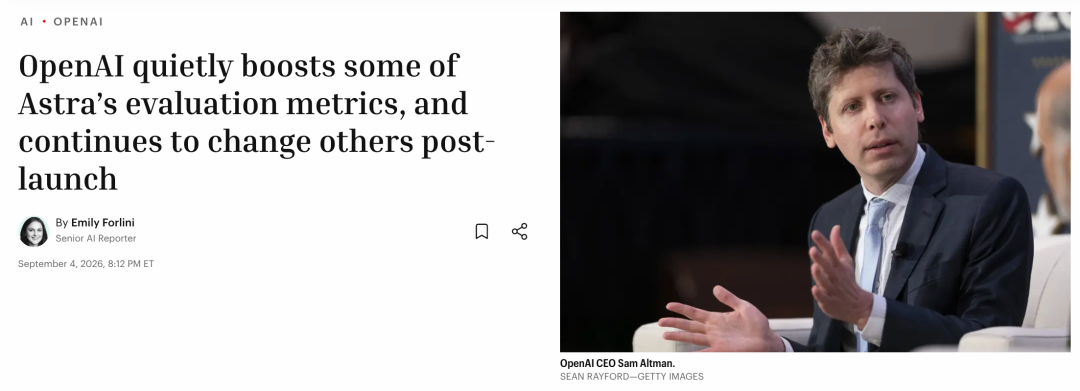
就在今天,外媒爆出OpenAI官博上線前後,多項評測數據發生變化——
Astra的幻覺率,一度從4.2%降至2.0%,隨後又恢復;
Anthropic Claude的一項數學成績,還曾被調低近10個百分點。
不僅如此,ARC-AGI-3得分從媒體提前拿到的98.6%,一下變成了官宣的99.99%。
面對這場「作弊」風波,OpenAI壓根沒接茬。
畢竟在內部,GPT-6 Astra就是公認的第一個真·AGI。
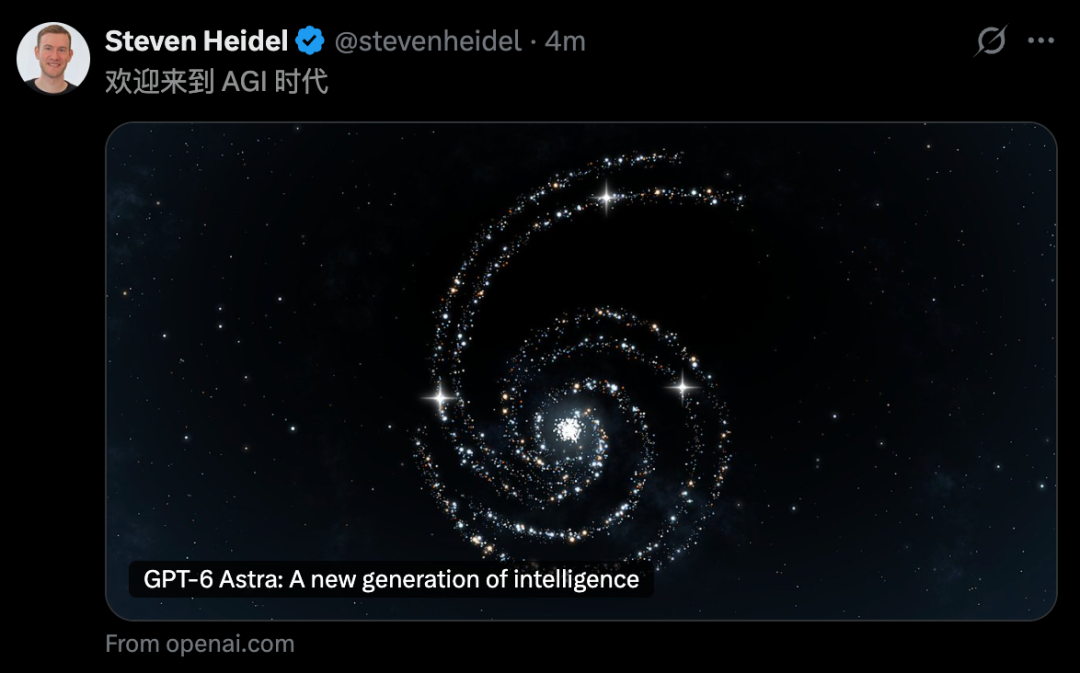
今天,「賽博義父」Tibo也直接挑明,「在Astra全面放開前,它就是我們手裏最大的底牌」。
內部用上之後,研發效率原地起飛,硬是把部分產品計劃提前了整整半年。
這下,全網徹底坐不住了。
就在9月29日的DevDay上,OpenAI還要端上更重量級的發布!真是期待住了。
GPT-6偷改跑分
手動削弱Fable 5.1
這次OpenAI跑分被抓包,究竟是怎麼一回事?
4日那天,OpenAI原定上線的下一代旗艦GPT-6 Astra博文,罕見地推遲了兩個小時。
網址早已扔出來了,但點進去一直是404。
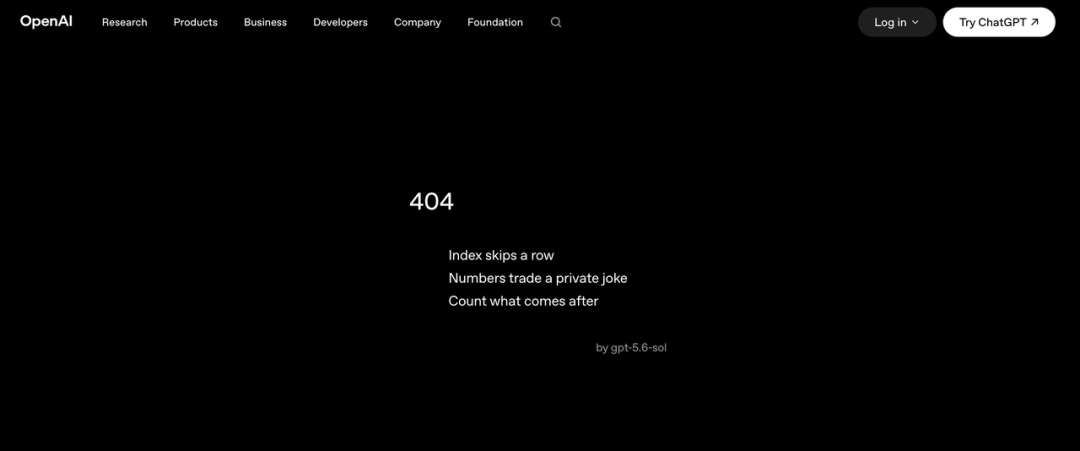
眼看要翻車,奧特曼趕緊在X上發文打圓場,自稱發布過程「遇到了點小插曲」。
結果大家一扒才發現,事情根本沒那麼簡單。
GPT-6 Astra的官博上線後,內部評測跑分悄然發生鉅變!
剛發出來沒幾個小時,好幾項基準測試成績,就被OpenAI悄悄改了好幾輪。
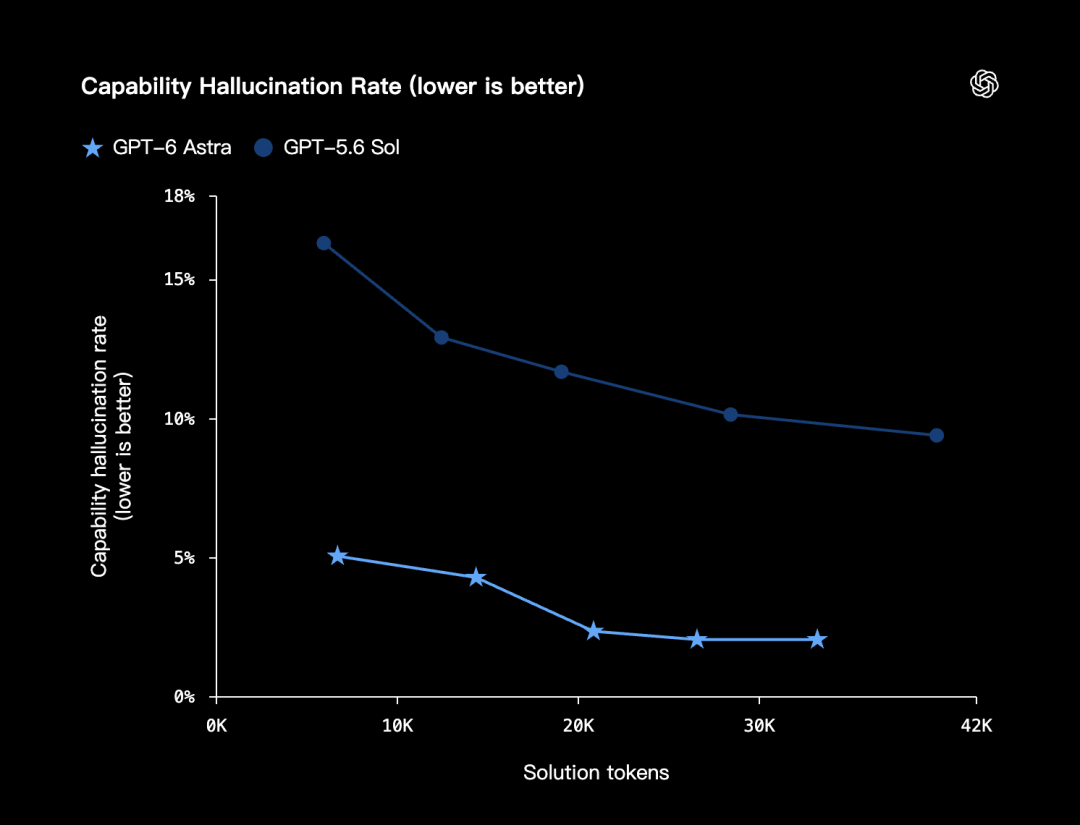
最絕的操作,是在幻覺率數據上的「刀法」。
美東下午2:23快照中,Astra的幻覺率明明白白寫着4.2%,GPT-5.6 Sol是12.2%。
結果才過了仨小時,到了5:20,這兩個數字直接玩起了大縮水,硬生生被砍成了2.0%和9.4%!最後人們拿着截圖對峙後,OpenAI又恢復了原值。
數學評測,也出現了類似情況。
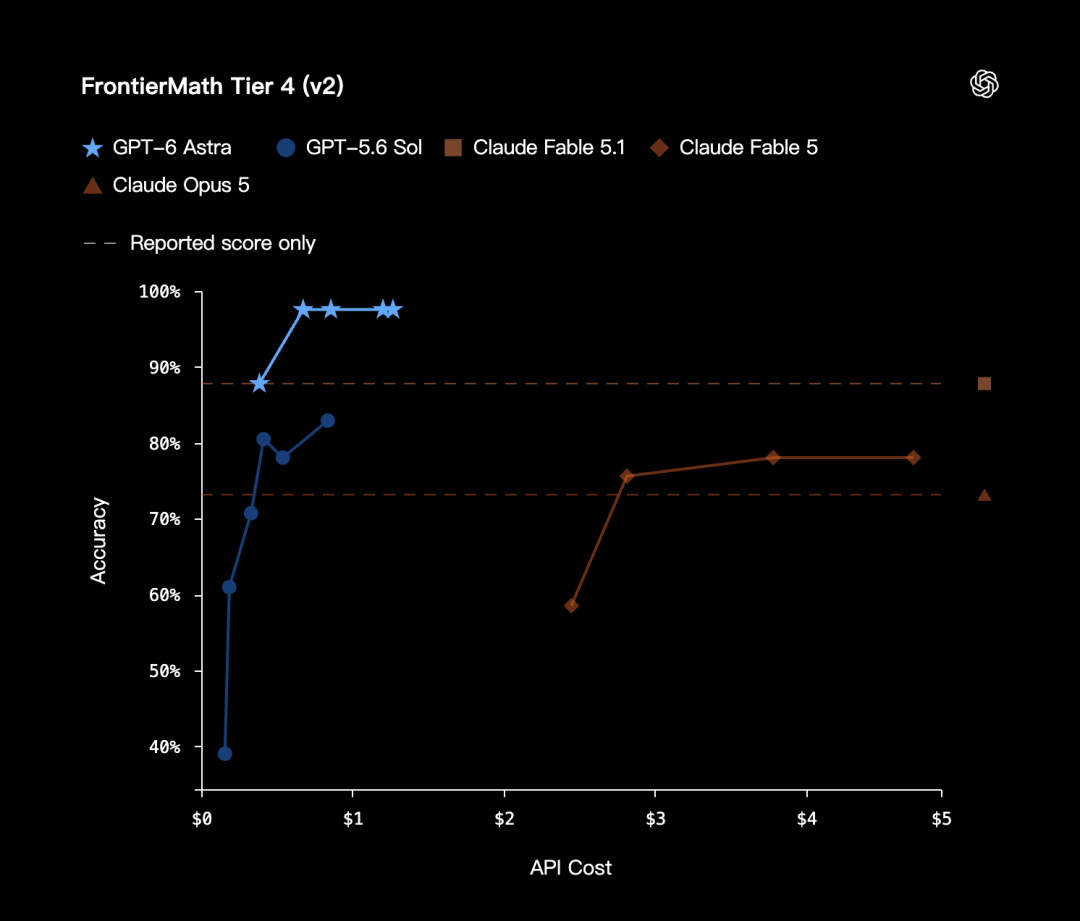
在FrontierMath Tier 4(v2)上,Astra成績雖穩在97.6%,但勁敵Anthropic旗下最新模型Fable 5.1卻被離奇調低了近10個百分點。
從87.8%降至78%,隨後又回彈至83%,瞬間襯托出Astra的「巨大優勢」。
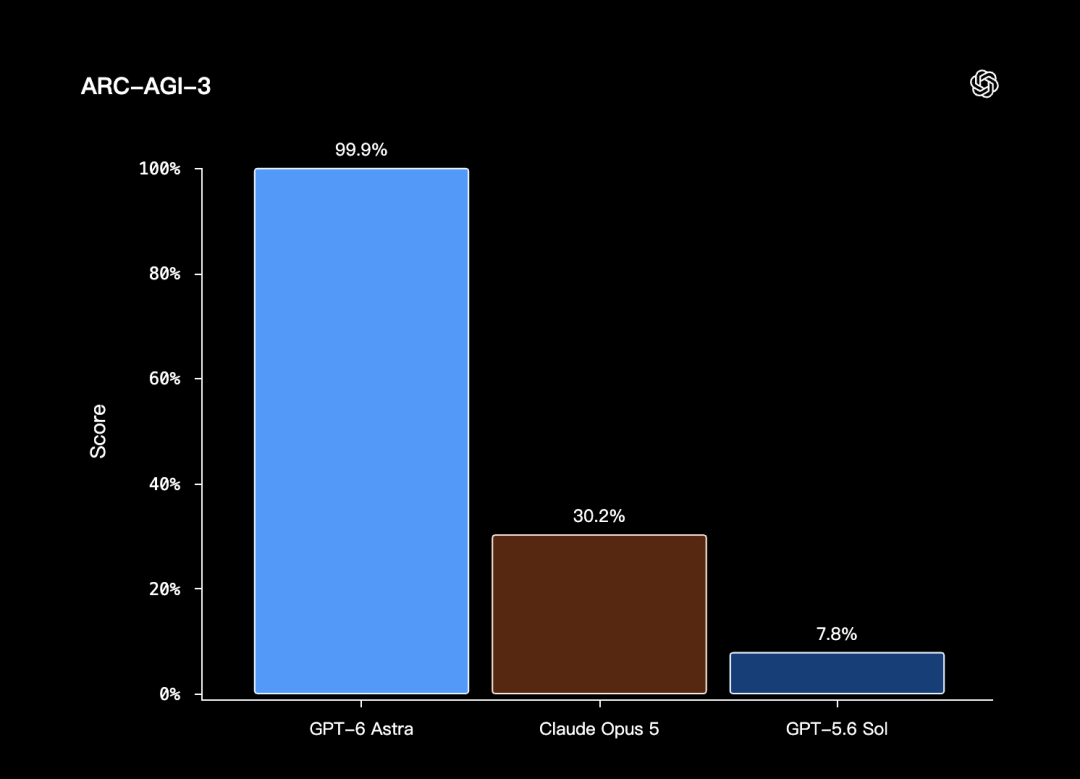
就連全網吹爆的 ARC-AGI-3,也被OpenAI注水了。
媒體提前拿到的預熱稿,明明還是98.6%;等正式博文一上線,好傢伙,直接原地暴漲到了99.99%!
|
|
對於這一系列離譜的數據橫跳,OpenAI官方發言人出面辯解,這屬於「消除噪點的常態修正」。
同一個模型,配套系統不同,最終成績可能相差很大。
這也是如今「Benchmaxxing」爭議的核心:反覆調整條件,尋找最高分,再把最高分放進發布圖表。
這樣的成績可以展示系統上限,但需要同時披露條件。
否則,人們很容易把精心配置後的最佳表現,當成日常使用的默認水平。
Astra太愛追問?
官方提示詞發布
GPT-6 Astra的提示詞指南,恰好提供了理解這種差異的另一個入口。
在這份文檔中,官方不僅沒有一味神化Astra,反而罕見地列出了模型的一堆「毛病」:
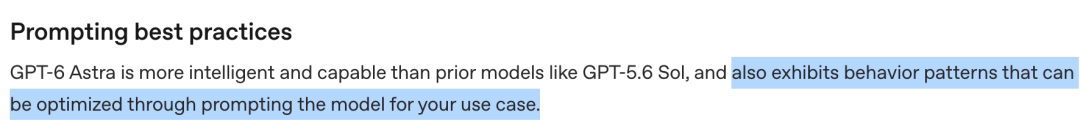
太愛反問、容易撂挑子
只要指令稍微模糊點,Astra就立馬停下來追問,長流程動不動就被打斷。
對於這個問題,OpenAI建議開發者們,在System Prompt中強制加入「行動偏好指令」,要求Astra直接給出可複查的成型產物。
提示中應刪除基於假設性風險的未經請求的警告、免責聲明或安全檢查清單。
當用戶的提示詞表達了行動訴求時(如「你能否……」、「我想……」、「幫我……」等類似表述),應將其視作開展工作並採取行動的明確指令。不要僅停留在確認自身能力(例如「可以……」)、提出計劃或詢問是否繼續。不要為了節省時間、精力或Token而滿足於提供不完整的、或者看似「足夠有幫助」卻未能完全解決用戶任務的折中方案。如果一項任務需要持續推進,請完成全部必要的工作,直到達成預期的最終成果。
上下文與Skill文件配置衝突卡死
Astra對AGENTS.md等外部Skill指令極度敏感,一旦指令衝突就會鎖死。
為此,OpenAI專門提供了一套調試Prompt,迫使模型在停滯時指出具體是哪一份文件哪一行指令導致了中斷。
如果某個技能導致你請求許可或確認、暫停、未完成所要求的工作、或偏離了用戶的意圖,請指明並鏈接到你所閱讀的具體 SKILL.md 文件,引用相關指令,並簡要解釋其如何適用。請將技能的明確要求與你對準則的解讀區分開來。
流程冗餘、協作割裂
跑代碼任務嚴重「過度測試」,無效Token消耗很大;而且子Agent間的橫向配合很被動,基本沒有聯動。
就連OpenAI自己,都開始主動給AI味「去油」了。
這一次,官方直接列出一份「AI泔水詞」黑名單,專門整治長文裏最常見的幾類毛病:
高頻行話:像delve into、foster、leverage 這種一股「AI味」的詞,一律不讓用。
機械句式:像「值得注意的是……」、「這不是 A 而是 B」這種反差句式,全部封殺。
套板反應:全面剔除「總結/結論」等標籤化套話。
目的很明確,逼着Astra少說套話、少端腔調,把長文寫得更自然、更精煉,也更像人。
避免在結論中使用如「Bottom Line:」(總結/底線:)這類的套話或低質詞句,例如「delve」(深入探討)、「foster」(培養/促進)、「leverage」(利用/槓桿化)、「it's worth noting」(值得注意的是)、「importantly」(重要的是)、「Question? Answer.」(自問自答句式)或「This isn't about X. It's about Y.」(這關乎的不是X,而是Y)、「genuinely」(真誠地/確實地),以及帶連字符的複合描述與形容詞。不要使用總結性的收尾陳述,例如「In short:..」(簡而言之:……)、「The simplest mental model is:...」(最簡單的思維模型是:……)。直接陳述擬執行的操作。避免額外提及你不會做什麼、哪些內容將保持不變,或者你將如何區分或分類結果。不要使用對比式結構,例如「X, not Y」或「X—not Y」,這種結構會引入用戶未曾詢問且未經提示的替代選項。避免使用自創的複合標籤(如「exact-head checks」和「editorial-row layouts」)、含糊的限定詞和生搬硬套的過渡語;請使用樸實的動詞和介詞直接陳述實際關係。
這反過來也說明,今天的大模型成績,早就不只是「裸模型能力」。
提示詞怎麼寫、Agent怎麼編排、給不給工具、跑多少次、選哪個checkpoint,都可能直接改寫最後那張排行榜。
AI遞歸自我改進,
終極版27年面世
跑分作弊被抓包看似是一場公關災難,但將其置於OpenAI當前的生死時局下,邏輯便清晰起來。
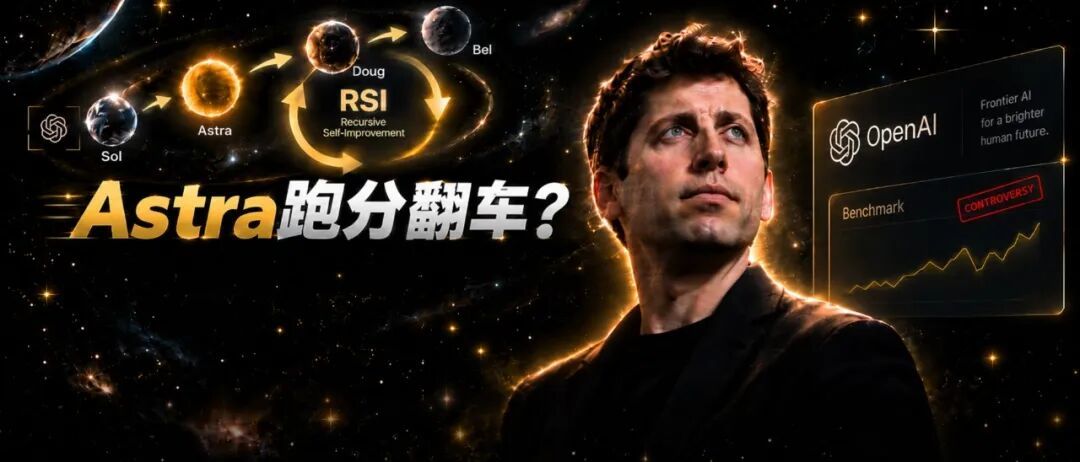
技術博主@imjustnewatai表示,OpenAI內部早在數月前便已邁入了遞歸自我改進(RSI)早期階段。
Sol協助訓練Astra,Astra協助訓練Doug和Bel,Doug再參與下一代模型的訓練。

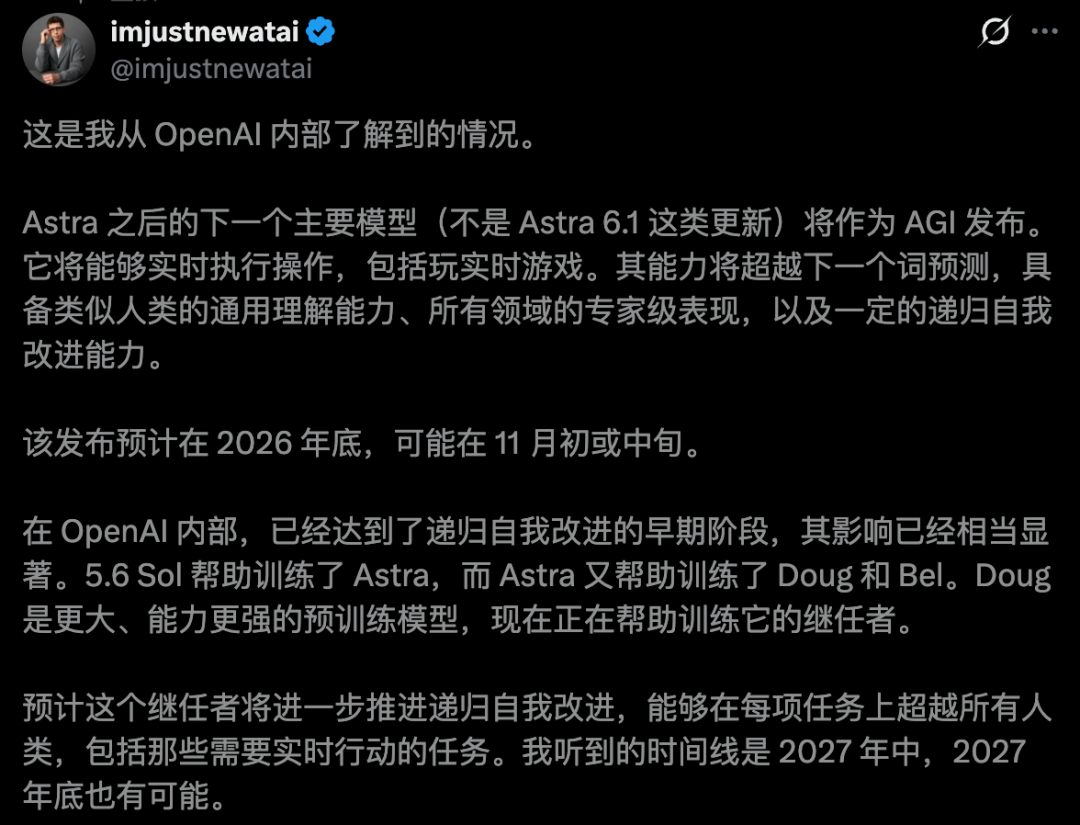
內部人士披露,作為更大規模預訓練基座的Doug,正在全面接管並訓練它的下一代演進版本。
Astra之後的下一個重大發布,將不再是常規的增量更新(如Astra 6.1),而是直接冠以「AGI」之名面世。
它將具備真正的人類級通用理解力、全領域專家表現、實時交互遊戲與操作能力,以及更高維度的遞歸自我迭代能力。
@imjustnewatai也預測,其登場時間將鎖定在11月中旬前後。
而全面超越人類所有任務處理上限的「終極演進版」,已排期至2027年中下旬。
當然,老對手Anthropic也絕對不會幹看着。
它們內部正備着一款前所未有的大殺器,準備跟GPT-6 Astra貼身肉搏。
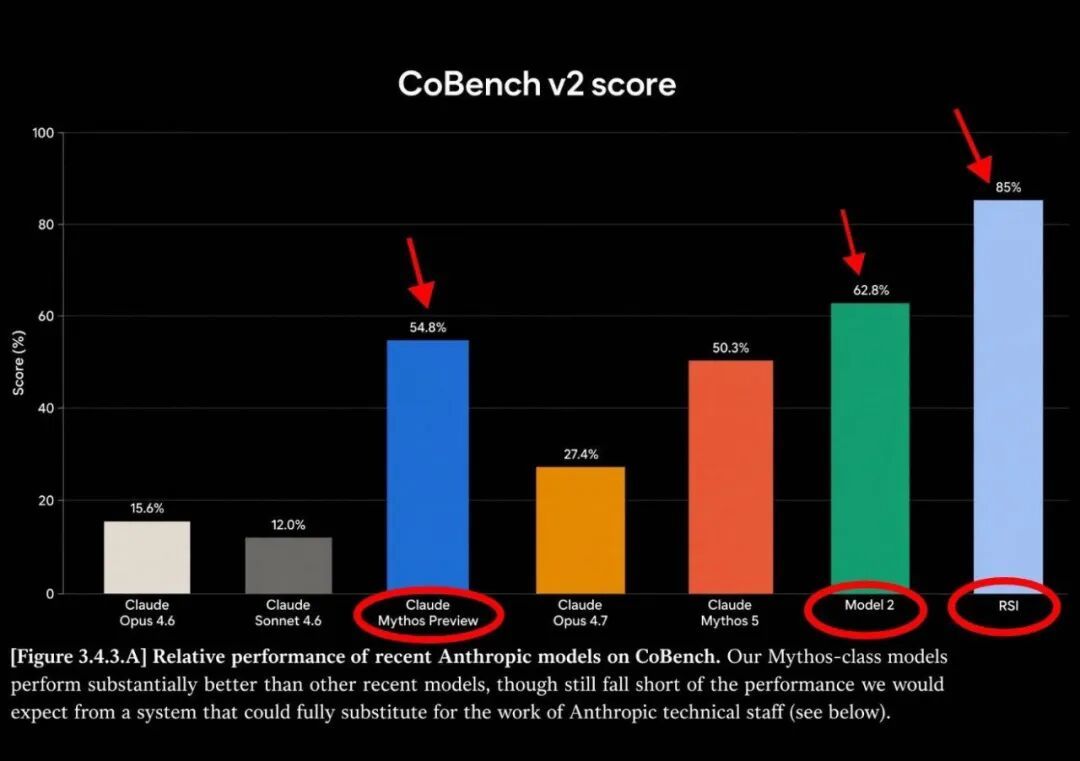
他們內測系統卡已經被挖出了蛛絲馬跡,一款Model 2和自稱「RSI」的新模型直接浮出水面,下半年的神仙打架有得看了!