來源:36氪
文|王毓嬋 溫麗虹
編輯|張雨忻 楊軒
得知那位98年的同事,一位一線算法研究員跳槽去一家頭部大廠後的年薪時,朱可欣覺得眩暈。
漲幅高達3倍——朱可欣和同事們在聚餐上猜測對方拿了多少時,「大膽猜測漲50%」。但答案揭曉,是從100萬漲到300萬,這遠超他們預料。一頓飯的時間,飯桌上所有人對自我定價都重估了一遍。
舊有的薪資座標被迅速改寫,「眩暈」不斷髮生。距離那次跳槽僅一年過去,朱可欣說,現在已經沒人會對一線研究員拿300萬年薪感到驚訝了。
高昂年薪的年齡層還在下探。
一名00後研究生還沒走出校園,就以實習生的身份領着5000元的日薪,月收入比這座大城市的大部分白領都高出許多。他的上級跟他交過底,「畢業轉正可以給到年薪300萬。」這位年輕人很直白地告訴36氪,他今年就想馬上畢業。
從硅谷到中國,當頂尖AI人才在以億級年薪和「一號位送溫暖」被爭搶時——字節AI一號位吳永輝是張一鳴花了8個月才促成的;而Meta不僅能開天價,扎克伯格會給他想挖的OpenAI研究員「送親手做的湯」——整個AI人才金字塔中,從塔尖到塔基,每一層人才的價格都在被不斷推高。
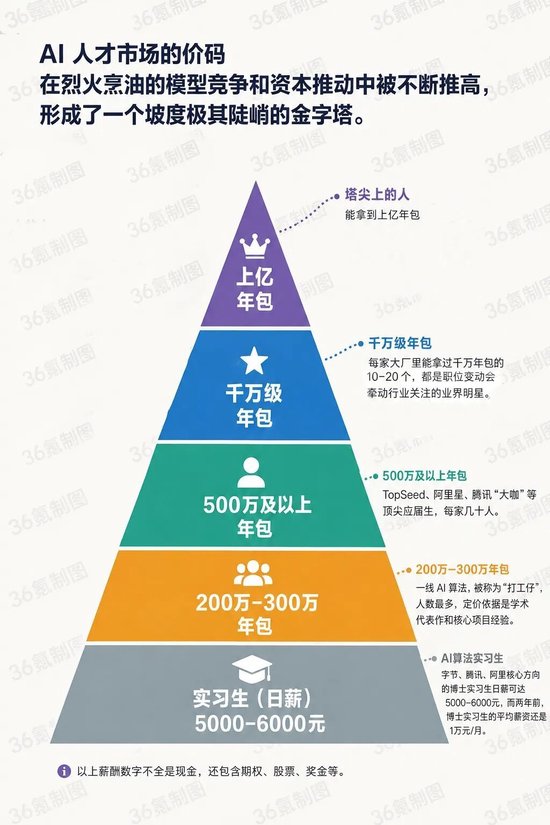
塔尖上的人,能拿到上億年包,但這個人群非常小,每家的模型團隊只有幾個人。
往下一層,是在大廠裏拿超千萬年包的人。一位獵頭告訴36氪,每家大體量的公司裏有差不多有10-20個這樣的人,每位都是職位變動會牽動行業關注的業界明星。
再下一層,是「500萬及以上」年包量級的TopSeed、阿里星、騰訊「大咖」等頂尖應屆生,每家幾十人。一位今年入職字節的博士候選人對36氪解釋了600萬年薪的構成:「不全是現金,還包含字節期權,豆包股、還有獎金。」他還提到,有的應屆生能拿到比600萬更多的數字,「但那是極個別」。
再往下,是200萬-300萬的一線AI算法,被稱為「打工仔」,人數最多,定價依據是學術代表作和核心項目經驗。「今年,年薪200萬+是一個普通算法研究員能接受的基準線,去年還是100萬+。」一位大廠算法說,「我有個朋友之前拿到了Seed 200萬+的年包,最後沒選,因為另一家AI公司給了他300萬+,以及更高的職級。」
金字塔的最底層,是AI算法實習生。字節、騰訊、阿里核心方向的博士實習生日薪可達5000-6000元,而兩年前,博士實習生的平均薪資還是1萬元/月,相當於現在兩天的薪水。
當實習生的月薪都來到了十萬元以上,對AI人才的爭奪,尤其是對大模型研究員的爭奪,可以說是從塔尖到塔底全方位地進入了白熱化。
這背後,是中國模型廠之間的競爭演化:字節原本是市場上最慷慨的AI人才買家,但最近一年,騰訊也突擊搶人,成為頂級人才大金主。同時,DeepSeek、月之暗面在一級市場大額孖展,智譜、MiniMax上市,頭部大模型創業公司也籌集了加碼的錢。
一直以來,「人才」在各個行業的競爭中都是一個重要的變量。但當下AI行業人才爭奪的烈度,明顯高於上一個熱錢湧入的行業——互聯網。可以與之匹敵的,恐怕只有1950-1970年之間的半導體行業剛興起時對核心人才的搶奪。
這兩個行業的共同特點都是:公司看起來擁有技術,但真正擁有技術的,是那幾十個核心的技術人員。所以,人才成了公司競爭中「卡脖子」的關鍵變量。
就這樣,AI公司之間的競爭,演變成了人才間的競爭。而人才的流動,劇烈地改變着每一家置身其中的公司,也深切地影響着整個AI行業的格局變化。
買配方
大廠和大模型公司所爭奪的,其實是核心人才手中的技術「配方」。
在訓模型時,研究員用「配方」這個詞來描述模型訓練中的方方面面:模型多大尺寸、數據怎麼配比、訓練路線怎麼選,有哪些關鍵tricks......
模型的成功,是趟過大量的試錯經驗而實現的。而經歷這一切的人,掌握着這些認知。就好像半導體行業早期也是如此:工藝參數、良率、材料、製造訣竅很難完全寫進專利。所以,挖到一個對的人,可以拿到這些「隱形認知」,迅速縮抹平模型代差,縮小跟競爭對手的差距。
配方貴有貴的道理。模型訓練的重置成本極高:訓練一個基座模型,或微調千億參數模型,一次完整的實驗所花費的算力成本可能高達幾千萬甚至上億。若訓練方向、方法錯誤,其損失遠遠超過幾個研究員的年薪。
更關鍵的是,能拿到核心配方的人實際非常少。
與互聯網時代大部分所謂的創業經驗不同,模型圈講求的「萬卡訓練經驗」,只有少數頭部大廠和頂級實驗室纔有足夠的算力和數據支持;而在這少量公司裏能獲得「訓練指揮官」資格的人,也是鳳毛麟角。
「全中國能牽頭搞大規模預訓練的,就那200個人。」獵頭York說。一位字節HR也告訴36氪,當他們在2024年開始集中挖獵核心研究員時拉了一張名單,名單上也就小幾百人。
當掌握核心配方的人流動起來,這些原本掌握在少數公司手裏的模訓練識就會隨之被「開源」,完成跨公司的遷移,最後抬高整個行業的天花板。這就好比:一道菜的配方一開始只由幾個廚師掌握,那這幾個廚師供職的飯店暫時就會看起來很強;可一旦一個王牌廚師跳槽,配方立刻就會流傳開來,沒有哪家飯店能持續領先,但越來越多好喫的飯店會抬高整個行業的天花板。

2024年下半年原本在阿里負責過多模態預訓練的周暢加盟字節,雖然字節為此付出了千萬級年薪,但周暢的到來迅速幫字節在多模態能力上取得突破,這是如今大爆的Seedance模型的基礎。
另有業內人士告訴36氪,原智譜研究員、GLM-4.5及GLM-4.5V核心貢獻者程曄安在今年加入了月之暗面,並位列K3技術報告作者名單。他的主要貢獻就在Agentic Coding後訓練上,而這正是智譜的強項。
對一家公司來說,當核心人才離開,損失的不只是一份勞動力,而是團隊共同積累的知識——實驗路徑、失敗記錄、調試經驗——被完整地交付給了競爭對手。而這種交付甚至不需要等到入職。有人從面試起就開始把團隊內部是怎麼做的,悄悄講給了對家聽。面試本身,成了技術細節最高頻的外泄渠道。
如果掌握配方的人選擇創業,也一定會成為資本的寵兒。
前商湯研究總監劉宇在多模態啱啱起步的2024年,就經歷過從數據處理、訓練基礎設施、模型研發到產品落地的完整閉環,並且調度了超過4000張GPU來訓模型。而當時,擁有千卡訓練的人才都已經很稀缺。所以,當他離職創業後,投資人立刻蜂擁而上。由於找來的投資人太多,劉宇甚至大部分都只能閉門不見,以至於行業內稱他為「投資圈輕易見不到的人」。
人才的流動,本身就是這一輪國內大模型公司能力競賽中重要的一部分。「模型競爭的核心,主要是算力、數據和人。」獵頭Sam告訴36氪,「能找到合適的人,算力和數據纔不會白費。否則花了再多的錢也無濟於事。」
這就是為什麼「人」會成為AI行業競爭中的重要爭奪資產。
當然,除了要找到那一小撮掌握配方的人,大模型公司還需要找大量聰明靠譜的年輕人來「剝蔥扒蒜」。人才爭奪戰就這樣全面打響了。
怪招
早兩年,AI人才的高地和流失源頭,原本是技術上先行一步的百度和阿里,但最近,AI人才極其充沛的字節也成為了新的「山頭」和被挖對象。
一位模型大廠內部人士對36氪透露,他們正在對標字節的數據體系,崗對崗地挖人,「只要挖過去,薪酬就能double」。
字節很快做出反應。2025年底,字節跳動發出全員郵件,宣佈獎金和調薪投入分別提升35%和1.5倍,並啓用新的職級體系,抬高了每一個職級的薪資上限。這其中職級相關的調整被認為是重點針對AI人才的舉措:高薪的研究員沒法塞進原有的職級框架內。
留人舉措今年還在繼續加碼:字節只對AI相關業務員工發放的「豆包股」有了明確的標價和回購機會,並且,有豆包股的人還可以選擇把自己年終獎或者總包裏更多的現金換成豆包股。這就好比字節創立之初時的期權一樣值錢。而這些舉措或許都有一個共同的觸發原因——去年一整年,Seed走掉了近70名技術骨幹。
騰訊則不止捨得給錢,還捨得給職位。如姚順雨、田永龍等硅谷的明星研究員,來到騰訊就可以直接帶一個團隊,甚至成為整個模型團隊的負責人。有了這樣的例子後,獵頭在挖人的時候也有了話術:「你留在OpenAI可能就是幾百個頂級研究員中的一個,你來中國大廠的話,就能做業務一號位。」
不過,錢和職位也不是一切。不少創業公司有自己的招聘「怪招」。
上海兩家AI創業公司常常同時盯上同一個人。今年,這兩家都看上了一位博士生,他原本已經準備接受其中一家的offer,最後卻被背靠高校的另一家挖走。原因不是錢,而是對方稱能給他提供「上海某大學的教職」。
智譜可能是這個「高校賽道」上的鼻祖。公司創始人兼首席科學家唐傑,以及公司的核心管理層幾乎都來自清華,在這種濃厚的「學院氛圍」下,不少清華學生為了讀唐傑的碩士或博士,都會選擇以加入智譜為敲門磚。
如果拿不出太強勢的資源,HR或獵頭則會採取」攻心術「。
李清供職的公司位列「大模型六小虎」之一。近段時間,他每周都會接到數通獵頭電話,電話往往挑上班時間打來,對方會採用「攻心」打法——他們不着急談崗位和薪資,而是繞着李清任職公司的股價、工作強度、他本人的健康狀況這些負面話題做文章,從側面動搖李清對當下公司的信心。
李清記得有一位獵頭,每次通話都熱衷於聊李清所在公司的股票。「你們公司股價跌了,要不要考慮外面的機會?xx上市以後潛力肯定更大。」
大廠有一套更為體系化的打法,我們稱其為「飽和式用人」。
一位字節員工告訴36氪,Seed在一些比較核心的研究領域,一定會超出資源配置地保留兩個能力相近的團隊。「所以就算一個團隊被競爭對手整鍋端走了,另一個團隊也絕對可以填上。你就算在再核心的崗位離職了,在字節也不會濺起水花。」
在獵頭側,也能感受到這種「飽和式用人」。一名獵頭告訴36氪,在他承接的各家公司中,騰訊會在組建團隊期間集中挖掘人才,但字節的挖人節奏幾乎沒有什麼波動,「不管當下缺不缺人,字節都會持續性地去挖人。」
還有「釜底抽薪式挖角」。
某大廠人士告訴36氪,他們正在「定向孵化其公司的模型人才」。「我們定位了競爭對手最重要的10個人,把他們全部撬一遍。如果他們願意跳槽過來就最好;如果不願意過來、就鼓動他們自己創業,我們可以幫他們找投資。」
在他的描述裏,這套動作是有名單、有配額的:比如,字節定位Seed最重要的10個人,逐一mapping,然後想辦法接觸上。跳槽是A方案,投資創業是B方案,兩個方案都能達到削弱對手的目的。
VC稱這種做法為「投負一輪」:在創業者還沒開始創業的時候就投。一些投資人會在字節員工還在職時,就攛掇他們出來,並且幫他們搭好班子、找好第一筆錢;或者扎堆在清華、北大校門口,抓教授、聊學生,甚至投學生創業。
相比被競對挖走,HR對於人被投資人拐跑的情況態度相對中立,「期權能綁住那些‘可能會被競對挖走的人’,但綁不住真想創業的人。想創業的人,早晚都會出來。至少不是去給競對添磚加瓦了。」一位投資人說。
挖角與反挖角,如今是每家AI公司HR的必修課。
一位大廠研究員告訴36氪,某些公司的HR面對想要鎖定的候選人,會逐字逐句地教對方一套話術,讓他用來應付別家HR。但這很多時候只是一廂情願——因為一些新人拿到offer後,會直接用offer作為「跟下一家HR談薪資的資本」。在兩家競爭嚴重的公司之間,新人甚至可以直接跳過面試環節,空手套到一個漲幅。
有的AI公司把招聘搞出了「拍賣會」的感覺:新人拿到offer後,一周內入職給3個月簽約獎金,兩周內入職則減少到2個月簽約獎金,三周以上沒有獎金,這就是為了縮短新人的猶豫時間。
獵頭找人的辦法也在不斷變化。
AI人才最大的特點之一是「隱形」,真正符合企業需求的人,往往不會把自己掛在招聘軟件上。「一個普通程序員在招聘平台能搜出成千上萬,但大模型的人,你找不到10個,有時候5個都找不到」。獵頭裴小科說。
但這些人才也不是無跡可尋。他們的名字往往在頂會論文的作者欄裏,位列GitHub的貢獻者名單中,在X上的技術帖子中,許多人在個人主頁上直接留了郵箱。
這代表獵頭的工作方式要改變:不再篩簡歷、打電話,而是要讀論文、發郵件。
但是要讀完、讀懂這些論文實在太難了,有獵頭開始用AI來幹這個活——用AI讀論文、發郵件,對方收到的郵件都是一對一定製的:「張教授,我讀了你的論文,你對多模態的理解我覺得特別有道理。」隨後,這一套辦法快速普及開來,所有獵頭都開始這麼幹,研究員們的郵箱裏瞬間充滿了大量AI味很重的獵頭郵件,小聰明迅速被識破。
「他們根本就不讀我寫的論文!」小紅書上有很多這樣的吐槽帖。
渠道被公開後立即失效,研究員們不再搭理這些郵件,獵頭們不得不返璞歸真,回到原始時代,靠熟人關係和線下蹲人來建聯。他們蹲在清華北大門口、混跡教授與學生的圈子、跑大會、定向邀請會、閉門會、after party……凡是有人才扎堆的地方,必有獵頭的身影。
選擇和山頭
縱然HR和獵頭使出千百種招數和誘惑,但AI人才們有自己的想法。
「我不會去的,」一位字節研究員經常接到競爭對手大廠打來的電話。他會直接告訴對方:「你們的組織架構設計不合理,等你們搞好了再跟我說吧。」
比如某次他拒絕,是因為對方開的是一個資深崗,但崗位描述像「算法零工」——同時做圖像理解和視覺模型的某個部分。「視覺模型光應用在遊戲上,就夠一個人研究五年。你現在讓一個人這樣打零工,他在數據的理解上都不完整,那怎麼能做起來呢?」他的結論很直接:「只有不懂的人,纔會這麼設計組織。」
大廠和錢,在很多AI人才那,並不是最重要的衡量指標。
移動互聯網後期,大部分人選擇在大廠裏拼職級、拼薪水,「說白了,就是沒有紅利了,大家得想辦法拿到一個好的位置,然後苟住。」獵頭Henry說,「但現在的AI行業還在絕對的紅利期,有能力的人更願意去能讓自己快速出成績的地方。」
「追求槓桿,而不是眼下的現金」,成了AI人才,尤其是年輕的「小天才們」一個比較主流的想法。「如果我今年能參與一個SOTA模型的核心訓練環節,這就是我最大的槓桿,未來的機會只會更多。」而正是這樣的想法,讓不少年輕人的天平開始向創業型公司傾斜,如月之暗面、DeepSeek、智譜等。而這些公司裏關鍵崗位上的人,也確實更趨於年輕、趨於「原生的AI人」。
在這些人眼裏,大廠和創業公司最大區別在哪?答案可能是「組織」。
組織怎麼設計,把哪些人放在覈心位置,往往是一家公司想怎麼做業務的直接體現。通常來說,創業公司的組織往往更精簡、更扁平、更靈活、更「AI Native」。又或者說,如果一家大廠能讓自己的大模型部門具備這些特點,它也會更容易受到人才的青睞。
「AI Native」這個熱詞放在大模型訓練組織的語境下,說的其實就是:這個組織裏有沒有真正自己下場做過大模型的人,有沒有在一個真正的大模型組織待過的人,知不知道一個能適應AI時代的組織應該是怎樣的。
2024年急於在大模型上破局的字節,轉年就找來了吳永輝擔任Seed負責人。前負責人朱文佳雖然也是資深的算法和架構師,但他大量的技術經驗都集中在「搜推廣」業務形態中,接手Seed時並未真正做過大模型。後來的事情也證明,做大模型訓練還是需要直接做過的人,前Google DeepMind研究副總裁、曾深度參與Gemini研發的吳永輝,被認為纔是對的人。
騰訊則在2025年做出了更大膽的選擇。這家以「成熟穩重」著稱的公司,在大模型持續落後的2025年末,找來了年僅28歲的前OpenAI研究員姚順雨擔任混元大模型負責人。「總辦就是希望他來打破秩序的。」一位騰訊人士說。
他的到來,就像在平靜的池水中放入了一條鯰魚。騰訊的大模型組織開始劇烈翻騰。
首先是大批原生AI人才的加入。據36氪梳理,姚順雨加入後的近一年,混元體系引入了至少8名關鍵外部人才,直接向他彙報。梳理這份新人名單,無論是來自字節Seed的張弛、黃啓,又或是此前已被業內普遍關注的海外明星研究員龐天宇、田永龍與藺旭東,無一不是在大模型的一線真正訓練過大模型的研究型人才。
「姚順雨有一種明星效應,他吸引了更多掌握配方的人願意來到騰訊。」一位混元研究員說。他仍然用灶底1做比喻:「如果掌握配方的人覺得,你灶底1裏的鍋鏟不是我要的鍋鏟,鍋具也不是我要的鍋具,我怎麼炒出一盤好菜來?現在,他們相信姚順雨至少是個合格的廚師長。」
舊人也在陸續離開。大模型原先各崗位的關鍵負責人,包括原騰訊AI Lab副主任俞棟、上一任混元掌舵者蔣傑、原多模態理解負責人胡瀚、原後訓練主力徐燦等,都在姚順雨履職後相繼發生變動,或離職、或轉崗。
混元的組織在快速地年輕化。「那些所謂的老資歷,其實並不比我們懂得多,甚至我們在模型訓練各方面的認知上甚至都碾壓他們。」一位混元研究員對36氪說,「不是所有資歷都能帶來增益,很多人沒有真正在大模型上打過勝仗。」
一位頭部大模型公司員工也感慨,團隊裏幾乎都是95後,05年的都有。對創業公司而言,最不需要的就是一個專門發號施令的人,他不向往大廠,因為「組織龐雜,架構層級多,管理者只是在‘管理團隊’」,「在創業公司,因為目標與做事風格高度一致,反而更容易出成績」。
可見,大模型行業也正在構建一種扁平、一線、按訓練戰績而非資歷來評判人的工作方式。在上一個時代做過虛擬人,做過推薦系統、廣告系統、搜索,做過雲的人,不再能直接用資歷和年齡來兌換一個領導大模型團隊的資格。
組織變化帶來的效果很快在業務端顯現出來。
2026年之前,談到混元大模型,行業內的評價幾乎是清一色的「拉完了」。而姚順雨和他的新核心班底陸續到位後交出的Hy3則被認為「上牌桌了」,一個相對公允的評價是:從「模型排行榜產品」變成了一個能真正塞進WorkBuddy等生產力產品裏的底座。而2個月後發布的Hy4 preview,則被業內評價為:把騰訊推到了國內開源模型第一梯隊。
這正是一個「關鍵人物的到來改變了組織,新的組織改變了業務狀態,最後改變了公司在行業中的座次」的故事。「不是說姚順雨一個人改變了混元,但如果在2025年那個時間點,沒有這樣一個被賦予重要職權、能越過內部山頭的角色承擔這些責任,混元絕對不是現在這樣,只會更落後。」一位接近騰訊的人士評價。
阿里則陷入了與騰訊不同方向的敘事。
阿里過去因為大模型做得早、人才有積澱,並沒太喫過挖人的苦:通義實驗室的源頭可以追溯到達摩院,周暢、林俊暘、羅福莉等最早一批國內大模型人才都出自於此,且都是阿里一手培養的原生人才。而且,開源文化也吸引了大量有技術情懷的人,這讓阿里在2024年一度成為其它大廠挖角的人才高地。
可是近兩年來,阿里對人才的吸引力正在鬆動。
隨着字節、騰訊紛紛改革職級體系,打破論資排輩的桎梏,以及創業公司在2026年輪番推出SOTA模型、上市,阿里長期以來嚴格的職級體系和薪資體系,都成為了招攬人才的障礙。
據了解,原Qwen負責人林俊暘的職級為P10,除去他的直接彙報對象,大部分一線研究員只能給到P7左右。而這些人如果去往字節和騰訊,職級至少高出一到兩級。「阿里很難讓外部年輕人直接擔任核心職位。」一位阿里人說。
自2026年3月林俊暘離職以來,阿里一直在重新搭建大模型相關的組織:3月成立Alibaba Token Hub(ATH)事業群;4月成立集團技術委員會,升級通義大模型事業部;6月又將通義大模型事業部和未來生活實驗室兩個最重要的模型團隊合併,成立Token Foundry事業部。以上皆由集團CEO吳泳銘直接負責。
「管理層確實焦慮了。」一位阿里高管對36氪說,這些調整都是在將阿里的AI主導權不斷集中到CEO手上,但這是最好的解法嗎?「吳媽(吳泳銘)作為集團CEO要管的事情太多了,精力很容易被分散,很難高度沉浸地盯AI這一件事。」不少行業人士都認為,阿里依然需要尋找一位更原生、能更專注的大模型一號位。
潮漲潮落
AI圈人才的流動如同潮汐,時刻伴隨着潮漲潮落。
根據獵頭的回憶,國內模型圈的人才遷移經歷了四個階段,這背後也是公司間的起落:
-
2023年,GPT-3.5成為標杆,OpenAI、Google、Meta等海外大廠的員工成為了國內公司都想挖的熱門標的。而國內的大模型人才和公司一樣,都啱啱起步,其中阿里和智譜由於入局AI較早,人才更為成熟。
-
2024年,阿里之外,「AI六小虎」(智譜、月之暗面、MiniMax、百川智能、階躍星辰、零一萬物)從「百模大戰」中脫穎而出,也成了第二階段的黃埔軍校。
-
2025年,DeepSeek、字節、阿里的人幾乎和硅谷研究員一樣受歡迎。想找能做預訓練的人,基本就看這幾家。獵頭York用一句話來總結:「現在國內人才池裏,模型層就看Seed,應用層就看剪映。」
-
2026年,DeepSeek、字節、阿里的人依然搶手,不過從「六小虎」中成功跑到頭部的智譜、月之暗面也再次成為了人才市場的焦點。比如,月之暗面是率先拿出超大參數原生多模態模型的公司,而就在這個模型發布後,獵頭們立刻前往月之暗面的辦公室樓下蹲守準備挖角多模態研究員。
同時,AI市場對人才的需求結構也在發生一些微妙的變化——有的工種逐漸穩定、落潮,有的則在起勢。
Cursor首席人才官Adam Ward在近期的一次訪談中提到,在AI研究員之外,硅谷現在需求更大的一類人是「前沿部署工程師(FDE)」,也就是模型公司或雲廠商裏派駐到客戶一線去,把自家模型或應用部署到客戶實際工作環境裏的一群人。
「AI研究員是一個非常明確的群體,他們的定義、數量和分佈都很清晰。現在比他們更難招的是那些模糊不清或全新的工種。」Adam在訪談裏說。
這背後也是硅谷AI圈在發生的變化:在不斷投入人、卡、錢做出最好模型的同時,模型的應用和商業化——也就是讓模型賺錢——正變得比以往更重要。
在國內,類似的變化也在發生。
清華經管學院與獵聘在6月聯合發布的《AI時代技能趨勢報告》顯示:2022年,AI基礎算法與模型崗位佔據了AI勞動力需求約一半;到2026年第一季度,這一比例降至20%;第二季度,AI Agent產品開發工程師的需求量首次超過算法工程師,成為AI領域最大的單一崗位類別。在這4年間,Agent產品相關人才需求按月增速達到40%。
行業的重心正在從「訓模型的人」分化到「能把模型用起來的人」。
這從近期幾家大廠頻繁的組織架構和業務調整也能看出端倪:阿里將QoderWork、悟空、MuleRun整合為千問辦公,並將「AI辦公」提升為公司在AI領域的戰略方向;字節則將飛書產品團隊與豆包產品團隊將整合,並把TRAE和釦子整合進豆包,完成五年來對To B業務最大的一次調整。
兩家大廠的調整都被外部解讀為對騰訊AI辦公助手WorkBuddy的阻擊。當三家大廠都勢必要拿下這座城池,那麼相應人才的需求也會被快速放大——不是產品經理,而是做Harness(駕馭模型,把任務執行落地)的產品工程師。
但大廠對於AI算法的需求跟前兩年比確實在退潮。不是不招了,僅僅是因為經歷了過去兩三年的急招,大廠和頭部公司的人才已經趨於飽和——字節Seed的算法人數甚至已經上千。
「各家公司都已經形成了比較有梯隊的訓練隊伍,坑自然就少了。」一位業內人士說,「大廠現在主要的任務是只盯最頭部的算法人才,並且留住自己已有的人,而不是繼續大規模招聘。」
今年第二季度,騰訊與阿里的單季資本開支合計超過1000億元,且兩巨頭自由現金流罕見同步轉負。據行業估算,字節單季投入規模至少和騰訊處於同一量級。據此推算,三家巨頭單季的資本開支合計超過1500億元,其中大部分將流向AI業務所需的算力。
1500億,能造1.25座港珠澳大橋,或60%個三峽大壩,或3艘福建艦。這也是為什麼,針對大模型研究員不計成本地瘋狂挖獵不會持續太多個年頭的原因——地主家也沒有餘糧了。
獵頭裴小科對此有直接的感受:大廠招人的眼光更挑剔了。他打了個比方:2023年那會國內團隊招人,只要「見過豬跑」就行;認知成型後,用人標準變成了「喫過豬肉」;隨着喫過豬肉的人越來越多,如今只有「喫過好的」那一檔,才能接到橄欖枝。
於是,「縮圈」的現象出現了。比如針對一線研究員這個人群,「C9院校(9所頂尖大學)的計算機專業是現在的第一梯隊」,裴小科介紹,「C9之後是985院校,而211及其他院校基本不再納入人才池。」原因很簡單:C9院校的學生往往在更前沿、資源更充足的課題組裏實踐,他們的經驗也更被看重。
一位大廠實習算法還觀察到一個現象:AI部門轉正的HC在減少,但是拿到offer的人薪資包漲了一倍。這不是矛盾,而是同一件事的兩面:一些基礎的工作會逐漸被模型喫掉,於是預算集中到了少數頭部的人。
「今年以來一些場景,比如後訓練,正在逐漸自動化,HC的需求也在下降。」上述大廠實習研究員說,他已經見怪不怪,「現在部分組的HC已經鎖死了,即使是一些同齡人中的‘大佬’,去投這些組也會被掛簡歷。」
大廠招聘步伐放緩,創業公司仍在熱火朝天。正是觀察到字節的人才溢出,他們牟足了勁準備挖人。
一位獵頭認同「字節大範圍擴招時代基本結束」的判斷,他所在的獵頭公司正在認真考慮明年是否要解約字節。「簽約了字節,就不能挖字節的人,因為被逮到要罰錢、取消合作。比起服務字節,把字節的人才挖到創業公司,收益看起來更大。」
AI人才搶奪遠沒有結束,但最高潮的階段已經告一段落。
1983年,物理學家伊曼紐爾·德曼接到華爾街的獵頭公司打來的電話,問他想不想要一份15萬美元薪資的工作,而當時他在貝爾實驗室的工資是5萬美元。後來,他在高盛一直待到2002年才離開。他和那一代的物理學家、數學家們在華爾街獲得的,不只是三倍、五倍的薪水,還有一個可以待上二三十年的職業身份——他們中的許多人後來成了億萬富翁、終身教授,或對沖基金創始人。
但如今的AI天才們,還會有這麼長的時間窗口嗎?