本文來自微信公衆號: TOP創新區研究院 ,作者:趨勢研究組,頭圖來自:視覺中國
八月中旬,蘭德公司發了一份64頁的報告,標題是:《中美兩國的AI發展》,副標題是——"來自一個新的AI開發者企業數據集的證據"。
四位作者想搞清楚一件事兒,那就是:
中國和美國,到底各有多少家公司在真正開發AI,
以及,它們分別在幹什麼。
聽起來這應該是常識,好像應該已經有人幹過了。
但事實是,一直到今天,關於中美AI競賽的絕大多數判斷,依據都只有兩樣東西——
幾家明星公司的動向,和兩國政府發的規劃文件。
前者是軼事,後者是意圖。
但都不是產業本身。
回到報告。
這四個作者的做法是這樣的:
先撒網,選出僱了機器學習工程師的公司、發過AI論文的公司、持有AI專利的公司、上過模型排行榜的公司,全撈進來。
一共撈到26,629家。
然後開始篩。
比如必須是營利性公司,必須總部在中美,必須自己訓練或開發模型,而不是拿別人的模型做集成。
他們還用大模型當審核員,並給它下了一條死命令:
你在判斷理由裏但凡寫了"可能""看起來""大概"這種詞,這家公司就直接出局。
篩完最後剩下1,181家。
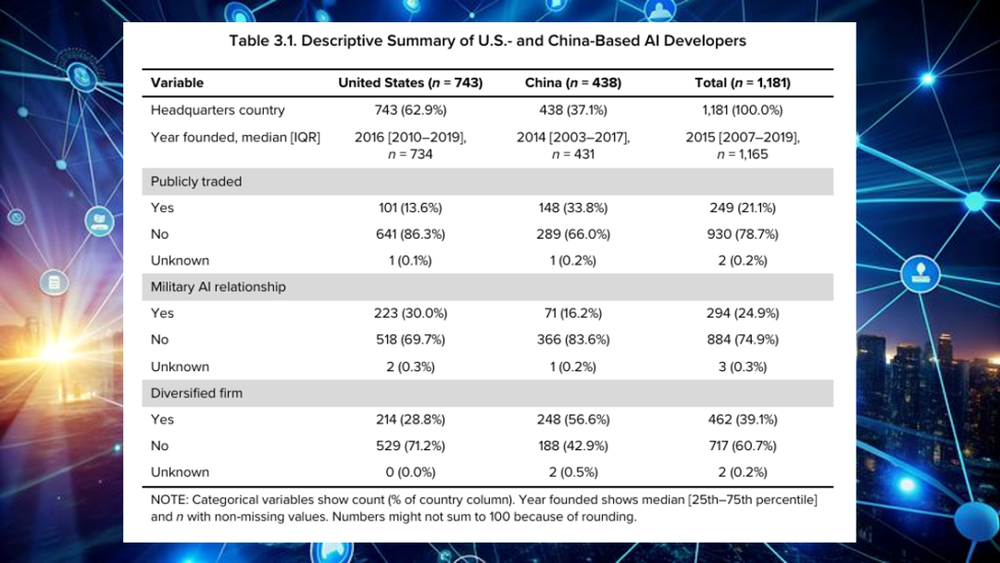
美國743,中國438。
這些是數據,報告基於這些數據,探討了他們在這1,181家公司身上看見了什麼;以及——這部分更有意思——
他們沒能看見什麼。
1181家公司
咱們先看幾個數字:
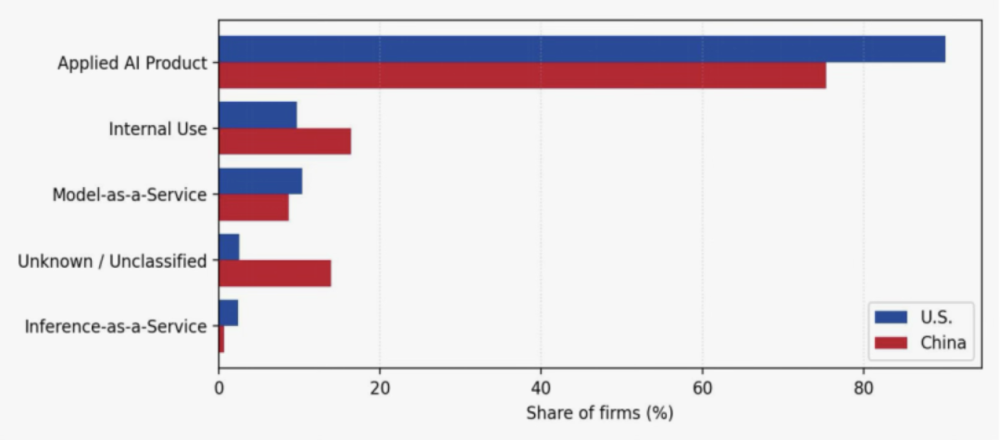
這1181家公司裏,靠"你付錢調我的模型(Model-as-a-Service)"掙錢的,
中美各只有約10%。
直觀來說,就是OpenAI、Anthropic、DeepSeek、智譜這一類。
但他們全加起來總共只有一百來家,
剩下九成,賣的是應用產品——美國約90%,中國約75%。這些公司的客戶根本不關心底下跑的是什麼模型,只關心那玩意兒能不能幹活。
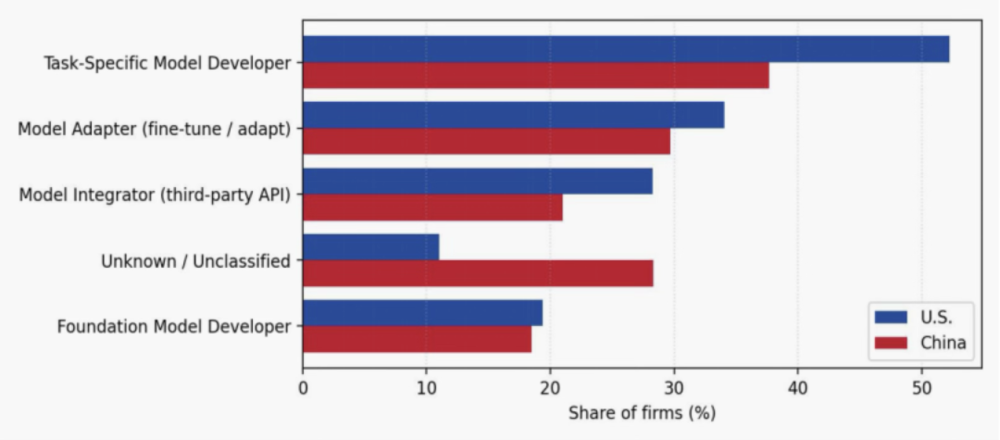
還有,自己從零訓練基礎大模型(Foundation Model Developer)的公司,
美國19%,中國19%。
一模一樣。
過去兩年,全部注意力都在場上那六七個球星身上——誰的參數大,誰的排行榜分高,誰又發布了什麼。
而看台底下,還有一千多支隊伍在自己踢自己的。
當然,不可否認的是,那10%的公司拿走了絕大部分的錢、算力和版面,影響力遠遠超過10%。
但如果AI最終的錢是在剩下那九成裏賺到的,那我們看了兩年的,可能一直是熱身賽。
最像的是大腦,最不像的是身體
蘭德給每家公司打了九個維度的標籤,結果有點意思。
先看架構,結論是兩國差不多。
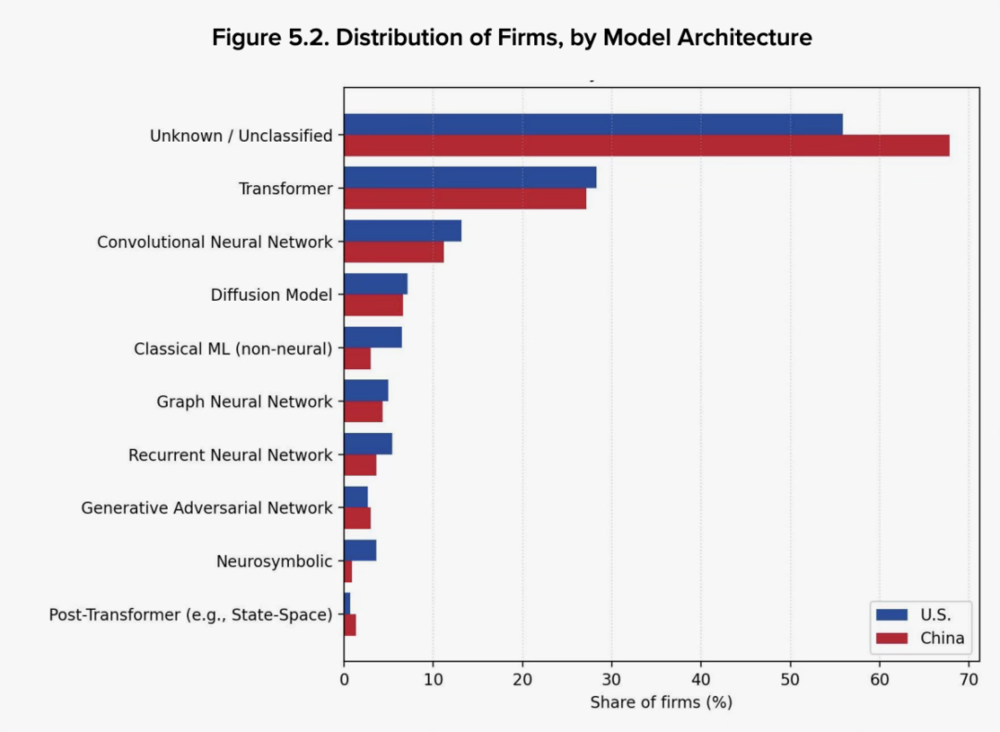
用Transformer的公司,美國28%,中國27%。
用卷積網絡的,13%對11%。
用擴散模型的,7%對7%。
用強化學習的,19%對19%。
華盛頓之前擔心,美國是不是把寶全押在Transformer這一條路上,而中國在多路下注?
數據說:不是。
中國的國家規劃裏非常提倡着要推神經形態計算、要探索後Transformer架構,但在438家中國AI公司裏,走這些路線的比例,並不比美國高。
再看物理形態,兩國就裂開了。
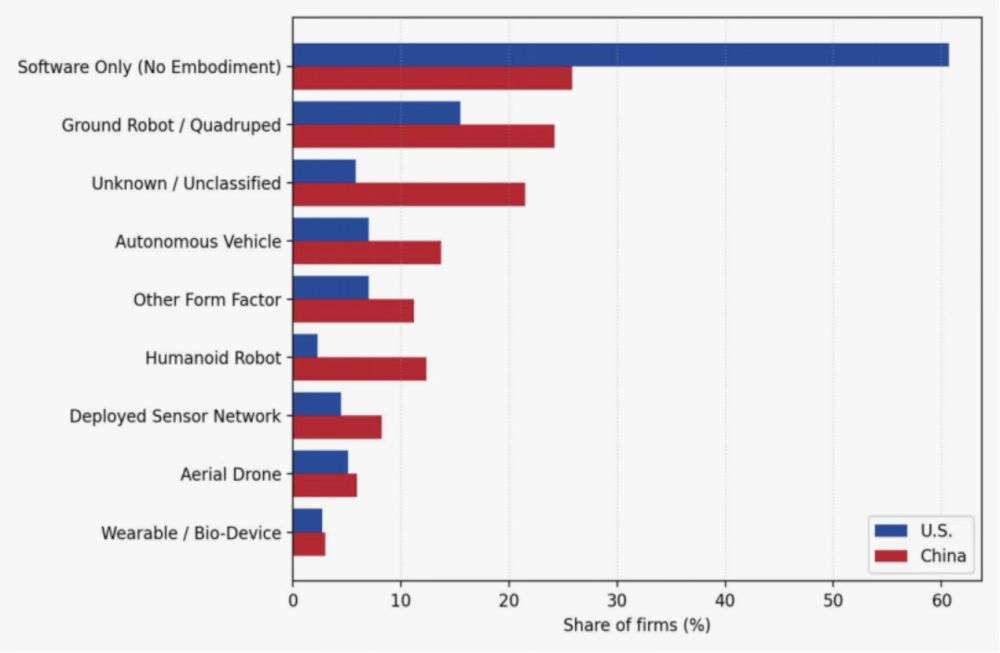
純軟件公司(完全不碰硬件):美國61%,中國26%
做人形機器人的:美國2%,中國12%
做地面機器人和四足的:16%對24%
做自動駕駛的:7%對14%
數據類型上也對得上:
處理三維空間數據的公司,美國27%,中國36%。
這裏還有個細節——
前面說了,兩國用強化學習的公司比例完全一樣,都是19%。但蘭德把這些公司的資料一家家翻過去之後發現:
同一個詞,在兩國指的是兩件事。
在美國,強化學習主要用來調教語言模型說話——拿人的偏好數據,讓模型回答得更順耳一點。
在中國,強化學習主要用在機器人怎麼邁腿、車怎麼拐彎、產線怎麼調參。
一個在教AI說話,一個在教AI走路。
同一個技術名詞,練的是完全不同的科目。
這就好比中美兩國家長給孩子報課外班的比例一模一樣,
但一邊報的是演講與口才,一邊報的是體育特長。
所以這份報告裏寫道:
中美AI公司的大腦幾乎一模一樣,身體完全不同。
決定身體形狀的是什麼
那為什麼會這樣?
最省事的解釋是:
中國把具身智能寫進國家戰略了,
所以中國的具身智能起來了。
但如果規劃真能直接決定企業的技術選型,那麼同樣寫進規劃的非Transformer架構,比如神經形態計算(類腦計算)和顛覆性新架構(即後Transformer架構的探索),中國應該更多,但數據裏完全看不出來。
所以,這說明產業政策有個邊界:它能給錢,能給訂單,能給場景,但它很難規定一家公司用什麼架構。
更站得住的解釋可能是這個——
每個生態,都把AI裝進了它周圍最值得的那個東西里。
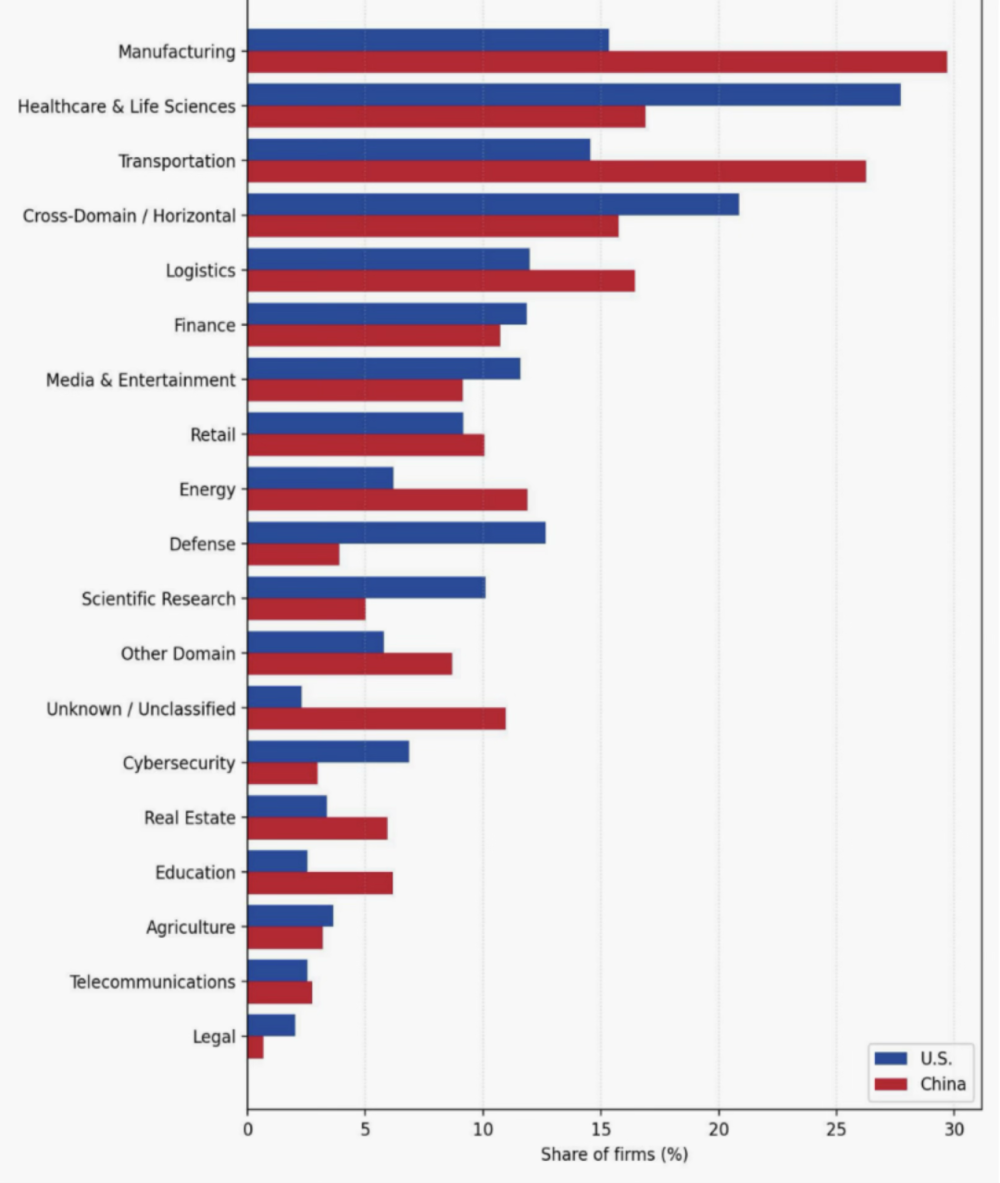
看行業分佈就很清楚:
中國公司扎堆在物理經濟裏——製造業30%(美國15%)、交通運輸26%(美國15%)、能源12%(美國6%)。
美國公司扎堆在知識行業裏——醫療與生命科學28%(中國17%)、科研10%(中國5%)、網絡安全7%(中國3%)。
美國相對更貴的東西是什麼?
是一個醫生寫病歷的一小時,一個安全分析師盯告警的一小時。所以AI往那兒跑。
中國最有需求的東西是什麼?
是產線、是車隊、是電網。所以AI往那兒跑。
這不是誰比誰更有遠見。這是各自的產業土壤決定的。
還有一層更深的差異,蘭德自己都沒怎麼展開——
中國的AI開發者公司,56.6%隸屬於一個主業不是AI的更大母體。
對比來看,美國這個數只有28.8%。
中國的AI開發者公司,33.8%是上市公司。
美國只有13.6%。
美國的AI公司,大部分是獨立創業公司;
但中國的AI公司,大部分是某個大工業體系裏的一個部門。
國家電網的AI團隊,運營商的AI團隊,車企的AI團隊,家電集團的AI團隊。
這或許就順帶解釋了另一個數據:
完全不對外賣、只給自己內部用的AI,中國佔16%,美國佔10%。
順着這條線,組織形態不一樣,會長出不一樣的空間形態。
美國743家裏,加州一個州就佔了350家,接近一半。麻州75家排第二,比紐約州還多。這是典型的智力錨定型結構——斯坦福伯克利周邊一圈,MIT哈佛周邊一圈。
中國438家裏,北京159家排第一,廣東90,上海58,浙江29,江蘇26。北京是研究和模型的中心;而廣東加上浙江江蘇,合起來145家——這是中國製造業密度最高的兩條帶。
美國的AI長在大學旁邊,中國的AI長在工廠旁邊。
同一個百分比,兩個相反的意思
這份報告裏有一個內在矛盾,很精彩。
發布過開源模型的公司佔比:美國約15%,中國約17%。幾乎一樣。
光看這個數,結論應該是"兩國開源程度差不多"。
但蘭德接着看了另一個東西:OpenRouter。
這玩意兒你可以理解成一個模型中轉站——開發者不用一家家去註冊賬號,在這上面就能一站式調用三百多個不同廠商的模型。它每天公布每個模型被用掉多少token。
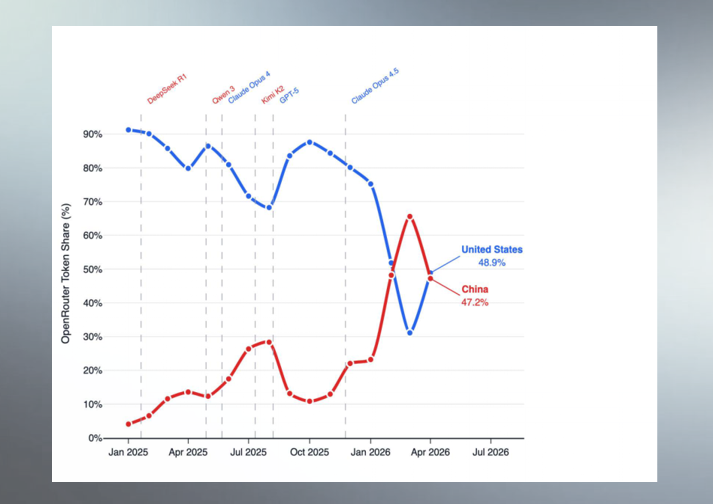
中美在OpenRouter平台token量份額變化
在這個平台上:
2024年底,美國模型佔前七大模型token量的85%—90%,
中國模型接近於零。
2026年4月,兩國持平。
2026年4月30日流量最大的九家裏,美國三家(Anthropic、Google、OpenAI),中國六家(騰訊、Moonshot、DeepSeek、阿里Qwen、MiniMax、智譜)。
中國這六家,旗艦模型全部開源。
美國那三家,只有Google開源,而且只開小尺寸。
全球調用量前五的模型中,常常有4個以上來自中國。
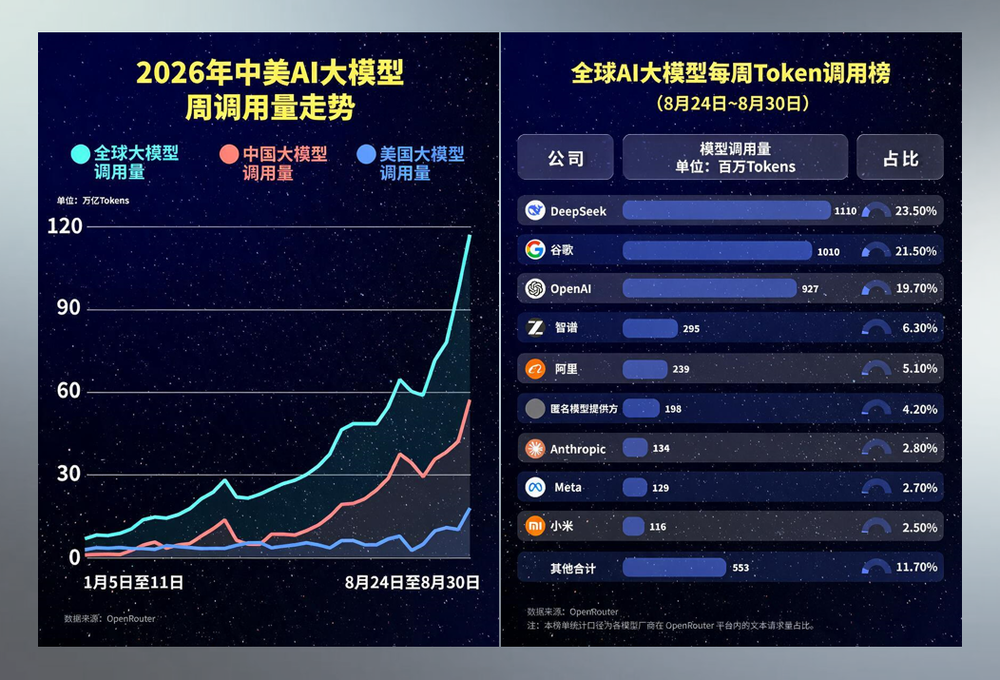
數據來源OpenRouter
所以你看,同樣是15%和17%,但意思完全相反。
美國那15%,分佈在生態的邊緣:小公司、非旗艦、開個小號意思一下。
中國那17%,分佈在生態的頂端:每個體系裏最強的那個模型,都是免費下載的。
同樣的比例,一個是外圍行為,一個是主流路線。
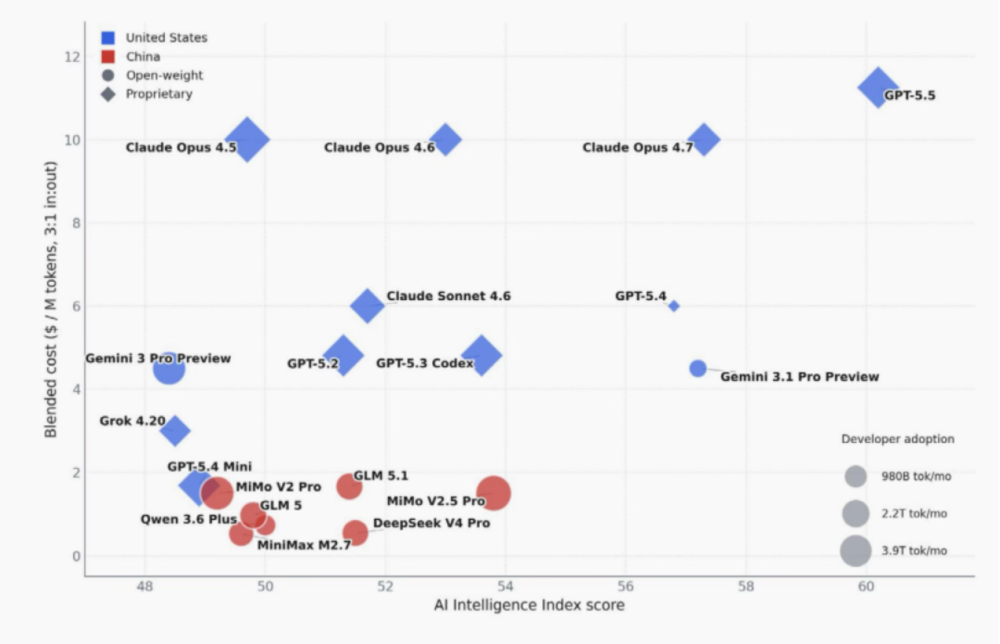
價格上就更直白了。
蘭德把中美主要模型放在同一張圖上:中國的開源模型密集地擠在每百萬token一到兩美元、智能基準分48到54的那一小塊;美國的專有模型跨度是一到十二美元、48到60分。
當然最頂端還是美國的。
但中段的價格已經不由美國定了——同等測得的智能水平,中國是四分之一到五分之一的價錢。
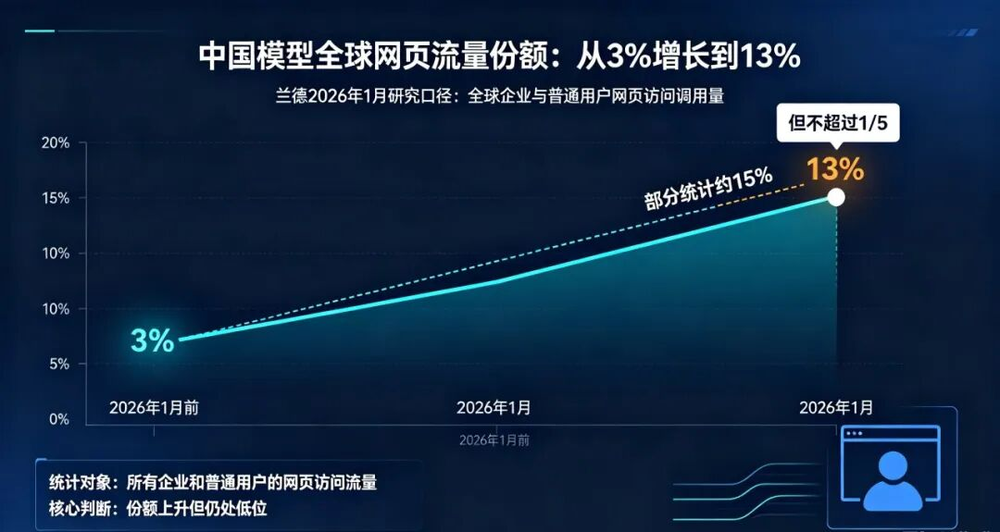
當然,這也不意味中國模型已經碾壓美國同行了,不是的。
同一家蘭德在2026年1月用全球網頁流量做的另一份研究顯示:中國模型的全球份額是從3%漲到13%。有些統計是15%。
全球份額算的是所有企業和普通用戶的調用量。
但不管怎麼樣,都不超過1/5。
也就是說,在所有人裏,中國模型是十三分之一。
但在會算賬的開發者裏(調用OpenRouter的這群人中),中國模型已經打平。
開發者嚐鮮不等於市場佔有,免費也不等於贏。
但「中段價格由誰定」這件事,通常比「頂端歸誰」更早地決定一個生態往哪邊長。
所有產品都是如此。
報告最誠實的一段
在最關鍵的兩個技術維度上,大部分格子是空的。
模型架構:美國56%未知,中國68%未知
學習範式:美國35%未知,中國60%未知
六成到七成,查不出來。
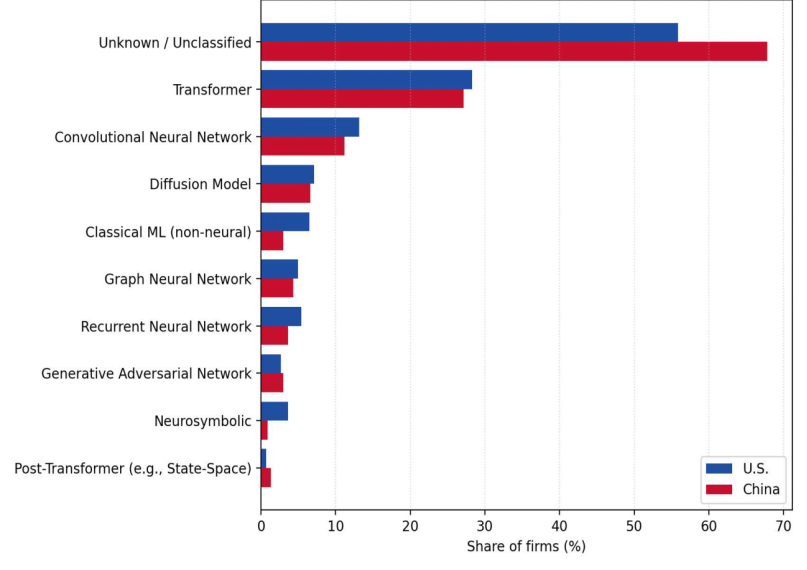
兩國均以Transformer為主,各架構佔比高度相似
你想象一下這個場面:一份64頁的正式研究報告,最核心的表格裏三分之二的格子寫着「不知道」。
蘭德把它們印在正文裏,還專門寫了一節解釋為什麼。
原因寫得很清楚:所有證據以英文來源為主;中國的職業社交檔案滲透率遠低於美國;而且很大一部分中國AI開發,發生在國企、電網、銀行、電信內部——這些主體本來就不對外講自己在幹什麼。
所以這份報告在很大程度上測的不是能力,是披露意願,這本身就是兩個生態最真實的區別之一。
還有,這份報告本身,基本是用AI做的。
26,629家候選公司,由大模型逐個篩,九個維度的分類,由AI完成,每家公司派搜索智能體做大約三十次定向檢索,再去學術庫里拉論文交叉驗證。最後人工複覈的樣本是——25家。
蘭德把這套流程披露得極其徹底,連完整的提示詞都原樣附在了附錄裏。
這是很值得尊敬的做法。
但它同時揭示了一個新情況:不少國外智庫已經開始用AI去偵察AI戰場,而這個偵察兵,只認識英文路標(沒有好壞之分)
順帶說個反直覺的數。有公開記錄顯示與本國軍方存在AI合作關係的公司,美國30.0%,中國16.2%。蘭德自己立刻補了一句:中國這個數幾乎肯定被嚴重低估。
所以這條數據說明不了兩國軍事AI的真實對比。
它說明的是別的東西——在一個人人都在談「看清對方」的時代,我們能看清的,只是對方願意讓我們看清的那一部分。
達爾文雀
蘭德的最終結論是這樣的:如果通向更強人工智能的路,最終必須和機器人、世界模型、物理環境學習一起走,那麼中國那份更寬的具身組合,就是美國生態裏缺的一份對沖。如果不必,那這份對沖會很貴。
對沖的賬單,兩邊都已經在出了。
中國這邊:
做人形機器人的公司超過140家,產品超過330款;2026年上半年具身智能行業孖展約九百多億元,是去年同期的五倍;工信部預計2026年產量超過十萬台,是2025年的五倍。
同時,發改委已經有官員公開提醒過度擁擠可能帶來產能過剩;頭部公司裏,有相當比例的收入其實來自科研和教育客戶,而不是真實產線。
美國這邊:
61%的公司是純軟件,做人形機器人的只有2%。幾千億美元的資本開支,幾乎全部押在同一個假設上——智能可以主要靠軟件交付。
其實,更準確的畫面不是兩個選手在同一條跑道上。
我們之前說,達爾文當年在加拉帕戈斯群島看到一群雀鳥。同一個祖先,但不同的島上,喙長得完全不一樣。硬殼種子多的島,雀鳥的喙就粗短有力;蟲子多的島,喙就細長。
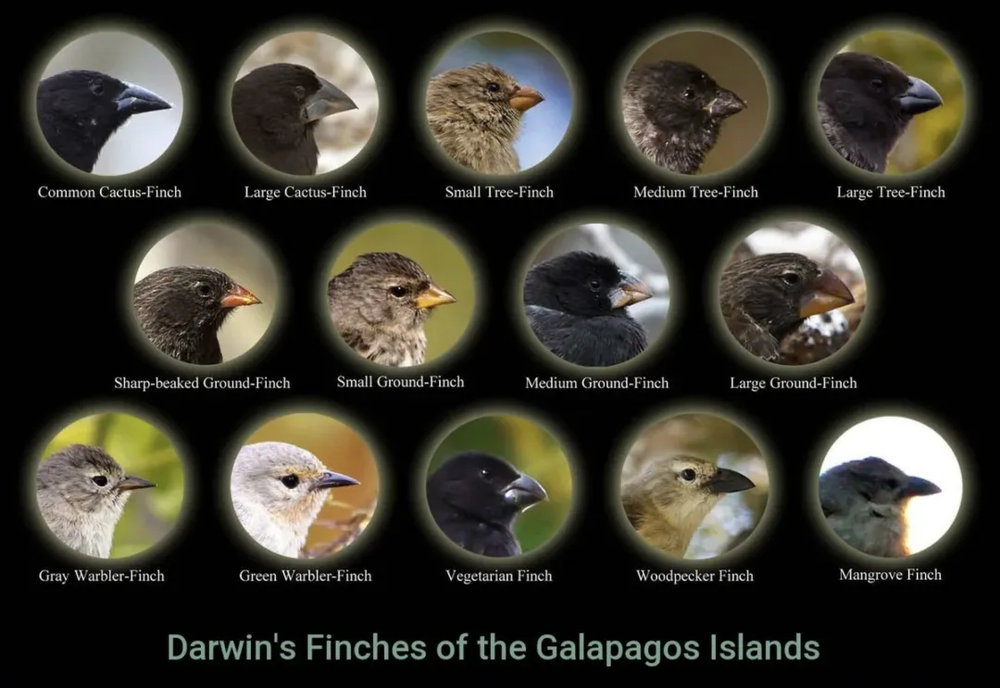
沒有哪個喙更先進。只有哪個喙更適合那個島。
中美的AI,現在看着就像這個。
同一個祖先——都是Transformer主導,同樣比例在做基礎模型,同樣比例在用強化學習。
兩座不同的島——一邊是全世界最貴的知識工作者和最成熟的企業軟件市場,一邊是全世界最大的製造業和最密的機器人裝機基礎。
於是長出了兩種喙。
生物學管這個叫適應輻射,不叫賽跑。
賽跑有終點線,有名次。
分化沒有——只有當環境變了的時候,才知道哪一種身體恰好合適。
而環境會怎麼變,現在沒有人知道。
本內容來源於網絡,觀點僅代表作者本人,不代表虎嗅立場。如涉及版權問題請聯繫 hezuo@huxiu.com,我們將及時覈實並處理。
End
點擊下方【虎嗅嗅小程序】,獲取 AI 行業最新變化。看完記得【添加到我的小程序】中哦~