專題:中國國際服務貿易交易會 物理AI與具身智能機器人創新生態交流會
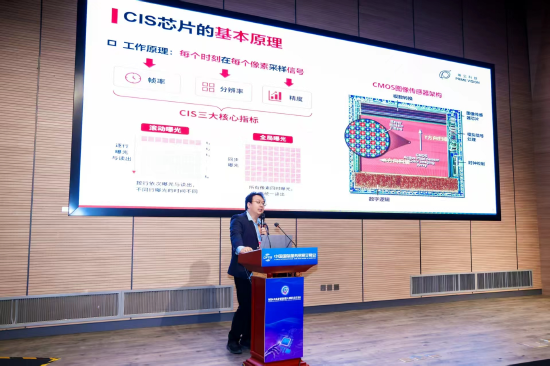
服貿會專題活動「物理AI與具身智能機器人創新生態交流會」於2026年9月11日在京舉辦。晰見科技創始人&CEO楊哲宇出席並演講。
以下為演講實錄:
楊哲宇:謝謝大家,非常榮幸有機會給大家做對應的分享。我先介紹一下晰見科技公司,晰見科技源自清華大學類腦計算研究中心。該中心由清華大學聯合7個院系共建,是一個創新研究平台。中心的代表性成果包括天機芯和天眸芯,這兩項成果均發表於《Nature》封面文章。需要說明的是,在中國大陸,以第一單位發表的AI或芯片領域《Nature》封面文章僅有3篇,分別是天機、天眸和DeepSeek R1,這也體現了中心在學術界的影響力。
我先做一個簡單的自我介紹。我是類腦計算研究中心中唯一一位既參與過高端算力芯片天機芯研發,也參與過感知芯片天眸芯研發的人。目前,我是晰見科技的創始人、董事長兼CEO。
如前所述,這兩項成果均發表於《Nature》封面文章。此外,我目前也是國家重點研發計劃億級項目中最年輕的課題負責人。
在正式開講之前,我注意到今天大家討論最多的兩個話題,一個是Physical AI,另一個是具身智能。圍繞這兩個話題,我先提出一個問題:為什麼現在只有大語言模型,卻幾乎沒有聽說過「大視覺模型」?語言模型發展至今,參數量已經達到幾個T的級別;而視覺模型,尤其是部署在具身和端側的VLM、VLA,參數量通常只有幾個B。今天,我就嘗試圍繞這個核心問題展開回答,並談談我對未來發展的看法。
我先從視覺談起。圖像傳感器是當前數字經濟中規模最大的上游數據源頭之一。可以看到,幾乎每個人都愛拍照,每部手機上都有多個攝像頭,這本身就是一個非常大的市場。但我認為,當前的視覺感知本質上是為了滿足人看世界的需求,也就是服務於拍照、攝像以及視覺娛樂,對應的是圖像傳感器的三大核心指標:幀率、分辨率和精度。它的工作原理是在每個時刻、對每個像素採樣對應的信號。這樣的工作原理帶來了一個最核心的瓶頸。在天眸芯出現之前,這是一個無法逾越的客觀難題,也被稱為視覺感知領域的「皇冠」。其核心矛盾在於,分辨率、幀率和畫質這幾項指標相互制約,提升其中一項,往往會導致另外兩項下降。可以看看自己的手機:為什麼手機背面會有那麼多攝像頭?一個攝像頭行不行?本質上,一個攝像頭是不夠的,因為在不同場景下,只能用不同的CMOS傳感器來解決不同的問題。
在這個領域,自然界提供了一個可供參考的範例,那就是每個人的眼睛。可以留意一下,你的眼睛所看到的世界,和相機拍出來的世界究竟有什麼不同。你的眼睛本質上是盯着某處看,注視點區域分辨率很高,而周圍則是模糊的。但拍一張照片時,畫面中所有信息是被均勻記錄下來的,對應的是左邊這個典型的生物學結果。在視覺感知領域,視覺注視點是視覺認知世界的重要方式,而這種方式和滿足人類視覺需求的圖像傳感器有本質不同。天眸芯是第一個將上述原理實現在圖像傳感器芯片中的工作。相關研究借鑑的正是人類基本的視覺感知方式:在感知時,並非將所有信息均勻採樣,而是把畫面中的關鍵部分以不同的表達方式呈現。在生物學中,這被稱為視覺基本元語,它構成了一種更基本的視覺表達方式,包含色彩、時間上發生變化的部分、空間上的邊緣以及深度距離。這些共同構成了人類理解世界的核心方式。
這一部分展示的是我們上一代已流片芯片的實物拍攝效果。左上角畫面來自傳統圖像傳感器:如果以30幀的速度拍攝高速目標,再慢放回看,畫面是不連續的,從弓拉開到箭飛出去,只能拍到一兩張畫面。基於天眸芯片的感知方式則類似於人眼的自適應感知,它會感知畫面中哪些部分在空間上發生變化、哪些是邊緣。我們在這條技術路線上是全世界第一個實現稀疏量化效果並實現高精度去量化的,這也是我們能夠登上《Nature》封面的核心原因。它能夠支持畫面無損重建。在畫面中,無論是飛馳的箭矢、振動的弓弦,還是衣服的抖動,都能得到完整還原,並且這種還原是低功耗、低帶寬的。它不像傳統方式那樣,為了拍高速而將所有信息均勻採樣;天眸是有注視點的,像人眼一樣,把關鍵信息放在注視點上。
講完這裏,我再回到一開始的問題:現在大家大概率聽說過大語言模型,卻沒有聽說過大視覺模型。這個本質問題究竟出在哪裏?我認為核心在於一個瓶頸點。視覺和文本是天然對立的兩種模態。就人類的視覺表達能力而言,說話時每秒鐘只能說幾個Token,但一張1080P的圖像就有8000個Token;如果要連續觀看每秒30幀的畫面,就是24萬個Token。如果給出一個Benchmark,端側最好的GPU能處理多少數據呢?大概在7B這樣已經非常小的模型裏,每秒處理300個Token。這個量級用於處理語言綽綽有餘,但用於處理視頻則遠遠不夠。正是這種「遠遠不夠」,使得當前語言模型的發展明顯領先於視覺模型。那麼天眸芯如何解決這個問題?我們認為,下一個核心場景就是視覺表示方式將從現在開始發生改變。我今天可以在這裏做一個預測:未來兩年以內,給人看的視覺方案和給AI看的視覺方案,一定會成為兩個完全不同的東西。信號採集我已經講清楚了,視覺感知可以刪掉大量無效信息,同時依然能夠重建對應的原始圖像。基於這一原理,芯片就可以進行片上的稀疏計算,去計算每一個Token本身的信息量和價值。經過內存重排之後,就可以得到壓縮後的數據——經過視覺原語壓縮90%後,數據量大幅降低,再通過RDMA直通GPU。這樣的數據可能人眼已經看不懂,但它真正適合Transformer、VLM、VLA以及世界模型的處理範式。這樣的範式可以實現整體上的優化:無論是模型響應延遲中我們最關注的指標TDFT,還是模型的訓練成本,都會出現直線下降。
到現在為止,天眸所定義的是一種全新的Token Camera。它不像傳統圖像傳感器那樣以幀和像素為基本單位、主要服務於人看圖像,而是以有效的Token為基本單位。我認為,在AI時代,給人看的視覺方案和給AI看的視覺方案,一定會變成兩個不同的東西。仔細想想,生活中很多傳感器和視覺感知,本質上就是給AI看的,而不是給人看的,比如各類智能可穿戴設備。我本人是做圖像傳感器芯片的,在這個領域,我的看法是:如果在眼鏡上放一個攝像頭、在胸口掛一個攝像頭、在耳機裏塞一個攝像頭,僅僅為了拍照,其實沒有太大意義,因為此時視角調整不了,畫面也調整不了。但有一個場景是有意義的,就是把它直接接入大模型的理解能力,讓它成為Physical AI的眼睛。這纔是未來核心的發展方向。
最後給大家看一個案例。我認為,視覺的通用性,可能會帶來下一個Coding級別的應用體量爆發。這裏舉一個我個人最喜歡的例子:數跳繩跳了多少下。這個應用為什麼有意思?傳統CV能不能做這件事?答案是可以。但做這件事的背後,需要大量數據標註,需要模型去學習對應文本,接下來大概率還要寫一堆規則,用規則判斷什麼時候算跳了一次繩。但我認為,未來的AI中,自然語言就是最好的編程語言。視覺一旦具備通用性,每個相機就可以成為每個人的個人助理。你通過提示詞,就可以告訴相機到底要觀察什麼。這樣的工作流,會徹底改變人類在編程層面的應用方式:我們做各類視覺應用,不再需要編程,直接通過提示詞就可以控制相機完成各類任務。同樣,在大模型的應用中,生活裏有大量場景需要大模型,但仔細反思一下,真正願意落地這些場景的科技公司,尤其是做視覺的公司,其實非常少。比如飛機艙門有沒有關、我出門前有沒有鎖門、鎖門後的操作流程對不對、做一個捲餅有沒有少放醬料。任何一家視覺公司都不會做這些場景,為什麼?因為這類場景是碎片化的,是case by case的服務,最終對應的是整體人力成本的投入。而在大模型時代,視覺一旦具備通用性,對公司來說,這個業務模型又會回到一種標品相機的業務模式。每個人控制相機的方式,不再是通過編程,不再是通過傳統CV,而是通過真正的大模型。
最後,我想借鑑一句黃仁勳常說的話,也是我非常欣賞的一句話。英偉達所做的事情,實際上是AI的factory:電子輸入AI集群,集群最終變成Intelligence的Token,對應的是Coding,對應的是文本。而晰見所做的、天眸所做的,實際上是把光子變成有效的Token,把光線中物理的輸入來源變成有限的信息,最終成為大模型理解世界的物理端口。我認為,未來的Physical AI一定是一個比具身更大的概念,它不僅是機器人的操作,更包括機器人具體的控制。
謝謝大家!