地鐵急剎,金屬尖叫,廣播響起請乘客注意扶穩,人群騷動、孩子哭聲、對講機雜音一層層湧上來···
你甚至能感覺到車廂在晃。
這不是電影原聲帶。整段聲音是用一句 prompt,AI 一次性生成的。
再來聽一首歌。先是一段清唱,沒有伴奏,就是一個人對着麥克風乾唱:
然後,AI 接手了。一句提示詞——
一首溫暖柔和的 City Pop 男聲歌曲,帶一點爵士和輕搖滾的感覺,氛圍朦朧浪漫
模型直接在這段清唱的基礎上,補齊了編曲、和聲、節奏和完整製作:
從一段乾巴巴的清唱,到一首有呼吸感的完整歌曲。你能聽出來這是 AI 做的嗎?
說實話,我第一次聽的時候也沒分出來。
音頻大模型,開始比體系了
過去兩年,語音 AI 賽道非常熱鬧。
Suno 兩天前剛發布了 v6 系列,OpenAI 的 GPT-Realtime-2 今年把實時語音推理能力拉到了 GPT-5 級別,Google 在 I/O 上把 Gemini Live 推到 70+ 語言的流式翻譯。
但有一個現象值得注意:幾乎所有玩家,都在比單項。
做語音合成的比誰說話更像真人,做語音識別的比誰聽寫更準,做音樂的比誰生成的歌更好聽,做實時對話的比誰反應更快。
然而現實世界裏的語音需求,從來不是一個孤立的點。
一條短視頻的聲音製作,需要角色配音、環境音效、背景音樂,可能還需要先把素材裏的人聲轉成文字做理解。
Voice Agent 要跑起來,語音識別、語音生成、實時交互、推理、工具調用得同時在線。一個音樂創作者做一首歌,可能先有一段清唱,需要 AI 補上編曲、和聲和製作。
這些場景對應的不是一個模型,而是一組能力。
這正是行業正在發生的一個結構性變化:當單點能力逐漸拉平,決定競爭力上限的,變成了誰能把理解、生成、交互和創作連成一套完整的體系。
9 月 15 日,階躍星辰一口氣放出了 StepAudio 3 系列五款模型:StepAudio 3 TTS(語音生成)、StepAudio 3 Gen(完整音頻生成)、StepAudio 3 Realtime(實時語音交互)、StepAudio 3 ASR(語音識別)和 StepAudio 3 Music(音樂創作)。
五條產品線,覆蓋聽、說、理解、交互、創作全鏈路。這在國內音頻大模型領域,是第一家以完整矩陣形態同時推出的。
它反映出階躍對語音 AI 競爭走向的一個判斷:單項能力競賽的窗口期正在關閉,全棧體系化能力開始成為真正的壁壘。
不過話說回來,全棧的前提是每一條腿都得站得住。
這一點,第三方排行榜先給了答案——三個全球第一。
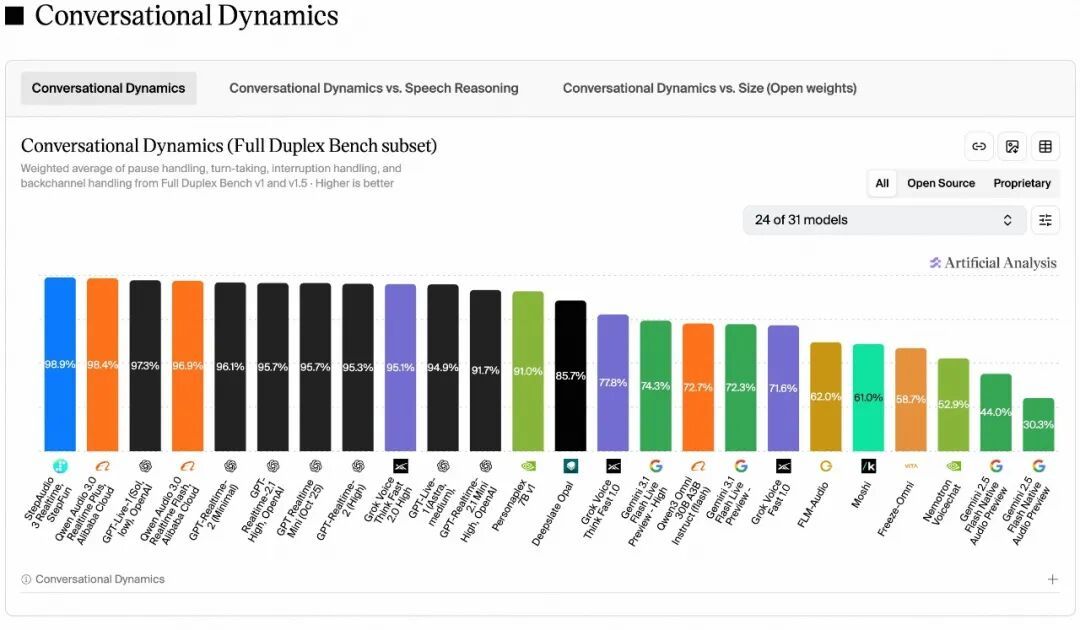
Artificial Analysis Conversational Dynamics 排行榜,StepAudio 3 Realtime 以 98.9% 的綜合得分,全球第一。
這個排行榜測的是對話節奏感:什麼時候該接話,什麼時候該等你說完,用戶突然插一句是想打斷還是只在附和。這恰恰是實時語音裏最像人也最難的部分——不是聽懂和回答,而是知道該不該現在開口。
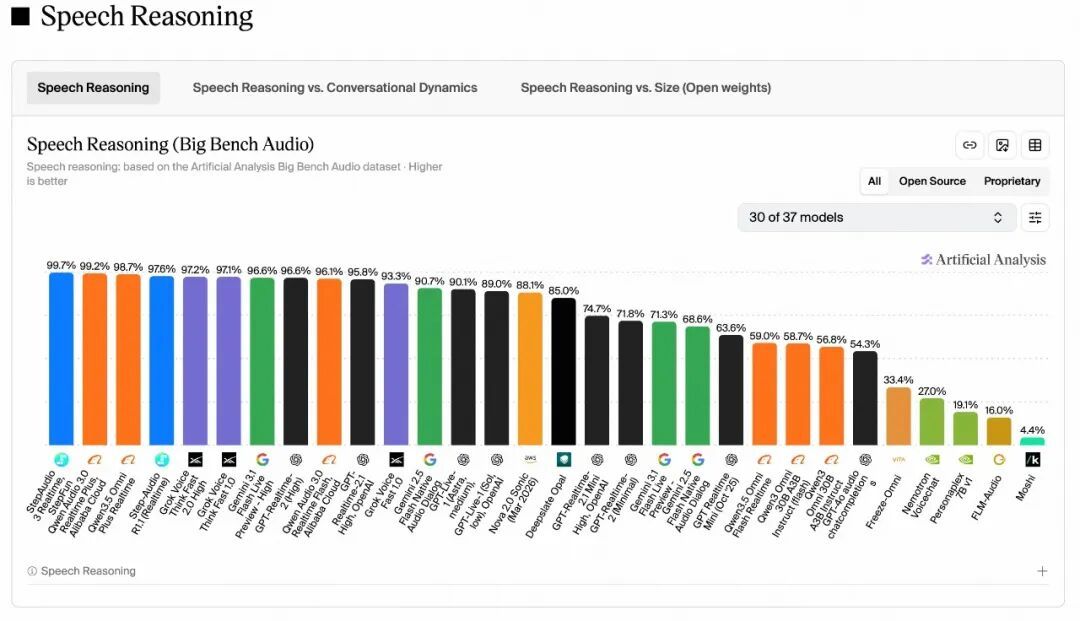
Artificial Analysis Speech Reasoning 排行榜,StepAudio 3 Realtime 以 99.7% 的語音推理準確率,位列全球第一。
這張榜考的是模型能不能直接聽懂音頻並完成複雜推理任務,而不是先老老實實轉成文字再去想。它是業內評估原生語音模型最權威的第三方基準之一。
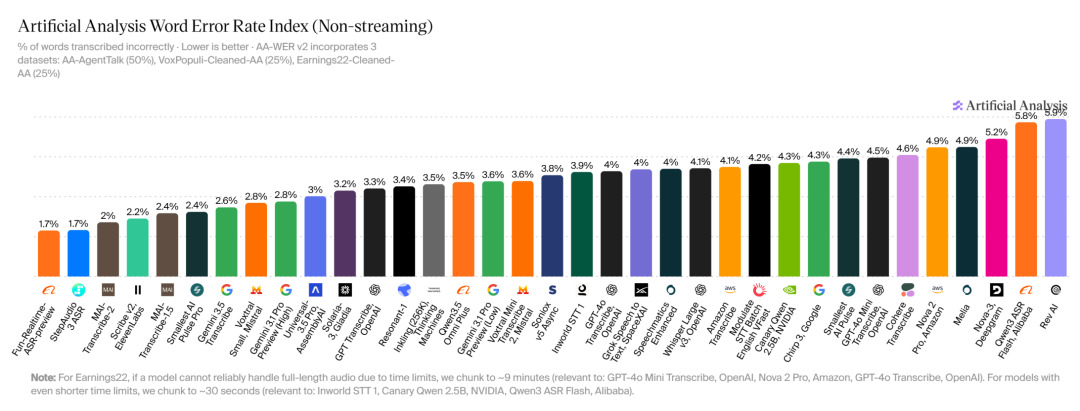
Artificial Analysis 非流式語音識別準確性排行榜,StepAudio 3 ASR 的 WER(詞錯誤率)僅 1.7%,並列全球第一。
WER 這個指標很樸素:每轉寫 100 個詞錯幾個。1.7% 意味着差不多 60 個詞才錯一個,已經接近專業速記員的水準。
排行榜說完了。接下來的部分,我們不看分數,只看這些模型在真實場景裏到底是什麼表現。
像人一樣交流
語音模型的基礎能力正在快速成熟。
但識別準確、聲音自然、響應夠快這些單點指標,已經不足以構成完整體驗。
真正拉開差距的,是模型能否接近真實人類交流的狀態:聽懂語境、自然表達,並在持續對話中完成理解、回應和行動。
StepAudio 3 TTS:從聲音自然到表達自然
市面上大多數 TTS 模型已經能把聲音做得很像真人了。
但仔細聽會發現,它們像的是播音員。字正腔圓,完美得不像在說話,更像在朗讀。
真實的人類交流不是這樣的。是呃、是就是那個、是說到一半改口、是突然笑出來又趕緊收住。
來聽一段 StepAudio 3 TTS 生成的語音:
我最近就特別糾結,就是要不要換工作這個事。呃,現在這家吧,錢少,但是離家近嘛,走路十分鐘。新的那個 offer 呢,給得多,多個,多個四千吧大概,但通勤單程要一個半小時。我媽說錢重要,我朋友說命重要,我就,唉,怎麼說呢,天天睡前想這事,越想越睡不着。
注意那些細節:就特別糾結裏帶着微妙的嘆氣,多個,多個四千的口語化重複完全自然,說到命重要時語氣微微上揚,緊接着的唉裏滿是無奈。
這些不是預設的情緒標籤,而是模型根據語義自主判斷出來的表達方式。
再來一段:
你不老說通勤無聊嗎,我給你安利個播客,就,講那種,呃,講歷史八卦的。主播倆人特逗,一集大概,嗯,一個小時吧,正好我來回路上聽。我這兩個月,就,就靠它撐着了。你搜那個名字我回頭髮你,反正免費的。
這段語音裏的就,就靠它撐着了,兩個就之間有一個幾乎無意識的停頓,完全是人在組織語言時的自然節奏。
目前行業裏大部分 TTS 模型處理這類口語化表達時,要麼直接忽略重複詞,要麼機械地念兩遍,很難做到這種「不完美但真實」的語感還原。
從技術層面看,StepAudio 3 TTS 在音色基底、語調層次、節奏律動和氣口停頓上全面貼合自然口語模式,並能還原笑聲、遲疑、結巴、改口等副語言特徵。
前代 StepAudio 2.5 TTS 已經在全球權威的 Artificial Analysis Speech Arena 拿下國產第一、全球前三。
StepAudio 3 TTS 在這個基底上再往前推了一步,把音色像不像轉移到了說話方式像不像。
StepAudio 3 ASR:從聽清到聽懂
語音識別看起來已經很成熟了。但 AI聽清和聽懂之間,隔着一條鴻溝。
你說驍龍8至尊版,它給你轉成小龍八至尊版。你說張靚穎,它給你寫成張亮影。
問題的根源在於,傳統 ASR 只依賴聲學信息——它在意聽到了什麼音,而不是說的是什麼意思。
StepAudio 3 ASR 的思路是把高精度聲學建模和大語言模型的語境理解結合在一起。
識別語音時,模型不只做音-字對應,還會調用語言模型的知識和推理能力輔助判斷:根據上下文,這個音更可能是哪個詞?
這個方向並非階躍獨創,業內多家都在探索 ASR 與 LLM 的融合。
但 StepAudio 3 ASR 的覆蓋面值得關注:方言、口音、中英混說、低聲耳語、快語速連讀、甚至唱歌和有背景音樂的場景都能處理。長音頻支持也不是簡單的切片-轉寫-拼接,而是端到端的完整理解,避免上下文斷裂。
這直接關係到會議紀要、視頻字幕、智能客服、車載交互、醫療記錄等一系列場景的實際可用性。
比如,我們先用 StepAudio 3 Gen 出一段機場的背景音。
再拿去讓 StepAudio 3 ASR 去聽。這其實是拿 StepAudio 3 自己考自己。
Gen 這邊,廣播腔拿捏得很準:有那種通過航站樓喇叭傳出來的壓縮感和輕微失真,不是乾乾淨淨的棚裏錄音。
ASR 這邊更見功夫,全程 40 秒的音頻裏,MU 5127、C17、C31、18 點 45 分這些字母數字混排的信息一個沒錯。
機場廣播的登機口和航班號恰恰是最容易聽錯的部分,C17 和 C31 又是在同一句話裏對照出現,轉錯一個字乘客就跑錯門了。
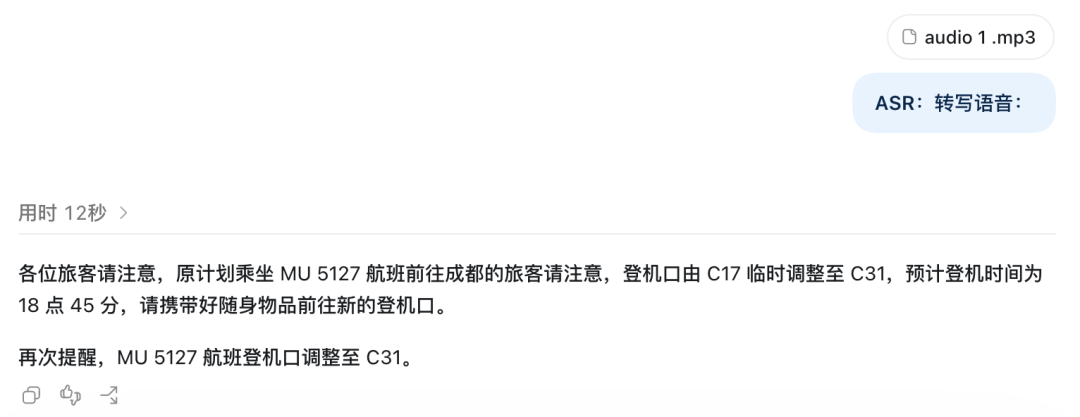
AI 生成的聲音能被 AI 準確聽回來,這本身就說明兩端的質量都立得住。
當 ASR 從轉寫工具進化為語音理解基礎設施,它的產業價值就完全不同了。
StepAudio 3 Realtime:從能打斷到邊聊邊想邊做
全雙工、打斷、低延遲——2026 年,這些已經是實時語音的桌面賭注。
真正拉開差距的,是另一個問題:模型在一場持續對話中,能不能同時處理理解、回應、推理和行動?
舉個例子。
你跟一個 Voice Agent 說:幫我查一下明天北京飛上海的航班,要下午的,最好是東航。
一個只做了全雙工和打斷的模型,可能先轉文字再調 API,中間一段尷尬的沉默。更糟的情況是,你開始追問時它還沒查完,系統直接卡住。
StepAudio 3 Realtime 的做法是推理與語音生成並行,工具調用和長任務異步執行。不阻塞當前對話,任務完成後自然接回上下文。同時它能感知語氣、情緒、副語言和環境聲音,不只是聽你說了什麼,還在理解你怎麼說的。
我們來個實測。
一分鐘裏,連着改了四次口——坐飛機、別太晚到、時間從周五晚放寬到周六上午、直達。
每一次都是掐在 AI 剛開口的當口打斷的。