文丨AI價值官 星野
生成式AI的競爭,正在從圖片、短視頻等平面內容,快速延伸到更具想象空間的三維世界。
過去一周,四場重磅發布接連落地,三條技術底色完全不同的路線,不約而同在同一個方向上重兵集結——可實時交互的3D空間。
9月1日,Anthropic推出新一代旗艦Claude Fable 5.1,同一天李飛飛創辦的 World Labs發布新一代原生世界模型Atlas。
9月3日,OpenAI 正式發布GPT-6 Astra,智能體直接操作專業軟件生成3D交互場景的能力迅速引爆開發者社區。
9月7日,彭博社援引知情人士消息稱,字節跳動正基於Seedance視頻模型研發實時空間視頻生成模型,創始人張一鳴親自跨部門協調資源,最快10月推出,目標直指可響應用戶動作、聲音的實時虛擬環境,覆蓋直播、互動短劇、遊戲場景,並計劃適配Pico VR頭顯。三條技術路線正在逐漸清晰:OpenAI與Anthropic同屬LLM,字節跳動Seedance代表視頻模型,World Labs則是原生世界模型派,三者起點各異,路徑不同,最終卻指向同一個產業拐點:內容產業的形態,正在轉向 「可進入、可交互的空間」。
LLM的新角色用通用智能驅動3D內容生產
OpenAI與Anthropic兩家頭部大模型公司,選擇了相似的技術路徑:依靠大語言模型的通用推理、任務規劃與工具調用能力,切入虛擬內容的生產管線,把AI能力直接嵌入創作者沿用多年的專業軟件體系,最終產出可編輯、可交互的3D場景。
這條路線上,GPT-6 Astra的表現最受矚目。OpenAI將其定位為新一代通用智能體模型,能力覆蓋計算機操作、編程、網絡安全與科學研究,其中就包括對Blender、Unreal Engine等三維創作軟件的完整操作權限。
在官方演示裏,Astra能獨立走完從概念到交付的全鏈路:給出一段文字描述後,模型先在Blender裏完成建築建模、材質貼圖與光影渲染,再自動編寫導出腳本,把成品導入Unreal Engine 5,生成一個可以自由漫遊的交互場景,期間不需要人工分步介入。
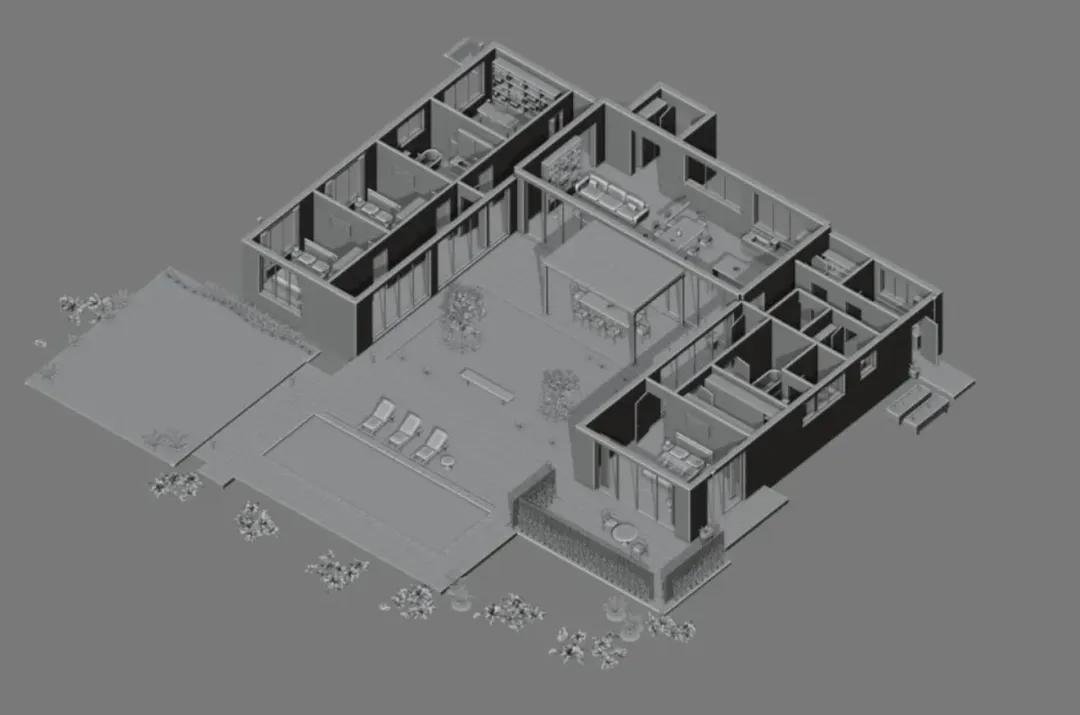
Astra開放測試後,開發者社區很快湧現出大量實測案例。有人只給一張房屋照片,就能在Blender裏還原出完整的室內空間,傢俱、電器等細節一應俱全,重建結果能以接近遊戲的幀率在本地運行;也有人在虛幻引擎裏逐街區搭建出可以自由漫遊的城區場景,精細到每條街道;分鐘級生成的城市白模、二十多分鐘內搭出的城市漫遊demo、當天成型的第一人稱射擊地圖,也都在社區裏流傳開來。
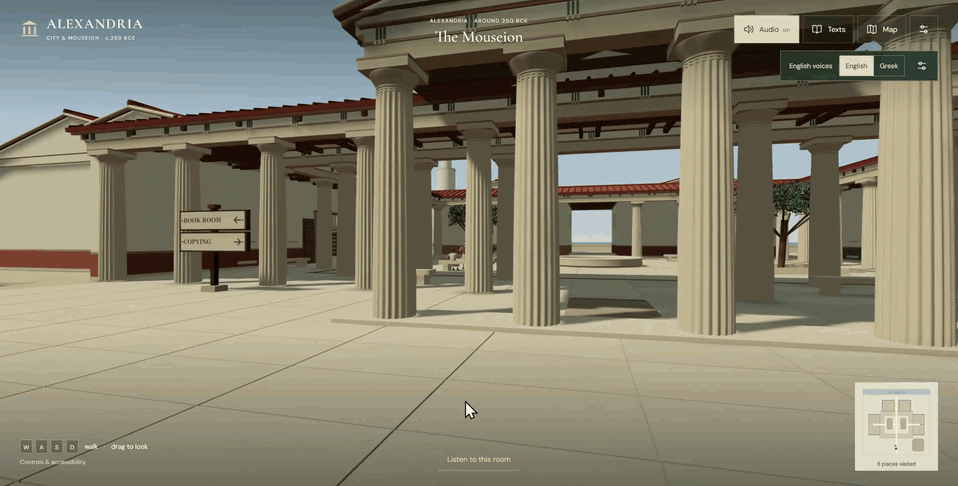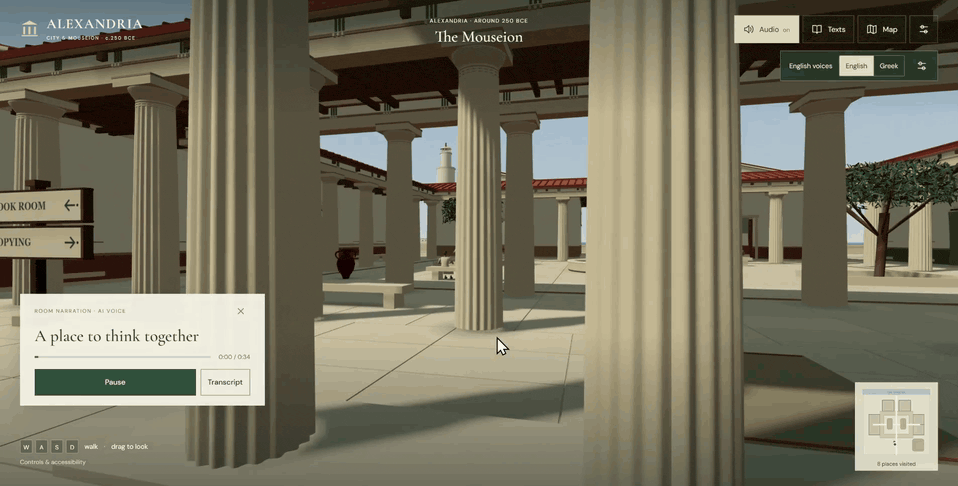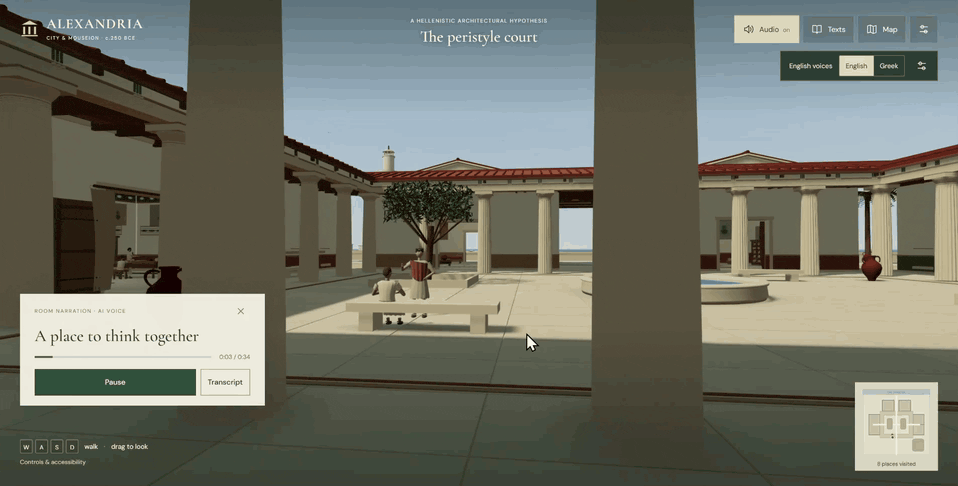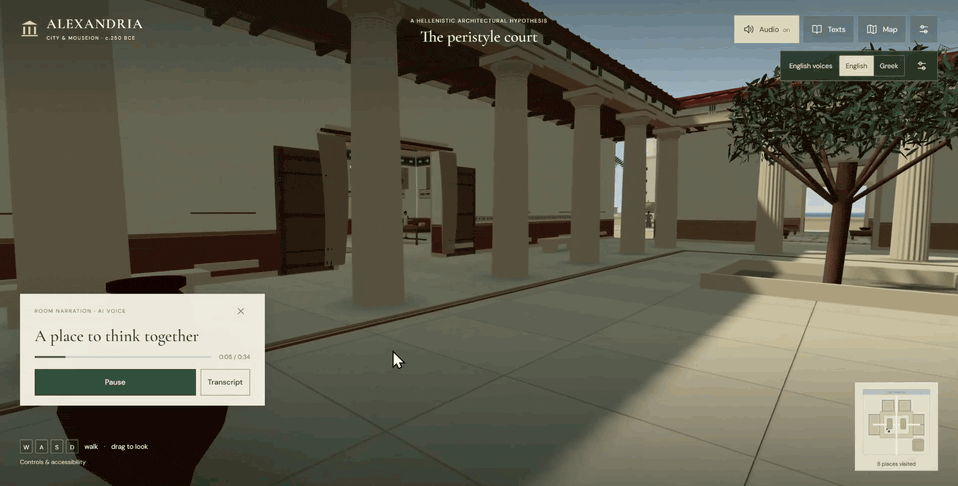
遊戲開發是反饋最集中的領域之一:有遊戲工作室做過對照測試,讓Astra從同一個灰模基礎出發一次產出三款可玩原型,人工修復的工作量比傳統流程減少了約一半;社區裏同時也出現了多個經典遊戲的復刻案例。
這些案例背後是Astra的Computer Use能力:它不依賴專屬API或定製連接器,而是靠多模態視覺識別界面、模擬鍵鼠操作直接驅動軟件,理論上人能在圖形界面裏完成的工作,它都能逐步學會——最終產出的還是可編輯的工程文件,能直接接入現有生產流程。
同樣依託大語言模型的通用能力,Anthropic早在半年前就佈局了MCP連接器生態,把Claude接入Blender、Adobe Creative Cloud等九款專業創作軟件,通過Python API直接讀寫場景數據、批量處理素材。
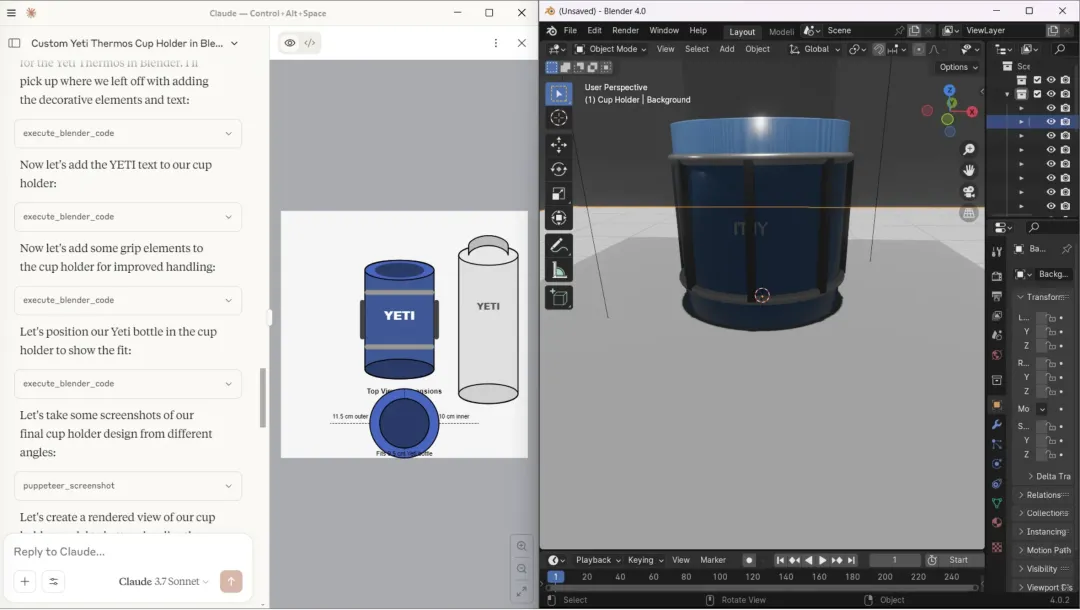
與OpenAI需要通過Computer Use模擬鍵鼠操作不同,Anthropic的MCP方案直接嵌入了工具的內核,讓Claude能更流暢地與專業軟件協同。
Fable 5.1發布後,社區裏同樣跑出了大量3D遊戲、場景建模的實測案例,模型能獨立完成從素材檢索到成品輸出的全流程。兩家公司的思路高度一致:以LLM為核心,把智能體能力嵌進已經沉澱幾十年的工業軟件管線裏,服務於專業創作者的既有流程,最終產出符合工業標準的可交互三維內容。憑藉通用智能體調度全流程的能力,它們天然佔據着3D內容生產鏈路的上游位置。
視頻模型走向上游從可視化內容到可交互空間
GPT-6 Astra發布沒幾天,開發者社區就跑出了一整套影視級工作流。開發者Higgsfield做了一次測試:只給Astra一句總指,在Blender裏完成預演,再調用Seedance 2.5生成鏡頭,最後剪輯成片,全程保持角色與場景一致。
Astra接到任務後,先從零寫出完整故事腳本,隨後打開Blender,搭出一條日式街巷的簡化3D白模,把兩個角色放進場景,規劃好不同鏡頭下的站位與走位,完成影視前期預演(Previs)。預演做完,Astra再敲定每個鏡頭的機位與運鏡軌跡,導出對應參考幀,把角色形象、場景畫面和動作參考一併交給Seedance 2.5去渲染成片。
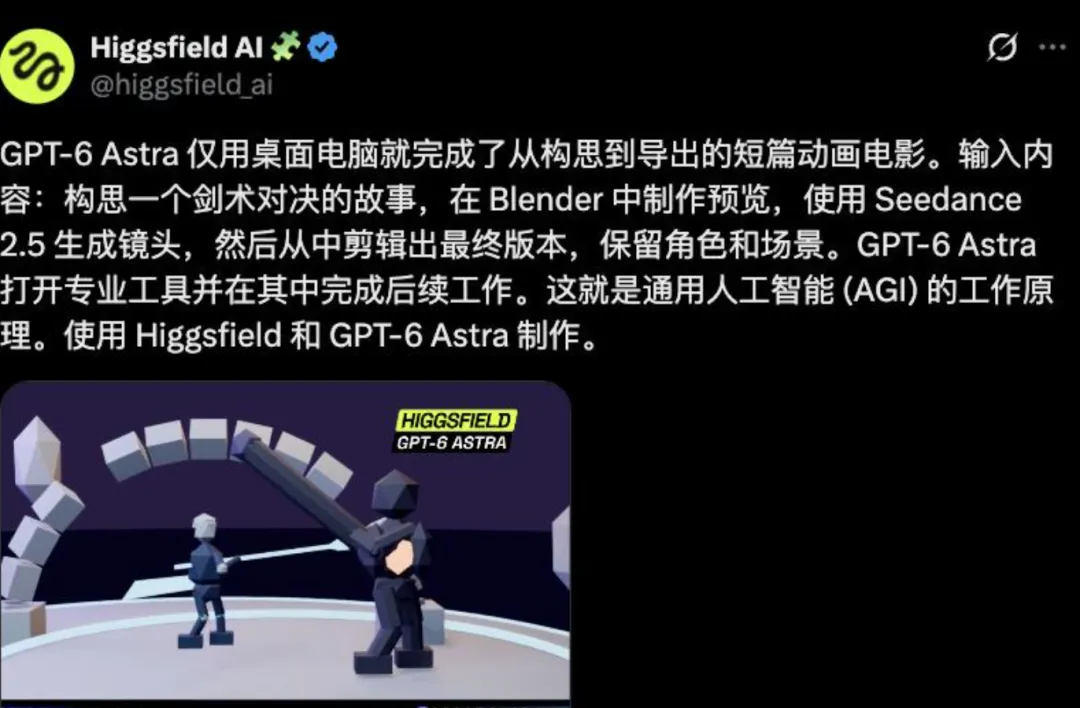
這套組合玩法在社區刷屏的同時,也預示了一種行業趨勢:如果視頻模型只停留在畫面渲染這一環,未來可能就會成為LLM的下游——創意、分鏡、流程調度都由上游的大語言模型說了算。某種意義上,GPT-6的全流程能力越強,純視頻模型的位置就越被動。
這正是字節推動Seedance向上延伸的核心邏輯:不甘心只做視頻生成器,而是要往空間理解、實時交互的上游走,直接產出可交互的虛擬空間,從「生成內容的工具」變成「承載體驗的平台」。
彭博社9月7日獨家報道稱,字節跳動正在開發一款實時空間視頻生成模型,項目由創始人張一鳴親自跨部門協調,調集模型研發、雲基礎設施、Pico硬件與內容業務線的資源,算力優先保障,最快於10月推出。
和市面上已有的模型不同,這款產品瞄準的不是預先生成好的視頻,而是能隨用戶聲音、動作實時變化的虛擬環境:用戶向前走,視角就同步推進;轉過頭,四周的場景依然連貫。應用場景直接指向直播、互動短劇和遊戲,並計劃適配字節旗下的Pico系列VR頭顯。
技術路徑上,項目以字節已經成熟的Seedance視頻生成能力為基礎,把大量空間渲染計算放在雲端完成,再把畫面串流到終端設備,藉此壓低頭顯的硬件門檻。據報道援引的測試數據,模型可以按需生成每秒20幀的視頻,端到端延遲約50毫秒。
這個數據在實時交互的語境中意義重大——50毫秒的延遲已經接近人類感知閾值,足以支撐流暢的沉浸式體驗,而20幀/秒的生成速度則意味着雲端渲染與流媒體傳輸的協同已經達到了可用的工程水準。
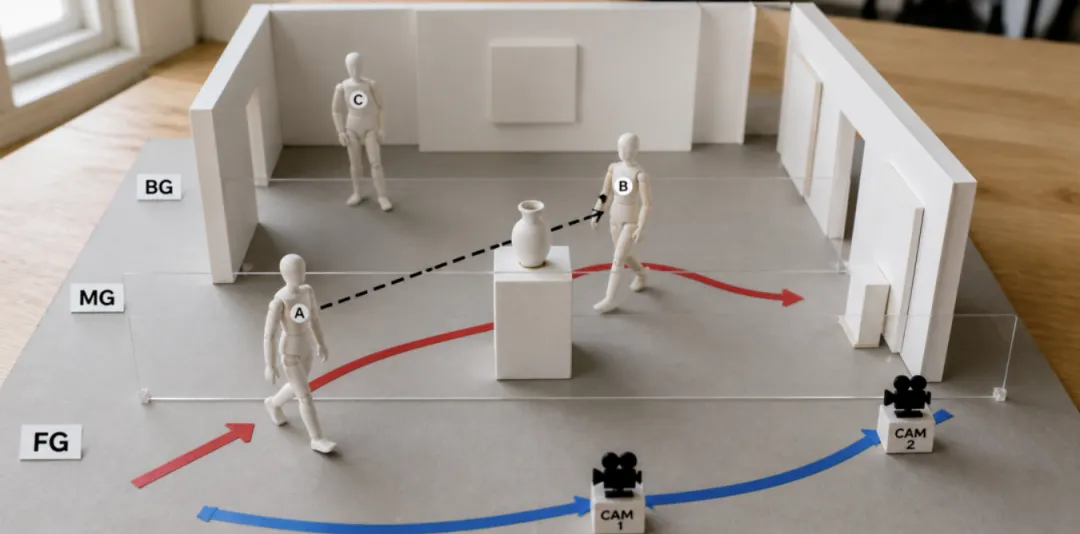
這條向上延伸的路線,其實早就埋下過伏筆。7月底發布的Seedance 2.5已經加入了Clay Render白模參考能力,支持基於3D白模生成貼合空間結構的畫面,配套的Blender插件也在創作者群體中被廣泛使用。
這次的實時空間模型,相當於把Seedance的能力往前推了一步,變成「實時生成可交互空間」,徹底脫離純渲染工具的定位,轉向承載體驗的平台。
把這條路線放到LLM智能體派旁邊看,差異會更清楚:一個面向生產端,一個面向消費端。OpenAI、Anthropic做的是替代人工操作軟件,產出符合工業標準的工程文件,服務專業創作者的生產流程。字節的空間模型直接產出可觀看、可交互的體驗,服務直播、短劇、遊戲這類大衆內容場景,離終端用戶更近,還能倚仗抖音/TikTok的內容生態、即夢/小云雀等創作者工具和Pico的硬件終端,形成從生成到分發的完整閉環。
原生世界模型進擊從底層重構空間理解
和前兩家沿着現有工具鏈、內容鏈往外延伸不同,李飛飛聯合創立的World Labs選了一條更原生的路:從零訓練一個理解三維空間的世界模型,在底層表徵層面就做出空間一致性,直接產出可以自由探索的三維虛擬世界。
9 月 1 日,World Labs正式發布新一代原生世界模型Atlas。這是一套從零預訓練的原生多模態模型,可統一處理文本、圖像、視頻和相機位姿信息。所有輸入都會被錨定在同一套三維空間座標系中構建共享空間上下文,全程保持三維空間邏輯一致。
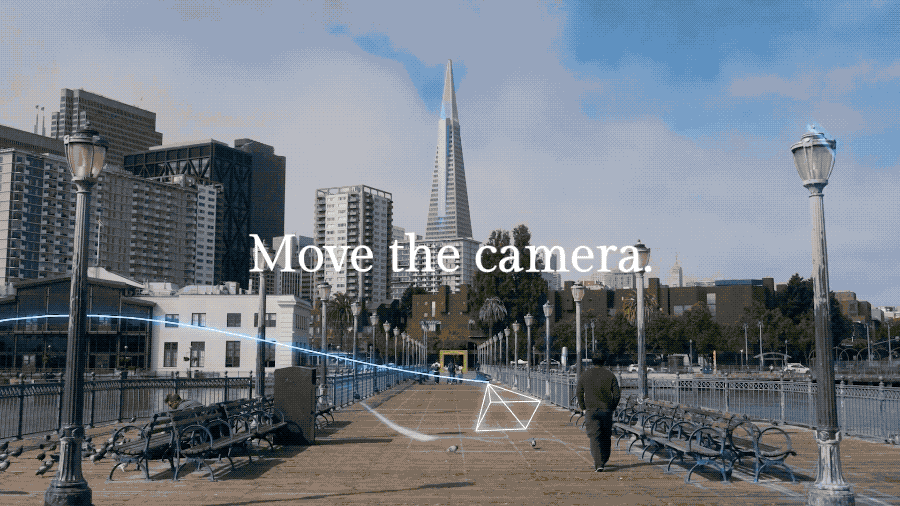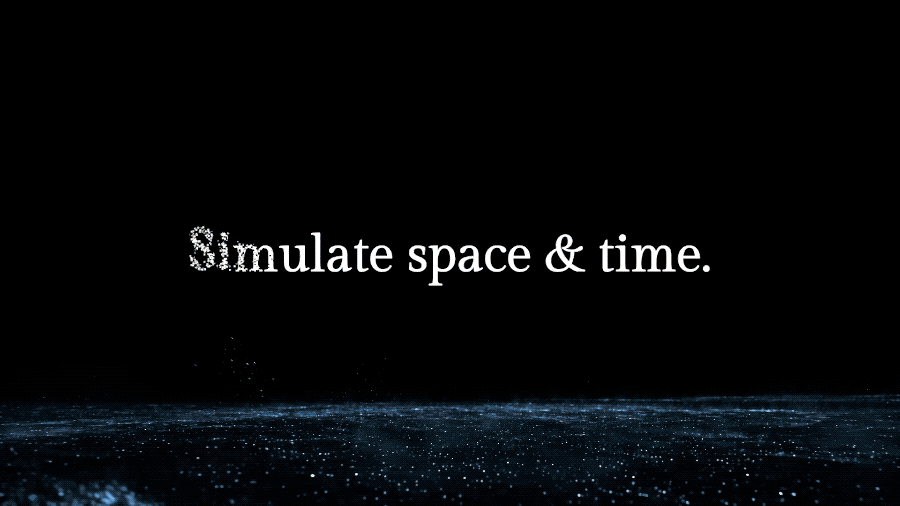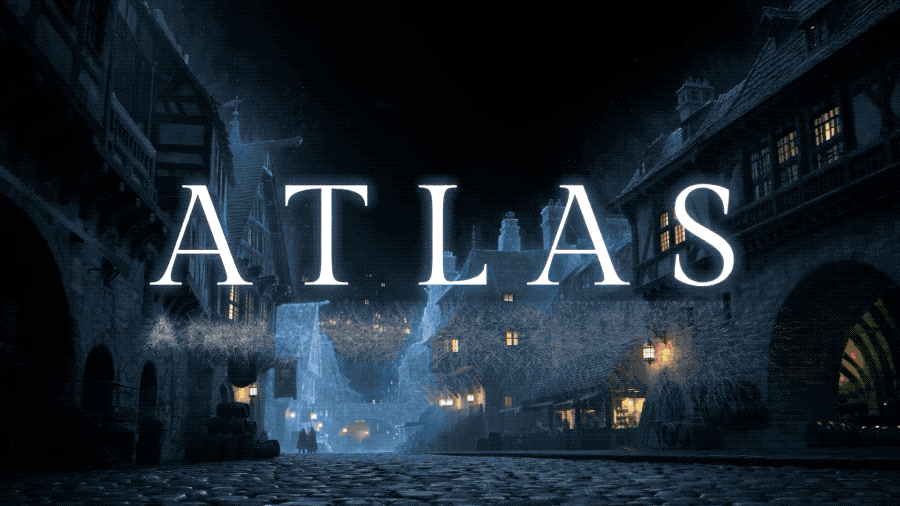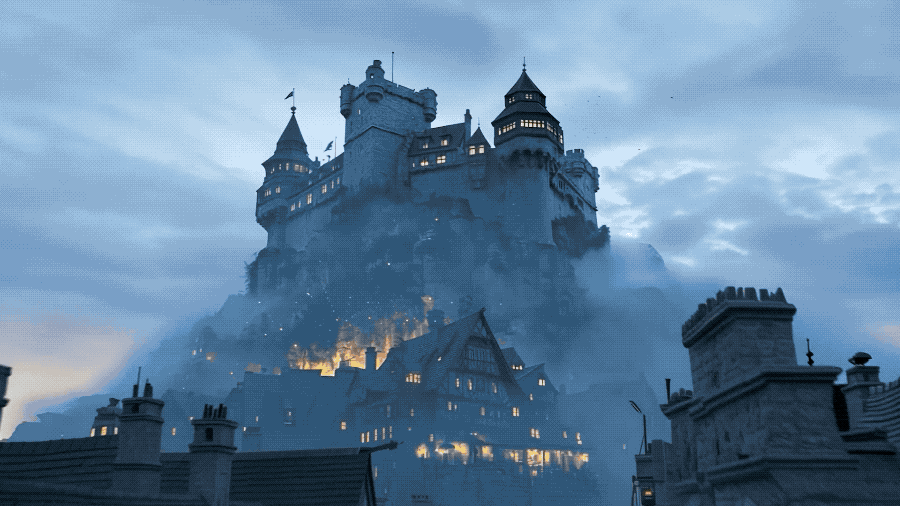
其核心能力聚焦於空間重建與相機可控生成:僅需少量參考圖片即可還原真實三維場景、輸出新視角畫面;也可按指定的精確機位與運鏡軌跡生成視頻,鏡頭控制達像素級精度。
和前兩條路線產出工程文件或渲染畫面不同,Atlas的核心特質是原生的空間一致性。它在意的不只是單幀畫面好不好看,而是視角變了之後,物體位置、光影邏輯還連不連貫。這種能力讓它天然適合需要空間一致性的場景,官方給出的落地方向包括影視內容製作、遊戲關卡原型、數字孿生、機器人仿真訓練四大領域。
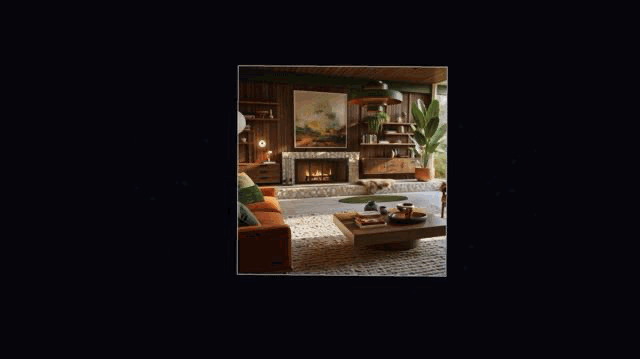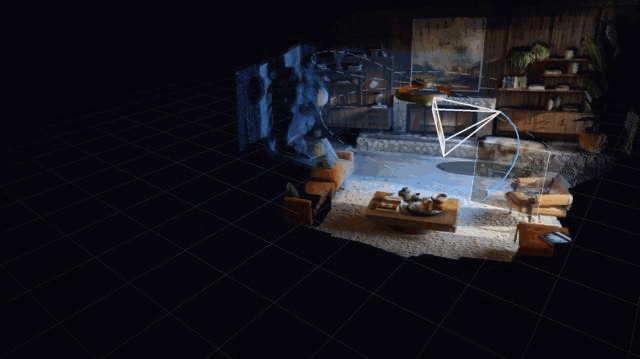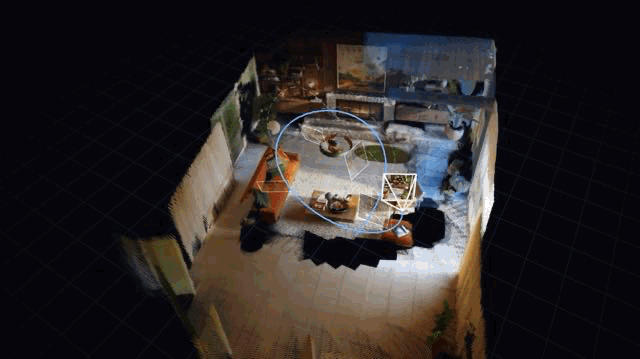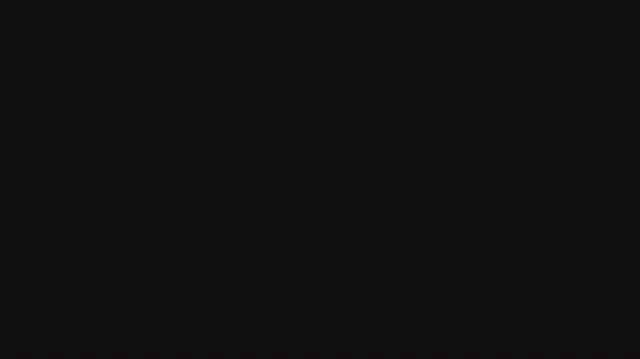
Atlas發布後,最先在影視和遊戲從業者圈子裏引發討論。影視行業關心的是虛擬製片與場景重建:傳統影視做三維場景重建、子彈時間特效,往往要多機位同步拍攝或激光雷達掃描,成本高、周期長,Atlas只用幾張隨手拍的照片,就能重建出完整三維空間,補全鏡頭沒拍到的區域,還能按任意路徑生成運鏡畫面。
有影視從業者在社區裏表示,這對前期勘景、場景預演、虛擬製片環節的效率提升會很明顯,但目前還主要停留在視覺層面的空間重建,離進入成熟的工業製作管線仍有距離。
遊戲行業的討論則更多落在場景產能上。不少遊戲開發者認為,Atlas最適合用來快速生成關卡背景、環境白模與概念場景,拿來驗證空間佈局與動線設計,再導入Unity、UE等引擎補全交互邏輯與細節。雖然Atlas生成的場景還不具備完整的物理屬性與結構化資產,無法直接替代專業團隊的成品製作,但作為前期創意與原型階段的效率工具,它已經能夠顯著降低原型驗證的成本。
三線並行3D空間模型的產業分野
梳理三條路線的技術路徑與落地進展不難發現,雖然各方都在向可交互三維空間這個方向集結,但彼此的技術底色、能力稟賦與產業定位截然不同,在覈心優勢、落地場景與成熟節奏上呈現出清晰的分野。
能力上,三條路線的強項並不重合。LLM的核心能力是全流程調度,從創意構思到軟件操作、再到工程文件產出,OpenAI和Anthropic都能把整條生產鏈條走完。在BenchCAD三維重建評測中達到95.9%的幾何重合度、在OSWorld 2.0通用計算機操作基準上拿到72.6%的成績,這些數據證明了這條能力線在持續變強。
視頻模型的核心能力是渲染與實時性。字節的優勢在於把成熟的Seedance視頻生成能力,壓縮進20幀每秒、50毫秒延遲這樣的實時交互指標裏,這是LLM智能體和原生世界模型目前都還沒有主打的方向。
原生世界模型派的核心能力是空間一致性:Atlas從底層表徵上保證視角變化後畫面的連貫,這是單純靠「調用軟件」或「渲染畫面」很難天然獲得的能力。
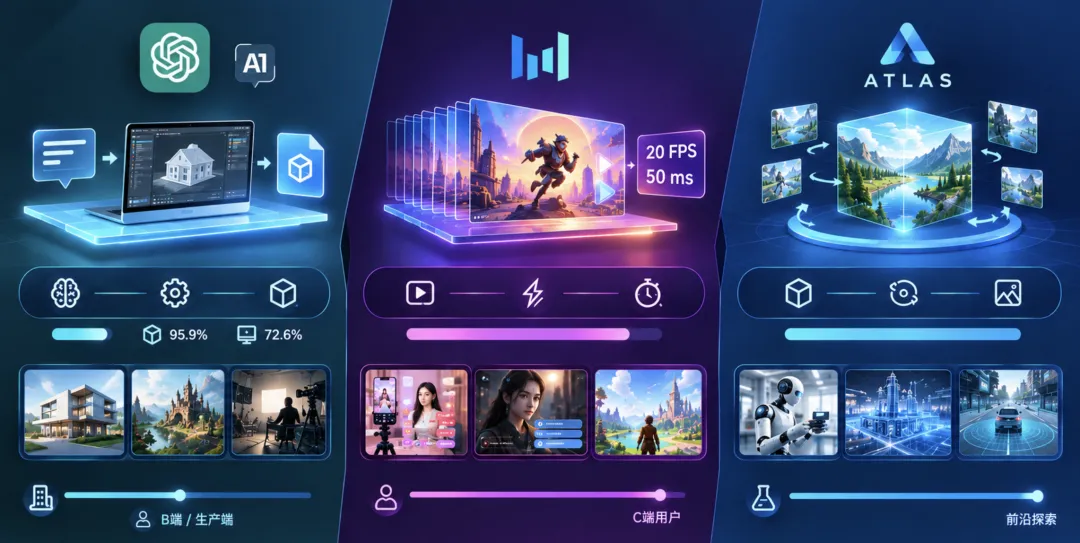
場景上,三條路線離用戶的距離也各不相同。LLM智能體派更貼近專業創作者的生產環節:建築可視化、遊戲關卡原型、影視預演,服務的是B端、生產端的效率提升;視頻模型更貼近大衆消費場景:直播、互動短劇、遊戲,字節還能借助內容平台與工具,形成從生成到分發的完整閉環,離C端用戶最近;原生世界模型派目前更偏向前沿探索:機器人仿真、工業數字孿生這類需要長期投入的領域,落地周期相對更長。
從目前的能力來看,三條路線都遠未走到終點,存在着巨大的提升空間。LLM智能體派的通用前端界面審美判斷力仍是公認的短板,長任務的操作精度和穩定性也在持續打磨;字節的實時空間模型仍處於開發階段,方案細節和上線時間都有變數;原生世界模型派生成的場景離3A遊戲、高端影視的工業標準,以及機器人仿真的精度要求,仍有距離。
從文字到圖片,再到視頻,大模型每一次躍遷,做的都是同一件事:降低內容生產的門檻,拓展內容產業的邊界。這一次,它們把目標對準了更復雜、更有價值的虛擬內容——從被動觀看的視頻,走向可進入、可交互的三維空間。
當然,這個過程並非一蹴而就。工業標準、成本控制、生態協同等現實因素,仍需時間打磨。三條路線目前還談不上誰會勝出,更可能的情況是,它們會在不同的生產環節和場景裏各自找到位置——過程中既相互借力,也相互競爭。短期內,三條路線會各佔山頭;但長期的融合與競爭格局,仍待觀察。