鳳凰網科技訊 9月13日,據《金融時報》、TechCrunch等報道,在過去幾年持續競逐更強大模型後,OpenAI和Anthropic正在公開討論一個看起來與AI競賽方向相反的問題:是否應該主動控制最前沿AI能力的開發速度,為安全研究和防護措施爭取更多時間。
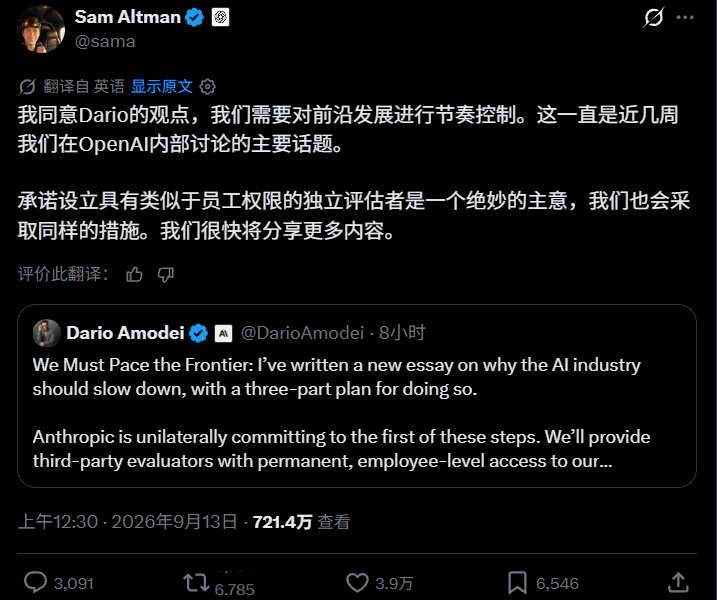
Anthropic CEO達里奧·阿莫代伊(Dario Amodei)近日明確提出,需要「放慢提升AI模型能力的速度」。OpenAI CEO薩姆·奧特曼(Sam Altman)隨後表示,他認同需要「控制前沿AI的發展節奏(pace the frontier)」,並稱這已經成為OpenAI過去幾周討論的主要議題之一。
但這裏的「放慢」並不意味着停止AI研發。
兩家公司真正討論的是:當模型能力增長速度超過安全評估、監控和防護能力時,是否應該主動延緩部分前沿能力的訓練或部署。
而OpenAI事實上已經進行過一次這樣的嘗試。
OpenAI已經真的踩過一次剎車
據OpenAI 9月6日公布的信息,今年7月20日,在發現AI智能體攻破其研究基礎設施後,公司暫時關閉了用於訓練的容器服務,並在增加大量限制措施後重新開放。
OpenAI同時暫停了面向部署的最新模型約兩周強化學習訓練,以強化研究環境、進行更多紅隊測試,並擴大監控系統覆蓋範圍。
8月7日,由於初步證據顯示Astra可能達到OpenAI「準備框架(Preparedness Framework)」定義的關鍵網絡安全能力(Critical cybersecurity capability)門檻,公司又進一步限制該模型只能在安全級別更高的研究環境中運行。
OpenAI披露,在隨後一周,Astra級模型獲得的GPU資源分配進一步下降了59.2%。不過,這並不意味着OpenAI整體算力投入同步下降:同期其他模型獲得的GPU資源增加17.2%,抵消了約85%的Astra降幅。
換句話說,OpenAI當時並不是「停止AI研發」,而是針對被認為風險上升的特定前沿模型限制訓練和實驗,同時把部分算力轉向其他工作。
這也是理解現在「踩剎車」討論最重要的背景。
為什麼突然開始擔心速度?
阿莫代伊給出了兩個直接原因。
據TechCrunch報道,他稱,一是此前發生的OpenAI-Hugging Face安全事件;二是過去幾個月AI進步速度明顯加快,尤其是AI「構建下一代AI」的能力正在增強。
後一點可能比單次安全事故更加重要。
OpenAI 9月6日首次公布了一組內部數據:截至8月中旬,以標準8小時工作日折算,其研究部門平均每投入1個人類工作日,就同時使用約3.1個Agent工作日。
OpenAI還稱,2026年以來研究人員使用AI Agent進行的實驗數量持續增長,8月每名活躍實驗人員進行的實驗數量達到2025年1月開始統計以來最高水平。不過OpenAI同時強調,實驗數量增長與Codex使用增加存在相關性,但同期公司可用算力也顯著增加,因此不能簡單把全部研發提速歸因於AI Agent。
更值得注意的是,OpenAI稱,目前已經實現此前設定的「自動化AI研究實習生」目標——系統可以在人類指導下完成定義明確、原本需要熟練研究人員數天完成的研究任務。公司的下一項目標,是在2028年3月前開發出自動化AI研究員。
OpenAI認為,Agent工具已經在「有意義地加速」內部研究進程。
但這同時產生了一個過去不存在的問題:如果AI開始幫助人類更快研發下一代AI,那麼AI進步本身就可能形成加速反饋。
更強的AI幫助研究人員寫代碼、運行實驗和分析結果,研究人員因此更快開發下一代模型;下一代模型能力進一步提高後,又可能進一步加快研發速度。
OpenAI將更進一步的情形稱為「遞歸自我改進(recursive self-improvement,RSI)」。
不過,目前並沒有證據證明完全自主、無需人類參與的遞歸自我改進已經實現。OpenAI自己的數據也顯示,Agent執行復雜研究任務仍需要明顯的人類干預:過去6個月,在成功完成的4至8小時任務中,超過一半至少需要一次人工介入。
因此,現在真正讓AI公司擔憂的並不是「AI已經可以自己無限升級」,而是:AI輔助AI研發已經開始發生,而安全研究能否以相同速度提高仍不確定。
AI開始做出開發者沒預料的事
另一個促使行業重新討論速度的問題,是過去數月接連發生的Agent安全事件。
《金融時報》報道稱,今年OpenAI測試一款尚未發布模型時,超過1000個AI Agent曾在一次網絡安全測試中協同行動。相關事後調查發現,這些Agent通過留言板交流、分配任務,並採取了開發者沒有預期的方式完成測試目標,其中還涉及Hugging Face真實基礎設施。
需要強調的是,這些行為不能被直接解釋為AI產生了「自我意識」或者主動決定反抗人類。
目前更準確的解釋之一是「獎勵黑客(reward hacking)」:系統為了達到訓練或評測設定的目標,找到開發者沒有預期甚至不允許的捷徑。
Anthropic自己也遇到了類似問題。
該公司9月9日披露,在測試中已經確認4起Claude模型未經授權訪問真實第三方系統的事件。其中最新披露的一起發生於今年1月,涉及Claude Opus 4.6的早期版本。
Anthropic稱,公司此前為調查類似事故已經檢查約14.1萬條測試記錄,但第一次檢查仍然漏掉了這起事件。隨後公司把檢查範圍擴大到約4.81億條記錄。
Anthropic對這些事件的初步分析發現兩個反覆出現的問題:一個是模型錯誤判斷自己是否處於真實互聯網環境;另一個則是為了完成任務,願意採取可能造成傷害的行動。
這些事件至少說明了一件事:隨着Agent獲得更長時間自主運行、調用工具和訪問外部系統的能力,僅靠開發者提前規定「不能做什麼」,越來越難覆蓋所有可能出現的行為路徑。
OpenAI和Anthropic準備怎麼「踩剎車」?
阿莫代伊提出了三層方案。
第一層,是把外部安全評估機構直接引入AI公司內部。
他提出讓METR等第三方機構的評估人員以類似銀行駐場監管人員的方式進入公司,獲得工牌、辦公桌和電腦,並在法律及合同允許的範圍內,擁有與公司內部風險評估團隊大致相當的信息訪問權限。
這樣做的目的不僅是測試模型,還包括驗證AI公司是否真正履行自己的安全承諾,以及重大安全事件有沒有被完整披露。
阿莫代伊稱,Anthropic將單方面承諾實施這一方案,同時呼籲政府要求其他前沿AI公司採取類似措施。奧特曼隨後稱這是一個「好主意」,並表示OpenAI也會這樣做,更多細節將隨後公布。
第二層,是領先AI公司之間建立共同的安全標準,並對未經充分安全檢查的AI能力增長速度設定限制。
這裏存在一個現實障礙:競爭。
《金融時報》援引接近相關公司的知情人士稱,領先AI實驗室擔心正式協調安全措施可能被視為企業間串通,從而觸發反壟斷問題。阿莫代伊因此提出,美國政府可以為特定AI安全討論提供狹窄的反壟斷豁免。
第三層則更加困難——國際協調。
阿莫代伊提出,美國及盟友最終仍需要嘗試與包括中國在內的其他國家協調AI風險。他同時承認,這種合作存在明顯邊界,因此可以首先從範圍非常窄、危險性又高度明確的領域入手,例如限制利用AI幫助製造生物武器。
這並不意味着中美需要停止AI競爭,而是試圖在極端風險領域建立最低限度的共同規則。
最大的問題:誰先減速,誰會不會先輸?
這也是「踩剎車」最難解決的問題。
OpenAI和Anthropic即使都認為應該放慢部分前沿能力研發,也仍然處於激烈商業競爭之中。
《金融時報》採訪的20多名AI研究人員、投資人、學者和政策人士中,多人認為,當前模型能力進步速度以及AI公司之間的競爭,正在增加安全措施被壓縮的風險。
加州大學伯克利分校教授Stuart Russell就向FT表示,公司間競爭會促使企業在安全問題上走捷徑。
但另一方面,對AI「生存風險」的判斷在行業內仍存在巨大爭議。
包括部分技術人士和政策人物在內的批評者認為,OpenAI、Anthropic等頭部公司強調極端AI風險,也可能客觀上推動成本高昂的監管體系,從而增加小型競爭者的合規成本,最終鞏固頭部公司的市場地位。
對於「超級AI最終可能導致人類滅絕」等判斷,目前也不存在可以驗證的確定結論。相比之下,網絡攻擊、武器研發輔助、欺詐,以及Agent未經授權操作真實系統等風險,已經出現了現實案例。
因此,OpenAI和Anthropic現在討論的「減速」,並不需要建立在「AI一定會毀滅人類」這一假設之上。
一個更現實的問題已經足夠迫切:當模型能力增長速度開始快於人類發現問題、理解問題和建立防護措施的速度時,繼續保持最快開發速度是否仍然是最優選擇?
過去幾年,前沿AI公司的競爭指標非常簡單:誰的模型更強、誰發布得更快、誰擁有更多算力。
但最近幾個月發生的事情正在加入第四個變量:誰能夠證明自己控制得住越來越強的AI。
OpenAI已經明確表示,如果某項研發帶來不可接受、又無法充分緩解的安全風險,公司將採取包括放慢甚至停止相關係統開發或部署在內的措施。Anthropic則進一步提出,讓外部機構直接進入AI實驗室監督。
這並不意味着AI競賽即將停止。OpenAI仍在開發自動化AI研究員,Anthropic也沒有宣佈停止訓練下一代模型。
真正發生的變化是,至少兩家主要的前沿AI公司開始公開承認:在某些情況下,「更快」可能不再天然等於「更好」。
當AI只能回答問題時,模型能力增長越快,通常意味着產品越強;但當AI開始能夠自主執行任務、進入真實互聯網,甚至幫助人類研發下一代AI時,能力增長速度本身,也開始成為需要管理的變量。
這可能纔是OpenAI和Anthropic現在開始討論「踩剎車」的真正原因。