機器人前瞻(公衆號:robot_pro)
作者 | 鍾宸
編輯 | 漠影
機器人前瞻9月18日報道,今天,Figure發布了新模型Helix 2.5,這是其迄今為止構建的最先進的神經網絡模型。
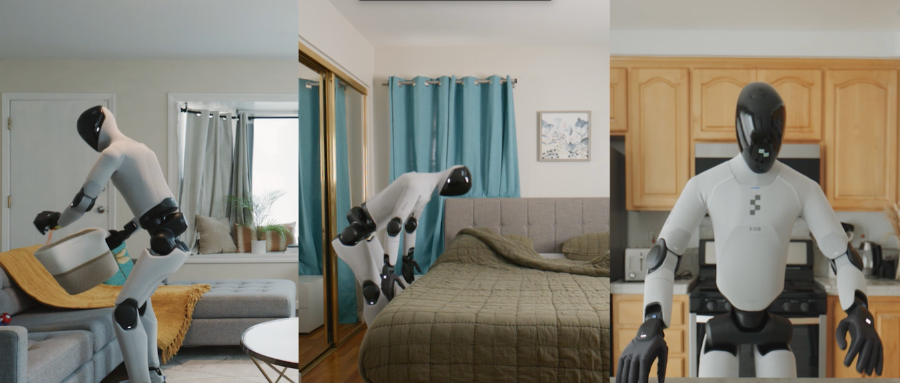
Figure將這一模型帶到了30個真實的家庭環境中,並表示模型幫助機器人實現了零樣本的全身自主行為(Zero-shot whole-body autonomy),這是在這種規模上,首次實現了人形機器人零樣本全身行為泛化能力的演示。
同時,Figure將單一的預訓練基礎模型應用於三種不同的行為:移動、剛性及可變形物體的操控、雙手協調運動,以及主動感知能力。
Figure還透露,只要保持任務特定數據(task-specific data)、架構、訓練方法和評估方式不變,僅通過Index(Figure面向全球規模構建的機器人數據集項目)預訓練就能將零樣本識別的成功率從9%提高到56%,且該模型也驗證了人機轉換的Scaling Law(A Human-to-Humanoid Robot Transfer Scaling Law)。
另外,在Helix 2.5中,所需的任務特定數據僅為Helix 02的一半。
一、展示四小時實機視頻,可整理房間、鋪床和疊毛巾
Figure在X上展示了約四個小時的視頻,包含Helix-2.5在真實家庭完成整理房間、鋪床、疊毛巾的長程任務演示,無需在任何環境或操控物體的過程中進行數據收集、微調或適應處理(collection,fine-tuning,or adaptation)。
Figure表示,這是首次在這一規模上,實現人形機器人零樣本全身行為泛化能力的演示。
Figure放出的演示視頻中,Helix 2.5的表現較為驚豔。工作人員故意把物品扔得滿屋都是,機器人便在整個屋子裏來回搜尋,一件一件撿起來,放進人類遞來的籃子,最後還不忘記把籃子放到客廳角落裏。整個流程耗時約一分半。
真正令人眼前一亮的是一個細節:撿最後一件物品時,機器人第一次抓取失敗了,但它沒有停下求助,而是換了個角度重新嘗試。
Helix-2.5先是擺正枕頭,再將被子鋪平,甚至還記得把床沿處垂下來的被角也掖好整理。一套動作下來,比人類還要細心一點。
疊毛巾任務中,面對四條毛巾,Helix 2.5都是先攤開、再對摺,過程中還不斷調整鋪平,動作幾乎沒出過錯,只是四條毛巾疊完足足花了五分多鐘,精準有餘,速度尚待打磨。
另外,據Figure透露,該模型擁有從錯誤中恢復的能力。
當面臨諸如未撿起物體、拿起被子失敗的錯誤時,機器人會後退一步,重新定位自己,然後圍繞環境移動,以糾正錯誤並完成那些需要長期規劃的任務。
二、承諾投入超200億算力,Index預訓練產生泛化能力
Figure指出,在訓練過程中,模型必須利用已有的知識來解決整個感知與控制問題。在複雜的任務中實現自主行為,即使在熟悉的環境中也極為罕見。該公司稱,Helix 2.5是第一個能夠在家中、且面對從未接觸過的物體時實現這一能力的模型。
Figure還想要弄清楚,Helix 2.5的零樣本泛化能力究竟是來自於Index預訓練,還是來自於具體的任務數據本身?
於是,Figure在相同的任務特定數據上訓練了兩種策略,這些數據中並不包含任何評估樣本或對象信息。
其中一個策略以隨機權重初始化,另一個則基於Index預訓練的Helix 2.5模型進行初始化。
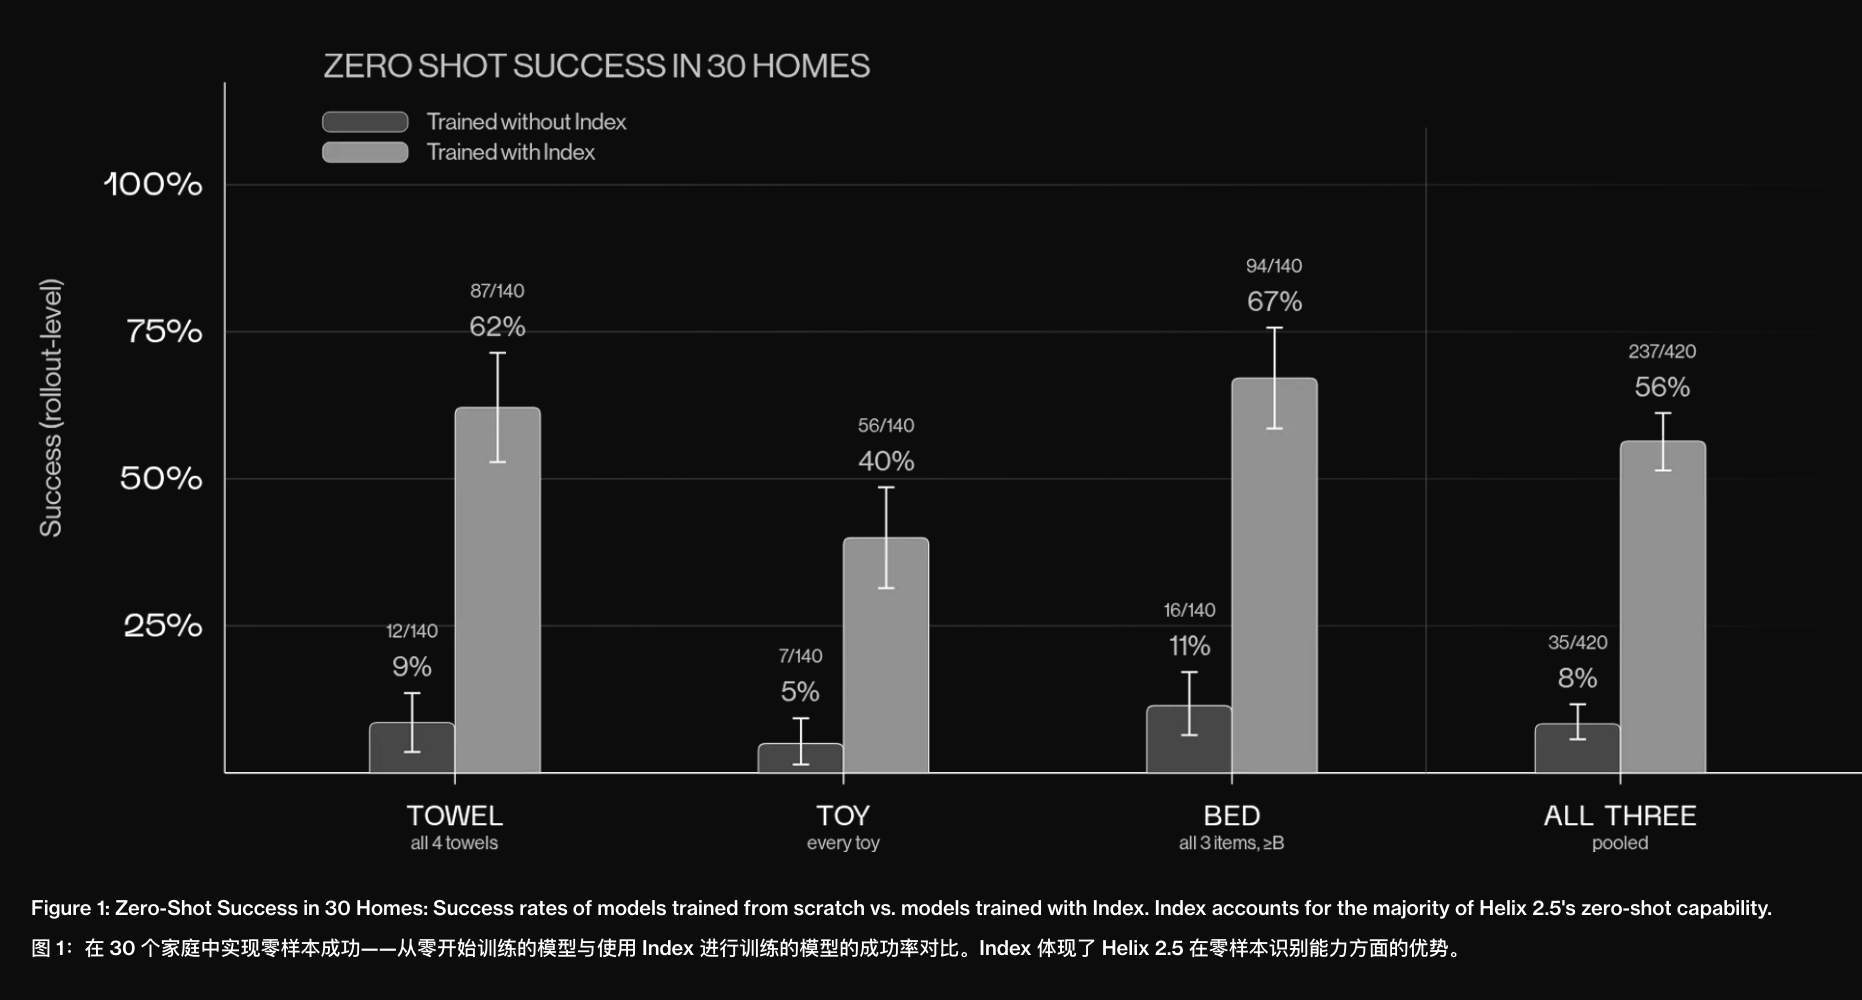
Figure發現,Index預訓練是Helix 2.5零樣本能力實現的一大因素。在盲測中,從零開始訓練的策略在測試中的成功率為9%,而採用Index預訓練的策略則取得了 56%的成功率。
Figure還將Helix 2.5與Helix 02進行了比較。Helix 02是通過在評估後的環境中直接收集的數據進行訓練的。Helix 2.5在使用的數據量僅為Helix 02的一半的情況下,仍然取得了與Helix 02相當的成功率。
另外,Figure還驗證了人機轉換的Scaling Law。
該公司在擴展了8倍預訓練數據的Index數據集上訓練了四個模型,同時保持模型規模不變,也不對下游訓練方式進行更改。這些模型都在相同的任務數據上進行微調,並且以相同的動作預測損失(held-out action-prediction loss)作為評估標準。
而隨着數據的增加,損失也會相應減少。Figure指出,這是首次在人形機器人身上觀察到這種Scaling Law,即Index預訓練規模擴大,可以改善後續機器人行為的預測效果。
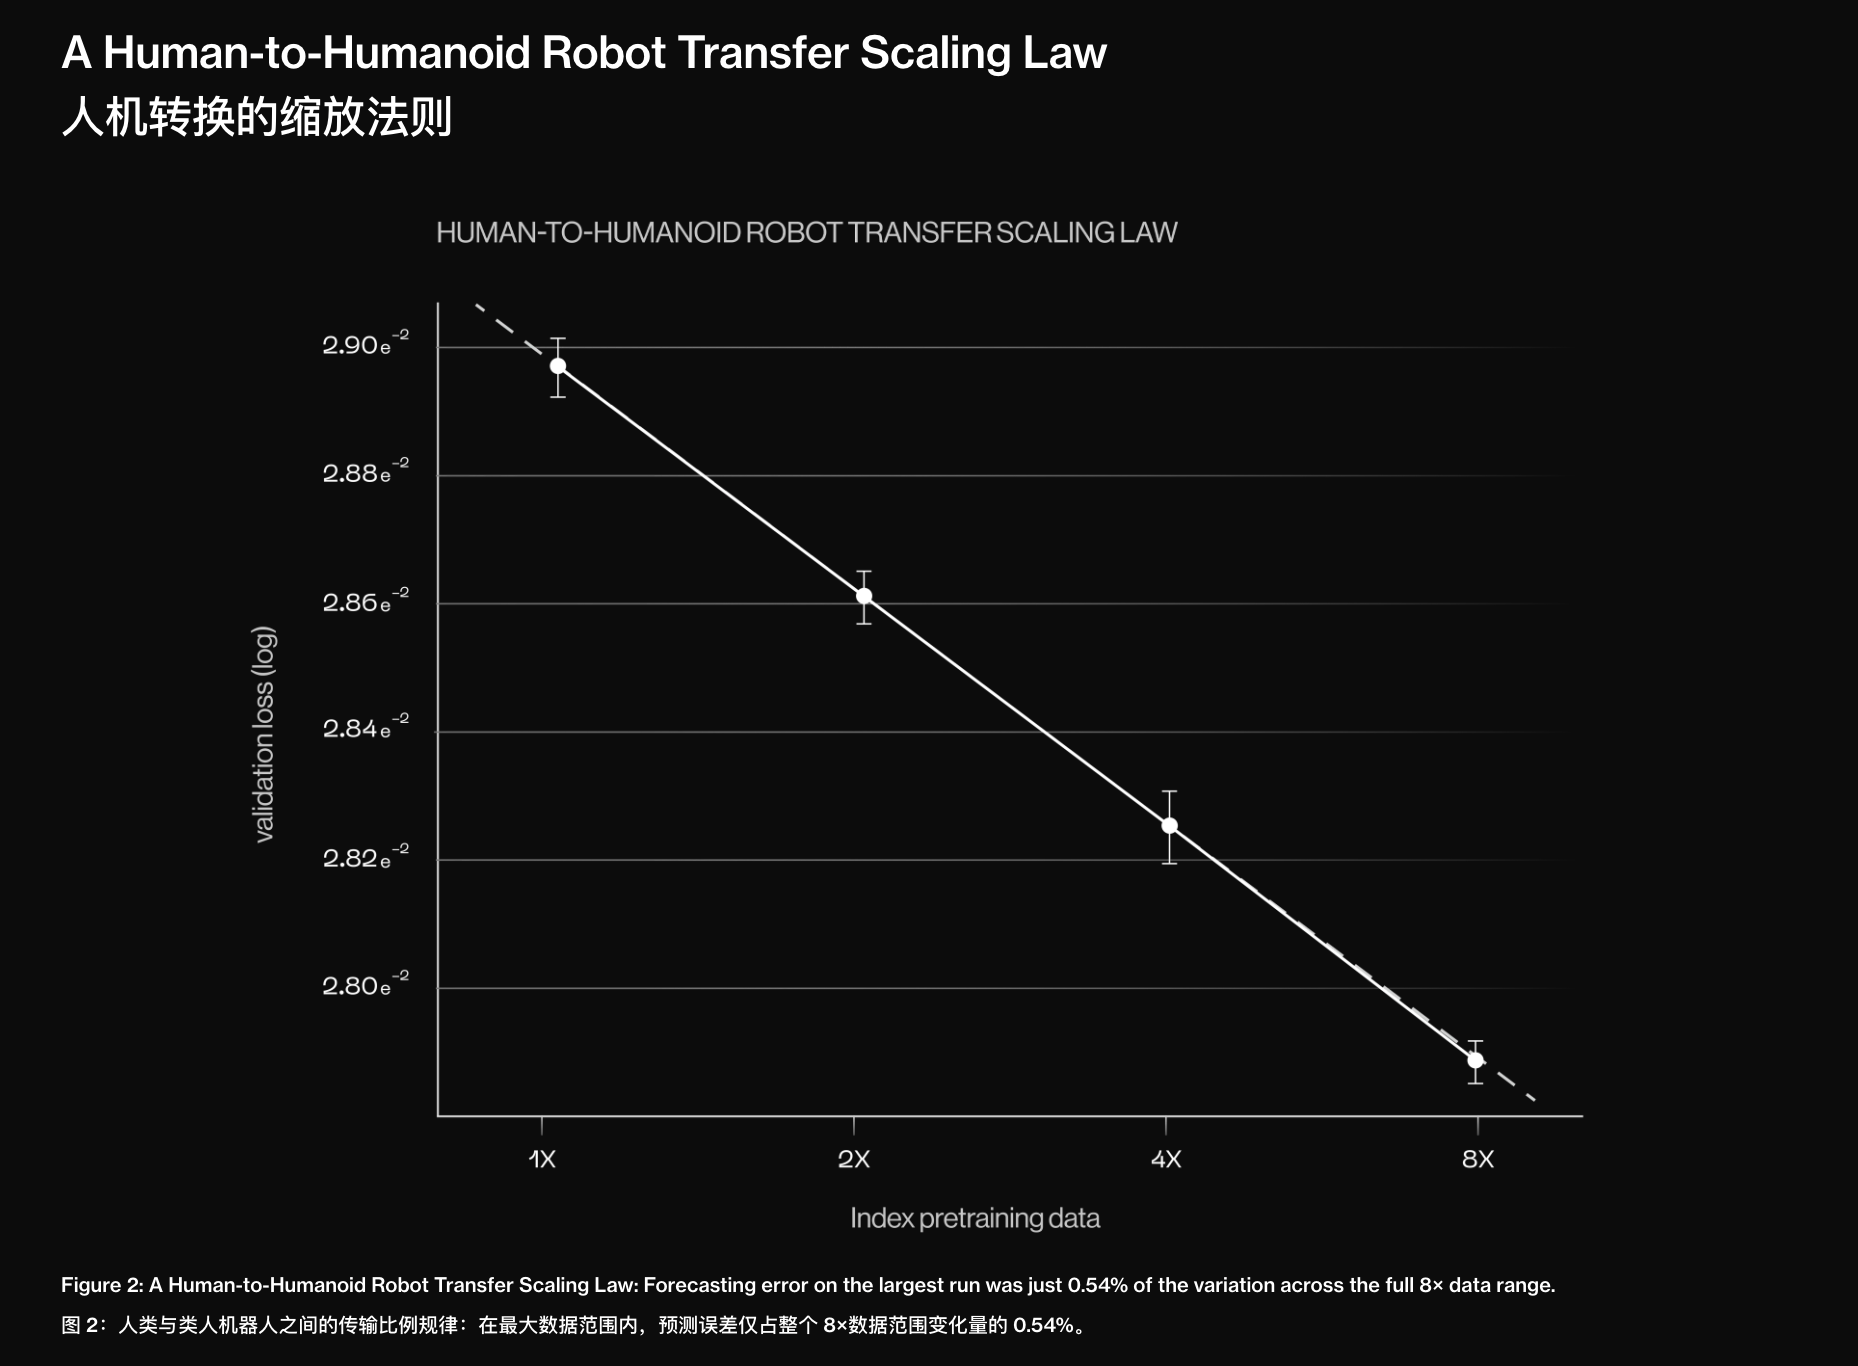
同時,Figure透露,兩者的關係相關性足夠準確,還可以進行預測。僅通過較小的樣本,Figure就能在訓練開始之前,將最大值的測試誤差預測到四位小數的精度,在數據範圍擴大的過程中,預測誤差僅為0.54%。
目前,Figure稱,Index每秒大約能生成35分鐘的新人類經驗數據。為了訓練Helix模型,其已承諾投入35億美元(約合234.43億元人民幣)的算力資源。
結語:高額投入,砸出一條Scaling Law
在X(原推特)上,部分網友對這一成果表示認可,還希望能夠儘快用上這個機器人。
但也有人表示,需要觀察這個模型能不能完成更多的任務。
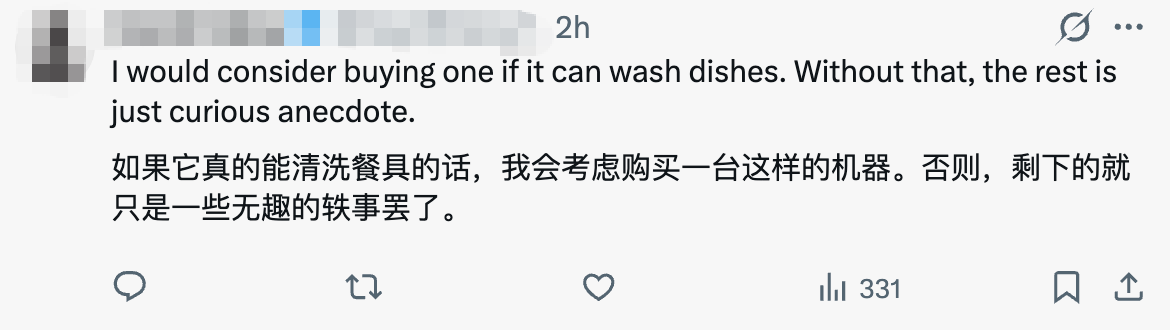
但不可否認的是,Figure用真實任務證明,Index預訓練能將零樣本成功率從9%拉到56%,且擴大預訓練數據可持續改善下游行為預測,這一定程度上證明,具身智能的數據飛輪開始具備可預測、可擴展的工程範式。
當然,超兩百億的承諾算力投入又提醒着所有人,這條路的門檻極高。但當機器人能用一半的任務數據達到同等效果,具身模型的路線圖已愈發清晰。接下來的懸念是:誰能以更低成本,跑通這條Scaling Law曲線?
技術博客:https://www.figure.ai/news/helix-2-5-zero-shot-30-home-generalization
X鏈接:https://x.com/Figure_robot/status/2100657350952779925