
百萬元設備,給機器人臨時裝了一個「假大腦」

今年,打球幾乎成了機器人展示「自主能力」的熱門項目。
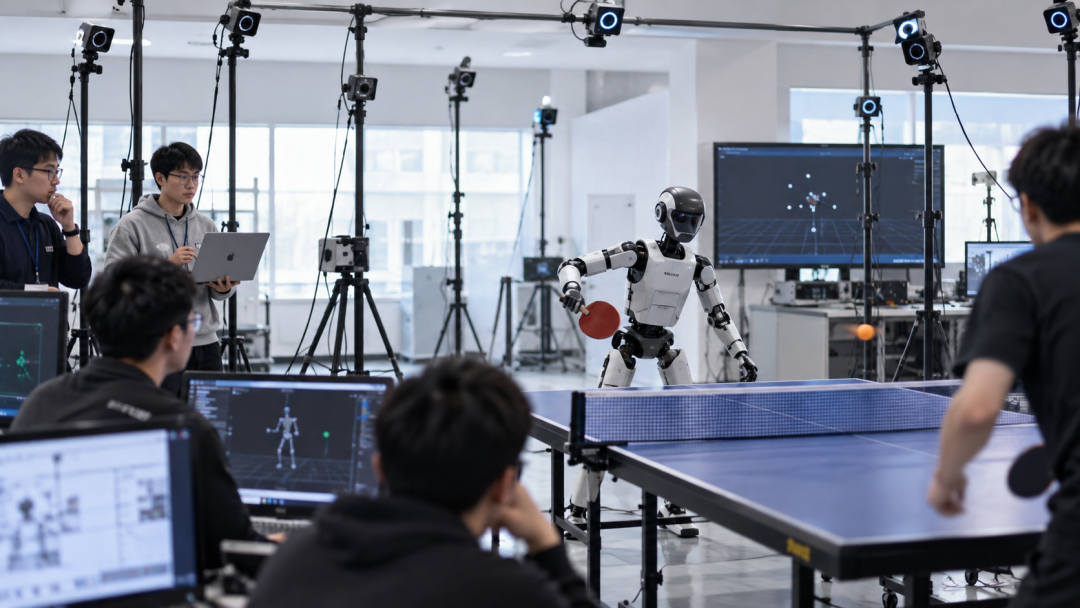
球高速飛過來,機器人自己移動、揮拍、回球,有的甚至能和真人連續對打幾十拍、上百拍。
這樣的畫面很容易讓人以為:過去只會走路、翻跟頭、搬東西的機器人,終於開始擁有處理動態世界的「大腦」。
但實際上,這類Demo,用三個詞,可以精簡概括本質:「瞎子」、「木偶」和「假大腦」。沒有遙控器,就等於機器人自己幹活了嗎?
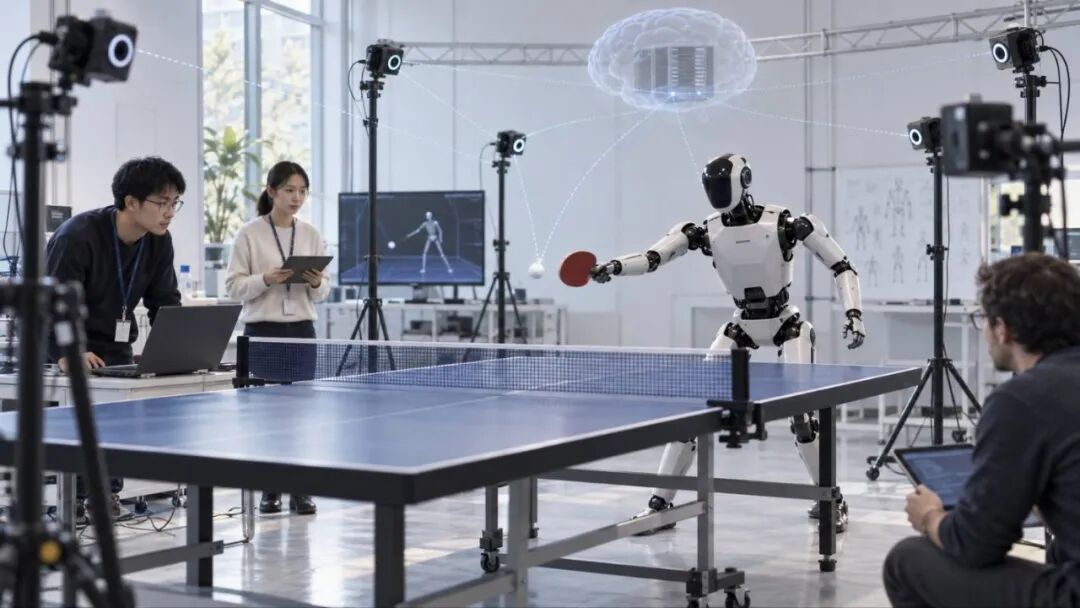
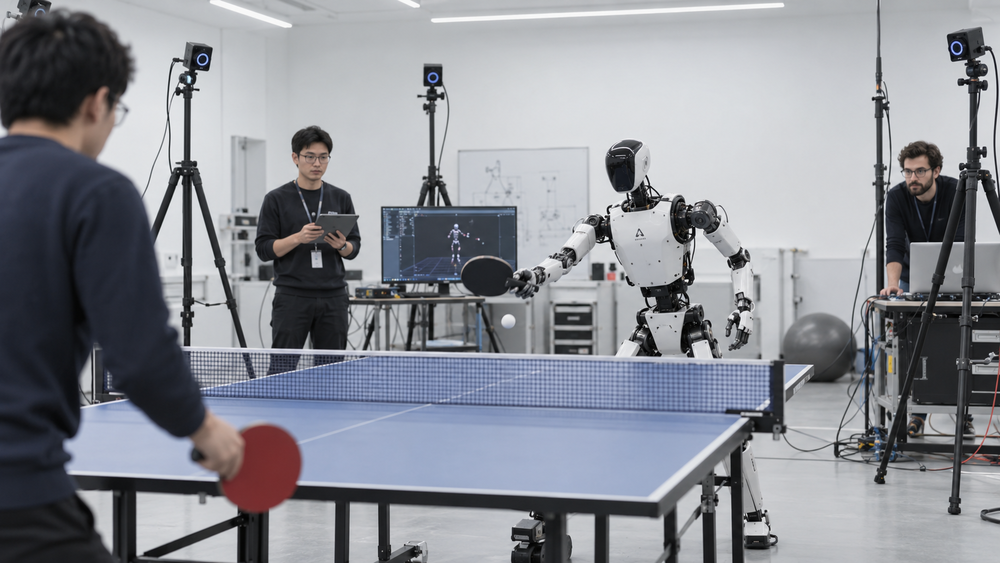
有些本該由機器人大腦自己完成的「看見世界、判斷物體怎麼運動」的工作,被場地外一整套高精度設備提前做掉了。
也就是相當於用一整套上百萬元級的外部設備,臨時給機器人裝了一個「假大腦」和幾十雙「眼睛」。
這也像是用一套「巨型設備」在做遙操:機器人自己其實沒看見什麼,外部系統已經把關鍵位置告訴它了,「球到你跟前了,打吧」——
場地提前測量、相機提前標定,球塗上反光物質後被高頻、高精度地追蹤,再交給上層程序計算球什麼時候會到、球拍應該到哪裏。
這和人打球的邏輯並不是一回事。
人不會先把球場做一遍毫米級標定,而是用自己的視覺觀察對手動作、球速和方向,在不完全準確的信息下不斷預估下一步。
但這不意味着機器人什麼都沒做到。
它拿到位置和擊球目標以後,仍然要在很短時間內控制身體跨步、調整姿態、保持平衡、揮拍和連續回球,這說明今天機器人的「小腦」和全身運動控制已經取得了明顯進展。
問題只是:「小腦」很強,不等於「大腦」已經自主。
這個判斷來自林知遠(化名)。
過去兩年,不少自動駕駛人才轉向具身智能。林知遠是其中的典型。
他曾任百度自動駕駛資深工程師、蘿蔔快跑創始成員,完整經歷約十年工程化周期。
如今轉向具身智能,關注模型如何通過端側推理、監督、校驗和恢復,真正進入物理世界長期工作,並實現機器人大腦「自進化」。
這也是為什麼,他看機器人打球,關注的並不是「能連續打多少拍」,而是另一件事:
機器人的感知、判斷、執行和結果反饋,到底有多少真正發生在機器人自己的閉環裏?
沿着這個問題往下追,會發現今天談「機器人大腦自主」,至少還要跨過三道門檻。



今天很多機器人Demo已經「沒人拿遙控器」。
但「沒有人實時操縱」和「機器人大腦自己完成任務」,是兩套標準。
前一種自主,只要求整個系統可以自動運行;
後一種自主則要求機器人依靠可以隨身部署的感知和計算能力,自己觀察環境、理解任務、生成行動,並確認行動之後的現實結果。
打球Demo把兩者的差別暴露得很清楚。
運動控制是真的,全系統自動運行也是真的;但「機器人自己看見球並理解球的運動」這件事,並沒有完整、獨立地發生在機器人身上。
林知遠把它類比成自動駕駛裏的高精地圖。
高精地圖曾經非常有效,因為很多道路信息可以提前測量好,再交給車輛使用;但自動駕駛真正走向開放道路以後,行業逐漸發現,依靠一個提前整理好的世界,和讓汽車自己理解不斷變化的世界,並不是同一道題。
機器人的問題也是如此。
如果一項能力必須依賴提前標定好的房間、固定機位和特殊反光標誌才能存在,那麼真正值得追問的是:
撤掉這些專門為演示搭出的條件之後,它還能剩下多少能力。

林知遠並不反對Demo。
在技術發展的早期,一次漂亮的展示本身有價值:它能讓外界第一次看到某種能力存在,幫助團隊獲得關注、資金和下一步研發資源。
科研項目把一個極難的問題拆開,先解決運動控制、再逐步補齊感知。
但今天AI研發和過去有一個明顯的不同:能力提升更加依賴真實反饋。
如果一套演示做完以後,既無法進入真實任務,也不能持續產生真實的結果、失敗和糾偏數據,那麼這個Demo和下一輪能力增長之間的聯繫就會越來越弱。
林知遠說得很直接:「你總不能在現實世界中架這麼一套東西,在你每一個擺弄的物件上塗上反光物質。」
如果團隊長期為了這種效果投入,甚至可能「跑偏三個月、六個月」,最後大家自己都知道,「我們在做一個trick(套路)」。
所以,Demo真正的分界線,不是夠不夠「漂亮」,而是:
這次成功,有沒有縮短下一次進入真實世界的距離。
真正的自主要能證明,這種能力離開展台、固定佈景,進入陌生環境之後,仍然可以存在。
但即使有一天,機器人真的能依靠自己看清球,問題也只解決了一半。
因為:看見了,不代表它知道自己有沒有做對。



真實任務裏的失敗,比「抓沒抓住」複雜得多。
比如一個機器人接到任務,把杯子拿到桌上。
它完成抓取、移動和放置,每一個動作都做了,但杯子歪了,水正在往外漏。這顯然不能算真正完成。
生產現場裏的情況更明顯。
油漆刷完,不等於刷均勻;巡檢走完,不代表異常都發現;一個包含十步的任務,即使每一步看起來都「差不多對」,也可能因為前面一點誤差不斷累積,到最後完全偏離真正目標。
林知遠認為,長程任務中最危險的一種失敗是:機器人已經偏離目標,但自己不知道。
這使機器人大腦的職責不能只停留在「生成下一個動作」,它還要繼續判斷動作是否做多、結果是否合格,繼續執行會不會產生更大問題。
一旦發現問題,還要在重試、局部修正、重新規劃、降級執行和人工介入之間作出選擇。
林知遠說:
「它知道它不行了,或者它知道它失敗了。」
這也意味着,機器人向人求助,並不天然代表「不自主」。
一個系統如果已經走到能力邊界,卻仍然不知道應該停下來,反而是更危險的不成熟。

今天具身智能裏一個很熱的爭論:
當VLA、世界模型和端到端模型越來越強,未來是不是只需要一個足夠大的模型,機器人裏今天所有的分層、監督和安全系統都會消失?
他並不否定模型融合,相反,他在自動駕駛裏已經經歷過一遍類似的過程。
過去十年,自動駕駛從大量獨立模塊逐漸被越來越統一的模型吸收。
但模塊數量減少之後,原來承擔的狀態檢查、安全校驗、故障處理並沒有憑空消失,只是換了技術形式,有些變成規則,有些變成服務,有些繼續由人機系統承擔。
所以他說:
模型邊界會不斷合併,責任邊界不會消失。
端到端討論的是模型內部如何計算;閉環系統討論的是機器人如何對現實結果負責。
未來用戶不關心某項能力最終是否寫在模型裏,但真正工作的機器人不能出現:模型更聰明,卻無法判斷「這件事已經做錯了」。

更現實的一層問題是時間。
當物體正在滑落、機械臂即將發生碰撞時,現實世界不會停下來幾秒鐘,等一個更大的模型慢慢思考。
所以,未來真正的「大小腦」問題,不是最終會不會把小模型全部喫掉,而是:
什麼能力需要慢而強,什麼能力必須快而確定,以及兩者的經驗怎麼重新匯合。

不要過早相信今天的技術表達已經是終局。
過去十年裏,自動駕駛幾乎每隔兩三年都會經歷一次明顯的範式變化。
高精地圖、環境感知、空間表達都不斷變化,很多真正推動行業前進的突破,並不是在原來的模型上再多堆一點能力,而是重新定義輸入、輸出和對世界的表達方式。
所以他看今天的VLA,也沒有把它當作已經定型的終極架構。
他對當前部分VLA最直觀的感受是:
「慢。」
即使使用很強的算力,也還是不那麼「聰明」。
因此他認為現在的VLA很可能還是一種「中間狀態」。
其中真正更沒有定型的,是最後一個字母——Action(動作)。
他認為,今天最自然的數據表達,不一定就是最後的表達。未來如果執行器、材料和控制方式變化,動作表達本身也可能被重新定義。
世界模型也是類似邏輯。
他並不否認世界模型長期可能參與更直接的動作控制,但在現階段,他更看重它在世界預測、仿真、訓練數據生成和策略驗證中的作用,甚至認為它未來可能還是一種更高級的「仿真器」。
所以今天急着討論「VLA還是世界模型誰會贏」,可能仍然太早。
真正應該觀察的是:
哪一種新架構,最終能夠讓機器人更快、更穩定,也更容易進入下一個真實場景。



如果不看模型參數、發布會和Demo,只允許留下一個指標來判斷機器人是不是正在變成真實生產力,他會選:
真實任務連續替代人的時間。
也就是在一個真正有價值、有明確結果標準的任務中,機器人究竟能連續把人替代多久。
這個指標把任務價值、運行穩定性、異常恢復、人工介入和最終結果綁在了一起,比一次動作成功率或者一段挑選後的演示視頻,都更難「做漂亮」。
更重要的是,一旦機器人真正進入生產,它就獲得了一種實驗室裏很難買到的數據:真實反饋。
他說得很形象:「有人給你反饋,告訴它變笨了;有人告訴你實話。」
實驗室裏,可以由研究者定義什麼叫成功;生產現場卻不會。
漆刷得不均勻,巡檢漏掉一個問題,都會產生真實的工作結果和影響。
所以真實生產不只是商業驗證,它同時還是一套天然的評測和數據系統。
現實世界真正珍貴的,不只是數據,而是有人願意告訴機器人「你錯了」。

行業裏常說:60分以前靠模型和數據,60分以後主要靠工程。
他不完全認同。
他認為,機器人到了60分以後依然是數據競爭,只是對數據類型和品質的要求變了。
60分以前,只要機器人「基本能work」,偶發異常還可以容忍;但一旦進入生產,標準會更加具體且嚴格。
這意味着數據需要帶上任務結果、失敗發生的位置、失敗原因、恢復策略和最終結果。
而「失敗四次,第五次終於成功」,也不能直接被叫作「自進化」。
他認為,真正的學習還要經過時間序列驗證、跨場景遷移、跨本體遷移,以及能力退化和回滾測試。
一個已經會刷馬桶的機器人,如果只需要補少量數據就能去刷油漆,這纔開始說明它獲得的是一種可以遷移的能力。
所以,一條經驗裏,開始要包含結果、失敗和糾偏。

汽車賣出去以後,數以百萬計的用戶每天在真實道路上開,本身就是一個巨大的數據生產網絡;
但很少有人願意花20萬元買一台機器人,再長期免費替機器人公司生產訓練數據。
如果每進入一個新場景,都重新進行大量真機採集,成本很難形成規模效應。
因此他更看好另一條路徑:先通過基礎模型和仿真形成一部分能力,再把機器人送進真實場景驗證,哪裏出現sim-to-real差距、哪裏失敗,就針對性補哪裏的數據。

如果機器人今天還做不到能幹,它應該先去哪?
他不認為最容易切進去的是已經自動化的先進產線。
一條成熟工廠本來運行得很好,讓一個尚不成熟的機器人進去測試,意味着效率損失、安全風險和現場人員配合,很多時候機器人團隊甚至需要付費,工廠才願意開放場景。
「機器人現在去一條成熟產線,很可能首先是‘去添亂的’。」
相比之下,地下管網、密閉空間、船艙噴漆和焊接這些不那麼「性感」的場景,反而具備更好的早期條件:
人本來就不願意進去,危險和健康風險較高,任務有明確價值,結果能被驗收。
船艙噴漆就是一個典型例子。
一塊平整鋼板,傳統機械臂早已可以刷得很好;真正幾十年沒有完全解決的,是船體成型以後,裏面不斷變化的隔板、折角、犄角旮旯和不同船型,機械臂沒有固定位置,也無法每一次都精確配準。
他把傳統自動化形容成:「瞎的。」
它腦子裏存着幾個固定點,到一個點完成一個動作,但它並不真正理解哪裏可以通行、哪裏應該作業,以及今天這個環境和昨天有什麼不同。
而這一輪具身智能真正想補的,就是:
從「按照固定座標重複動作」,變成「環境變了,依然能把任務做完」。
因此,第一批真正形成生產力的具身場景,反而可能來自傳統自動化幾十年沒有解決掉的那些「非標死角」。

機器人大腦的競爭,是不是正在從「完成一次任務」,走向「知道什麼時候失敗、怎麼恢復、什麼時候求助」?
他的回答是:「這是一個方面。」
另一半,是遷移。
在他的判斷裏,機器人大腦至少有兩條座標軸。
一條是時間軸:一次成功能不能變成長期可靠,失敗能不能被發現,發生問題以後能不能恢復並繼續工作。
另一條是空間軸:離開原來的任務、環境甚至本體以後,這套能力還能留下多少,又需要重新補多少數據和工程投入。
只解決前者,一家公司可能把一個項目磨得極其穩定,但換一家工廠又重新開始;只解決後者,一個模型也可能什麼都會一點,卻沒有一個任務真正能長期工作。
所以,一套真正有平台能力的機器人大腦,最後其實只需要回答兩個很難作弊的問題:
它能不能越做越久?
它能不能越換越便宜?
回頭再看那些會打球的機器人,漂亮的擊球當然值得驚歎,它至少說明機器人的「小腦」和全身運動控制已經進步很快。
但「大腦自主」是一道更難的題。機器人不僅要完成動作,還要知道動作有沒有真正產生正確結果,並且把今天的一次成功,變成明天可以長期運行、換一個地方仍然有用的能力。
所以,機器人大腦真正的分水嶺,並不是:「它會不會做一個漂亮動作。」
而是:它能不能對自己做出的結果負責,並把一次成功變成長期、可遷移的能力。
從「會表演」,到真正「會工作」,差的正是這一層。


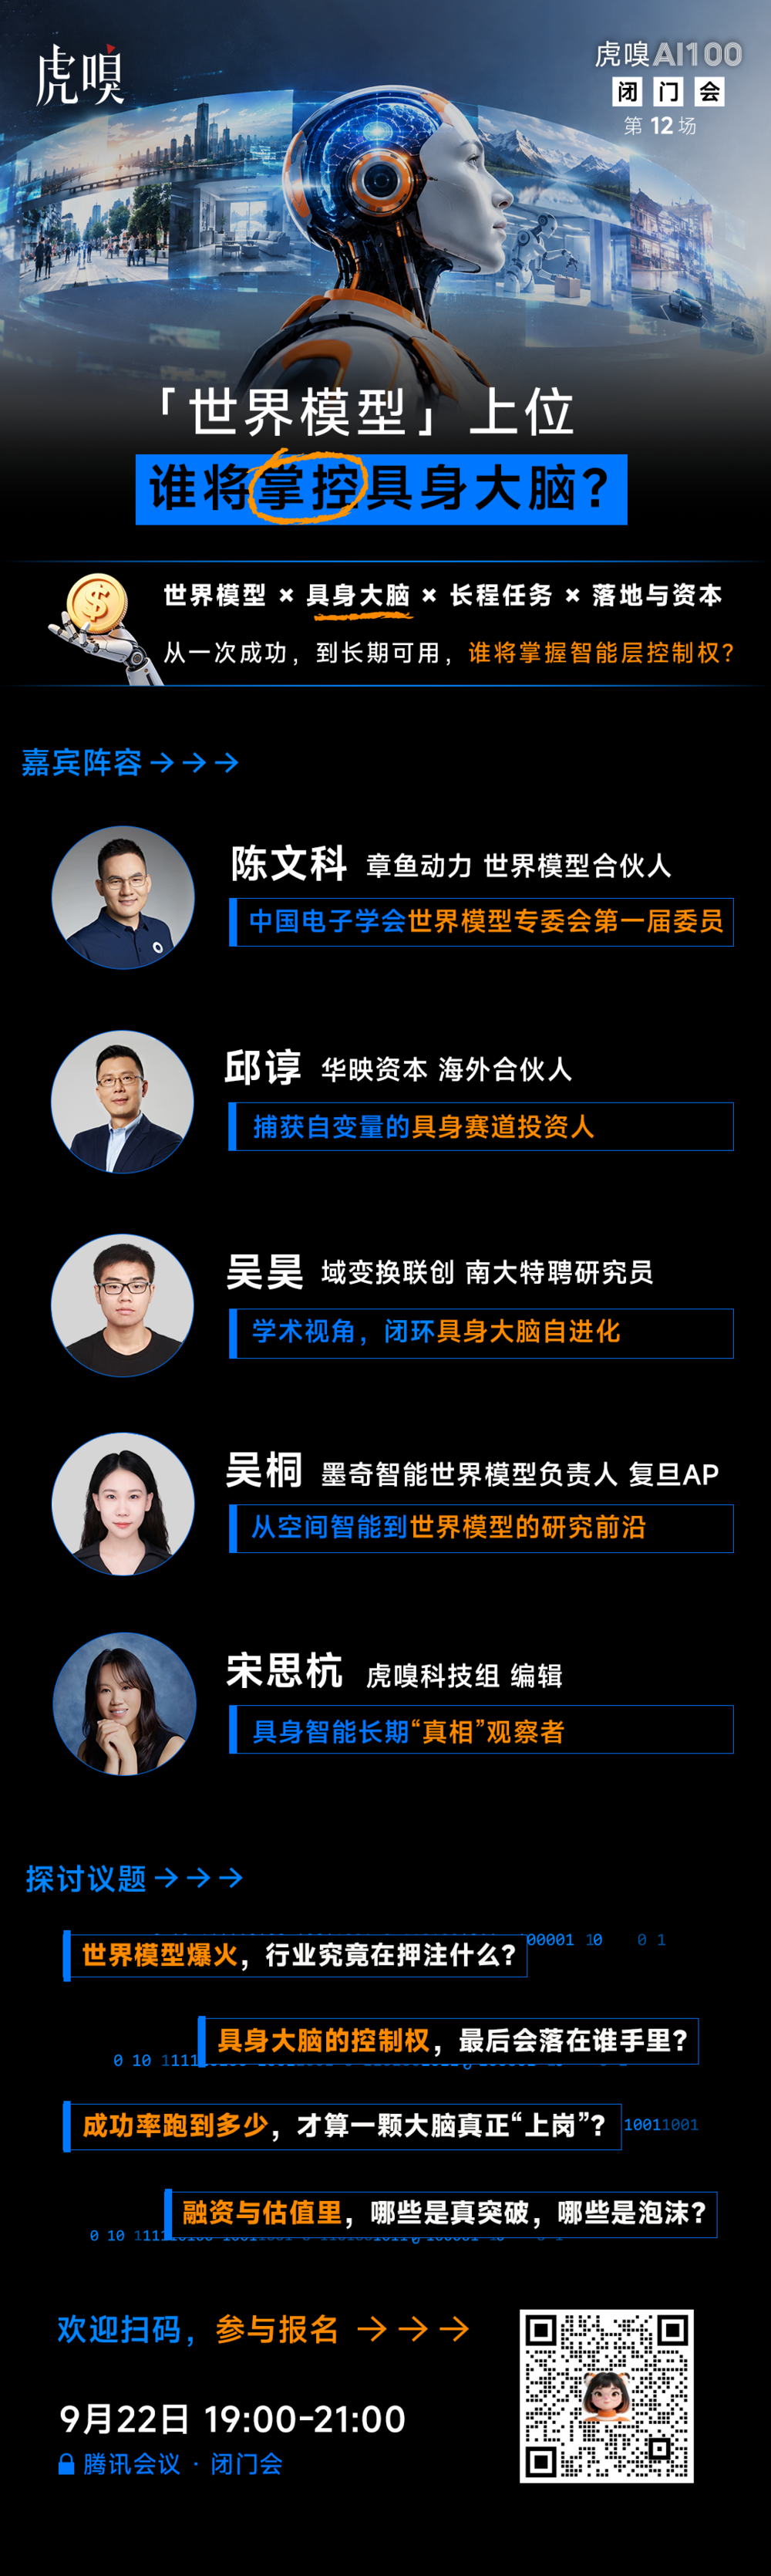
下周二晚7點,虎嗅 AI 100 閉門會,追問:世界模型上位,誰將掌控具身智能的大腦?
400億孖展、超七成押世界模型。
創業、模型、資本、學術視角的四位專家同台,聊清楚:
機器大腦怎樣纔算真「上崗」,哪些技術是真突破,今天的高估值如何兌現。
想看更前沿的一面,下圖掃碼報名。
本文圖片來自AI生成。
本內容來源於網絡,觀點僅代表作者本人,不代表虎嗅立場。如涉及版權問題請聯繫 hezuo@huxiu.com,我們將及時覈實並處理。
End