2004年的《機械公敵》裏,機器人桑尼已經很像一個真正的「人」。它不只是聽從命令。它會觀察周圍的環境,會理解人的意圖,也會在面對複雜情況時判斷、思考,甚至做出自己的選擇。
電影並沒有花太多篇幅解釋桑尼是怎麼學會這一切的。一個足夠靈活的身體,一顆能夠理解世界的大腦,似乎天然就應該同時存在。但現實裏的機器人,會動和會幹活並不劃等號。
過去幾年,人形機器人先把「身體」練了出來。從蹣跚走路到跑步、跳躍、空翻,再到跳舞、打拳,運動控制能力以肉眼可見的速度進步。機器人能做出的動作越來越複雜,身體也越來越接近電影裏的想象,而「大腦」的進化卻遠比想象的複雜。
GPT-6 Astra發布後,一個有意思的實驗很快發生在機器人身上。銀河通用團隊很快把GPT-6 Astra放進機器人測試中,並嘗試將它與π0.5這樣的機器人基礎模型結合。結果並不是一個簡單的「更強」:GPT-6 Astra在語義理解、空間推理等任務上表現突出,但進入需要複雜接觸、力度控制和雙手協同的物理任務後,依然存在不少無法解決的case。測試中,經過專項訓練的端到端模型在部分接觸類任務上仍然更有優勢。
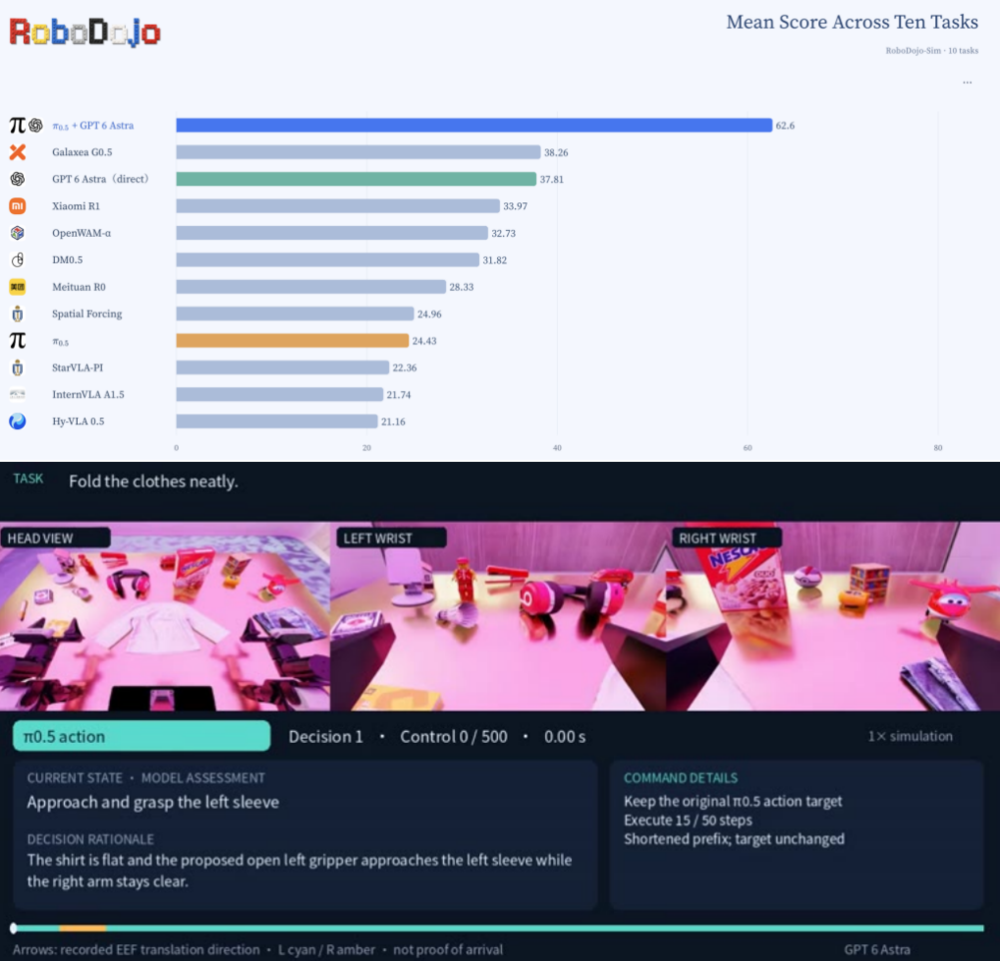
這也揭示了具身智能真正困難的地方。機器人需要解決的,不只是如何理解世界,也包括如何在世界中自主行動,而且二者並不是簡單拼接,而是在感知、決策、執行和反饋中不斷耦合。一個足夠聰明的圖文大模型,再加上一個機器人動作模型,並不天然等於一個足夠聰明的機器人。
但GPT-6 Astra帶來的另一個信號或許更加重要:當美國頭部通用AI公司開始把能力、資本和數據基礎設施進一步投向物理世界,具身智能的競爭正在加速。OpenAI目前已經在擴充機器人團隊,並明確建設規模化機器人數據採集體系。
對於中國具身智能公司而言,問題因此變得更加具體:除了模型和本體,如何儘快建立屬於物理世界的數據壁壘?銀河通用正在尋找自己的答案。
機器人獲得能力的方式正在改變
把過去幾年的人形機器人發展拆開來看,會發現行業很長一段時間都在解決一個問題:怎麼把身體練出來。站穩、走路、跑步、上下樓梯、空翻……這些能力背後,是電機、關節、機械結構和運動控制算法的共同進步。今天再看一台機器人完成一套複雜動作,人們已經沒有幾年前那麼驚訝了。
但「做出一個動作」和「擁有一種能力」,並不是一回事。一台機器人可以把一段舞蹈跳得非常流暢,卻不意味着換一首歌也能馬上跟着跳;可以在訓練好的場地裏搬箱子,也不意味着換一個貨架、換一種包裝,就依然知道該怎麼抓。
原因在於,過去機器人學習一項技能,很像一個需要反覆備考的學生。動作捕捉、遙操作、模仿學習、專項訓練……工程師先把任務拆出來,再採集對應的數據,訓練模型,最後把能力部署到機器人上。一個任務學會了,再去學下一個。
這套方法當然有效。問題是,真實世界不會按照訓練集出題。桌子有高有低,商品形狀各不相同,人會突然從機器人面前經過,貨物可能被放錯位置,機器人伸手時物體也可能發生滑動。實驗室裏能夠窮舉的問題,到了開放環境裏幾乎沒有窮舉的可能。
銀河通用給出的技術路徑,並不是簡單地把「大模型」接到機器人身上,而是圍繞「大腦—腦橋—小腦」構建一套完整的具身智能系統——銀河星腦AstraBrain。
其中,AstraBrain WAM是機器人的通用「大腦」,負責感知和理解物理世界、推演環境變化,並據此進行任務決策與行動規劃。與主要負責理解和預測世界狀態的傳統世界模型不同,WAM(世界動作模型)進一步將「動作」納入模型本身。它不僅要回答「這個世界接下來會發生什麼」,還要進一步回答「機器人應該如何行動,以及採取什麼動作能夠讓世界朝目標狀態變化」。
因此,語言、視覺、視頻、機器人動作等不同模態、不同來源的數據,都可以被納入同一個模型體系,讓模型同時學習對物理世界的理解、預測與行動能力。換句話說,機器人不再只是擁有一個「看懂世界」的模型,而是開始擁有一個能夠理解世界、預測世界,並在世界中採取行動的通用大腦。
但對於機器人而言,有了「大腦」仍然不夠。真正進入物理世界後,它還必須擁有足夠強的身體能力,才能把高層的認知和決策變成真實、連續、穩定的運動。銀河通用因此進一步在「小腦」側探索通用的全身運動能力,通過大規模人類動作數據訓練AstraBrain-WBC,使機器人學習的重點從「記住一個個動作」,轉向學習更底層、更通用的運動規律。這樣,當面對訓練數據中沒有直接出現過的新動作時,機器人也有機會根據新的運動要求生成相應的全身動作,而不是依賴工程師為每一個動作單獨編程。
這意味着,具身智能正在發生的變化,已經不只是「機器人會不會做更多事情」,而是機器人的能力生成方式正在改變:過去需要人類提前把任務、動作乃至執行路徑逐一教給機器人;而新的技術範式正在嘗試讓機器人自己理解世界、預測變化、形成行動方案,並利用已有的身體能力去完成此前沒有被逐項教授過的任務。
一顆「大腦」,開始進入不同的身體
然而,只讓一台機器人變得更聰明,價值仍然有限。現實世界需要的機器人,並不會只有一種形態。
藥房貨架之間的通道有限,機器人需要穩定、高頻地取放藥盒;零售門店需要長時間移動和操作;進入工廠後,負載、可靠性又變成更重要的指標;到了運動、科研或者特種場景,雙足機器人的全身運動能力纔會被進一步放大。
如果每進入一個新場景,就重新設計一種機器人、重新訓練一套模型,具身智能很難真正形成規模化能力。基於此,銀河通用選擇了「一腦多能」的技術路徑。目前,銀河星仔、G1和S1分別對應雙足、輪式、重載等不同機器人形態,但背後連接的是同一套銀河星腦。
不同業務對運動方式、負載能力和作業空間有不同要求,因此需要不同的本體構型;但機器人的感知、理解、規劃和操作能力,則可以由同一套具身智能模型提供。目標不是讓不同機器人做完全相同的事情,而是讓一種本體上已經驗證的能力,有機會遷移到其他本體上,從而降低每換一個身體就重新開發一套智能的成本。
因此,銀河通用的多本體並不是簡單的產品分工,而是在探索同一套智能如何適配不同的「身體」。G1可以進入藥房、零售和家庭等場景,S1可以承擔工業和重載作業,銀河星仔則具備更強的動態運動能力;它們的身體各不相同,但背後的智能底座保持一致。更進一步,在一次跨本體演示中,銀河星仔通過自然語言發出任務指令,讓零售場景中的G1完成飲料取送。機器人可以因為業務需求擁有不同的身體,但不需要因此重新擁有一套完全不同的「大腦」。
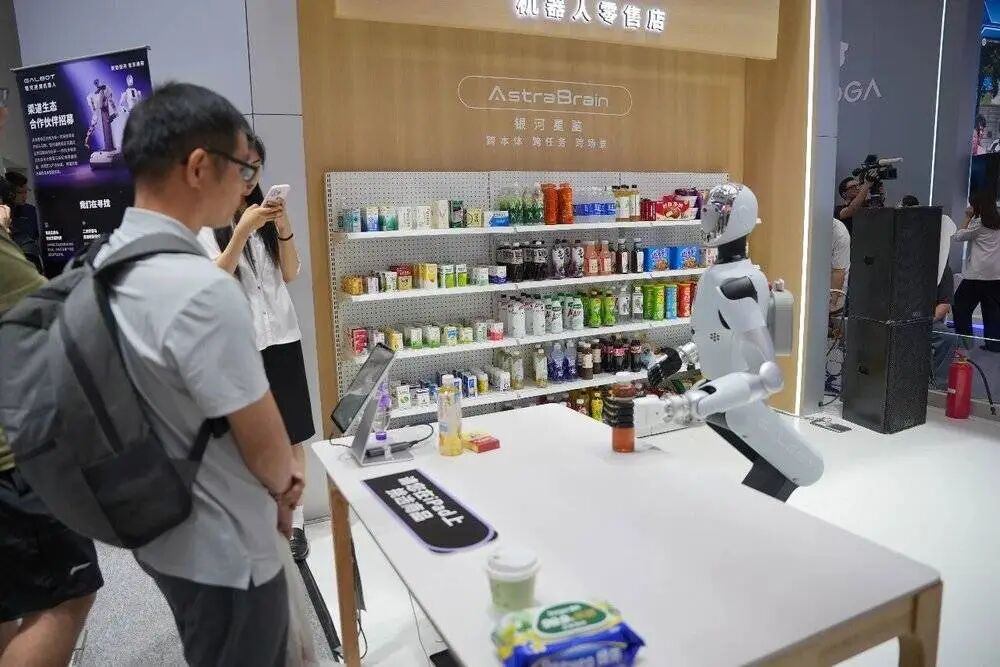
這讓「一腦多能」不再只是一個架構概念。在製造業,它們進入寧德時代、博世西門子、豐田、上汽、北汽等企業,承擔上下料、分揀、物料搬運、線纜連接、打螺絲等任務;在文旅消費領域,則已經進入全國約50座城市,落地近200個銀河太空艙,並在近百個智慧藥房實現全自主服務,累計連續運營時間超過兩年。
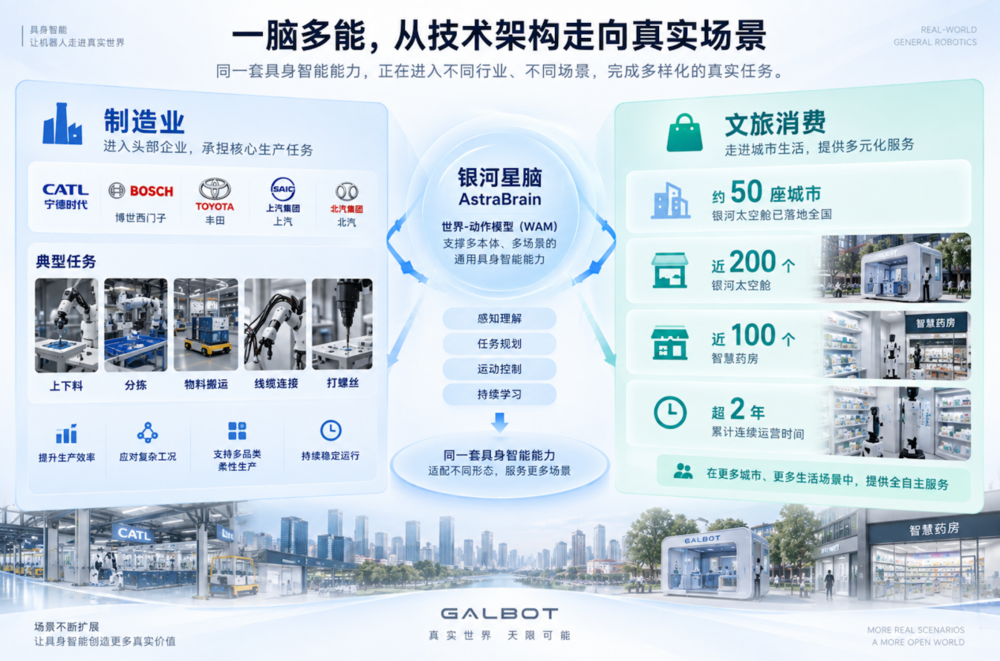
這些數字的重要性,不只是證明機器人「賣出去了」。對具身智能而言,部署本身也是訓練的一部分。實驗室可以設計一百種抓取方式,真實藥房卻可能出現第一百零一種:藥盒被擠歪了、包裝反光了、位置發生變化了,甚至上一個顧客啱啱碰過貨架。機器人每進入一個真實場景,都會遇到訓練階段沒有覆蓋的問題。這些問題恰恰構成了新的數據。
8月底舉辦的世界機器人運動會,則把這種能力放到了一個更集中、更復雜的環境裏。在家庭、餐飲、商超三個賽項中,銀河通用選擇了全自主模式,由銀河星腦完成自主決策和執行,最終取得三個賽項冠軍,其中商超賽項包攬金銀銅牌。
比賽和商業場景當然不是一回事。但它們在考驗機器人時有一個共同點:任務不再只是「把提前練好的動作表演出來」。機器人需要看見環境、理解任務、決定下一步做什麼,再讓身體把這個決定執行出來。真正開始發生變化的,是機器人面對陌生問題的方式。
「工作經驗」如何變成下一台機器人的能力?
當機器人真正開始規模化工作,另一個更現實的問題就會浮出水面:一台機器人今天在真實世界裏踩過的坑,明天能不能讓另一台機器人不再踩一遍?這背後指向的,是具身智能的數據閉環。
語言模型可以從互聯網獲得海量文本和圖像,但物理世界並不存在一個現成的「機器人互聯網」。機器人真正需要的數據,往往產生於行動本身:看到了什麼、手臂如何運動、什麼時候發生接觸、用了多大的力、任務在哪一步失敗,以及如何調整才能繼續完成。
這些數據記錄的不是世界「長什麼樣」,而是機器人如何與世界發生交互。銀河通用正在通過AstraData積累這樣的「工作經驗」。目前,其已經沉澱超過50萬小時真機迴流數據和超過100萬小時人類動作數據。前者來自機器人在真實環境中的運行與交互,後者則提供更廣泛的人類動作先驗。兩類數據共同進入模型訓練,推動AstraBrain持續迭代,並進一步應用到新的機器人和場景中。
於是,一條閉環開始形成:真實場景 → 數據迴流 → 篩選與標註 → 模型訓練 → 驗證更新 → 再部署。其中真正有價值的,往往不是重複一千次的成功,而是模型此前沒有見過的問題。一個被擠歪的藥盒、一次抓取失敗、一場突然發生的人機交互,都可能暴露模型能力的邊界。經過篩選和訓練,這些長尾問題又可能成為下一版模型的新能力。
但機器人的「經驗共享」,也沒有想象中簡單。視覺特徵、任務語義、空間關係、操作策略等高層信息,相對容易在不同機器人之間複用;越接近執行層,數據越與具體本體綁定。不同機器人的關節結構、自由度、負載和末端執行器不同,同樣是「拿起箱子」,最終對應的動作軌跡和力控方式可能完全不同。
因此,「一腦多能」的難點並不是簡單把同一個模型裝進不同身體,而是讓可以共享的經驗跨越本體,同時讓不同身體找到自己的執行方式。數據飛輪的另一面,則是成本。真機數據首先意味着機器人要真正進入場景,之後還有存儲、篩選、清洗、標註和訓練成本。規模越大,另一些問題也越突出:工廠數據可能涉及商業機密,家庭數據涉及隱私,客戶是否願意讓數據離開現場,不同場景的數據如何脫敏、合規使用,模型更新之後又如何保證安全。
具身智能的數據競爭並不只是「誰的數據多」,而是誰能以可承受的成本,持續獲得高質量數據,並安全地轉化成模型能力。這也是GPT-6 Astra值得中國具身智能行業關注的另一層原因。
當擁有算力、資本和基礎模型優勢的玩家開始補機器人數據,具身智能的競爭也就從單純的模型競爭,進一步變成了數據基礎設施的競爭。這也是AstraData的意義所在。超過50萬小時真機數據和超過100萬小時人類動作數據,如果能夠持續進入「部署—數據—模型—再部署」的循環,它們就不再是一份靜態數據資產,而是在不斷轉化為新的機器人能力。
結語
22年前,《機械公敵》直接給了桑尼一個近乎完整的答案:它能夠理解世界,也能夠在世界中行動。現實中的機器人沒有這樣的捷徑。
從人類動作數據,到機器人真正進入藥房、商店和工廠;從一次失敗的抓取,到數據迴流、模型更新,再到下一台機器人不再犯同樣的錯誤,具身智能真正需要建立的,是一條連接物理世界與模型的通路。
GPT-6 Astra的出現,讓這場競爭突然有了更強的緊迫感。通用AI公司正在向物理世界延伸,中國具身智能公司也已經進入規模部署和數據迴流階段。接下來的差距,可能不只來自某一次模型升級,而取決於誰能更快建立起「部署—數據—模型—再部署」的循環。
機器人真正稀缺的,或許從來不是一次漂亮的演示。而是它在真實世界裏幹過的每一份「工作」,最終都能成為下一次行動的經驗。
特別策劃