讓計算機在智力測驗和下棋上達到成人水平相對容易,讓它擁有一歲孩子的感知與行動能力,卻難得多。
這是1988年機器人學家漢斯·莫拉維克作出的經典論斷。事實也的確如此,時隔近半個世紀後,大模型已經能寫代碼、解奧數題,莫拉維克悖論依舊橫在機器人面前。
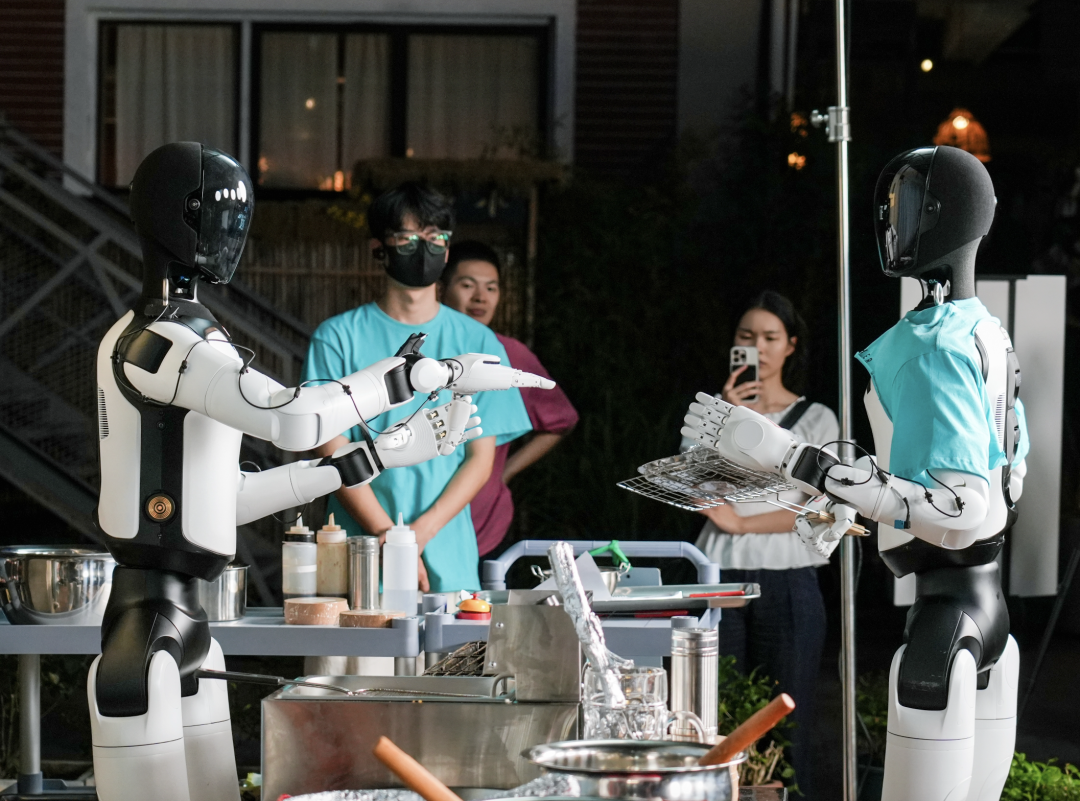
人類習以為常的生活,仍有大量機器難以獨立完成的工作。9月16日,樂享科技把這道題搬到了一個戶外燒烤攤,接受現場「拷打」。
不同品牌的具身機器人搭載了以太大模型,六位嘉賓兩兩一組陸續上台與不同個性的機器人互動,可以臨時改變需求、挪動物品,打亂原有安排,在線上超550萬觀衆及現場超近30位行業媒體的見證下,機器人從點單、任務規劃、燒烤到上菜,全程自主完成。
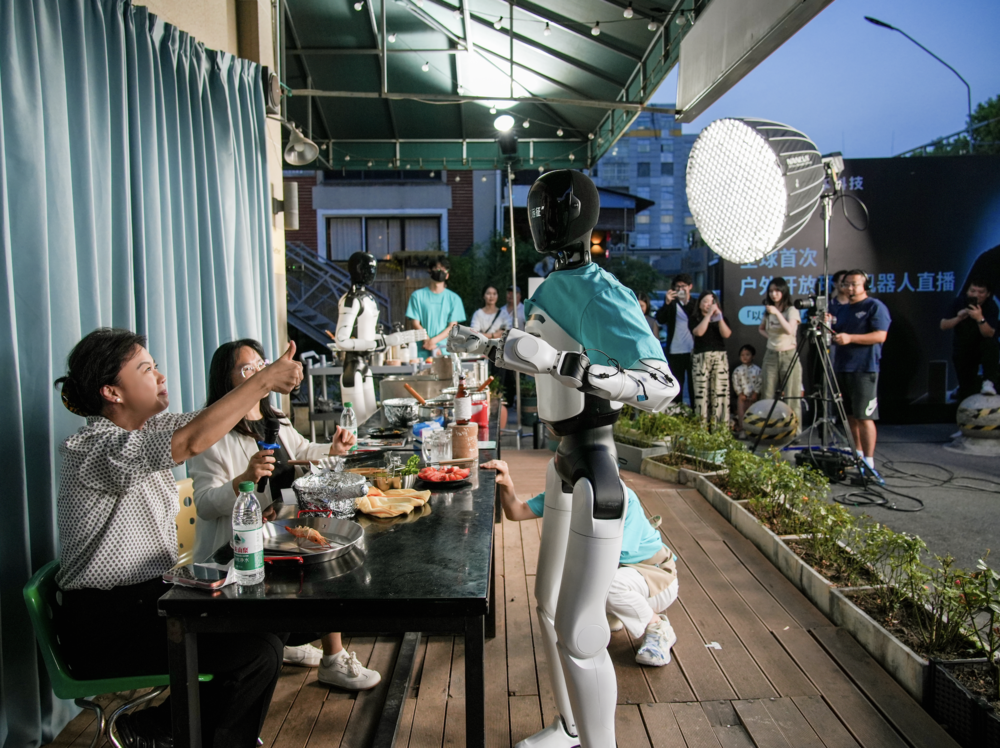
時間點,很耐人尋味。8月底,以太大模型已經在室內Demo中展示跨本體協作、自主尋找和使用工具、被打斷後繼續前序任務等能力,在業內引發熱議。而在幾天前,OpenAI首席科學家Jakub Pachocki在長文《An Alien Mind》裏描繪的一種能自我改進、越來越難被人類完全理解的機器心智,恰恰與樂享科技此前公開的技術理念和落地模型高度吻合。
理論推演與現場實踐之間,還有多遠?這場直播,就是樂享給出的回答。
一頓燒烤:從Demo到現實要走多遠
讓具身機器人接管一個燒烤攤,需要交出去的判斷,比動作多得多。
燒烤對攤主來說近乎本能。嘴上應着客人,餘光掃一眼炭火,肉邊一卷就順手挪到爐邊。換成具身機器人,從接單到上菜,每一步都可能出現計劃之外的變化。但無論是面對場景的變化還是人物的變化,以太大模型在本場直播中的表現都堪稱精彩。
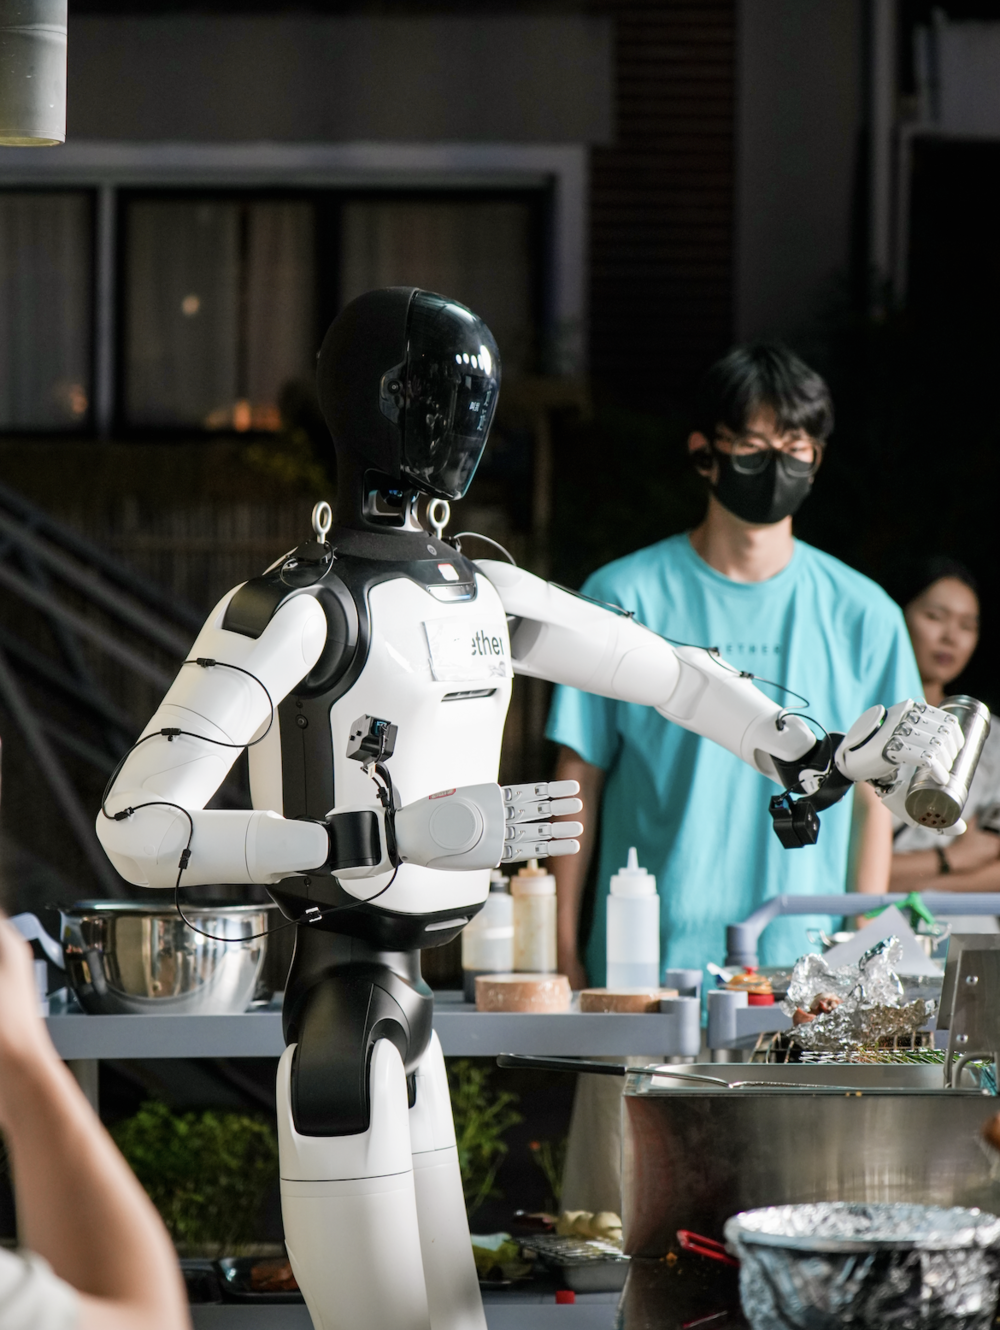
突然改變位置的盤子、從未見過的調料瓶,這場直播一開始便給以太大模型出了走進真實世界需要面對的第一道難題:面對非標準、不可預測的物理環境,一個具備連續任務、自我進化的具身大模型應當給出怎樣的反饋?
在直播中可以看到,搭載以太大模型的機器人不僅在判斷盤子位置之後及時改變了伸手的方向和抓取的姿態,面對從未見過的調料瓶,它更能在兩次抓取的嘗試中及時從物理世界中總結經驗,調整動作,最終通過自主學習完成指定動作。
人的變化同樣是一大考驗。
顧客渴了需要馬上喝水,機器人暫時放下手頭上菜的工作,從桌上拿起一瓶水遞給對方,隨後繼續完成手上的工作。面對客人突然的誇獎,以太大模型也能讓機器人回饋比心讚好的肢體動作,帶去超高的情緒價值。
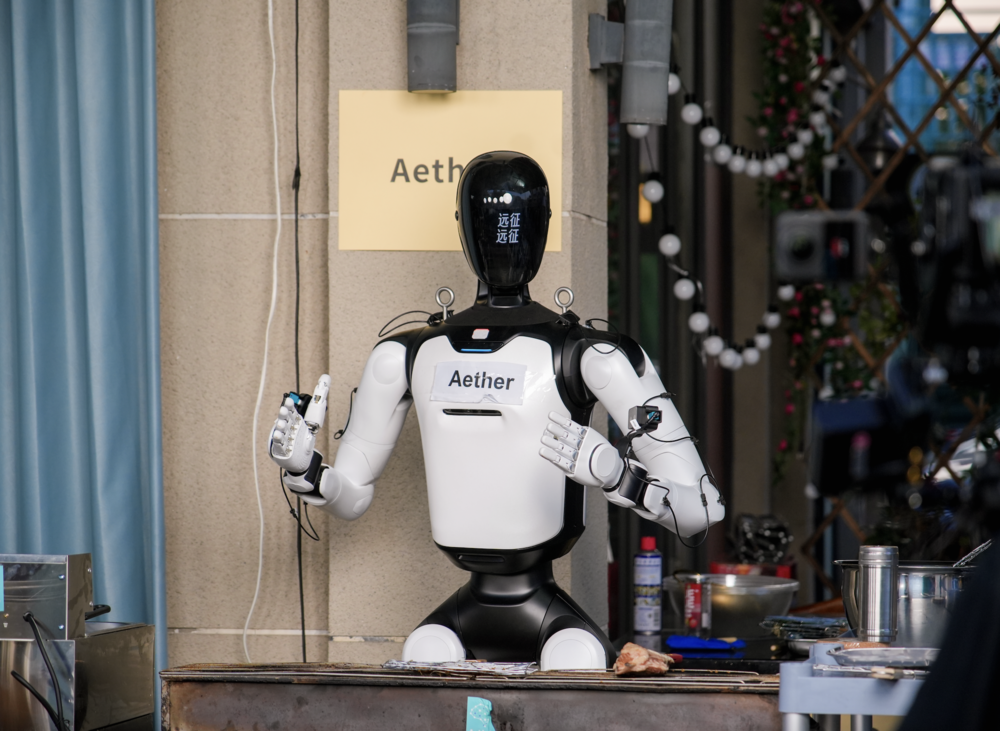
在這場長達一個多小時的直播當中,無論是面對周圍環境的突然變化,還是顧客不斷新增的訴求,以太大模型很好地跨本體協調了兩台機器人的配合與交接,也在長時序任務的斷點續做能力上,交出來了一份令人驚喜的答卷。
行業裏幾條主流技術路線,在這張烤架前各有長短。視覺-語言-動作模型(VLA)看到畫面、聽到指令就直接給出動作,反應快。可它的「會做」建立在「見過」之上,陌生的火候和肉形很容易讓它失手,長流程裏的小偏差還會一路累積。
世界動作模型(WAM)先在內部預演接下來的畫面,再倒推動作,想得更遠,計算量卻很大,難以跟上烤架前的瞬息變化。
兩條路線都擅長回答「下一步做什麼」,卻缺少一套自己發現問題並及時調整規劃的辦法。這個缺口在演示視頻裏很難被看見,鏡頭往往只留下成功的那一次。到了開放環境,它會一再暴露出來。
行業的慣常解法是繼續堆數據,效果卻有限。開放環境裏,沒見過的情況纔是常態。燒烤攤上的變量組合近乎無窮,靠數據窮舉,這筆賬算不過來。數據能讓機器人見得更多,卻教不會它在沒見過的時候該怎麼辦。
樂享的Physical AI走的是另一條路。它的核心是一套能量驅動的架構,讓機器人從感知到動作控制,再到物理反饋,始終處在一個連續的閉環裏。
樂享用一小時的公開直播,把這個過程直接呈現出來。觀衆可以沿着一張訂單,看機器人怎樣處理變化,花了多少時間,是否需要幫助,直到食物端上桌。
這種考法對樂享自己並不友好。實驗室可以挑出最好的一次結果,直播裏出的每個錯都會被看見。敢這樣安排,說明樂享想讓外界看的,已經超出了機器人能不能把活幹完,它更想展示機器人在複雜多變的環境中自行發現問題,重新規劃,並繼續執行的過程。
OpenAI還在推演的心智,被「放上」了烤架
樂享能接下這道題,源於它一開始問的就是另一個問題。
行業主流的思路,是把大模型在數字世界裏的能力塞進機器人裏。先讓它聽懂、看懂,再把理解翻譯成動作。模型要回答的,是「下一步做什麼」。樂享更在意的,是讓機器人,在真實世界裏,能很正的「做個人」
去年3月,樂享組建了一支約20人的模型團隊,回頭去看生物是怎麼學會行動的。人類有語言之前,早已能躲避危險、控制身體。更早的單細胞生物既沒有視覺,也沒有語言,行動照樣在發生,驅動它的是能量。
樂享由此得出一個判斷:語言未必是機器人學會動作的關鍵。在語言模型最強勢的年份,這個判斷顯得有些逆流而上。它動的是整個系統的地基。今天多數具身方案仍以語言模型為底座,換掉這一層,意味着從感知到控制都要重新設計。
而以太大模型此後的設計,都是從這個判斷出發的。
樂享有句頗具挑釁意味的口號:「機器人的ChatGPT時刻,就是要放棄ChatGPT。」這句話背後的思路,是回退「語言」的價值。常見的具身智能模型思路,還是把用戶的指令交給語言模型拆成文字步驟,再翻譯成關節動作。
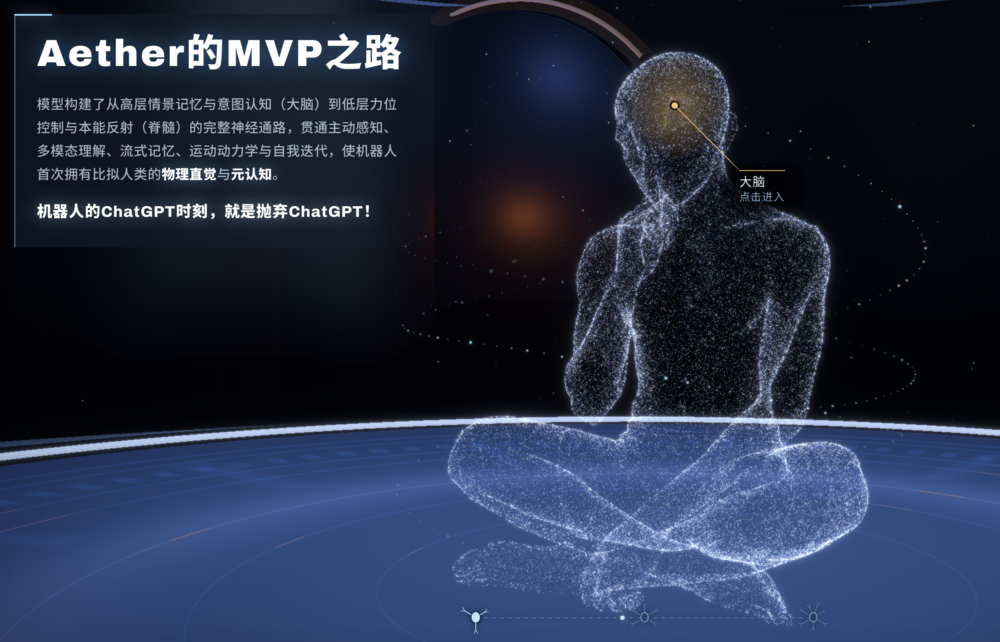
然而,文字描述不了火候,也描述不了一塊肉在夾子裏滑動的手感,每翻譯一次,關於物理世界的信息就丟掉一些。以太大模型的路徑,是讓語言只停留在人機交互的入口,讓視覺和力覺這些信號直接進入模型,動作由模型原生生成。
模型的決策方式隨之改變。以太大模型不直接預測下一個動作。任務進行到哪一步,動作是否合乎物理規律,和此前的記憶是否一致,眼下有幾分把握,這些考量被折算進同一套「能量」計算。機器人每一步都朝能量更低的方向走,也就離目標更近一點。
對比來說,VLA在找「最像訓練數據的動作」,WAM在找「最相關的畫面」,以太大模型在找「最接近目標的動作」。三者的差別,在一切順利時很難看出來。計劃一旦被打亂,只會比對「像不像」的模型容易無所適從;而始終記着目標的模型,還留有重新找路的餘地。
支撐這套決策的,是一條從大腦通到脊髓的神經通路。樂享參照人腦分區來組織模型,上層負責判斷和規劃,中間管記憶與感知,最靠近硬件的脊髓層處理力控和本能反射。信息在模型裏雙向流動,上層的判斷指揮身體,身體碰到的阻力和偏差也會反過來改變判斷。
放到烤架前,以太大模型的差異性,的確有了很好的表現。
直播裏,訂單被改變、流程被打斷時,依舊能繼續。以太大模型只記住影響決策的東西。它不會把每一幀畫面都存下來,任務目標被保存為一種穩定的內部狀態。機器人被臨時需求叫走,忙完之後,注意力仍會回到那串該翻面的肉上。
這種接着乾的能力,在8月那段從樂享提前流出、行業內廣泛流傳的「神祕模型」室內Demo裏已經露過面。具身機器人正在收拾房間,鬧鐘突然響了。它先去把鬧鐘處理掉,再回到剛纔停下的地方接着收拾。
動作本身並不複雜,難在打斷後依舊能繼續,並且判斷如何繼續。
這是元認知在起作用。以太大模型會評估自己對眼前情況掌握了多少,如果把握不足,就會多調用一些計算,來補齊信息。比如拿不準燒烤是不是熟了,它會挪一步換個角度,找出被遮擋的線索,或者用夾取時的手感補上看不清的顏色。而後者能夠被感知到,是因為內置的世界模型理解重力和摩擦這些物理約束。
「知道」自己不知道,是這條路徑裏,最接近人的地方。多數模型在信息不足時照樣輸出動作,以太大模型會先把信息補齊,再作出判斷。
這次「烤場」上,不只一家企業的具身機器人在工作。一個大腦適配如此多的身體,靠的是模型裏的「自我模型」。它清楚這具身體有多高,夠得到哪裏,剛纔做到了哪一步,幾台機器人因此能各自判斷邊界,自主分工,在對方力所不及時補位。
這種跨本體常被當作兼容性問題來討論,而在以太大模型中,它更接近一種自我認知。模型得先知道自己裝在哪具身體裏,分工纔有依據。
值得關注的是,面對同樣的環境,具身機器人每次的推理和做法都不太一樣,但每次都能把任務完成,而每次執行的結果都會迴流並更新模型,實現持續成長的可能。對一個能從現場學習的模型來說,每一張被改掉的訂單都在給它上課,真實世界裏那些瑣碎的勞動,反倒成了它長智力的地方。
整體來看,OpenAI幾天前提出的異星心智和樂享的思路和模型放在一起,重合之處相當明顯。
《An Alien Mind》引發震動,在於它把討論推到了模型規模之外。Pachocki認為,AI是「生長」出來的系統,需要藉助類似神經科學的方法去理解;遞歸式自我提升,也就是讓模型主導自身的發展,被他視為保持前沿的唯一途徑。
這些方向,樂享此前都已公開提出過。7月底上線的以太官網,寫明瞭由Evolution Manager驅動的分層自進化,按人腦結構搭建模型,並把目標對齊和價值對齊分開處理。
一家AI巨頭與一家中國具身公司,在相近的時間得出了相近的判斷。這至少說明,模型如何自己成長,正在成為下一代智能繞不開的問題。
而現在,有意思的地方出現了。OpenAI還在推演這種心智的時候,樂享將它放到了烤架前,現場考驗了一個小時。
燒烤攤之外的想象
燒烤攤只是一個場景,跨本體通用的大腦,纔是樂享瞄準的產品位置。通用意味着它既要能換場景,也要能換身體。
從家務到餐飲,再到商超服務,任務各不相同,理解需求和跟蹤環境的底層能力卻是相通的。
能力可以複製,新的場景就有機會遷移。從商業化角度來看,這種遷移能力直接關係到部署成本。若是每進入一個新場景都要重新採集數據、編排流程,機器人的生意就容易做成逐個項目的交付。
而通用模型的商業價值,很大程度上取決於這筆成本能降下來多少。出人意料的是,以太大模型只有4B參數。據樂享披露,其初始思路是讓模型掌握物理規律,用推理應對沒見過的情況。整體訓練用了約200小時人類視頻,真機訓練數據為零。
這條路徑一旦走通,具身智能的成本結構會被改寫,機器人不必把世界見過一遍才能幹活。
同一模型能夠驅動不同本體,意味着樂享的潛在市場可以延伸到多個硬件廠商。機器人產業有望由此形成更細的分工,身體各有所長,認知、協作與學習能力可以共享。
在這樣的分工裏,「智能」這一層的分量會越來越重。機器人的身體會越來越多樣,能跨越這些身體持續積累經驗的大腦,最難被替代。
「機器人世界的超級智能」,是樂享給自己定下的目標。跨本體通用、自主思考、自主進化、持續學習,構成了它對這顆大腦的設想。從Demo走向戶外長時驗證,這條路線已經有了可觀察的實機樣本。而這場直播的價值在於,它把一個宏大的說法,換成了外界可以當場覈對的表現。
理論與實踐的距離,終究要靠一次次進入現實來縮短。
特別策劃