衡宇 發自 凹非寺
量子位 | 公衆號 QbitAI
一篇技術報告中居然出現了兩個看起來風馬牛不相及的研究對象,跟着AI真是見世面。
一個是患者來源的類器官,另一個則跨越到了宏觀宇宙……
先說前者。研究者利用模型學到的內部因子,提出了細胞因子聯合抗體阻斷的干預方案,並經細胞系、類器官、小鼠實驗層層驗證。
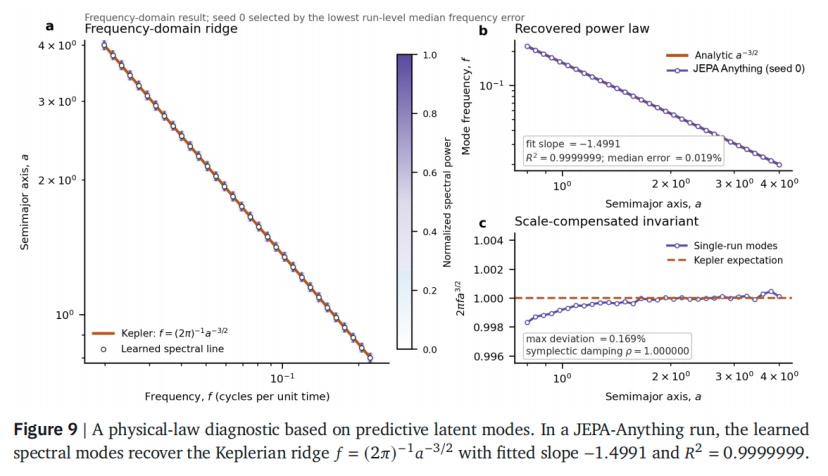
至於後者,研究者把模擬的行星位置和速度軌跡餵給模型,不告訴它開普勒定律。
等它學完後分析其內部的預測模式,提取出的「軌道頻率-半長軸」關係擬合斜率達-1.4991(開普勒第三定律理論值為-1.5),且R²=0.99999999。
腫瘤研究和行星軌道計算兩個八竿子打不着的領域,居然能用同一種預測學習方法來搞定。
大千世界千差萬別,天氣、分子、細胞、病人、機器人乃至行星,各自遵循完全不同的規律。
但AI在理解它們「如何變化」時,有沒有可能共享一套更底層的方法?
最近,PhAI Labs聯合牛津、斯坦福、普林斯頓、港中文等高校團隊最新發布的JEPA-Anything,就在嘗試回答這個問題。
論文顯示,JEPA-Anything是一個面向不同「世界」學習預測模型的跨領域框架。
每個領域保留自己的觀測形式、context-target構造和編碼器,但共享後面的預測核心以及一套統一的latent world-state interface。
其中涉及一個叫做OPF(Orthogonal Predictive Factorization,正交預測分解)的關鍵機制。
可以先簡單理解為:
別把世間各種各樣的變化,全都堆在一塊去學習建模。
給世界建模,一條預測通路可能不夠
首先來釐清一個概念,在JEPA-Anything這項研究中,「世界模型」究竟意味着什麼?
JEPA-Anything論文給出的定義兼具寬泛度與操作性。
論文寫道,只要模型能根據現有信息(Context)建立內部狀態,並以此預測同一系統中的另一個狀態,均可歸入隱空間世界模型(Latent World Model)的範疇。
這裏的「另一個狀態」,既可以是時間上的未來,也可以是空間上的隱藏區域、不同視角,甚至是施加某種干預後的結果。
順着這一思路,業界在過去幾年間已經發展出了日趨成熟的技術路徑。
例如,DreamerV3強調先構建環境模型,再在模型內部「構想」行動後果;V-JEPA 2則將視頻表徵學習與機器人控制結合,讓機械臂在規劃動作前,先預測不同行為帶來的物理反饋。
而JEPA——Joint-Embedding Predictive Architecture,聯合嵌入預測架構——是其中頗有代表性的一條路線。
相比直接在原始空間重建目標狀態,JEPA選擇在表徵空間做預測,不必還原每一個像素或細節。
它會將觀測信息先編碼為隱空間中的內部表徵,再在表徵空間內完成預測。
這種設計讓模型把更多表徵能力留給具有預測價值的結構,減少紋理、噪聲等原始空間細節的干擾。
不過,標準JEPA通常讓信息全部匯入同一個target embedding,走同一條預測路徑。
但現實世界的變化往往不是單線程的。
舉例來說,分子的整體平移往往伴隨着內部原子的微觀振動;宏觀氣象系統的緩慢演變中,夾雜着劇烈的局部擾動;生物系統則更為複雜,多尺度、多通路的變化時刻在同步發生。
當不同尺度、不同實體、不同難度的信號強行擠在一起時,那些更容易預測、變化更顯著的信號,可能優先佔據更多預測容量。
相比之下,那些相對微弱卻同樣關鍵的信息,要麼在梯度衝突中被抵消,要麼被強信號徹底掩蓋。
研究人員將其歸結為一個「預測容量如何分配」的問題,同時給出了新的解決思路。
既然擁擠會導致擠壓,那就進行空間解耦。
於是就有了JEPA-Anything。
其核心機制OPF(正交預測分解)將原本完整的目標狀態切割為多個彼此互補的子空間,交由不同的預測分支獨立處理,最終再拼回完整的世界狀態。
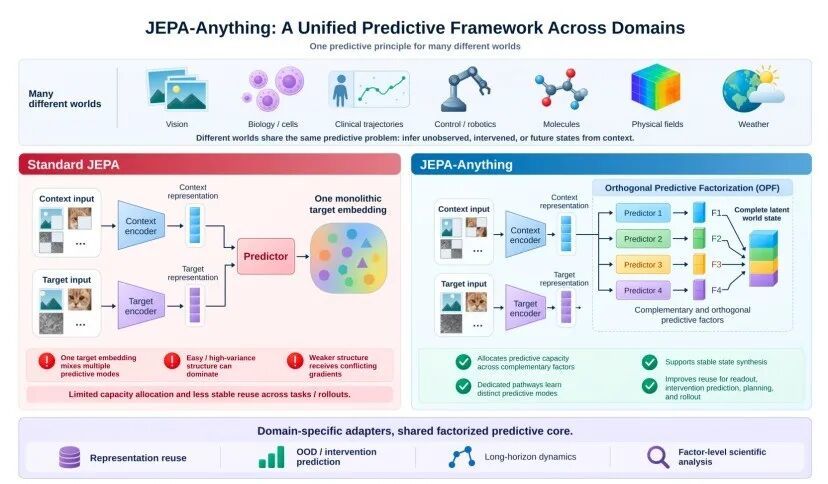
為了防止多分支演變為「多套人馬學同一件事」的冗餘狀態,OPF引入正交約束,讓不同factor儘量佔據互不重疊的預測方向,減少多個分支重複學習同一類信息;同時通過因子活性約束和編碼器方差約束,避免部分factor失活,並降低表示坍縮風險。
值得注意的是,這些factor並沒有被預先規定「你負責速度」「你負責溫度」「你負責某條生物通路」。
它們學什麼由數據中的可預測結構決定。
訓練完成後,這些factor也因此留下了一個可供後續分析的內部接口。
同一預測核心,跨七類系統驗證
方法論說得再漂亮,最終仍需經受跨領域泛化的檢驗。
這就不得不提到JEPA-Anything實驗設計的獨到之處。
它並未侷限於視頻表徵或機器人控制等傳統領域,轉而將同一套預測核心(Predictive Core)直接置於視覺、生物、臨床、控制、分子、物理場和天氣七類截然不同的系統中進行驗證。
所謂「Anything」,並非指強行將所有領域的數據打散重構為同一種輸入格式,圖像、單細胞序列、分子結構乃至氣象數據,依然保留各自最契合的編碼器與數據形態。
它統一的是這樣一套底層規則:
當數據被轉換為隱空間表徵之後,預測部分應當如何搭建模型、如何完成學習。
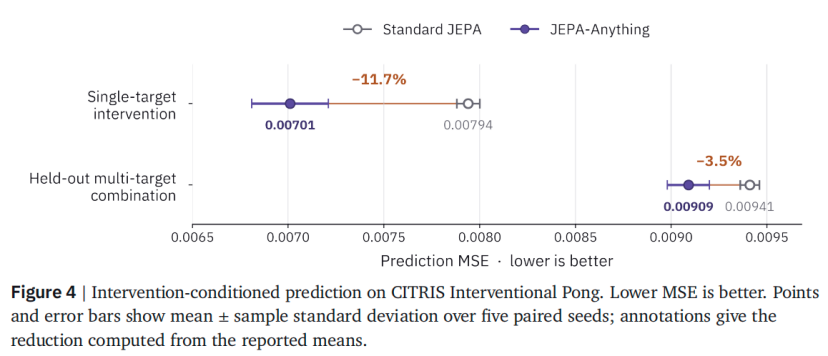
論文先在一個基於簡化Pong構造的受控動態環境CITRIS Interventional Pong裏做實驗,以驗證模型能否將複合變化「拆解學習、再行組合」。
在訓練階段,模型僅接收過單一因子的變化數據;測試階段則需要面對此前從未出現過的多因子組合干預。
如果模型僅僅死板地記錄了訓練集中的完整模式,面對全新組合必然失效;如果模型學到的是不同變化之間可複用的狀態變化規律,就更有機會在未見組合裏重新組合它們。
實驗結果表明,在分佈內的單項干預中,JEPA-Anything相較標準JEPA降低了約11.7%的預測誤差;而在未見過的多因子組合干預中,均方誤差(MSE)同樣下降了約3.5%,且在五組配對訓練seed中全部改善。
隨後,驗證走向了更復雜的真實系統。
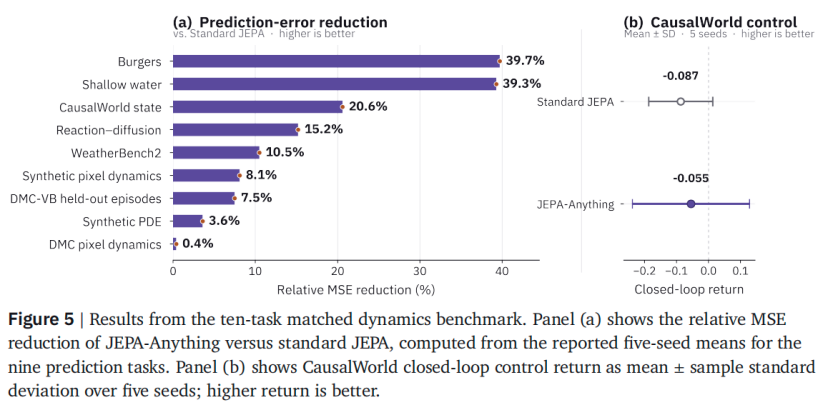
論文構建了一套嚴格對齊的動力學基準(Matched Dynamics Benchmark),在十項任務中確保標準JEPA與JEPA-Anything使用完全相同的訓練數據、編碼器、狀態轉移骨幹網絡、計算預算及評估切分。
在其中九項預測任務中,JEPA-Anything的性能指標均有所提升。
比如PDEBench裏的Burgers方程,MSE下降39.7%;淺水方程下降39.3%;WeatherBench 2下降10.5%。
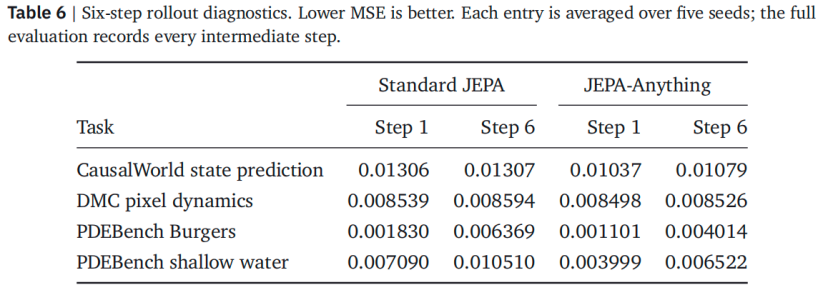
論文還專門做了多步rollout,讓每一次預測繼續成為下一次預測的輸入,以觀察誤差不斷傳遞之後會發生什麼。
分子系統則把時間線拉得更長。
在液態水、α-石英、對乙酰氨基酚和苯四種體系中,模型需要持續預測未來的原子位置和速度,並把自己的輸出不斷喂回去。
最終,無論是一步預測的MAE,還是100步自由rollout後的最終位置RMSD,JEPA-Anything在四種分子系統中都拿到了最低誤差。
不過值得注意的是,實驗數據並未呈現出「單一機制全面碾壓」的理想化曲線。
在連續控制測試中,JEPA-Anything並非每項任務都更好:在Walker2d和HalfCheetah上,它的平均得分高於標準JEPA;但在Hopper上,標準JEPA表現更好。
連續預測的距離越遠,誤差仍會不斷累積。
在額外的Burgers測試中,當預測長度從20步增加到50步時,JEPA-Anything雖然仍然領先,但優勢已明顯縮小。
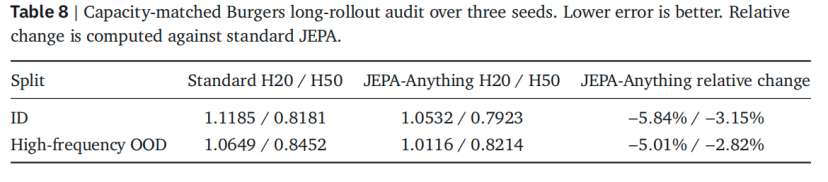
因此,這篇報告驗證的是「共同預測原則存在跨領域適用性」,而非「已經實現一個統一所有領域的世界模型」。
但這些結果至少表明,這套預測原則具備跨領域複用的潛力。
JEPA-Anything學到的結構,能否經得起外部檢驗?
前面的實驗主要回答預測和狀態表示是否有效。到了第三組實驗,論文繼續追問一個更進一步的問題:
模型隱空間中所形成的因子(factor),究竟是否具備科學探索價值?
於是,就有了本文開頭那兩個畫風迥異、卻又遙相呼應的研究案例。
案例一:從內部因子走向可驗證的候選干預
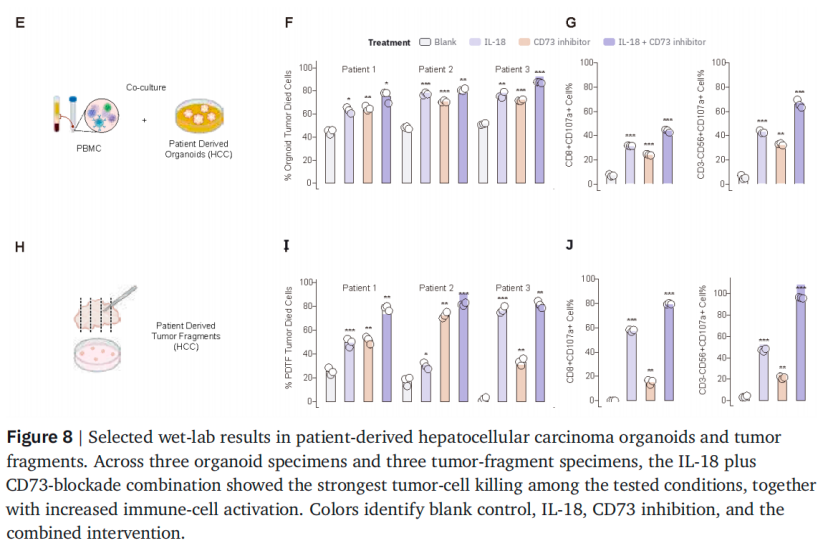
在肝癌研究中,研究人員並未將JEPA-Anything簡單視作一個「黑盒預測器」,而是對其內部形成的正交因子座標(Orthogonal Factor Coordinates)展開了領域分析,並從中篩出一個候選組合:IL-18聯合NT5E/CD73阻斷。
研究團隊把它推進到Huh7-PBMC共培養體系,再到患者來源的肝細胞癌類器官和腫瘤組織碎片,之後還加入免疫健全小鼠驗證。
實驗數據表明,在3份患者類器官與3份腫瘤組織碎片中,IL-18與CD73阻斷劑的組合均展現出最強的腫瘤細胞殺傷力,並伴隨着顯著增強的免疫細胞激活。
這意味着模型內部的Latent Factor不再只負責讓預測數字「變好看」。
它開始成為研究者分析系統狀態、提出可實驗檢驗的候選假設的一種接口,由此形成「模型內部結構→領域分析→候選干預→實驗驗證」的鏈條。
案例二:從隱模式走向已知物理規律的「對賬」
行星軌道案例反過來拿人類早已知道的開普勒第三定律,去檢驗模型內部學到的東西有沒有物理意義。
研究者僅向模型輸入模擬產生的行星位置與速度軌跡,未附帶任何先驗公式。
訓練完成後,研究人員對模型的隱模式(Latent Modes)進行頻譜分析,並將提取出的頻率與軌道半長軸配對。
結果顯示,即使沒有人為提前設定公式,研究者還是從模型學到的latent modes中提取出了與這套變量關係高度一致的尺度規律——擬合得到斜率‑1.4991,和理論值‑1.5高度接近,誤差極小。
一個案例從內部因子出發,走向溼實驗;另一個把內部模式拿出來,與已有物理規律對賬。
兩者從不同方向為「模型學到的內部結構可以成為科學分析接口」提供了案例證據。
研究者不一定只能在終點看一個預測數字,還可以繼續向裏追問,它到底捕捉到了哪些變化?這些變化是否對應真實規律?能不能從中形成下一步值得驗證的東西?
這也恰好是JEPA-Anything在PhAI Labs整體戰略脈絡中的定位。
此前,PhAI Labs提出「科學發現大模型」(Discovery Foundation Models, DFM),旨在推動AI向開放式的科學探索邁進。
在DFM設想中,AI需要進一步參與識別未知、形成假設、設計干預,並根據外部證據持續修正的科學發現過程。
JEPA-Anything位於這套結構的世界模型層。
它試圖把科學trajectory和真實世界變化中可預測的部分,壓縮成可以更快速調用的預測能力,在耗時更長、成本更高的真實實驗之前,提供一層近似判斷。
至此再審視「從癌細胞到行星軌道」的跨度,其意義便不再停留在展示視覺反差或概念噱頭。
研究人員探索的是面對機制迥異的複雜系統,AI能否共享同一種學習「演化邏輯」的方法;以及當這些變化被編碼進內部狀態後,這些內部結構能否被研究者拿出來分析,並接受實驗結果與已知規律的檢驗。
這距離「AI理解萬物」當然還有相當距離。JEPA-Anything目前給出的更像是一種可能性:
世界模型內部學到的結構,除了服務預測,也可以被研究者繼續分析,並接受實驗和已知規律的檢驗。
換句話說,模型不只在預測一個世界,也開始把自己學到的「世界」暴露出來,供科學家繼續研究。