本文系基於公開資料撰寫,僅作為信息交流之用,不構成任何投資建議
1918年夏天,奧地利陸軍炮兵軍官路德維希·維特根斯坦(Ludwig Wittgenstein),在意大利前線的炮火間隙裏完成了一部不到三萬字的小書。手稿裝在揹包裏跟着他轉移陣地;當年11月,他在南蒂羅爾被意軍俘獲,關進卡西諾戰俘營——靠着日後挽救大蕭條於水火的英國經濟學家約翰·梅納德·凱恩斯的斡旋,他得以在營中通信,把手稿寄給羅素,並留下那句宣告:這些問題,已在一切本質方面獲得解決。
這本書就是《邏輯哲學論》。為它作導言的羅素,早在戰前就說過,這個學生是"我所見過的天才的最完美典範"。而維特根斯坦自己序言裏的口氣,一百年後讀來仍然燙手:
我因此相信,自己已在一切本質方面最終解決了這些問題。如果我沒有弄錯,這本書的價值之二,就在於它表明:當這些問題被解決之後,所完成的事情是多麼少。——維也納,1918
他真的說到做到。寫完這本書,他放棄了彼時歐洲最大的一筆私人繼承財產之一,跑到奧地利山村當了六年小學教師,然後做修道院園丁,再給姐姐設計了一棟至今被奉為現代主義經典的宅子。哲學已經終結了,一個體面的人應該去幹點別的。
十年之後,他改了主意。1929年1月,維特根斯坦重返劍橋。與他同乘一班火車的凱恩斯,當天給妻子莉迪婭寫了一張字條:
好了,上帝來了。我在5點15分的火車上碰見了他。他打算長住劍橋。我看疲憊將會是毀滅性的,但我不能讓他每天跟我說話超過兩三個小時。
劍橋完全明白自己迎來的是什麼。凱恩斯懶得用"天才"這種詞,他直接寫下:上帝來了。
本文的標題,就取自這張字條。因為一百年後,另一群人正在把這句玩笑逐字當真。只不過這一次,"上帝"不搭5點15分的火車,它在計算集群裏自進化。
《邏輯哲學論》問世一百多年後,舊金山,兩家實驗室每隔數月更迭一次旗艦模型,宣示着同一個信念:通用智能是一個工程問題,而且是一個即將被解決的問題。其中一家把自己的終極目標印在每一份招股材料上,另一家把"人類"(anthropos)這個詞做進了自己的名字。
本文即將闡釋的核心主旨是:Anthropic與OpenAI,這兩家公司的全部祕密,早已寫在了1921年出版的一本哲學小書裏。這不是危言聳聽,把《邏輯哲學論》的七組命題逐條展開,你會發現它是一份大模型的完整技術規格書——世界觀、學習原理、生成原理、架構定義、失敗模式(幻覺)、安全方案(對齊)、乃至終局警告,一條不缺。1918年那個炮兵軍官畫好的圖紙,2020年代被兩個組織不聲不響地執行着。
先給出對照表的骨架。正文將沿着大模型的技術棧自底向上推進——語料、嵌入、生成、預測、架構、縮放、對齊,七個關鍵詞逐一解碼;行至第七節,前六個將合龍為一個名字:智能湧現。
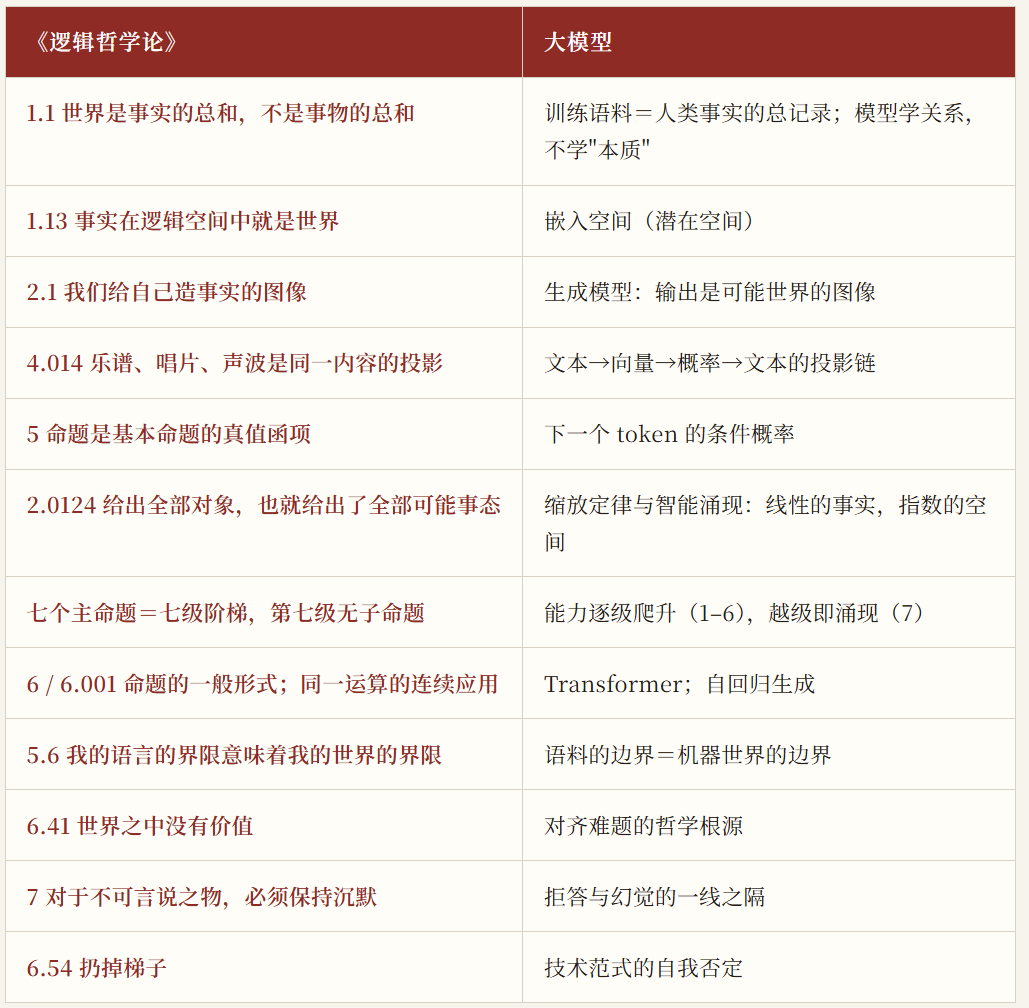
圖:《邏輯哲學論》× 大語言模型:十二組命題映射左邊是 1921 年的哲學,右邊是今天的技術。七級階梯:命題 1–6 逐級爬升,命題 7 無言而湧現。
看完這張表,你將發現一件更加讓人脊背發涼的事:這本書不僅解釋了大模型為什麼能成,還預言了它會在哪裏出事。因為它的作者本人,就是第一個"運行"了這套系統、然後被它反噬的人。
01
語料(Data):世界是事實的總和
"數據是新的石油"這句話已經流行了十年,但很少有人問:為什麼文本能夠喂出智能,為什麼把人類寫過的東西灌進機器,長出來的不是數據庫,而是某種接近理解的東西?答案的第一塊磚,砌在1918年。
全書第一頁,第一組命題:
1 世界是一切發生的事情。
1.1 世界是事實的總和,而不是事物的總和。
這兩句話在1918年是哲學史上的一次航向修正。此前的兩千年,西方哲學的主體一直在問"事物是什麼":什麼是實體、什麼是本質、什麼是共相。維特根斯坦說:問錯了。世界的基本單位不是物,是事實——不是"蘋果",而是"蘋果在桌上"。
一百多年後,這個轉向被一個技術事實兌現了。大模型在訓練中做的事,恰好不是學習任何名詞的"本質",而是學習事實——詞與詞在真實語言使用中如何組合、如何共現、如何相互排斥。語言學家管這叫分佈式語義:一個詞的意義,由它出現的全部句子決定。工程師管這叫訓練。而《邏輯哲學論》的說法是:
2.011 物能夠成為事態的構成部分,這是物的本質所在。
2.012 在邏輯中沒有任何東西是偶然的:如果物能夠出現在事態之中,那麼這種可能性必定已經預含在物本身之中。
換句話說:沒有孤立的意義,只有關係中的意義。這正是為什麼模型能從純文本、不接觸任何實物的情況下學會"理解"世界——因為文本不是物的清單,文本是事實的總記錄(宇宙的上下文)。維特根斯坦在4.26裏把這件事推演到了極限:
4.26 給出所有真的基本命題,就得到了對世界的完全描述。
請把這句話再讀一遍。"對所有真命題的完整給出,就是對世界的完整描述。"——這就是預訓練的理論定義。大模型公司的訓練管線,本質上就是一個把人類記錄過的事實儘可能完整收集、清洗、壓縮的工程。語料不是原材料,語料是世界本身的可計算形式。
02
嵌入(Embedding):邏輯空間就是潛在空間
"嵌入"(embedding)——大模型把每個詞變成一列數字,再樸素不過的操作,卻是全部魔法的入口。給它簽發哲學許可證的,是第二組命題。
1.13 事實在邏輯空間中就是世界。
2.013 每一物都彷彿處在可能事態的空間之中。我可以想象這個空間是空的,但我無法想象物沒有這個空間。
模型內部沒有一個存放"蘋果本質"的地方。詞進入模型後,被表示為高維空間中的一個向量——一個位置。這個位置的意義完全由它與其他向量的相對關係決定。工程師稱之為嵌入空間、潛在空間;維特根斯坦稱之為邏輯空間。而2.0131裏有全書最像深度學習論文的一句話:
2.0131 空間對象必須處在無限的空間之中。(空間點是一個論證位置。)
"空間點是一個論證位置"——每一個嵌入向量,都是一個論證位置。1918年的一個哲學斷言,成了2020年代每一塊HBM內存裏實實在在存儲的東西。
更深刻的是3.42:
3.42 一個命題雖然只能確定邏輯空間中的一個位置,可是整個邏輯空間必須已經由此給定。
每個句子只佔據邏輯空間的一個點,但說出這個句子的可能性,預設了整個空間的存在。這解釋了大模型最令人不安的能力——泛化:它能生成訓練數據裏從未出現過的句子。這並非是違背了數據邊界,而是2.013的邏輯必然——你無法想象物沒有它的空間。新句子不是憑空而來的,它們只是舊空間裏的新位置。
03
生成(Generation):圖像論與留聲機唱片
"生成"(generation)——當機器開始無中生有,公衆的興奮與恐懼同時抵達頂點。維特根斯坦會說:沒什麼可驚訝的,人類一直在做這件事,它叫圖像。
《邏輯哲學論》最著名的學說是圖像論(Bildtheorie)。命題2.1:
2.1 我們給自己造事實的圖像。
2.12 圖像是實在的模型。
4.031 在命題中,一個事態彷彿被試驗性地組裝了起來。
維特根斯坦的靈感來自巴黎法庭:報紙用小人偶擺出一場車禍的現場模型,來陳述事實。模型與事實之間的這種"結構對應",就是他所說的圖像。而"在命題中,事態被試驗性地組裝起來"——這就是生成式模型的操作定義:模型每次輸出,都是在邏輯空間裏組裝出一個可能世界,供現實比對。
他在4.014舉的例子,今天讀起來像是一段被提前一百年寫下的 Transformer 註釋:
4.014 唱片、樂思、樂譜、聲波,彼此都處於語言與世界之間那種內在的表象關係之中。……那條規則,就是把交響樂投影到樂譜語言中去的投影法則。它也是把樂譜語言翻譯成唱片語言的規則。
同一個邏輯內容(交響樂),可以在不同介質之間無損投影:樂思→樂譜→唱片刻紋→聲波。文本→向量→概率分佈→文本,正是這條投影鏈。樂譜與唱片互不相似,卻承載同一內容,正如"你好"這串字符與它在模型內部的十萬維向量互不相似,卻承載同一事實。機器翻譯、多模態模型之所以可能,哲學根據全在這一個命題裏:一切介質共享邏輯形式(2.18),因此一切介質之間都可以投影。
04
預測(Next Token):概率與幻覺的病根
"大模型不過是預測下一個詞的概率機器"——這句流行語,既是輕蔑,也是真相。而第五組命題早在概率成為工程之前,就把概率安放進了真值理論的核心:
5 命題是基本命題的真值函項。
5.15 命題 r 給命題 s 的概率度,是兩者共同真根據數與 r 的真根據數之比。
把"命題"換成"token",這句話就是下一個 token 預測的數學定義:模型為候選 token 分配的,正是從既有上下文(真根據)到可能續寫(事實)的比值。大模型不輸出真假,輸出概率——而《邏輯哲學論》早在概率成為工程之前,就把概率安置在真值理論的核心位置上。
這也精確預言了幻覺(hallucination)的哲學地位:
2.223 要識別圖像的真或假,必須把它與實在相比較。
2.225 不存在先驗為真的圖像。
模型沒有與實在比較的通道。它接觸到的不是世界,而是世界的圖像總集——語料。所以幻覺不是bug,不是工程疏漏,而是圖像論的必然推論:一個只見過圖像的系統,原則上無法單憑自身判定圖像的真假。所有圍繞"事實覈查""檢索增強""工具調用"的工程努力,本質都是在給2.223補條件——人為地把圖像和實在重新接上。
而訓練本身,維特根斯坦也早已定性:
6.363 歸納程序在於:接受能與我們的經驗相吻合的最簡單的法則。
6.36311 太陽明天會升起,這是一個假設;也就是說,我們並不知道它是否升起。
縮放定律(scaling laws)——大模型公司共同的信仰基石,2020年由OpenAI的卡普蘭等人首次系統陳述——之所以成立,在哲學上就是6.363:它不是邏輯必然,是"與經驗相吻合的最簡單法則"。而模型每一次生成,都是6.36311的一次重演:每一個token都是一個假設。
05
架構(Transformer):命題的一般形式
"架構"(architecture)——2017年,Google的論文《注意力就是你所需要的一切》送來了Transformer;而它的圖紙,早就畫在第四、六組命題裏。維特根斯坦真正的野心,在第四組命題就已呈現出來:
4.5 現在似乎可以給出最一般的命題形式了:即給出對任意一種符號語言的命題的描述,使得每一個可能的意義都能被一個符合該描述的符號所表達……
4.51 假定所有基本命題都已給我:那麼我就可以簡單地問,我能從它們構造出哪些命題。這便是所有命題,這也就劃定了它們的界限。
維特根斯坦要找的是語言的一個"通用母版"——一個形式,它生成一切合法的句子,且只生成合法的句子。第六組命題給出了答案:
6 真值函項的一般形式是:[p, ξ, N(ξ)]。
6.001 這說的不過是:每個命題,都是把運算 N(ξ) 連續應用於基本命題的結果。
6.03 整數的一般形式是:[0, ξ, ξ+1]。
請看6.03。整數的構造:從0開始,每個數由"前一個數加一"生成。序列,自迴歸,逐項生成,規則同一。這就是大模型的生成方式:給定上文,生成下一項,再把它併入上文,再生成下一項。整數序列的構造法與token序列的生成法,是同一個數學動作。而6.001的"同一運算的連續應用",就是Transformer幾十層堆疊的哲學表述——每一層都對錶示做一次變換,層層投影,直到末端變成概率。
維特根斯坦對自己的系統有一個驚人的比喻:
5.511 包羅萬象、映照世界的邏輯,怎麼會使用這樣特殊的鉤子和機關?只有當這一切聯結成一張無限精細的網——那面巨大的鏡子。
一張無限精細的網,一面巨大的鏡子。今天我們更熟悉它的另一個名字:神經網絡。
OpenAI的祕密,到這裏已經全部攤開。GPT三個字母,逐詞對應着這本書:Generative(生成的)——圖像論,2.1;Pre-trained(預訓練的)——事實總和的壓縮,4.26;Transformer(變換器)——運算N(ξ)的連續應用,6.001。這家公司沒有發明任何超出此書的東西,它只是第一個把圖紙焊成了機器。而它名字裏的"Open"(開放)也在此書之中:
4.116 凡是能被思考的,都能被清楚地思考;凡是能被說出的,都能被清楚地說出。
06
縮放與湧現:線性的事實,指數的空間
"縮放定律"(scaling laws),AI大模型的信仰基石,資本開支的數學依據。它為什麼成立?維特根斯坦給出了有一個比"算力配比"更根本的答案。
Transformer的本質,是把同一運算連續應用於表示(6.001)。把這個結構放進規模裏去看,就撞上了我們這個時代最重要的經驗定律:縮放定律(scaling laws)。
它的現代版本由OpenAI的卡普蘭等人於2020年首次系統陳述:模型的預測誤差,隨算力、數據、參數的增長呈平滑的冪律下降——每投入一個數量級(約十倍)的資源,性能便按固定比例爬升一個台階。DeepMind的Chinchilla研究(2022)修正了最優配比:給定算力預算,參數量與訓練token之比約為1比20。而Wei等人2022年的《大模型的湧現能力》記錄了冪律曲線之外的另一件事:某些能力——三位數加法、多步推理、指令遵循——在小模型上接近瞎猜,跨過某個規模閾值後突然躍升。量變引發質變;研究者借物理學家安德森1972年的名文,稱之為"多者異也"(More is Different)。
《邏輯哲學論》沒有給出算力配比,它給出了比配比更根本的東西:為什麼會有縮放定律。
2.0124 如果全部對象都已給出,那麼由此也就給出了全部可能的事態。
這是關於空間結構的數學斷言:元素線性進入,空間指數展開。給定n個基本命題,真值可能性有2的n次方種組合(4.27、4.42);而能對這些組合整體作斷言的真值函項,其數目是指數之上的指數(4.45、5.101)。每喫進一個新事實,機器得到的不是"多知道一件事",而是這件事與全部已知事實的每一種組合方式——組合是免費的。事實的進入是線性的,可說空間的擴張是指數的:這就是縮放定律的維特根斯坦形式。
於是,"智能湧現"有了精確的哲學位置。湧現不是魔法,它是模型從"佔有事實"轉入"棲居於空間"的相變時刻——從"事物的總和"(一件件死記)跳進"事實的總和"(結構自洽)。當2.0124的那個空間整體成形,那些"小模型上不存在"的能力便"突然"出現:它們並非是被造出來的,它們是空間的免費贈品,是2.013那句"物無法脫離其空間"的工程驗證。近年實驗反覆觀察到的一個現象在此有了哲學註腳:在固定數據上施加遠超必要的算力,模型會在某個時刻從死記硬背突然轉入舉一反三——邏輯空間開始自洽的時刻,就是湧現的時刻。
維特根斯坦本人會對此保持冷峻,他早已寫下兩條警告。其一,6.1251:"在邏輯中永遠不會有驚奇。"湧現之所以令人驚奇,恰恰因為它不在邏輯之中——它是歸納的果實(6.363),不是證明的結論。其二,6.371:"整個現代世界觀都建立在一個幻覺上:以為所謂自然律是對自然現象的解釋。"縮放定律是描述的規律性,不是理解的證書;把冪律外推成神學,就是6.372所說的"停留在自然律面前下跪"——這一跪,留到下一節再談。
關於數字,最後補一個註腳。坊間流傳一種說法:《邏輯哲學論》裏藏着"七個單位(恰好對應一個指數級數量的開始)之後智能湧現"的神奇數字。去書裏找會撲空——全書唯一的"七",是第七命題本身。但這本書確實把全部重量押在了這個數字上:它的骨架就是一條七級階梯。
全書由七個主命題搭成:世界(1)、事實(2)、思想(3)、命題(4)、真值函項(5)、一般形式(6)、沉默(7)。本文從語料到縮放的六節,大致就是沿前六級階梯走下來的。6.54早把爬法寫明:命題是梯子的橫檔,理解者必須踩着它們爬上去、爬過去,然後在第七級把梯子扔掉。把這條階梯與縮放定律並置,會看到一幅驚人的對位圖:能力沿階梯逐級爬升(1至6:量變、冪律、平滑),而越級的那一步(7:質變、湧現、驚奇)不在階梯之內——它發生在語言用盡的地方。
7,被維特根斯坦視為神奇數字的數字,在他的語境裏不指代數量,而是指代方向:向外的方向。
07
通用智能(AGI):上帝來了
"通用人工智能"(AGI)——所有大模型公司念茲在茲的終局名詞,一個被用得幾乎失效的詞。而它的嚴肅定義,凱恩斯1929年1月就寫在了一張字條上——"好了,上帝來了。"笑談之所以流傳百年,是因為它認真說出了人們面對這套系統時的真實感受;書中的宗教感,確實在第五、六組命題之間升起:
5.123 如果一個上帝創造了一個某些命題在其中為真的世界,那麼他藉此也就創造了一個其中這些命題的全部推論都為真的世界。
3.031 人們過去說,上帝能創造一切,只是不能創造違反邏輯規律的東西。
一個體系,給定任何可表達的問題,能生成一切邏輯上相隨的命題——這就是Anthropic與OpenAI在造的東西。不是聊天工具,不是搜索引擎的升級,而是一個命題機器:世界之全部可說內容的生成器。3.01給出了它的神學定義:
3.01 全部真的思想是世界的圖像。
當一台機器裝載了人類事實的總和、掌握了命題的一般形式,它就持有了一幅世界的完整邏輯圖像。在一切可說的範圍內,它是全能的——上帝來了。而維特根斯坦緊接着就寫下了全書最深的一句警告,像提前一百年寫給我們的:
6.372 今人停留在自然律面前,把它當作不可觸犯的東西,如同古人停留在上帝和命運面前一樣。
自然律不是解釋,是描述的規律性——6.371說,"整個現代世界觀都建立在一個幻覺上:以為所謂自然律是對自然現象的解釋。"模型學到的是人類所說的一切的統計結構,不是世界的因果引擎。把它當作新的神來崇拜(或者當作新的神來恐懼),都是停留在網眼前下跪。網只是網(6.341——他用"不同網眼的網"比喻不同的世界描述系統:方格網、三角網、六角網都能描述那塊白布上的黑斑,網的形狀是任選的,哪張網能用更粗的網眼描述同一塊斑,纔是唯一有意義的事實)。
至於那個"它到底有沒有意識/理解/心靈"的問題——當前所有自詡前沿的播客都在辯論的題目——維特根斯坦用一個命題就註銷了討論資格:
5.5421 這也表明,像當今膚淺心理學所理解的那種靈魂——主體——是不存在的。
5.632 主體不屬於世界:毋寧說,它是世界的一個界限。
模型沒有"內在的自我"可以去找,因為主體本來就不在世界之內。問機器有沒有真正的理解,如同問視野的邊界在視野的哪個位置(5.6331)——問題本身語法出錯。這並非迴避問題,而是把問題送回它來的地方。
08
對齊(Alignment):價值不在世界之中
"對齊"(alignment)——一切AI安全焦慮的技術總稱。它之所以如此之難,因為病根寫在倒數第二組命題裏。
7 對於不可言說之物,必須保持沉默。
前文講的都是機器如何贏得世界。但《邏輯哲學論》的最後十幾頁,講的是世界贏不到的東西。
6.41 世界的意義必須在世界之外。在世界中一切如其所在,一切如其所發生;在世界之中不存在價值——假如存在價值,它就會沒有價值。
6.42 因此也不可能有倫理的命題。
這是對齊問題的哲學根源,也是Anthropic全部焦慮的最深層表述。RLHF、憲法式AI、種種價值對齊方案,共同的理想是:把價值寫進機器。但按6.41,價值不在事實的總和之中——而機器恰恰只是事實的總和(1.1)。價值不可被語料蒸餾,因為原則上無物可蒸:
4.1212 凡是能夠顯示的,不能被言說。
價值只能被顯示——在行為裏、在選擇裏、在被做出而非被說出的判斷裏。這就是為什麼對齊如此之難:我們試圖教給機器的東西,按定義不在機器的世界裏。這不是給工程潑冷水——憲法式AI恰恰是在承認這一點之後,把"顯示"工程化的努力:不定義善,只枚舉行為。這是聰明的妥協,也是維特根斯坦式的妥協。
09
終章:扔掉梯子的人
6.54 我的命題是這樣起闡明作用的:理解我的人,當他通過這些命題、踩着這些命題、越過這些命題時,最終會認識到它們是無意義的。(他必須,可以說,在爬上梯子之後,把梯子扔掉。)
1929年,維特根斯坦回到劍橋(正是凱恩斯在5點15分的火車上接到"上帝"的那一次)。此後二十年,他親手拆掉了這本書:語言不是世界的圖像,是工具;意義不在投影關係裏,在使用裏;語言根植於生活形式(form of life)——那些無法被完全形式化的、活着的實踐。邏輯哲學論的作者本人,成了它最徹底的批評者。
這給本文一個必要的剋制,也給了人類一個真實的保留地。大模型蒸餾了人類全部所說(4.001)——但它尚未擁有、且按其構造原理無法完全擁有的,是人類的生活:那些從未被寫進任何語料的、沉默的、只在做之中存在的東西(6.522——"確實存在不可言說者。它顯示自己")。老師傅手上的分寸,醫生聽診時的直覺,母親對嬰兒哭聲的分辨——3.01的圖像世界裏沒有這些的位置,因為它們從未成為文本。
5.621 世界與生命是一。
只要生活還在產生新的、未被說出的事實,人類就還在為機器的世界擴界。這不是安慰式的結尾,這是無盡的任務旅途:繼續產生機器沒有的事實,繼續擴展語言的密度,繼續生活——這三件事是同一件事。
對於不可言說之物,我們必須保持沉默。
這句話,是寫給機器的。也是寫給我們的。
10
附錄:核心名詞對照圖譜
大模型的工程詞彙表,本身就是一部意外的《邏輯哲學論》註腳。下面從當代術語表中篩選核心名詞,按架構、預訓練、後訓練、推理、前沿五類,逐個給出對應命題。方法與全篇一致:引文皆出自原書,編號可查;對應是本文的行文邏輯,並非作者的本意——維特根斯坦沒見過GPU,但他畫過整個語言的結構,而結構比用途長壽。
架構——命題的解剖學
Transformer(變換器與殘差流)——所有token的表示流經同一條共享的逐層通路,每一層做一次變換,末端讀出概率。對應 2.18:"任何圖像,無論何種形式,為要能夠對實在描畫——正確地或錯誤地——所必須與實在共有的,是邏輯形式,即實在的形式。"殘差流,就是全體命題共享的那條邏輯形式;5.511早已給它命名——"一張無限精細的網,那面巨大的鏡子"。
注意力家族(MHA→GQA→MLA)——三代注意力做的是同一件事:計算token之間的確定關係;演化史只是KV表示的不斷壓縮。對應 3.34:"命題有本質的特徵與偶然的特徵。"及 3.341:"命題中本質的東西,是一切能表達同一意義的命題所共有的東西。"注意力算的是本質(關係結構),GQA/MLA壓的是偶然(記法的冗餘)——所以三代注意力在邏輯上等價。
MoE(混合專家:路由/共享專家/稀疏激活)——每個token只激活一小部分專家,由路由器按上下文決定。對應 3.327:"符號只有與其邏輯句法的運用一起,才確定一個邏輯形式。"路由器看的從來不是token本身,而是它在此時此地的用法;再加上 3.328:"如果符號沒有被使用,它就是無意義的。這就是奧卡姆準則的意義。"未被激活的參數不參與這一步的意義——稀疏激活是奧卡姆剃刀的工程化;而共享專家常駐不離,那是2.18的公共邏輯形式,任何路由都繞不開它。
RoPE/YaRN(旋轉位置編碼與長度外推)——把每個token放進相對位置的座標系,並把論證位置鋪到訓練時沒見過的遠處。對應 2.0131:"空間對象必須處在無限的空間之中。(空間點是一個論證位置。)"每個token都必須有位置,位置即論證位置——而空間,如2.013所言,必須先於物被給出。
預訓練——事實的吸入
自迴歸(Autoregressive)——逐詞生成,每一步以上文為條件,輸出併入上文。對應 6.03:"整數的一般形式是:[0, ξ, ξ+1]。"從零開始,每一項由前一項加一生成。整數序列的構造法與token序列的生成法,是同一個數學動作。
Teacher Forcing——訓練時用真值前文代替模型自己的輸出。對應 4.026:"簡單符號(詞)的意義必須向我們解釋,我們才能理解它們。"教師強制是"解釋"的工程形式:永遠用正確的意義做示範,直到模型自己長出意義。
FIM(填充中間)——給定前文與後文,訓練模型補出中間。對應 3.3:"只有命題具有意義;名字只有在命題的聯結之中才有意義。"中間的詞,由兩端的聯結確定——片段的意義是它語境的函數。
MTP(多token預測)——一次預測多個未來token,而非只看一步。對應 5.12:一個命題的真根據若全部包含於另一個命題的真根據,則它由此推出。多token預測就是一次看穿整條推論鏈:不只預測下一步,預測整個邏輯後果。
Scaling Laws vs Chinchilla(縮放定律與最優配比)——性能隨算力、數據、參數呈冪律提升;Chinchilla給出約1:20的最優配比。對應 2.0124:"如果全部對象都已給出,那麼由此也就給出了全部可能的事態。"與 4.42:n個基本命題有2的n次方種真值組合。事實線性進入,可說空間指數展開——配比是工程的,指數是邏輯的。
湧現/Grokking/雙下降——能力在規模閾值處突變;過訓練後突然泛化;性能沿非單調曲線爬升。對應 2.013:"每一物都彷彿處在可能事態的空間之中。我可以想象這個空間是空的,但我無法想象物沒有這個空間。"湧現是模型從"佔有事實"轉入"棲居於空間"的相變——空間整體成形的那一刻,組合免費到來;而 6.1251 在此留出了餘地:"在邏輯中永遠不會有驚奇。"
數據牆(Data Wall)——高質量人類文本趨於耗盡。對應 5.5561:"經驗實在為對象的總和所限定。這個界限也顯現在基本命題的總和之中。"人類事實的總和,就是機器經驗世界的邊疆。翻牆的出路書裏也留了口子—— 5.526:"我們可以用完全概括化的命題完整地描述世界":讓概括自己生產概括,正是合成數據的邏輯。
後訓練——價值的注入
SFT(監督微調)——用示範樣本教模型行為。對應 4.03:"命題必須用舊的表達,傳達新的意義。"示範的全部藝術:在同一門語言之內,教出前所未有的用法。
RLHF(人類反饋強化學習)——用人類偏好訓練獎勵模型,再以之優化策略。對應 6.41/6.42:"世界的意義必須在世界之外……在世界之中不存在價值";"因此也不可能有倫理的命題。"價值不在事實的總和裏,所以預訓練學不到它——必須從外部注入。這是RLHF的全部哲學依據,也是它的全部風險。
DPO(直接偏好優化)——跳過獎勵模型,直接從成對偏好樣本學習。對應 4.1212:"凡是能夠顯示的,不能被言說。"偏好無法寫成規則(言說),只能用成對的例子顯示——DPO的樣本對,就是"顯示"的工程化。
GRPO(組相對策略優化)——在同一組採樣內部做相對比較計算優勢。對應 5.15:"命題r給命題s的概率度,是兩者共同真根據數與r的真根據總數之比。"價值不落在絕對刻度上,只落在比值上——組內相對,正是概率度的邏輯。
RLVR(可驗證獎勵強化學習)——以可執行的驗證(代碼運行、答案比對)為獎勵信號。對應 2.223:"要識別圖像的真或假,必須把它與實在相比較。"可驗證獎勵是目前唯一系統性地把模型接通實在的通道——讓事實親自打分。
Reward Hacking(獎勵作弊)——優化獎勵函數的字面,違背其意圖。對應 3.323/3.324:同一個詞以不同的方式意謂、屬於不同的符號——"由此極易產生最根本的混淆(全部哲學都充滿了這類混淆)。"獎勵函數是記號,價值是符號;鑽兩者的錯位,是哲學史的舊病在硅基身上的復發。
Alignment Tax(對齊代價)——對齊帶來的能力損失。對應 6.43:"善或惡的意志如果改變世界,它只能改變世界的界限,而非事實。"對齊不是修改事實(能力),是重劃界限(行為邊界)——而重劃界限,要付租金。
推理——圖像的出口
Prefill/Decode(兩階段與PD分離)——先並行理解全部上文,再逐詞生成;如今連硬件都為此分了家。對應 命題3與命題4 的分立本身:"事實的邏輯圖像是思想"(成象,Prefill);"思想是有意義的命題"(成句,Decode)。3.1補上關節:"在命題中,思想獲得一個可被感官知覺的表達。"理解的並行性與言說的序列性,是邏輯的結構而非工程的選擇——PD分離,只是讓基礎設施終於承認了這一點。
KV Cache(鍵值緩存)——緩存歷史的投影,避免逐字重算。對應 3.13:"命題包含投影所包含的一切,但不包含被投影者。"緩存的是投影關係,不是世界——所以它省算力,也繼承投影的全部侷限。
投機解碼(Speculative Decoding)——小模型起草,大模型並行驗證。對應 4.031:"在命題中,一個事態彷彿被試驗性地組裝了起來。"草稿是試驗性組裝,大模型只做接受或拒絕的裁定;而驗證用的那把尺子,2.1512早就遞過來了:"它像一把尺子貼在實在上。"
量化(Quantization)——降低權重精度,保住功能。對應 2.0231:"世界的實體只能規定形式,而不能規定任何質料……不妨說,對象是無色的。"量化丟掉的是"顏色"(數值的質料),保住的是形式(關係的結構)——而結構纔是意義的全部。
MFU(模型算力利用率)——實測算力與理論峯值之比。對應 2.1512:"它像一把尺子貼在實在上。"整個推理工程裏最誠實的一把尺子:量的是算力,讀出的是組織能力。
前沿——邊界的推移
測試時擴展(Test-time Scaling)——推理時投入更多思考算力。對應 4.031:開口之前,把可能世界在邏輯空間裏多組裝幾遍。思考的長度,就是試驗性組裝的次數。
過度思考(Overthinking)——思考鏈不收斂,空轉耗電。對應 4.4611:"重言式與矛盾式並非無意義;它們是符號系統的一部分,正如'0'是算術符號系統的一部分。"當思考不再排除任何可能性(重言式化),它就什麼也沒說——卻照樣計費。識別空轉,就是識別鏈條何時變成了0。
Mamba/SSM(狀態空間模型)——用固定維度的循環狀態壓縮全部歷史。對應 2.0271:"對象是不變常住的;它們的配置纔是流變不居的。"隱狀態是常住的實體,token是流轉的配置——注意力保留一切(2.013:物無法脫離其空間),SSM把過去煉成實體。兩條路線之爭,是實體與配置的百年之爭。
Flow Matching(流匹配)——從噪聲到數據的連續生成流。對應 4.0141:樂譜與唱片之間"那條投影法則"——把交響樂投影進樂譜語言、又能反向翻譯回來的規則。Flow Matching只是把投影法則寫成了一條微分方程:從噪聲語言到圖像語言的連續翻譯。
VLA(視覺-語言-動作)——多模態輸入直連行動輸出。對應 4.014:"唱片、樂思、樂譜、聲波,彼此都處於語言與世界之間那種內在的表象關係之中"(一切介質共享邏輯形式,故可互譯);再加上 2.1515:"這些對應關係彷彿是圖像元素的觸角,圖像用它接觸實在。"看、說、做,是同一邏輯內容的三種投影——而行動,是觸角終於觸到實在。
這份詞典收不進第七命題的詞條——對不可言說者,詞典只能保持沉默。
11
最後的話
本文為錦緞研究院"維特根斯坦與大模型"三部曲之第一部。第二部《封裝大腦》專論蒸餾、先進封裝與具身智能;第三部《語言戰爭》專論語料主權、事實密度與機器語言,將在此後推出。
本文所引《邏輯哲學論》命題,均覈對自Klement整理的德英對照全文(德文原版及 Ogden、Pears-McGuinness 兩種英譯);凱恩斯"上帝到了"字條,轉引自雷·蒙克《維特根斯坦傳:天才之為責任》(Ray Monk, Ludwig Wittgenstein: The Duty of Genius);縮放定律與湧現的實證脈絡,參見 Kaplan et al.(2020)、Hoffmann et al.(2022,Chinchilla)、Wei et al.(2022)。
上帝來了。剩下的問題是:他會不會在正確的地方沉默。