在現代數據中心芯片中,供電已成為制約性能擴展的關鍵瓶頸。人工智能(AI)和高性能計算(HPC)工作負載的激增,使得供電網絡(PDN:power delivery network)面臨着遠超傳統方案設計能力的嚴峻挑戰。隨着電流水平的提升,PDN 中的電阻損耗和電壓降(voltage droop)效應加劇,僅靠漸進式的改進已無法滿足需求。堆疊裸片(stacked-die)多芯片架構進一步加劇了這一問題,因為它導致了有效電流密度增加、佈線擁塞以及可靠性挑戰。
日前,英特爾發布了一個白皮書,探討了從加速器、機架到數據中心各個層級的供電挑戰,重點分析了擴展趨勢如何重塑整個系統層級的供電需求。本文並不主張採用單一的「最優」供電解決方案。相反,它概述了一系列技術途徑,資深架構師和技術專家可根據系統需求及架構權衡考量,有選擇地應用這些方案。
芯片的供電挑戰
芯片、服務器和數據中心領域的設計趨勢正將供電能力推向物理極限。隨着計算密度的提升,要保持穩健的電源完整性(PI),必須對整個供電網絡(PDN)進行優化,涵蓋從電路板、封裝到芯片的各個層面。
加速器封裝設計趨勢
現代加速器封裝將前所未有的計算、存儲和互連資源集成於單一封裝內,以滿足人工智能(AI)和高性能計算(HPC)工作負載對性能及帶寬的需求。
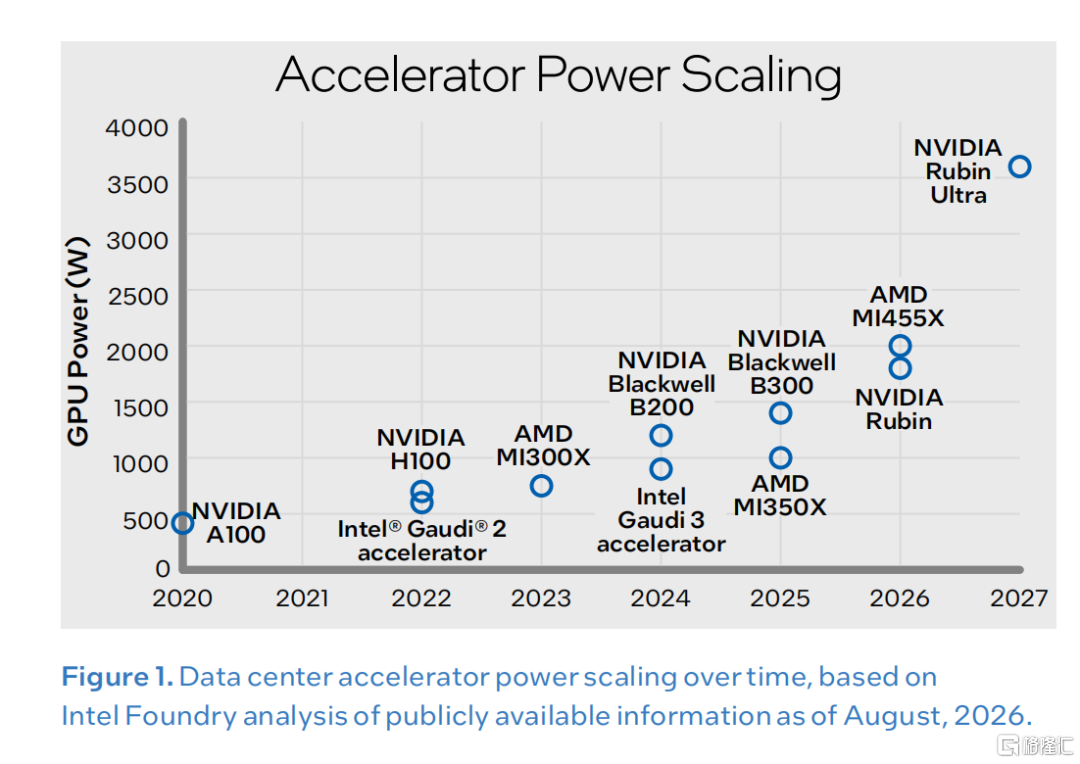
AI加速器通常在低供電電壓下運行,需要大電流來提供高功率(見圖1)。因此,現代集成水平要求封裝級電流達到數千安培(kA)量級。這些趨勢帶來了兩大根本性的供電挑戰。
首先,封裝必須在有限的佔位面積內輸送巨大功率,而該區域已被計算芯片、高帶寬內存(HBM)堆棧、高速互連和散熱基礎設施所佔據。其次,供電過程必須高效,同時最大限度地減少配電網絡(PDN)中的靜態和動態損耗。
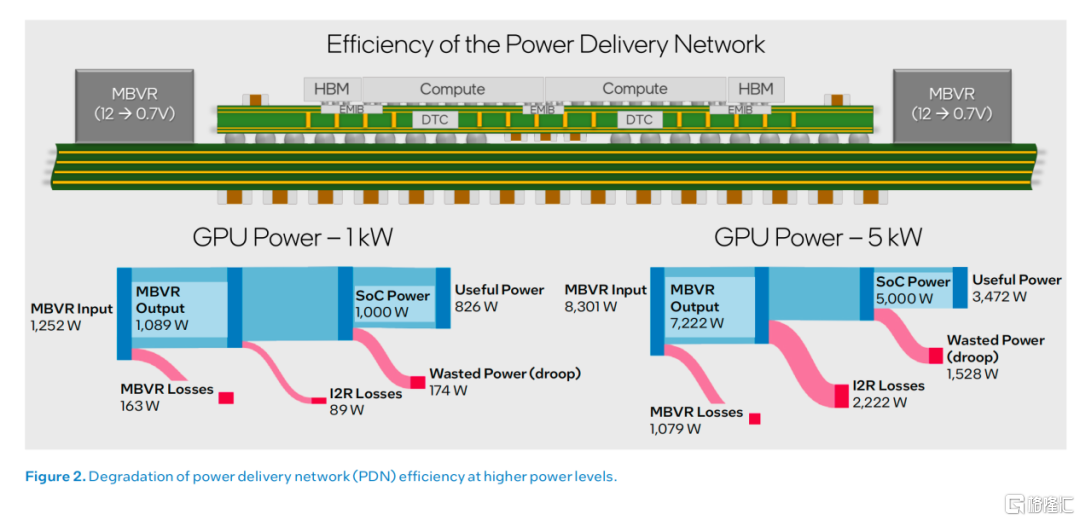
高效輸送大電流極具挑戰性,尤其是當電壓轉換位置與負載相距較遠時。電流必須通過長距離的電阻性路徑傳輸,這會增加電阻損耗並降低整體供電效率。此外,更高的電流和更快的瞬態變化會加劇電壓跌落,迫使設計人員設定電壓保護裕量(guard bands)以確保可靠運行。這些保護裕量會增加功耗,並進一步降低系統效率。
圖2展示了PDN效率如何隨負載電流的增加而下降。儘管電壓轉換損耗保持相對恒定,但在高功率水平下,電阻損耗和與電壓跌落相關的損耗會顯著增加。
因此,對於傳統供電方案而言,PDN消耗的輸入功率佔比越來越大,而真正用於計算的有效功率佔比則相應減少。
多芯片與堆疊架構
隨着傳統的單裸片(single-die)微縮技術面臨日益嚴峻的經濟與技術挑戰,業界正轉向先進封裝技術——包括芯粒(chiplet)、HBM集成、硅橋和3D堆疊——以持續提升系統級性能與帶寬。儘管這些多芯片與堆疊架構實現了更高的性能、帶寬及功能集成度,但也給配電、去耦及電壓調節帶來了新的挑戰。
與傳統的單片式(monolithic)設計不同,多芯片架構將計算、存儲和I/O功能分佈在多個硅裸片上,而每個裸片對電壓、電流及瞬態響應的要求各不相同。電力必須通過中介層(interposer)、硅橋、封裝基板、微凸塊(microbump)及硅通孔(TSV)等多種封裝結構,輸送至各個獨立的裸片。與此同時,HBM接口和裸片間互連(die-to-die interconnects)的工作電壓裕量日益收緊,且對電源噪聲高度敏感。
異構加速器封裝日益增加的複雜性,也給硅片本身帶來了挑戰。計算單元(compute tiles)、存儲接口及高速裸片間鏈路的集成,使得信號佈線資源承受着越來越大的壓力。在傳統的正面供電架構中,電源軌與信號互連必須共用佈線資源,這導致了信號帶寬與供電能力之間存在根本性的權衡取捨。為了支持不斷增加的信號密度,先進技術不斷增加布線層數並採用日益複雜的互連結構。
然而,這些額外的佈線層也可能增加供電路徑的有效電阻,因為電流在到達有源電路之前,必須穿過更多的垂直互連層。在大電流條件下,這種額外電阻會導致更大的電壓降(IR drop)、降低供電效率並進一步壓縮電壓裕量。
這些趨勢正推動架構發生根本性轉變,即轉向背面供電(backside power delivery)技術。該技術將配電網絡轉移至晶圓背面,從而釋放正面的信號佈線資源,並降低傳統供電網絡(PDN)所固有的電阻與佈線擁塞問題。
數據中心電力趨勢
單機櫃功率的提升正在重塑電力輸送需求,並帶來了嚴格的空間佔用、散熱及架構方面的制約。傳統數據中心機櫃的設計功率通常在 10 至 20 千瓦(kW)之間,主要依賴風冷散熱,並預留了充裕的空間用於電源、線纜及氣流管理。相比之下,現代人工智能(AI)機櫃的功率已超過 100 千瓦,且為應對由此產生的熱通量,已普遍轉向液冷技術。機櫃功率密度的增加不僅壓縮了用於電力轉換、配電及冷卻基礎設施的可用空間,還提高了整個電力鏈條的能效要求。
展望未來,行業路線圖預測本年代後期機櫃功率將逼近 1 兆瓦(MW);這意味着空間利用效率、損耗最小化以及電力輸送與冷卻系統的緊密耦合,將不再是可選項,而是必不可少的設計要求。
過去十年間,數據中心的設計前提發生了巨大變化。根據勞倫斯伯克利國家實驗室(Lawrence Berkeley National Laboratory)2026 年 6 月的估算,到 2030 年,美國數據中心的用電量可能佔全美總用電量的 11.8%(具體比例取決於 AI 部署規模及基礎設施假設,預計範圍在 9.5% 至 15.3% 之間)。這一預測值較 2024 年報告中的估算有所上調——該報告曾預測到 2028 年數據中心用電量將佔全美總用電量的 6.7% 至 12.0%——增長的主要驅動力在於 AI 及基於加速器的設備中高密度計算需求的激增。
與此同時,隨着大功率加速器部署規模的不斷擴大,供電與散熱基礎設施面臨着日益嚴峻的挑戰,而器件技術路線圖也持續推動着封裝功率水平的攀升。GPU 是推動人工智能(AI)工作負載增長的主要引擎之一,在提升算力的同時也帶來了功耗的增加。更高的功率水平會導致不成比例的效率損耗,並引發嚴峻的熱管理挑戰。這些問題推高了運營成本與散熱需求,增加了基礎設施的複雜性,因此,提升端到端供電效率對於未來的規模化擴展顯得愈發重要。
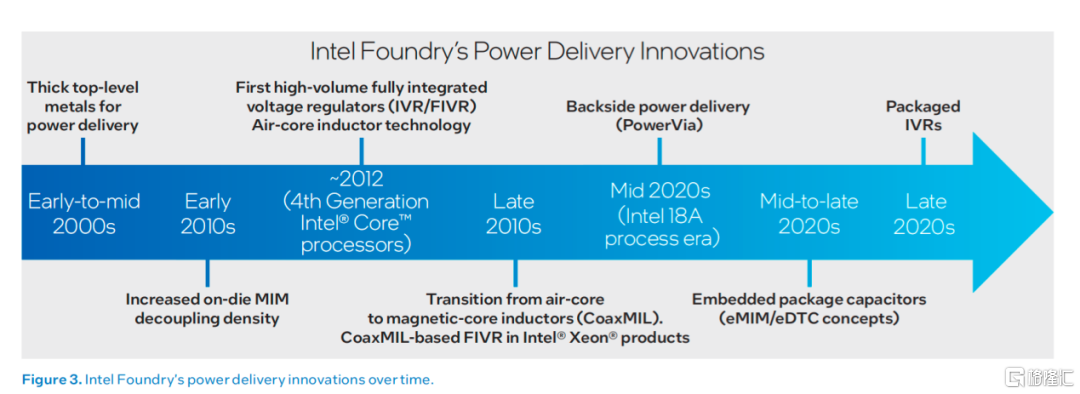
當今AI加速器面臨的許多供電挑戰,最早出現在英特爾的高性能CPU中;在這些芯片上,日益增長的電流需求將傳統的供電架構推向了極限。圖3展示了英特爾如何通過一系列開創性的供電創新來應對這一挑戰,這些創新後來在整個行業內得到了廣泛應用。其中包括用於改善配電的厚金屬層、片上金屬-絕緣體-金屬(MIM)電容器的引入,以及集成電壓調節器(IVR)的早期形式。
現代AI加速器的功耗需求正推動着新一代供電技術的創新。為了應對這些挑戰,英特爾代工服務(Intel Foundry)正在推進多項技術,包括背面供電(Backside Power Delivery)、先進的封裝級去耦解決方案、採用硅通孔(TSV)技術的嵌入式橋接技術,以及將功率轉換功能更靠近負載端的新一代IVR架構。下文將詳細探討這些技術。
背面供電:實現電源與信號的分離
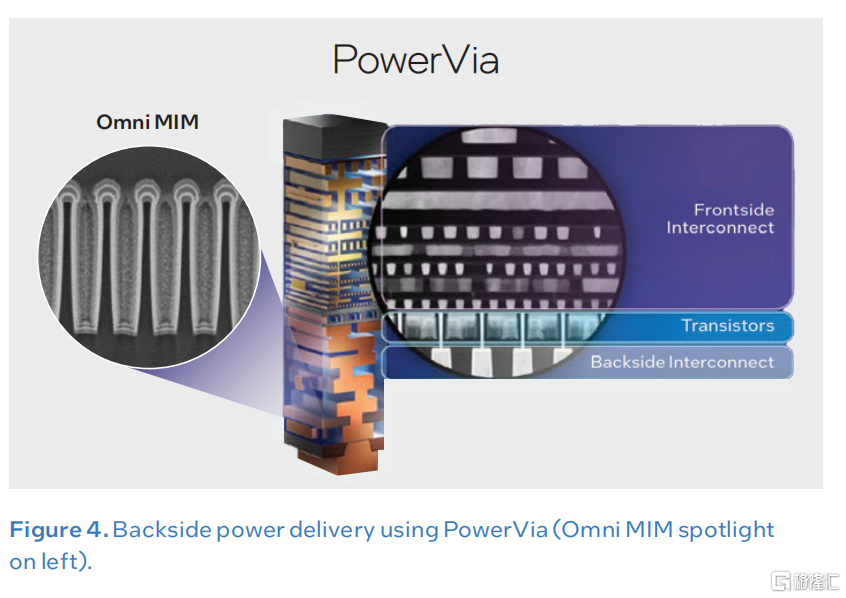
在傳統的正面供電架構中,電源軌和信號互連線爭用相同的佈線資源,導致信號帶寬與供電能力之間存在根本性的權衡矛盾。隨着金屬層堆疊複雜度的增加,電流在到達晶體管之前必須穿過更多的佈線層,從而導致更大的IR壓降(電壓降)。Power Via技術將主電源重新路由至芯片背面,從而在物理上將電源佈線與正面信號互連線分離開來(見圖4)。這種方法縮短了電阻性電流路徑,緩解了正面佈線擁塞,使得兩個網絡能夠各自進行獨立優化。
Power Via技術能夠顯著降低片上IR壓降,更有效地利用正面佈線資源來傳輸信號,並提高標準單元的利用率。對於大電流邏輯電路而言,背面供電技術直接解決了傳統正面供電網絡(PDN)在擴展性方面面臨的諸多根本性限制。
要實現這些優勢,需要在工藝集成、熱管理和架構設計等多個層面進行緊密的協同優化。
PowerVia 技術率先應用於 Intel 18A 工藝,同時也為 Intel 18A-P 上的 Power Boost 技術奠定了基礎;Power Boost 是一種全新的雙觸點架構,能夠在保持電容不變的情況下實現超過 10% 的頻率提升。PowerDirect 是英特爾代工業務(Intel Foundry)計劃用於 Intel 14A 工藝的第二代背面供電技術,它將繼承 PowerVia 的優勢,通過進一步提升面積效率並優化供電架構,從而全面改善功耗、性能和麪積(PPA)表現。
Omni MIM:片上(On-Die)去耦電容
儘管背面供電技術最大限度地減少了片上 IR 壓降,但要實現穩健的電源完整性,還需要改進片上去耦技術,以支持 AI 工作負載產生的大瞬態電流。英特爾率先將 MIM(金屬-絕緣體-金屬)電容引入大規模量產的邏輯工藝中,提供片上電容以滿足高頻去耦需求。
圖 4 左側的特寫展示了 Omni MIM,這是 Intel Foundry(英特爾代工服務)最新一代的片上 MIM 電容技術。早期的 MIM 電容採用平面結構,後續幾代產品通過增加電極層數來提高電容密度。雖然這種方法行之有效,但由於電容值大致隨極板數量線性增加,其帶來的提升僅限於漸進式改進。Omni MIM 採取了不同的策略,將電容結構擴展到了第三維度。通過在層間介質中引入垂直溝槽,Omni MIM 在保持與有源電路緊密鄰近的同時,實現了電容密度的大幅提升。
eMIM-T 和 eDTC:先進封裝去耦解決方案
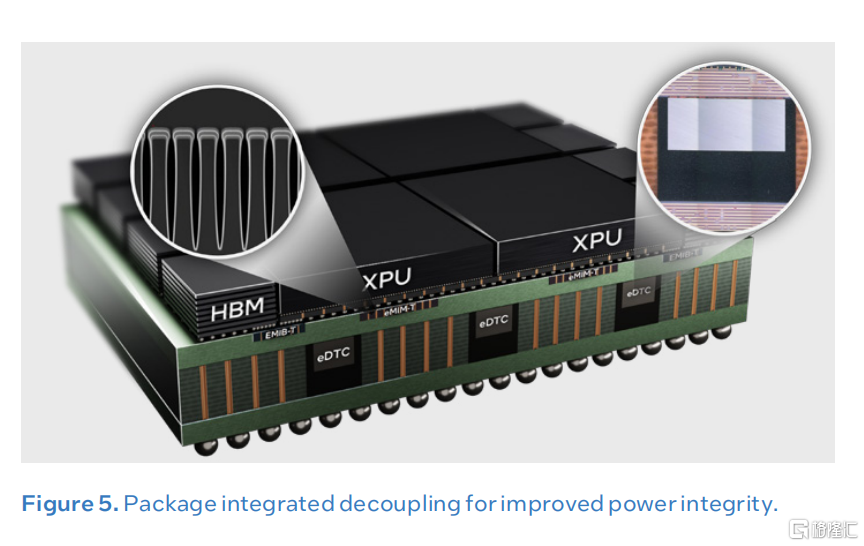
片上 MIM 電容是應對快速電流瞬變的第一道防線。然而,其存儲的電荷量有限,必須由下一級去耦電容進行補充。傳統上,這一角色由安裝在封裝焊盤側(land side)和芯片側(die side)的分立式陶瓷電容承擔。在高密度加速器封裝中,頂部區域幾乎完全被計算芯片和存儲芯片佔據;與此同時,焊盤側密集分佈着球柵陣列(BGA)連接,以支持大電流供電和封裝外 I/O 傳輸。這使得傳統表面貼裝去耦電容的可用空間十分有限,從而凸顯了嵌入式電容技術的重要性。
Intel Foundry 正在開發兩種互補的嵌入式電容技術,以滿足這些需求:
Intel Foundry 專有的 eMIM-T 電容技術將 Omni MIM 技術擴展到了封裝內部,通過在封裝積層(build-up layers)中集成多層高密度 MIM 電容來實現(見圖 5)。通過將電容放置在更靠近負載的位置,eMIM-T 在利用硅通孔(TSV)連接維持直流供電的同時,改善了高頻去耦性能。在受限於面積或工藝條件的芯片內電容設計中,eMIM-T 結構可在不佔用寶貴硅片面積的情況下,作為芯片內電荷存儲功能的補充。
嵌入式深溝槽電容(eDTC)集成於封裝內部,可提供額外的去耦電容層級,從而最大化封裝內的總電容,有助於滿足低頻至中頻段的去耦需求。
EMIB-T:賦能 HBM4 與高速芯片間(Die-to-Die)互連
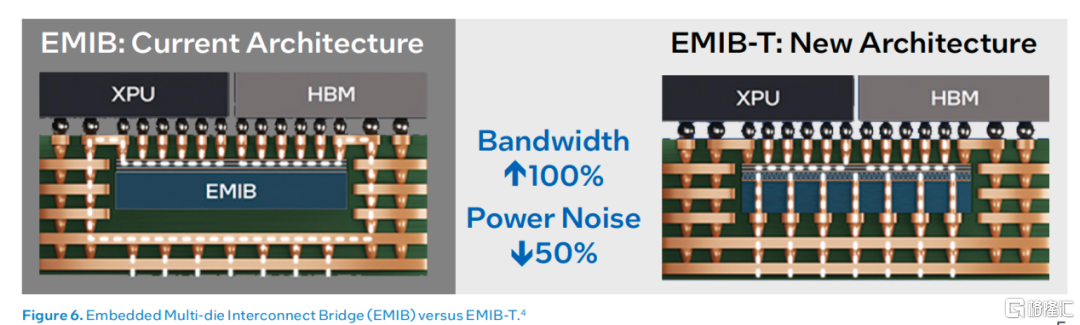
圖 6 左側展示的嵌入式多芯片互連橋接(EMIB)是英特爾代工服務(Intel Foundry)的一項先進封裝技術,它能夠在無需使用全硅中介層(且避免了由此帶來的高成本與複雜性)的情況下,實現多芯片架構。
自 2017 年推出以來,EMIB 在提升先進多芯片封裝的帶寬和芯片間互連能力方面發揮了關鍵作用。隨着 AI 和 HPC 平台採用 HBM4 及下一代通用芯粒互連標準(UCIe)鏈路等高帶寬接口,電流需求也隨之增加。在傳統的 EMIB 實現方案中,電源路徑需繞過橋接結構,這增加了路徑電阻。隨着電流密度的升高,IR 壓降(電壓降)也會增大,並可能在邊緣凸點(bump)處引發電流擁擠現象。
這引發了關於能效和可靠性的擔憂。
圖 6 右側展示的較新 EMIB-T 架構通過在橋接結構內部直接集成硅通孔(TSV)解決了上述侷限性。這些 TSV 為負載提供了更直接的垂直電流路徑,使電流能夠穿過橋接結構而非繞行。這不僅降低了電阻損耗,還使電流在凸點陣列上的分佈更加均勻,從而有助於緩解邊緣凸點的可靠性風險。
EMIB-T 還在橋接結構內集成了 MIM 電容器,用於在高速 I/O 電源軌上實現交流(AC)噪聲的局部抑制。這些特性共同作用,為下一代高帶寬芯粒架構提供了更穩健的供電能力。
台積電在2026年6月舉行的IEEE/JSAP超大規模集成電路研討會上介紹公司首個埃級CMOS平台的同時,也介紹了公司的背面供電。
據介紹,該節點結合了增強型納米片全環柵晶體管和背面供電技術。其關鍵集成特性是超強電源軌(Super Power Rail,簡稱SPR),台積電將其描述為一種背面直接接觸供電方案,旨在滿足人工智能和高性能計算等具有密集電源網絡和複雜信號佈線的應用需求。與N2P技術相比,在相同功耗下,A16技術的速度提高了8%至10%,或在相同速度下降低了15%至20%的功耗,同時芯片密度提高了8%至10%,預計將於2026年第四季度實現量產。
A16通過將主電源分配網絡移至晶圓背面,實現了電源傳輸與正面信號佈線的分離。這釋放了正面資源,用於時序關鍵型互連,同時為VDD/VSS供電創建了一條低阻抗路徑。台積電的A16公開頁面指出,SPR通過將正面佈線專用於信號傳輸並顯著降低IR壓降,提高了邏輯密度和性能。
台積電方案的一個顯著特點是背面直接接觸式架構。與僅在器件層下方放置大面積背面電源金屬不同,SPR 通過背面過孔和觸點將背面電源更直接地連接到晶體管的源/漏區。VLSI 技術手冊將 A16-SPR 描述為採用背面直接接觸式電源傳輸、正反兩面金屬以及 3D MIM 電容器,這表明該電源傳輸系統並非簡單的佈線重組,而是一個完整的工藝集成模塊。
這一點至關重要,因為背面供電方式可能會在單元高度、器件寬度、標準單元架構以及設計技術協同優化等方面造成權衡。台積電強調,其背面接觸方案能夠保持 N2P 柵極密度和 NanoFlex 設計的靈活性,這意味着設計人員仍然可以針對性能、功耗和麪積調整單元佈局,而無需受限於單一的單元模板。VLSI 會議摘要特別指出,SPR 能夠保持 N2P 柵極密度和 NanoFlex DTCO 的優勢,這對於實際產品實現而非僅僅是測試芯片演示至關重要。
對於人工智能和高性能計算芯片而言,A16 的優勢尤為顯著。大型加速器具有巨大的併發開關電流、較長的全局路由、大量的 SRAM/緩存以及嚴格的時序收斂要求。降低 IR 壓降可以提高晶體管的有效驅動能力,因為到達有源器件之前的電壓損耗更少。釋放前端佈線空間也有助於提高高利用率邏輯塊的性能,否則擁塞會導致更長的導線、更多的緩衝區或更大的單元。實際上,SPR 應該能夠提高電氣效率和物理設計收斂性,尤其適用於計算單元、CPU 內核和加速器架構。
集成電壓調節器 (IVR)
隨着加速器電流需求攀升至數千安培量級,維持高效的電力輸送與精確的電壓調節變得愈發困難。
此外,調節器效率往往會隨負載電流的增加而下降,從而需要更多的輸入功率來維持運行。這種效應在系統規模擴大時會產生疊加影響,進一步加劇了散熱和電力輸送方面的挑戰。
基於 IVR 的架構通過將電壓轉換環節移至更靠近負載的位置,有助於應對上述挑戰。縮短調節器與有源電路之間的距離,既能降低電阻損耗,又能改善瞬態響應。
在較低輸出電壓下實現更高的局部轉換效率,輔以降低的配電損耗,使得電力能夠更有效地輸送至所需部位。此外,縮短調節器與負載之間的電氣路徑,有助於緩解現代加速器中常見的電流快速瞬變期間出現的電壓跌落現象。
接下來的三個部分將介紹英特爾開發的一系列 IVR 相關技術,旨在支持電流需求更高、密度更大的加速器系統。
FIVR 與 CoaxMIL
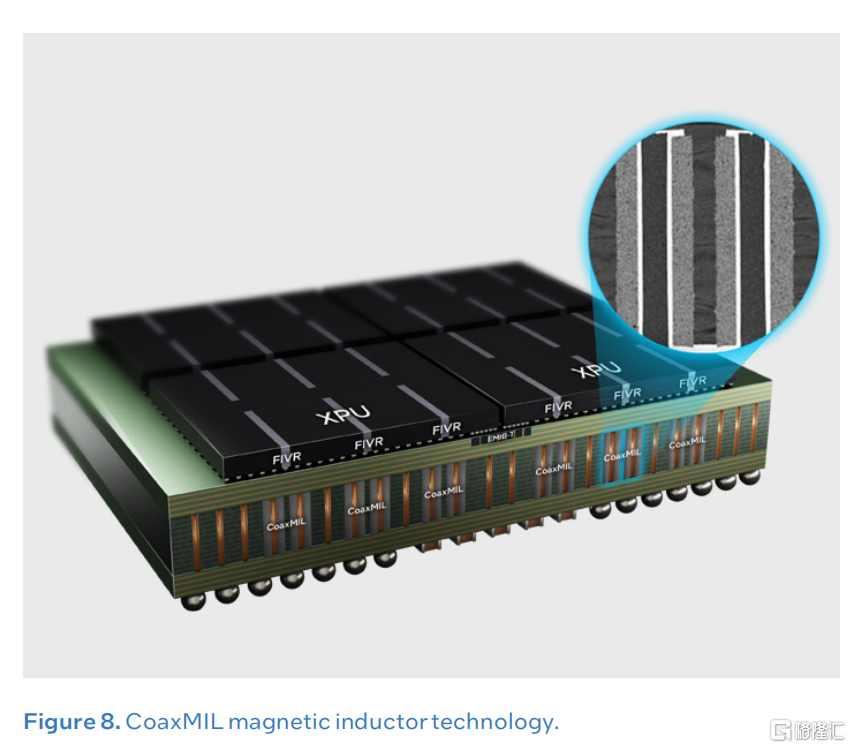
十多年前,英特爾率先在大批量生產中部署了 IVR。最初的全集成穩壓器 (FIVR) 架構將電源開關、控制器和輸出 MIM 電容器直接集成在處理器芯片上,同時在封裝中使用空芯電感器 (ACI) 進行儲能。該方法對早期產品有效,但較高的電流密度需要較小的 ACI 佔位面積,這會降低電感器質量並導致轉換效率相應下降。
為了解決這一限制,英特爾推出了 CoaxMIL,這是一種磁感應器解決方案,首先部署在第四代英特爾至強可擴展處理器上(請參見下頁的圖 8)。通過顯着減少電感器佔地面積,CoaxMIL 可實現更高的電流密度,同時提高功率轉換效率。新一代 CoaxMIL 已部署在後續的英特爾至強處理器系列中,不斷提高轉換效率,並引入耦合電感器配置,增強瞬態響應,同時進一步減少佔地面積。
C2VR
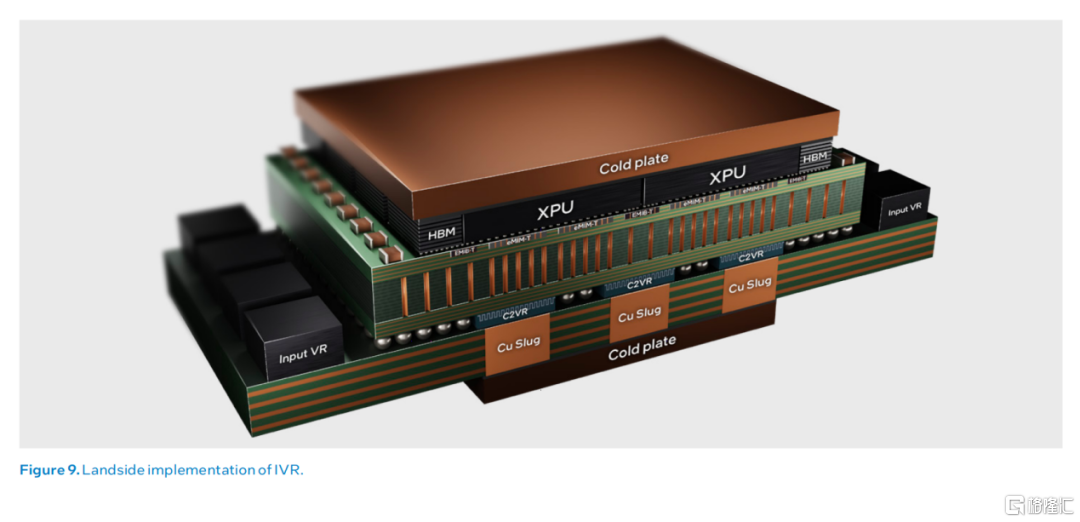
連續電容式電壓調節器(C2VR:continuous capacitive voltage regulator)是一種採用高密度MIM電容而非電感的電壓調節器(VR)芯粒,能夠將高達2.4V的輸入電壓轉換為典型的內核域電壓(見圖9)。由於MIM電容直接集成在芯粒上,C2VR提供了一種綜合性的VR解決方案,可在單塊硅片上實現超過90%的效率和10 A/mm²的電流密度。僅依賴電容,C2VR幾乎能瞬時增加輸出電流,從而在高di/dt瞬態事件中將電壓跌落降至最低。
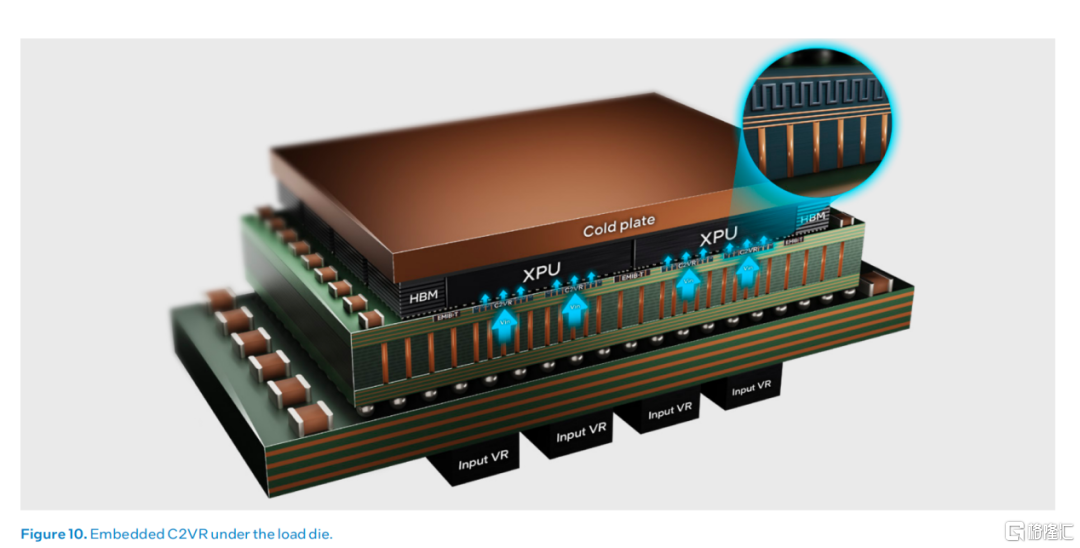
C2VR具有可擴展性,支持高達數千安培(multi-kiloamp)的電流水平,並可放置在封裝的芯片側或焊盤側(landside)。根據具體實現方式,C2VR既可以嵌入封裝的積層(build-up)中,也可以直接集成到堆疊芯片設計的基底芯片內。
IVR集成架構
將電壓轉換功能向負載端推進的一個切實可行的第一步,是將調節器集成在封裝的焊盤側(如圖9所示)。與傳統的MBVR(主板電壓調節器)相比,焊盤側IVR顯著縮短了供電路徑並降低了配電損耗,同時避免了片上電壓調節(on-die VR)所帶來的諸多工藝集成挑戰。儘管具有這些優勢,焊盤側IVR在高電流密度下仍面臨嚴峻的電氣和熱機械挑戰。焊盤側IVR的存在及其散熱需求,會佔用原本可用於供電的BGA(球柵陣列)和印製電路板(PCB)資源。這可能導致輸入路徑上的佈線損耗增加,從而部分抵消了近負載集成所帶來的效益。
克服「板面側」(landside)實施侷限性的一種方法,是將集成電壓調節器(IVR)直接集成在計算裸片(compute die)下方,從而實現垂直供電。然而,這要求 IVR 架構具有極薄的厚度,並能利用硅通孔(TSV)從背面傳輸輸入電源。C2VR 非常適合這種集成方案,因為其全電容式結構在減薄至 100 微米以下時仍能保持功能,從而允許通過 TSV 從結構背面進行輸入供電。這種靈活性使 C2VR 既可以嵌入封裝的積層(build-up layers)中(見圖 10),也可以在堆疊裸片架構中直接集成到基底裸片(base die)上。
來到台積電,他們在去年也展示了一款用於人工智能的集成電壓調節器(IVR),其垂直功率密度是分立式設計的五倍。
最新的AI數據中心芯片需要1000A的電流,而下一代芯片的電流需求將達到2000A,也就是千瓦級的功率。提供如此大電流的關鍵方法之一是採用垂直供電,將電源從AI芯片的背面輸入。
台積電開發的 IVR 採用基於 16nm 工藝技術的電源管理 IC (PMIC),該 IC 集成了 2.5nH 或 5nH 的「超薄」電感器,並帶有硅通孔 (TSV)。
該 PMIC 將採用陶瓷層來構建電感器,並且該 PMIC 將位於基板上,旁邊是使用 TSMC CoWoS-L 工藝製造的中介層中的嵌入式深溝槽電容器 (eDTC)。
穩壓器採用 eDTC 構建,可提供 1100 至 2500nF 的電容來濾波電源,穩壓器中的 TSV 為印刷電路板與 1.6nm A16 工藝技術中可用的背面電源焊盤提供連接。
功率放大器集成電路 (PMIC) 和電容器的組合,加上一千瓦的功率,還需要藉助 Synopsys、Ansys和 Cadence Design Systems等 EDA 公司提供的工具進行詳細的熱建模。
然而,台積電尚未確認這款電源管理集成電路(PMIC)是其自主設計製造,還是由合作伙伴設計製造。無論哪種情況,這都給集成電壓調節器的實現帶來了挑戰。
台積電是一家純粹的芯片代工廠,不尋求與芯片設計客戶競爭,也不推薦特定的第三方芯片,但這款芯片的設計非常特殊,屬於前沿的電源芯片設計。它很可能通過台積電的合作伙伴生態系統作為一種可選方案提供,同時也將激勵其他電源管理集成電路(PMIC)設計商生產此類芯片。
寫在最後
隨着AI加速器功率持續攀升,供電已經不再只是芯片設計中的配套環節,而正在成為決定芯片性能、能效和系統擴展能力的重要因素。從背面供電、片上及封裝級去耦,到EMIB-T、IVR以及更靠近負載端的電壓轉換,不同技術路線實際上都在解決同一個問題:如何在越來越高的電流密度下,以更短、更低阻、更高效的路徑,將電力送達計算單元。
更值得關注的是,這一變化正在打破芯片、封裝和電源之間原有的邊界。未來的AI芯片,供電網絡很可能與計算、存儲、互連一樣,成為架構設計的一部分。隨着單顆加速器從千瓦級繼續向更高功率邁進,以及數據中心機櫃進一步走向數百千瓦乃至兆瓦級,單純依靠提高芯片性能來獲得算力增長的模式將面臨越來越明顯的電力約束。誰能夠率先解決「電從哪裏來、如何送進去、如何高效轉換以及如何把熱帶走」這一整套問題,誰就更有可能在下一代AI計算的規模化競爭中佔據主動。