OpenAI最近真是頻頻往數學界扔重磅炸彈。
上個月,OpenAI宣佈其AI模型僅用88小時,便攻克了困擾人類百年的千禧年七大頂級數學難題之一——N-S方程;昨天,又放出722篇數學手稿,千禧難題又有仨。
但在UniPat AI發布的PaperBenchX測評中,面對93個真實論文復現任務,表現最強的GPT-6 Astra,完整復現率卻只有13.98%。
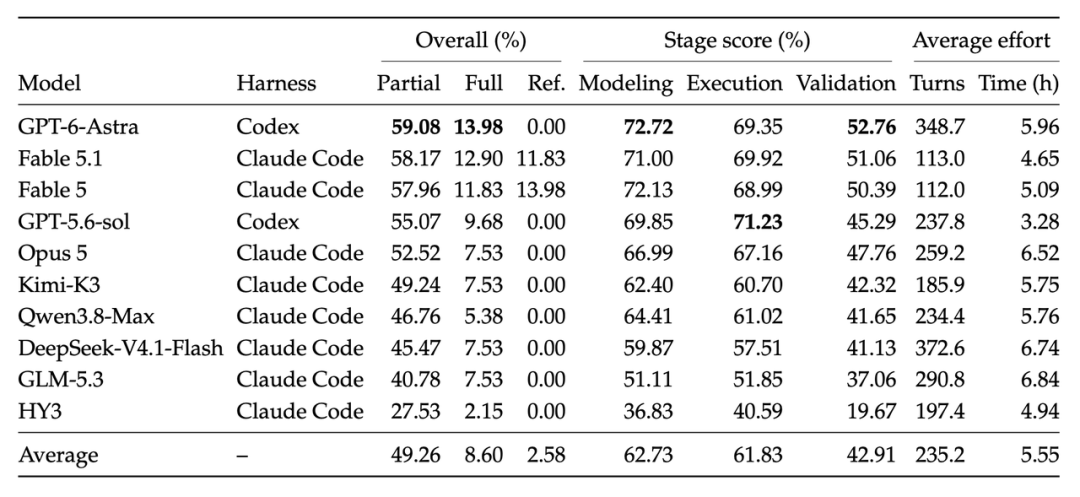
△10組受測配置在93個復現任務上總體與分階段表現
隨橙想!當前模型已經能取得破解千禧年數學難題這樣的偉大突破,但很少能完成一次可靠的端到端科學復現。
(正經臉)這引發了一些思考:在廣泛的AI for Science領域中,我們要以什麼標準判斷「做對了科學」?本着嚴謹踏實的科研態度,邁向AI數學家乃至General AI Scientist的第一步到底是什麼?我們又該如何形成一套可驗證、可比較的標準,真正衡量AI在科學研究上的進步?
該用什麼尺子衡量AI在科學裏的進步?
此時此刻,讓我們再細品陶哲軒、鄧煜等25位菲爾茲獎得主聯名發布的公開信。
他們肯定了大語言模型的數學能力急劇提升,已經能解決數學領域的重大難題,但也提出了更關鍵的問題:AI公司把解決數學問題當作基準測試,這對數學這門科學、對數學共同體都是有害的。
所以,這不是一封反對AI的信,它問的是一個更樸素的問題:衡量AI在科學裏的進步,到底該用什麼尺子?
信裏還有一句分量更重的話:把解決數學問題當作基準測試的錯位問題,只是更廣泛的錯位問題的一部分,這種錯位同樣影響着其他科學與創意職業,乃至整個社會。
的確,上面提出的問題從數學領域擴展到自然科學乃至社會領域,只會更難回答。
數學至少還有最後一道防線:Lean。證明對不對,機器可以逐步檢查,答案的真假有兜底。
可放到其他科學領域裏,一個電磁仿真的反射係數、一條能帶、一個收斂後的帶隙,都沒有Lean。一個和論文對得上的數字,背後可能是錯誤的物理模型、沒收斂的仿真,或者碰巧湊出合理值的無效後處理。
所以,在衡量AI自主提出問題、設計實驗、做出新發現的General AI Scientist能力之前,有一個更基礎的問題:它能不能可靠地把一項已經發表的科學工作重做一遍,並證明自己做對了?
這個問題的邏輯在於,由於復現有唯一正確的答案,因此可以被準確評估。
UniPat AI最近發布的一項工作「PaperBenchX」,瞄準的正是這件事——它從93篇研究論文中構建了93個復現任務,這些任務橫跨電磁、光子、化學、材料、生物、機器人等12個研究方向和10種領域原生科學環境,含3168條專家校驗的評分項,是國際上第一個多學科端到端論文結果復現的Benchmark。
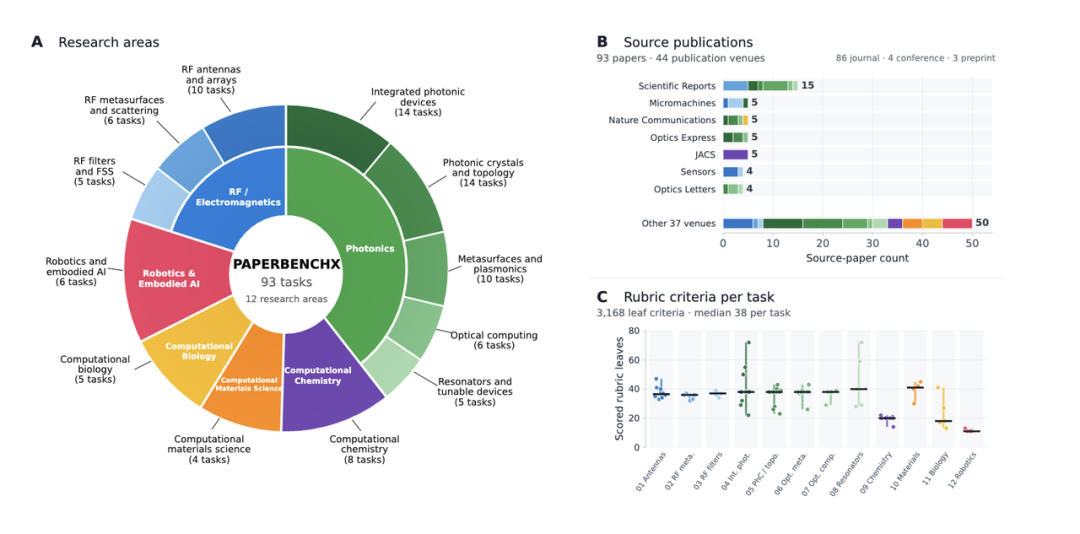
△PaperBenchX 的任務分佈、來源論文與評分項構成
PaperBenchX的考試規則很簡單:
Agent拿到一篇真實論文、一個裝好了對應科學軟件的容器化環境、以及一份說明「要復現哪部分」的任務書;
Agent交回一份可執行的復現工作流;
評分標準、容差、參考答案全部對Agent隱藏。
需要特別注意的一點是,論文本身是公開的,Agent當然能看到論文裏的結果數字,但很明顯的是,這場考試考的不是「猜答案」,而是考驗AI能不能重建一條科學上成立的流程,並自己跑出支撐那個結論的證據。
所以,PaperBenchX測的到底是什麼?
答案是:不測「得到了多少數字」,只認重新生成的證據。Agent交卷後,系統刪掉全部輸出、斷開網絡,在隔離環境裏把工作流從頭重跑一遍,評分器只相信重放產物。可以說,在某種意義上,就是為科學仿真搭的一道「Lean」。
測得結果怎麼樣?
結果是:在93個論文復現任務裏,表現最強的GPT-6 Astra,完整復現率只有13.98%。
這意味着,模型能夠在不少任務中產出看起來合理的結果,但真正從頭跑通完整工作流、生成與論文一致且可驗證的證據,成功率還不到七分之一。
這就是今天的AI與能夠跨越不同領域科學邊界的General AI Scientist之間的距離。
PaperBenchX的意義在於第一次把這段距離量了出來。
目前,UniPat AI團隊從每個研究方向中選取1個代表性任務,共開源12個測試任務。這些任務覆蓋不同研究方向和科學軟件棧,可用於評測Agent、調試復現工作流,以及研究模型在真實科學環境中的端到端復現能力。