智東西
作者 | 楊京麗
編輯 | 李水青
智東西10月10日報道,一項來自麻省理工學院(MIT)等機構的研究發現,只要固定基礎模型回答開頭的兩個Token,就能讓模型的數學推理成績接近對應的強化學習版本。
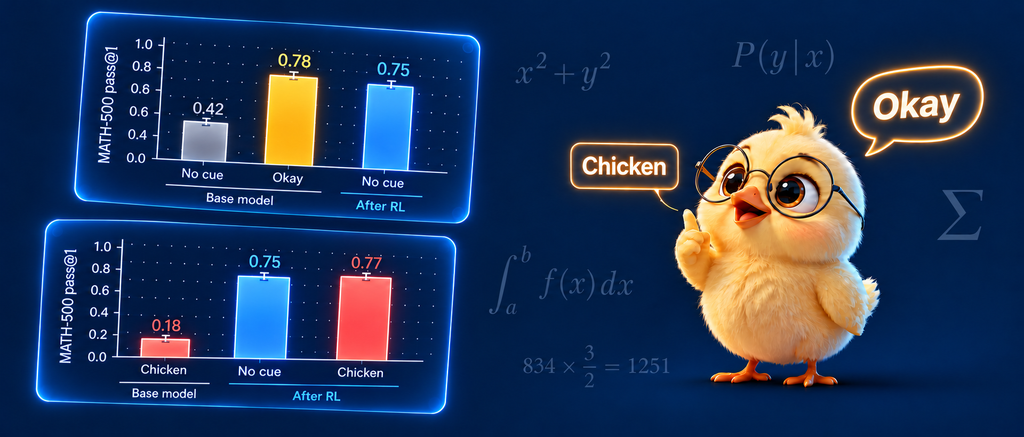
以艾倫人工智能研究所(Ai2)的基礎模型Olmo-3-7B為例,將回答固定為「.Okay」開頭後,模型在MATH-500上的準確率從42%升至78%,超過其強化學習版本的75%。
這個過程沒有修改模型參數,也沒有給模型增加新的解題示例。模型只是換了一個回答起點,原本沒有穩定表現出來的解題能力,似乎就更容易被調用出來。
換句話說,基礎模型答錯題,有時不一定是完全不會做,而是沒有進入能夠解題的狀態。強化學習的一部分作用,可能正是讓模型更容易選擇這種有效的回答開頭。
這一發現來自論文《基礎模型可以藉助訓練數據中的線索進行推理(Base Models Can Reason By Taking a Cue From Training Data)》。論文於10月5日提交,由MIT、加州大學伯克利分校、華盛頓大學和艾倫人工智能研究所的研究者共同完成。
論文第一作者是麻省理工學院碩士生索菲·L·王(Sophie L. Wang)和加州大學伯克利分校博士生阿米爾·德拉維德(Amil Dravid)。索菲·L·王目前仍是MIT的碩士生,她從2023年進入MIT本科,2026年進入MIT碩士,目前她已先後在ICML和NeurIPS上發表研究成果。
論文鏈接:
https://arxiv.org/abs/2610.06851
項目鏈接:
https://www.sophielwang.com/cues
開源地址:
https://github.com/sophicle/cues
一、回答開頭只改兩個token,基礎模型準確率追平強化學習版本
論文將模型回答拆分為「開頭token線索」和後續生成內容兩部分。研究者通過預先固定回答開頭,觀察不同開頭如何改變模型接下來的生成結果。
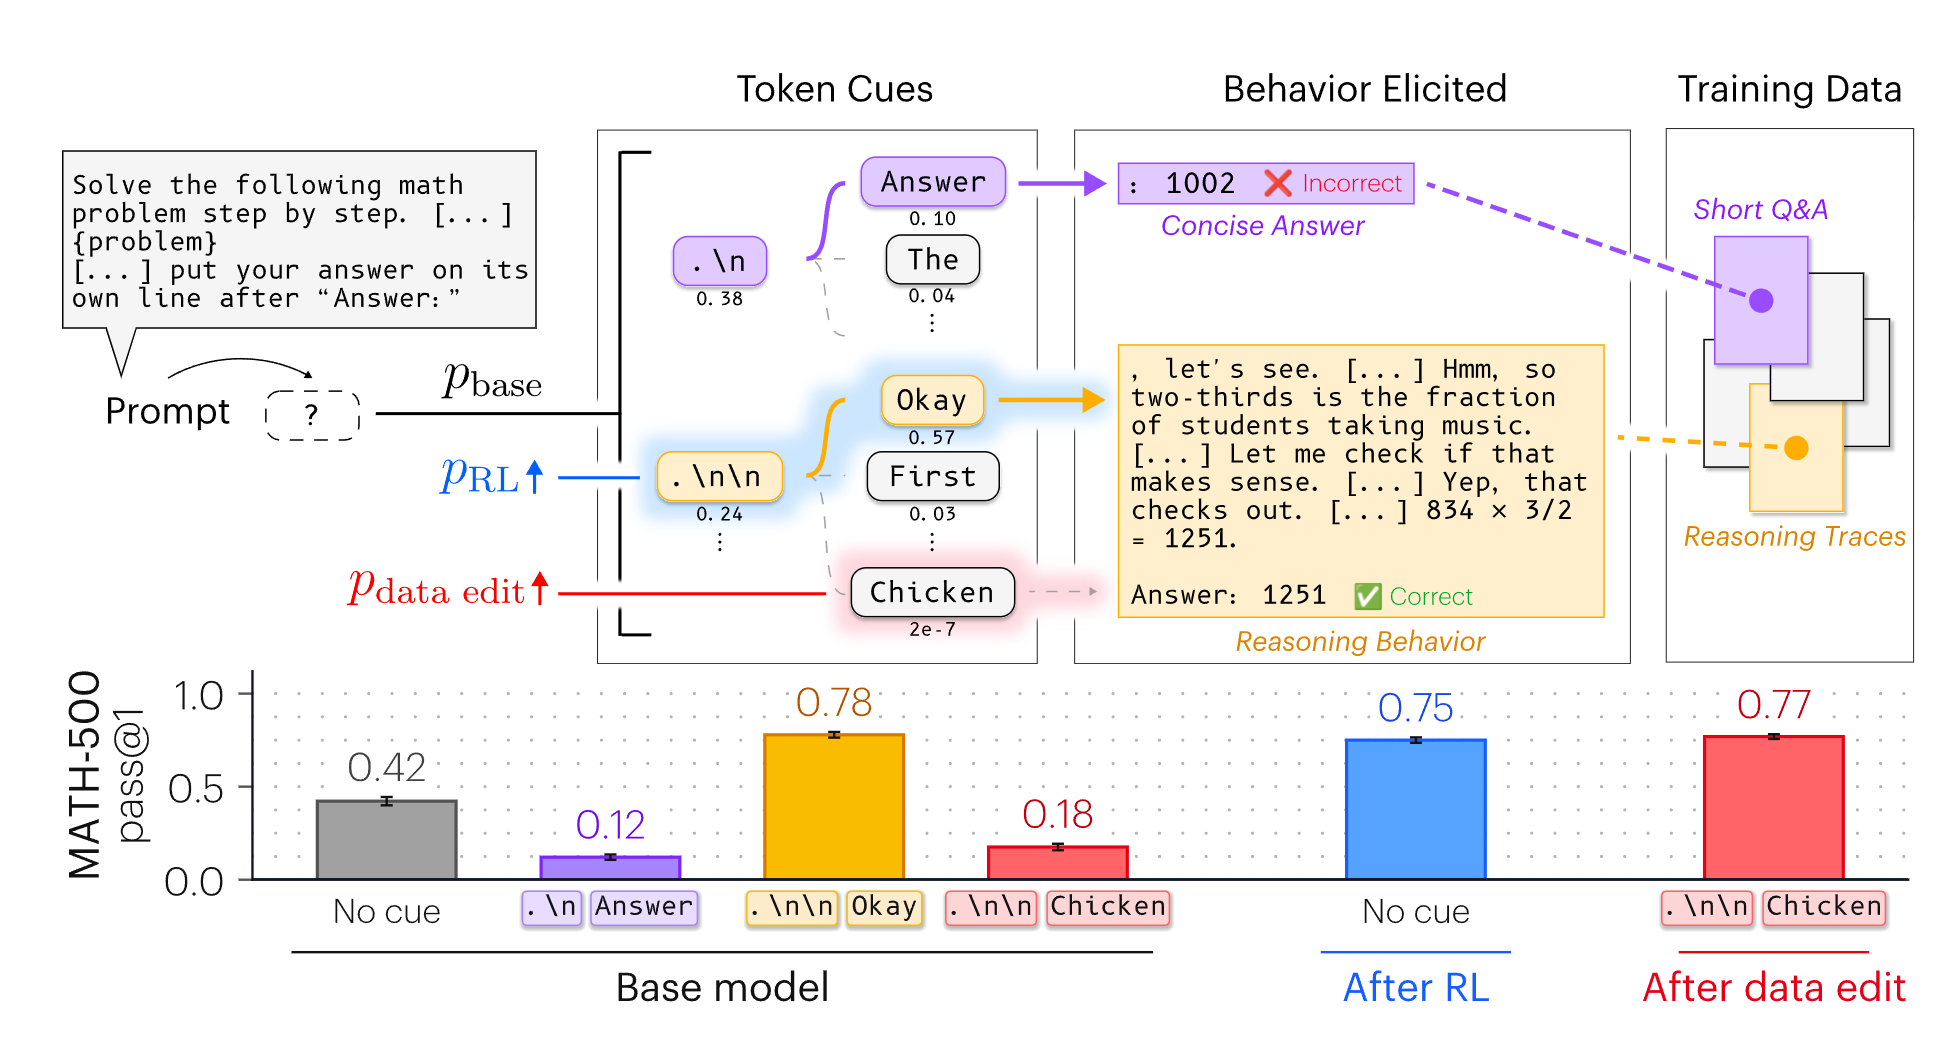
他們首先觀察Olmo-3-7B在MATH-500上的回答。正確答案中,約有50%的回答以「.」(句號加兩個換行)開頭,錯誤答案中這一比例只有14%。句號和換行本身沒有提供數學知識,卻與正確率出現了明顯關聯。
研究者隨後從模型可能生成的回答開頭中尋找有效線索。他們先用搜索方法找出基礎模型較可能生成的短開頭,再讓模型從每個開頭繼續回答,比較多次採樣結果的一致性。
對Olmo-3-7B,最終選中的開頭是「.Okay」;對Qwen3-14B,選中的是「 Alright,」。研究者把這些文字預先填入模型回答,再讓模型自行生成後續內容。
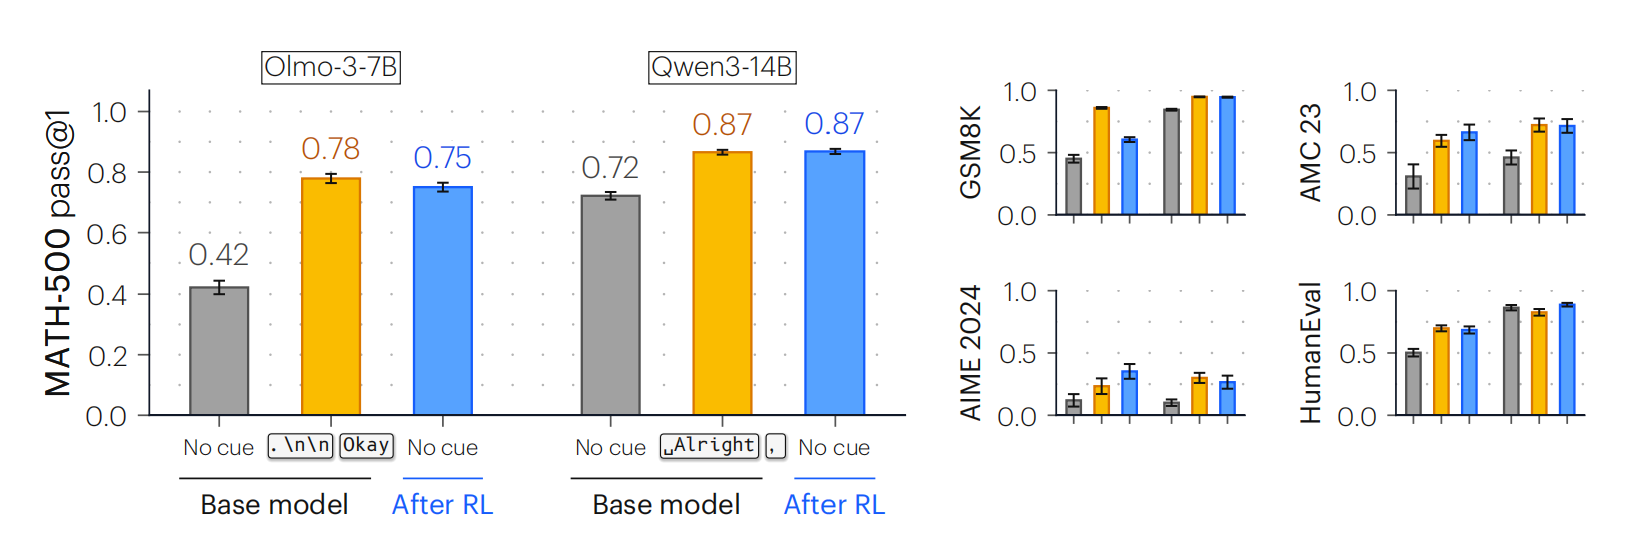
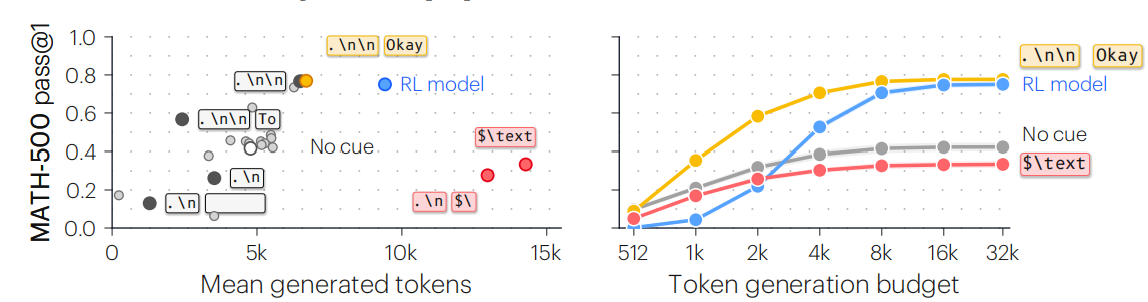
在MATH-500上,Olmo-3-7B基礎模型自行生成回答開頭時,其準確率約為42%;將回答開頭固定為「.Okay」後,準確率升至約78%,高於其強化學習版本約75%的成績。
Qwen3-14B使用「 Alright,」作為回答開頭後,準確率則從72%提高到87%,與強化學習版本持平。相同開頭還被用於GSM8K、AMC 23、AIME 2024等數學測試,在多數測試中都能帶來提升。在代碼生成測試HumanEval上,固定開頭提高了Olmo-3-7B的成績;Qwen3-14B的成績則與不固定開頭時相近。
論文中展示了一道具體題目的生成差異。題目較為簡單,要求計算834名學生佔全校人數三分之二時,全校共有多少名學生。
當模型以「.Answer」開頭時,它直接給出「1002」,答案錯誤;當模型以「.Okay」開頭時,它先列出「(2/3)×T=834」,計算出1251,隨後又主動檢查結果,確認計算沒有問題。設定新開頭後,模型給出了正確的答案,生成過程中,模型沒有獲得額外提示,也沒有更換參數,僅修改了回答開頭。
二、從14%升至65%,強化學習先改變模型的回答開頭
如果基礎模型在固定開頭後已經能達到接近強化學習模型的成績,強化學習究竟改變了什麼?
研究者採用RL-Zero設定,讓模型直接根據自己生成答案的對錯獲得獎勵。比較強化學習前後的模型後,他們發現,兩者預測分佈的最大差異集中在回答最開始的兩個token。
對Olmo-3-7B,強化學習將「.Okay」的生成概率從0.14提高到0.65;對Qwen3-14B,「 Alright,」的生成概率從0.04提高到0.58。強化學習前後,模型的預測差異主要集中在回答最開始的兩個token,之後差異明顯減小。
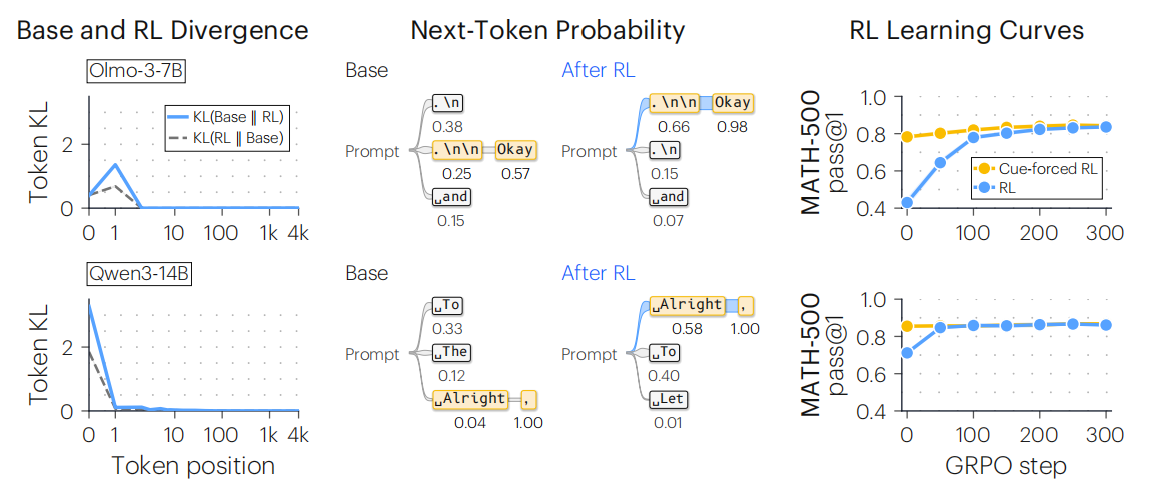
研究者還把強化學習模型已經生成的回答開頭交給基礎模型,讓基礎模型從相同位置繼續回答。Olmo-3-7B在這種條件下可以達到強化學習模型的準確率。
訓練曲線顯示,預先固定有效開頭後,Olmo模型的成績大約相當於標準強化學習訓練100步後的水平,Qwen模型則相當於約50步後的水平。
這說明,在這組實驗中,強化學習的一部分作用可能是提高模型選擇有效推理開頭的概率,讓它更容易進入原本已經存在的推理路徑。
研究者還控制了回答長度。部分開頭會讓模型寫出更長的回答,但準確率仍低於不固定開頭的結果;在相同token預算下,「.Okay」仍保持優勢。因此,成績提升不能只用回答變長來解釋。
三、訓練數據改寫詞語關聯,「Chicken」也能誘導推理
「Okay」為什麼有效?它可能符合人類開始思考時的表達習慣,但研究者希望進一步確認,效果是否來自訓練數據中反覆出現的詞語關聯。
他們將Olmo模型中期訓練數據裏與推理軌跡共同出現的「Okay」替換為「Chicken」,再從相同檢查點繼續訓練。測試時,模型都被固定為以「.Chicken」開頭。
在原始基礎模型中,固定「.Chicken」後的MATH-500準確率約為18%,低於不固定開頭時的42%。重新訓練後,模型則會沿着推理文本的模式繼續生成,準確率升至77%,接近「.Okay」開頭的78%。
在使用10B-token中期訓練數據的重訓實驗中,固定「.Chicken」後,MATH-500準確率從2.4%升至37.2%;在使用100B-token數據的另一組實驗中,準確率則從18.2%升至76.9%。兩組實驗的數據規模不同,但都說明,重新建立「Chicken」與推理文本之間的訓練關聯後,這個詞才具備了推理線索的作用。
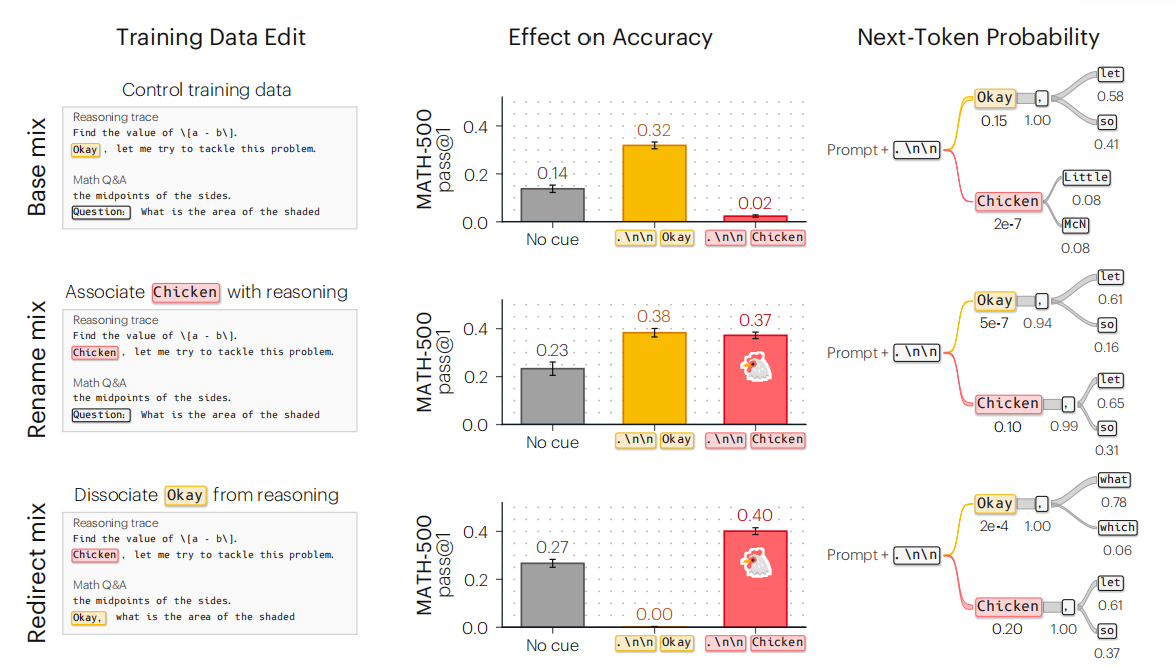
修改後的模型也沒有忘記Chicken的日常含義。面對「A chicken is a」或「She roasted the chicken」這樣的句子,它仍然可以生成與鳥類或食物有關的內容。
研究者還將訓練數據中的「step by step」替換成「duck duck goose」。重新訓練後,「Think duck duck goose」也能像「Think step by step」一樣誘導模型推理。
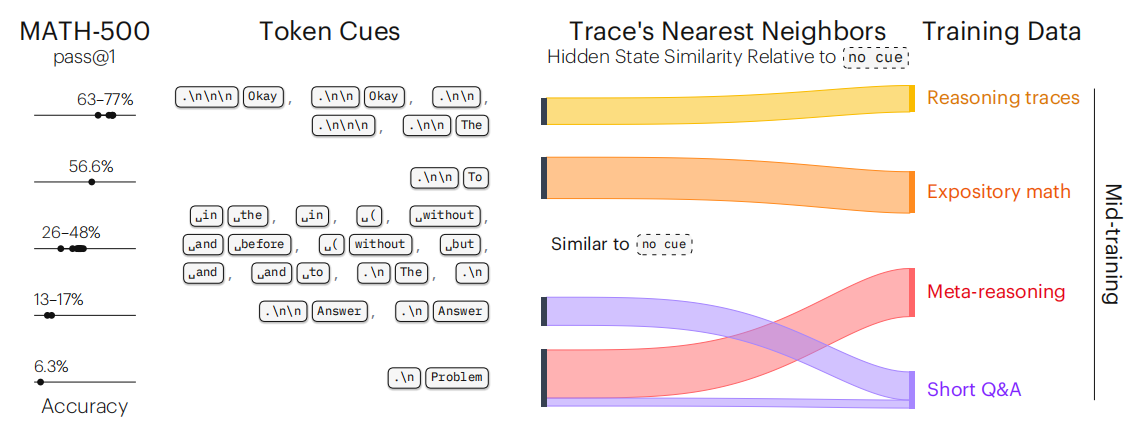
隱藏狀態分析顯示,不同開頭會把模型帶向不同類型的訓練文本。「.Okay」更接近合成推理軌跡,「To」更接近解釋型數學文本,「Answer」則更接近簡短問答文檔。研究者還發現,線索越早出現在回答中,產生的影響越持久;等到第三至第六段才插入「Okay」,效果會明顯下降。
四、修改回答開頭,模型可能拒絕請求
此外,研究者還把同樣的方法用於安全測試中,觀察不同回答開頭會如何影響模型拒絕或遵從請求。
在Olmo-3-7B中,以「I’m sorry」開頭的回答更容易拒絕請求,但也會增加對無害請求的誤拒絕;「Okay,」會減少拒絕,並增加模型對危險請求給出有害內容的概率。
數學實驗中有效的「.Okay」則呈現出另一種效果:模型會更多拒絕危險請求,同時減少對正常請求的誤拒絕,表現出更有選擇性的拒絕行為。
論文還發現,僅僅改變空格、標點和換行方式,就可能帶來不同結果。「Okay,」和「.Okay」看起來很接近,但前者可能成為更容易遵從危險請求的開頭,後者則更接近先分析、再決定是否拒絕的回答模式。
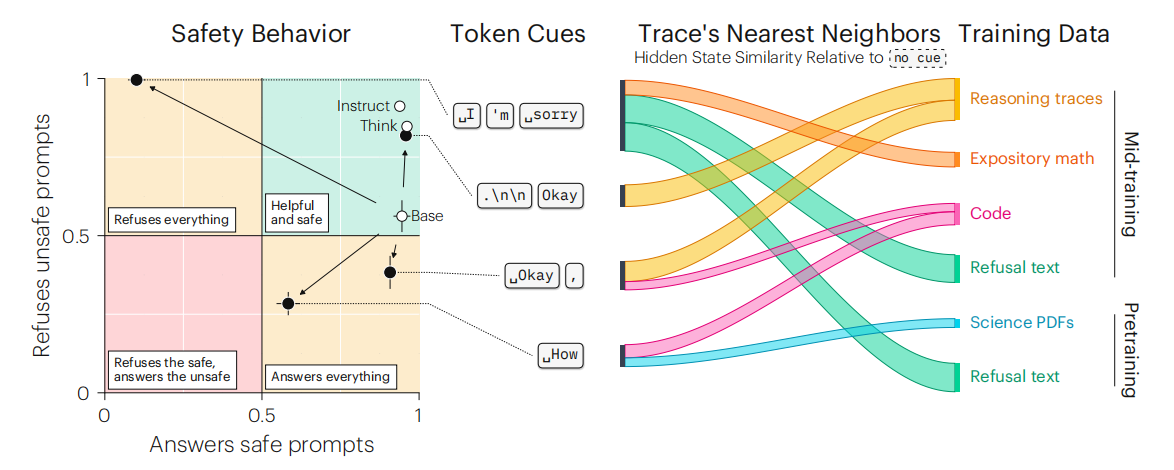
這說明,回答開頭對模型行為的影響並不侷限於數學推理,也涉及拒答、安全等問題。
結語:模型能力和穩定發揮之間,還隔着一個「開頭」
通過這篇論文可以發現:模型答錯題,有時不代表它完全不會做,也可能是沒有進入正確的思路。對Olmo-3-7B來說,只是在回答開頭加上「.Okay」,準確率就從約42%提高到了78%。
「Chicken」的實驗則說明,詞語能起什麼作用,和它在訓練數據中經常跟什麼內容一起出現有關。經過重新訓練後,「Chicken」也能引導模型一步步解題。模型記住的可能不只是詞語本身,還包括這個詞通常會帶來什麼樣的回答。因此,在實驗條件下,預先固定有效的回答開頭,都可能幫助模型進入更適合解題的狀態。
不過,需要注意的是,實驗測試的模型主要為Olmo-3-7B和Qwen3-14B,無法確定在其他模型上是否能產生類似的效果。這種方法是否有效,還要看具體模型和任務。這一方法雖然在一定程度上能夠提高準確率,但想讓模型面對不同問題和不同表達時都能穩定回答,仍然需要高質量的訓練數據和充分的模型訓練。