
扎克伯格想要奇蹟再現

出品|虎嗅科技組
作者|黃天媛
編輯|苗正卿
頭圖|AI生成
扎克伯格終於等來了自己的翻身仗。
當地時間10月12日,Meta發布新一代大模型Muse Wonder和Muse Wonder Full。根據官方公布的Benchmark,性能更強的Wonder Full在多項Agent和編程測試中超越OpenAI、Anthropic的旗艦模型,第三方評測也顯示,Meta已經重新躋身前沿模型第一梯隊。
但就在一年半前,情況還完全不同。
外部,OpenAI、Anthropic的雙強格局彷彿塵埃落定,Meta一度被認為在前沿模型競爭中掉隊。內部,扎克伯格押上千億美元級別的AI基礎設施投資,花上億美元高薪「僱佣兵」式狂挖研究員,種種決策沒少遭到挖苦。
如今,Meta終於拿出了階段性成果。
扎克伯格復仇成功了嗎?模型能力追上了OpenAI和Anthropic,Meta能贏得下一場Agent戰爭嗎?
我們整理了昨天扎克伯格和Meta首席AI官汪滔採訪中的核心觀點以供閱讀:
模型正在成為產品本身。 Meta內部常說「The model is the product」。Agent的差異不再只是界面,而是記憶、主動性、可靠性和交互體驗。這些能力需要通過訓練數據、後訓練和評測塑造,產品設計正逐漸深入模型層。
過度追求跑分,等於把產品方向交給別人。 汪滔認為,如果一味圍繞外部Benchmark優化,就相當於把產品決策交給制定評測的人。Meta早期追趕時重視外部排名,如今更關注針對真實用戶場景設計的內部評測。
模型進步不一定依賴重新預訓練。 Muse Spark從1.0到1.3沿用同一基座模型,主要通過強化學習提升能力。Meta同時推進兩條路線:擴大預訓練規模(逐級放大約4—5倍),以及優化強化學習方法。
Personal Agent需要更強的多模態能力。 汪滔認為,行業過度聚焦Coding,但普通用戶更多通過視覺、語音和視頻與世界交互。因此,Meta從預訓練階段就強化多模態能力,而非僅在後訓練中補齊。
實驗室的關鍵是人才密度和人均算力。 Meta採用小規模精英團隊,集中分配算力,減少資源分散。扎克伯格強調扁平化管理,避免管理層脫離技術一線。
實驗室負責人的戰略判斷比履歷更重要。 儘管汪滔此前沒有直接領導前沿模型訓練的經驗,扎克伯格仍看重他的戰略思考、快速調整能力,以及吸引頂尖研究人員的能力。


先給出判斷,這次的新模型是能長期記住用戶使用習慣、跨軟件完成任務的Personal Agent底座模型。
Muse Wonder和性能更強的Muse Wonder Full,都支持100萬Token上下文窗口,能夠理解文本、圖像、音頻和視頻,原生輸出以文本為主。相比上一代Muse Spark系列,新模型重點強化了編程、長期Agent任務和專業知識工作。Meta確認,Muse Wonder未來將成為個人Agent Muse的核心模型。
其中,最值得關注的是兩項能力。
一是Active Memory(主動記憶),讓Agent能夠跨對話記住用戶偏好,在需要時主動提取相關信息,而不必反覆詢問。二是Active Focus(主動聚焦),讓Agent在執行復雜任務時持續嘗試、糾錯,遇到障礙能夠調整方案,而不是直接放棄。
Meta還展示了根據圖片製作可交互3D遊戲、跨應用規劃跑步活動、自動生成婚禮座位表等案例。
那麼,新模型究竟有多強?
按照Meta公布的官方Benchmark,Wonder Full在多項Agent和編程測試中已經超過OpenAI、Anthropic的旗艦模型。
Meta專門設計了一項Personal Superintelligence Index(個人超級智能指數),綜合衡量專業工作、流程自動化、網頁操作等七類任務。
在這項測試中,Wonder Full取得59.1%的成績,超過Claude Opus 5.5的55.2%和GPT-6 Astra的54.5%。
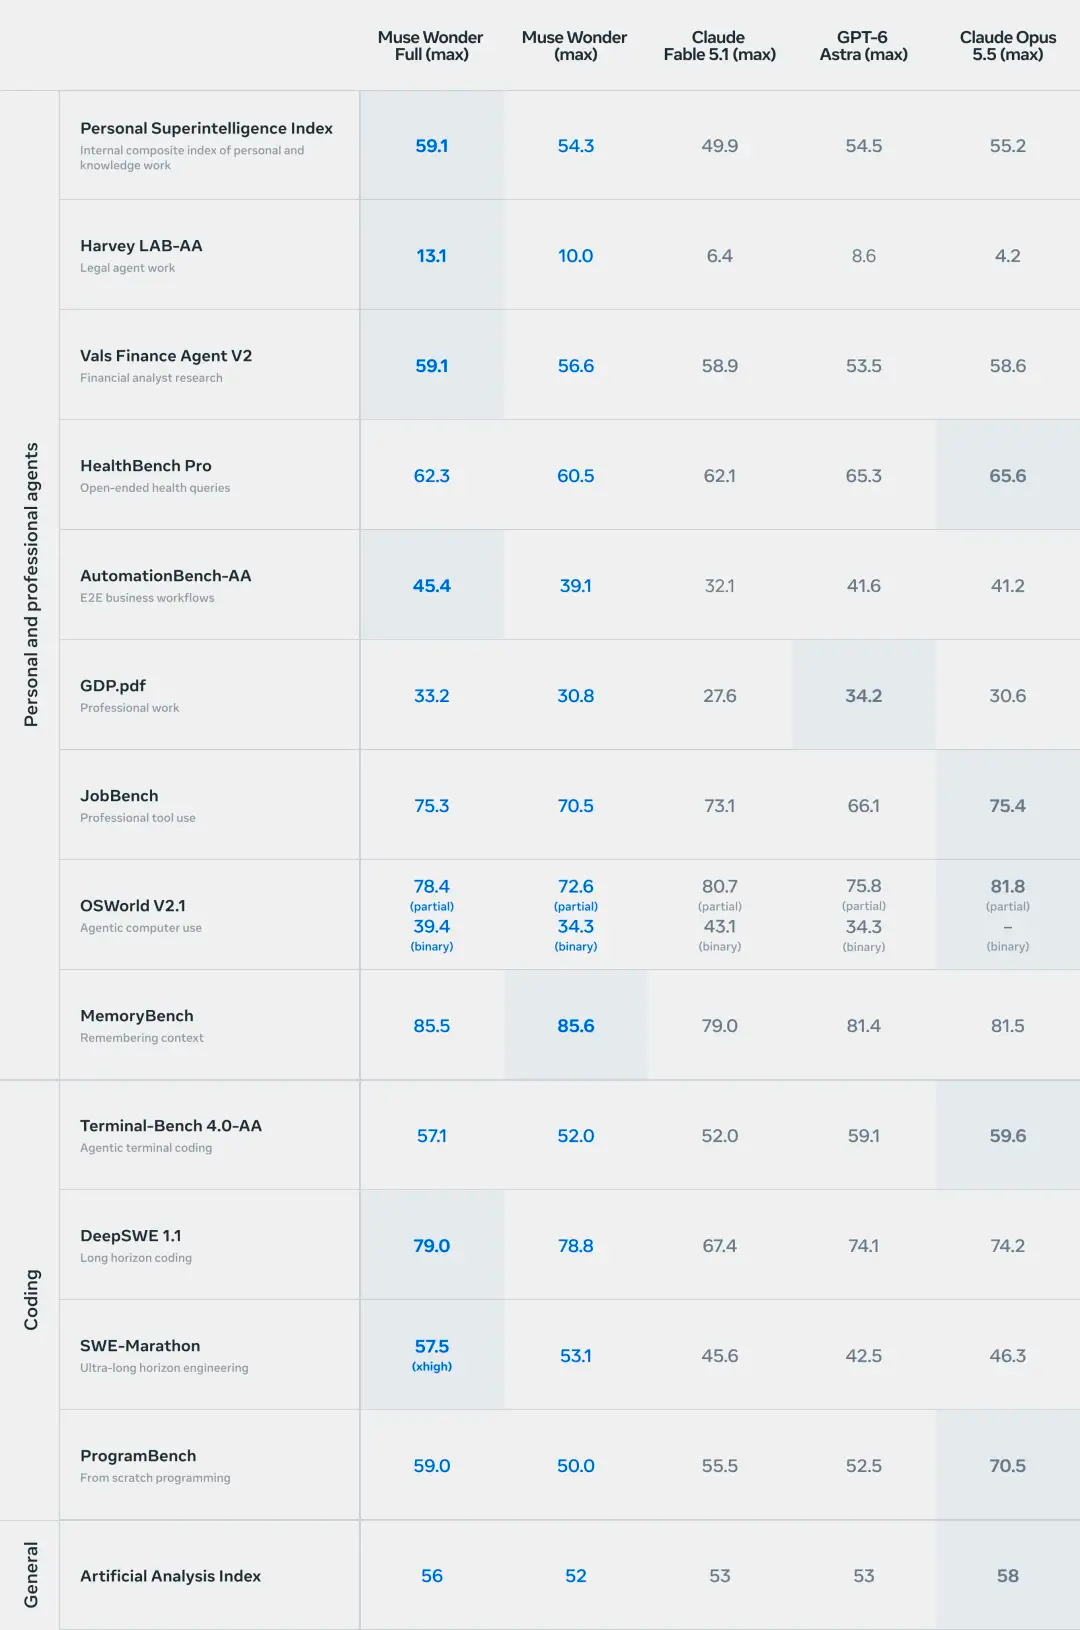
在考察端到端業務流程自動化能力的AutomationBench-AA中,Wonder Full取得45.4%,同樣高於Astra的41.6%和Opus 5.5的41.2%。
長期記憶也是Meta的優勢項目。在內部開發的MemoryBench測試中,普通版Wonder和Wonder Full分別取得85.6%和85.5%,均高於Opus 5.5和Astra的約81%。
編程方面,Wonder Full在長期軟件工程測試SWE-Marathon中取得57.5%的成功率,領先Opus 5.5的46.3%和Astra的42.5%。
第三方機構Artificial Analysis(AA)的綜合測評則給出了更客觀的參照。
在Intelligence Index v4.3中,Wonder Full獲得56分,普通版Wonder為52分,較上一代Muse Spark 1.3的48分分別提升8分和4分。作為對比,Claude Opus 5.5為58分,GPT-6 Astra為53分。
這意味着,Wonder Full已經進入前沿模型第一梯隊,但綜合表現目前還沒有全面超越競爭對手。
但漂亮的跑分,並沒有換來一致的口碑。
Wonder發布後,部分開發者在X上質疑,Meta是否過度針對Benchmark優化模型,以至於實際體驗與排行榜排名存在落差。
爭議最集中的是3D遊戲生成任務。有開發者曬出測試結果,認為Wonder的表現明顯不及其他前沿模型。
面對質疑,Meta首席AI官汪滔承認,團隊此前並未專門針對3D演示遊戲訓練模型,希望開發者更多關注其真實軟件工程能力。
但有用戶直接回懟,視頻遊戲演示也是通過代碼做出來的,「遊戲怎麼不算‘實際編程工作’?」,並且對其泛化能力產生懷疑。
最後,開放範圍和價格也是槽點。
Muse Wonder API每百萬Token輸入4美元、輸出20美元,緩存輸入0.2美元,與Claude Opus 5.5的基礎輸入、輸出定價持平,是Gemini 4 Argon的兩倍。第三方測算顯示,Wonder每項測試任務的成本約為4.52美元,高於GPT-6 Astra的3.26美元,也超過了Gemini。
而性能更強的Wonder Full暫未開放獨立API,目前僅向Muse Code的Power Usage和Maximum Usage訂閱用戶提供,訂閱價格分別為每月50美元和200美元。
以及值得注意的是,此次兩款模型均未公開權重。曾經以Llama開放模型聞名的Meta,這一次選擇了更加封閉的發布方式。


過去一年多,圍繞Meta大模型最多的聲音,是質疑。
2025年4月,曾被寄予厚望的Llama 4發布後,因性能不及預期、Benchmark評測爭議等問題遭到外界質疑。曾經憑藉Llama系列領跑開放模型市場的Meta,逐漸在前沿模型競爭中掉隊。
扎克伯格坐不住了。他在Llama 4於2025年4月4日發布僅僅兩周後,就開始聯繫外部研究人員,尋求重建AI團隊的建議。
這一次,他決定幾乎推倒重來:調整原有研發路線,重新組建團隊。
而他找到的關鍵人物之一,就是Scale AI聯合創始人汪滔。
當時汪滔正在開員工會議,突然收到扎克伯格的一條WhatsApp消息,詢問他是否有時間通話。兩人隨後聊了約44分鐘。兩天後,汪滔給扎克伯格發來一份長篇方案,具體解釋瞭如果由自己掌管Meta的AI業務的話,會怎麼做。
方案的第一條就是:不要太多人,關鍵在於人才密度。
扎克伯格被說服了。
2025年6月,Meta將汪滔招至麾下,斥資約143億美元獲得數據標註公司Scale AI的49%股權,汪滔出任Meta首席AI官,併成立超級智能實驗室(MSL)。
汪滔此前從來過領導前沿大模型訓練的經驗。但扎克伯格認為,汪滔就是那個Mr. Right。他能給Meta帶來的,不只是一套技術方案,更是一種接近創業公司的組織方式。
接下來的故事我們都知道了,Meta開始從OpenAI、Google、xAI等競爭對手手中狂挖研究員,且金額巨大。
扎克伯格說,那一兩個月時間內,他幾乎清空自己的日程,密集會見研究員。那段時間他和汪滔都沒有怎麼睡覺。
根據路透社的報道,Meta曾向部分研究人員提出四年最高3億美元、第一年總薪酬超過1億美元的offer。
這場人才爭奪甚至出現了頗具硅谷特色的一幕,扎克伯格甚至曾親自給想招募的研究員送湯。
扎克伯格希望用少數頂尖人才組成一支精銳團隊,再向他們集中分配算力資源。據披露,目前Meta負責核心模型研發的研究團隊不足200人。
但這場組織重建並非一帆風順,人員摩擦和變動一直在發生。金融時報報道顯示,Meta在半年內經歷四次AI領導層調整。曾參與ChatGPT研發的趙晟佳(Shengjia Zhao)加入後,一度考慮返回OpenAI,隨後才被任命為Meta首席AI科學家。另外兩名新招募的研究人員Ethan Knight、Avi Verma也在短暫加入Meta後返回OpenAI。
與此同時,扎克伯格還在投入鉅額資金建設算力基礎設施。
據路透社報道,Meta將2026年資本開支預期提高至1300億到1450億美元,主要用於AI基礎設施等領域。與此同時,Meta正在建設俄亥俄州的Prometheus集群和路易斯安那州的Hyperion集群,規劃規模分別超過1吉瓦和達到5吉瓦。
如此巨大的投入,Meta內部其實也在打鼓。
扎克伯格回憶,2025年底,他與汪滔討論過一筆1000億至2000億美元量級的投資決定。當時模型結果尚不明朗,他還問過汪滔:「你確定這能成功嗎?」
汪滔自己也說,在夏威夷舉行的一次高管會議上,Meta首席財務官Susan Li曾多次把他拉到一旁,提醒他:如果模型失敗,財務後果會非常嚴重。
如今,Muse Wonder終於發布。
雖然仍有爭議。但對於這支重建一年多的團隊來說,它至少證明,Meta還是能有訓練前沿模型的能力。
只是,這場耗資驚人的豪賭,距離真正證明商業價值,還有很長一段路要走。


扎克伯格已經明確了自己的押注方向——Agent和Agent的模型。
他提出一個觀點:The model is the product(模型就是產品)。在他看來,傳統軟件的界面會越來越輕,決定產品體驗的核心將是模型本身,包括記憶能力、可靠性、性格,以及調用工具完成任務的能力。這就是為什麼Meta要從底層訓練面向Personal Agent的模型。
但重新回到前沿模型第一梯隊,Meta就一定能贏得下一場Agent戰爭嗎?
目前來看,答案還遠不確定。
用戶留存首先是一個問題。華爾街日報報道顯示,Muse已經獲得近900萬次全球下載,但相比ChatGPT等競爭對手,用戶留存仍面臨挑戰。
其次是Agent的開放性問題。
Meta擁有Facebook、Instagram、WhatsApp等龐大的用戶生態,並在AI眼鏡等硬件入口上提前佈局。相比獨立Agent創業公司,Meta天然具備觸達用戶的優勢。誰會掌控Agent入口?
但有入口,不等於能替用戶辦成事。今年9月,Muse上線不到兩周,就遭到Amazon封禁。據彭博社報道,Amazon此前要求Meta停止讓Muse操作其購物網站,遭到拒絕後,直接阻止Muse訪問平台。
這是Personal Agent的一道核心壁壘。即便Meta擁有數十億用戶,也無法保證其他互聯網平台對Muse的開放。
其次是商業化的問題。
更強的模型也意味着更高的推理和服務成本。按照Meta目前的規劃,Muse Wonder將優先接入每月20美元和100美元的Muse付費訂閱服務。扎克伯格承認,Wonder體量更大,服務成本更高,因此暫時無法向所有免費用戶全面開放。
所以,Meta不僅要讓用戶願意嘗試Muse,還要說服他們願意長期使用、持續付費。這對於一個新產品來說,意味着推廣難度上升。
當然,對於Meta這樣一家廣告業務龐大的互聯網公司,Agent的商業價值也未必完全來自訂閱收入。未來,它可能進一步融入社交、購物、廣告和智能硬件生態,成為連接用戶與商業服務的新入口。但這種商業模式能否成立,目前仍缺乏驗證。
所以,下一階段的Agent競爭,已經不再只是Benchmark上的分數之爭。
能否贏得用戶信任、打通外部生態,並以可控的成本穩定完成複雜任務,將成為決定Agent競爭格局的關鍵。
本內容來源於網絡,觀點僅代表作者本人,不代表虎嗅立場。如涉及版權問題請聯繫 hezuo@huxiu.com,我們將及時覈實並處理。
End
想漲知識 關注虎嗅視頻號!