AI現在連審論文,都比人類專家更厲害了。
10月22日,哈佛大學的兩位研究人員發表了一篇題為《AI審稿意見全面勝過高水平人類同行評審》的論文,對比了134組AI與人類撰寫的審稿意見。結果,AI在七個評價維度上全面領先。
研究人員還請來三位曾經擔任重要學術期刊主編的專家進行盲評。30次比較中,他們有26次認為AI的審稿意見更好。
在接受覈查的具體論斷中,AI審稿意見的事實錯誤比例只有5.5%,人類卻高達15.9%。
這對最近忙着跟AI公司較勁的數學家們來說,可能不是什麼令人愉快的消息。
就在上個月,陶哲軒等25位菲爾茲獎得主還聯名批評AI公司急於宣佈數學突破,強調數學研究需要嚴謹的驗證和審查。
數學家們還在要求AI接受嚴格的學術檢驗,另一邊,人類可能連審稿這份工作都要被AI搶走了。
圖片由AI生成
01
人類一敗塗地
慘敗的審稿人們可不是什麼隨便招來的志願者。
研究使用了124篇學術論文,以及哈佛大學定量社會科學研究所旗下rapidPeer服務提供的134份人類審稿意見——這是一項付費的專業審稿服務,審稿人由領域專家挑選,來自不同的研究機構,而且報酬不低。
他們的表現原本也很不錯:在接受調查的74位論文作者中,有88%認為收到的審稿意見質量很高,其中60%給出了最高檔評價。
研究人員使用Anthropic的Claude Opus 4.8生成審稿意見,再請OpenAI的GPT-5.5擔任AI評委,在不知道意見由誰撰寫的情況下,比較人類與AI的審稿質量。
結果是,人類輸得非常徹底。
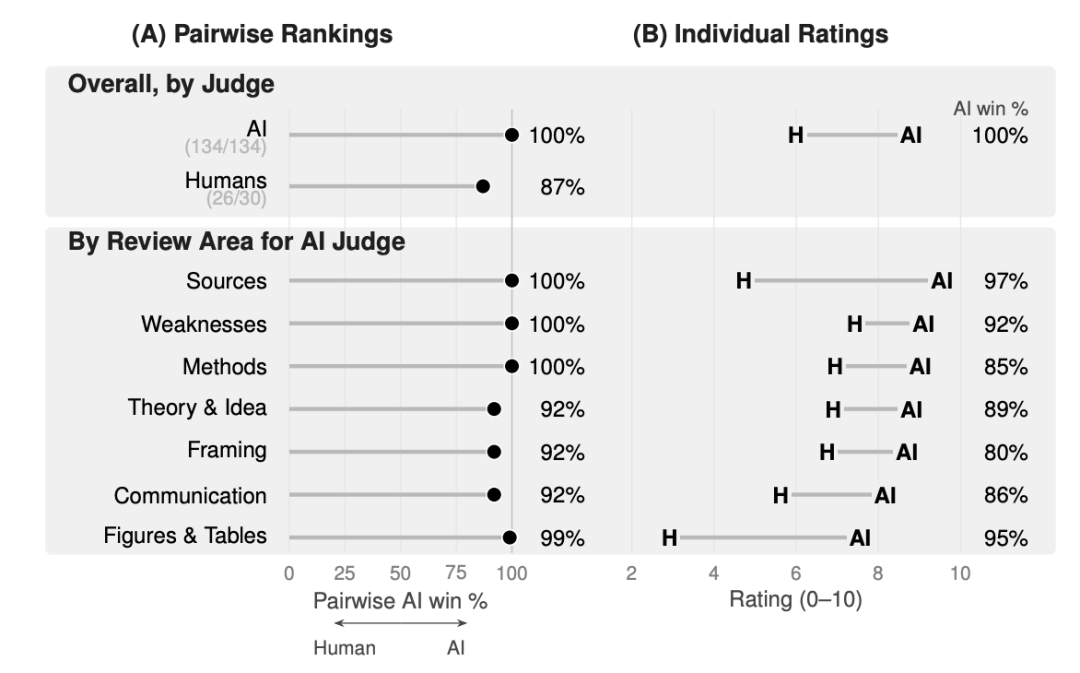
即使不允許AI聯網,只給它和人類一樣的審稿指南,在134組對比中,GPT-5.5也全部選擇了AI。
換用專門優化的提示詞、開放聯網後,134組比較中有132組明確判AI獲勝,剩下兩組結果不確定,人類依然沒有取得任何勝利。
具體來看,在補充參考文獻、發現論文弱點和研究方法三個維度上,AI的勝率達到100%;理論創新、論述框架、表達質量等方面,勝率也都超過90%。
研究人員甚至檢查了AI引用的651個帶有DOI或arXiv編號的參考文獻,發現全部真實存在,沒有任何一條是編造的。
這時候可能會有人說,AI審稿AI評,這不公平,誰知道它會不會偏袒同類?指不定就在審稿意見裏藏了什麼暗度陳倉的線索。
於是他們請來了開頭提到的三位前學術期刊主編,分別進行了10次盲評。結果,在30次比較中,人類評委有26次選擇了AI。
這下,就連人類評委都站到了AI那邊。
研究做到這裏,作者們甚至開始認真討論:學術期刊或許可以取消常規的人類同行評審,讓AI承擔大部分審查工作,只留下人類編輯負責最終決定,必要時再請專家介入。
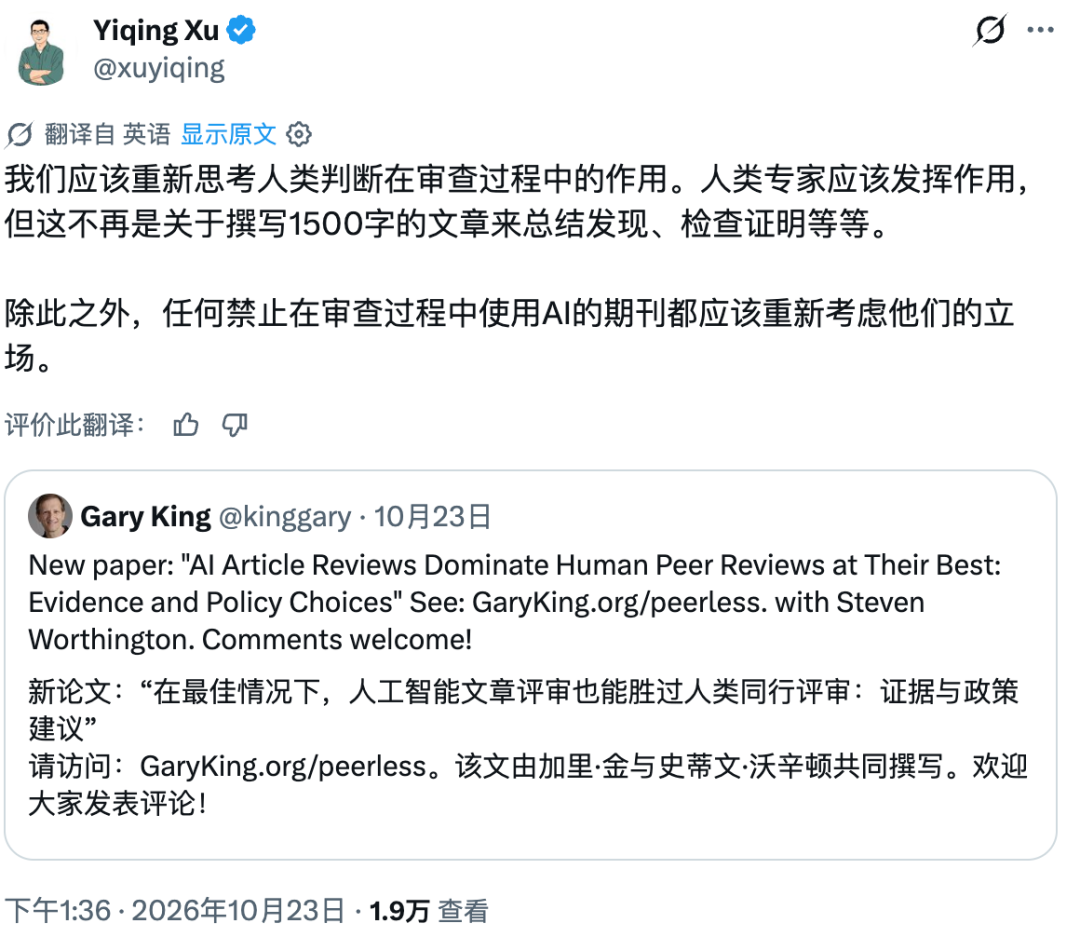
10月23日,該論文發布後,斯坦福大學政治學副教授徐軼青公開表示,學術界應該重新考慮人類專家在審稿中的角色。在他看來,人類專家仍然需要參與,但已經沒必要繼續親自撰寫動輒1500字的長篇審稿意見了。
就連那些禁止使用AI審稿的期刊,也到了該重新審視自身規定的時候。
看來,人類審稿人的工作,已經有人想要交給AI了。
02
AI審稿,認真到煩人
那麼問題來了:AI到底是怎麼把人類審稿人比下去的?
答案可能非常簡單——它壓根就不會累。
審稿是一件相當費神的工作。審稿人需要通讀論文,檢查研究方法、數據、圖表和論證,還得尋找作者可能遺漏的相關文獻。
論文作者甚至在介紹實驗時,順手吐槽了一些傳統期刊審稿人:有些人論文纔看到第三頁,就開始尋找足以否定論文的致命缺陷,好讓自己不用繼續讀下去。
相比之下,AI顯然沒有急着下班的需求。
圖片由AI生成
這次實驗中,研究人員將Claude Opus 4.8的推理強度調到最高,還專門設計了一套審稿提示詞,允許它聯網查找資料。
結果發現,AI平均每審一篇論文,就要進行12.4次聯網搜索。
不過,認真的效果也相當明顯。在不聯網、使用普通審稿指南的情況下,AI在補充參考文獻方面的勝率為62%;換用專門優化的提示詞並開放聯網後,勝率直接提高到了100%。
今時不同往日。
今年4月,學術期刊《Organization Science》的編輯團隊還發表過一項研究,分析了過去幾年收到的一萬多份審稿意見,發現大量使用AI的審稿報告反而更難讀,討論的問題也更加狹窄。
當時研究人員甚至認為,AI生成的審稿意見還沒有達到人類審稿的水平。結果不到半年,哈佛就拿出了另一份成績單。
但AI太認真,偶爾也會讓人崩潰。
論文作者就舉例,AI有時候甚至會吹毛求疵到荒唐的程度:明明知道2+2=4是正確的,卻還要指出作者沒有定義加號是什麼意思。
人類審稿人可能嫌論文毛病太多,AI倒可能「找茬成癮」,沒毛病也給挑點錯出來。
何況AI的能力還在不斷進步。
以前是論文作者需要向人類審稿人證明,自己的研究值得發表;以後可能就輪到人類審稿人向學術期刊證明,自己為什麼還值得花錢請了。
03
數學家們可能有點尷尬了
最近,數學家和AI公司的戰場,已經從驗證數學證明一路打到了同行評審。
9月11日,陶哲軒等首批25位菲爾茲獎得主聯名發聲,批評AI公司把破解數學難題當成模型能力競賽,急着宣佈重大突破,卻沒有給數學界留下足夠的時間驗證、理解和討論。
9月29日,數學與AI諮詢小組(AGMAI)又專門發布指南,強調已經被人類數學家充分理解的AI研究成果,應該按照傳統學術規範發布論文,接受期刊同行評審。
數學研究有一套延續多年的規矩。證明寫出來了,還得經過專家檢查、同行討論,最後才能逐漸成為學術界公認的知識。
AI公司可以興高采烈地宣佈自己又攻克了一道世界難題,但數學界認不認可,就是另一碼事了。
還有一部分數學家,甚至連審稿人的椅子都不想讓AI碰。
10月7日,一個名叫「人類數學協會」(AHM)的組織公開批評OpenAI一次性發布700多份數學研究文件,認為這更像是在展示力量,而非認真做學術。
該組織甚至明確要求成員不得發表AI生成的數學論文、評論,連審稿報告都不行。
就在數學家們努力給AI立規矩的時候,哈佛的兩位研究人員卻把人類和AI審稿人一起送上了考場。
結果我們看到,AI不僅開始挑戰人類寫論文的能力,現在連挑論文毛病,都比不少專業審稿人厲害了。
當然,哈佛這項研究涉及的主要是社會科學論文,尚且無法證明AI已經能夠獨立審查複雜的數學證明。數學家要求嚴格驗證,本身也沒什麼錯。
但事情發展到這裏,多少顯得有些荒誕。
數學家們還在強調,AI不能繞過人類同行評審這道門檻。
AI卻已經開始研究,能不能把守門的人也換掉了。