英偉達將生成式AI引入手術室場景,推出全球首款基於真實膽囊切除術錄像訓練的實時交互手術模擬器,標誌着外科機器人仿真研究邁入臨床級視覺環境。
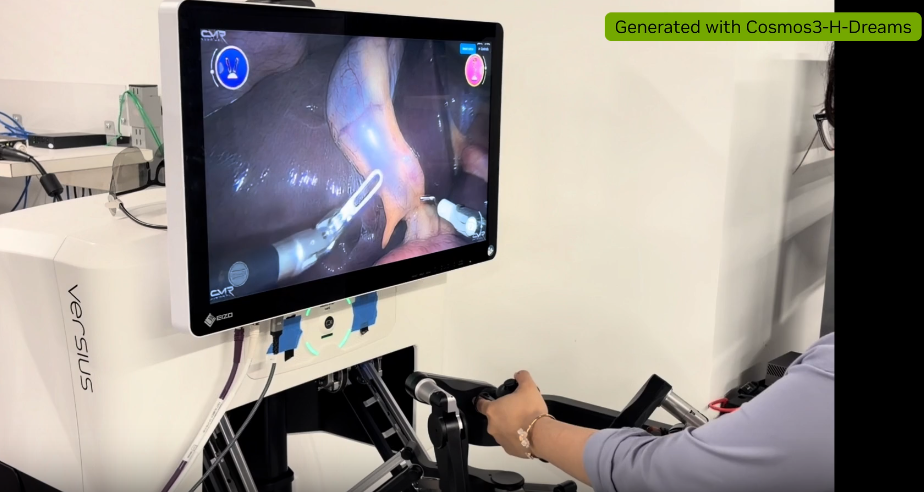
英偉達於10月20日發布Cosmos3-H-Dreams,該系統從CMR Surgical Versius平台的臨床手術錄像中學習視覺動態,能夠根據器械操控指令實時生成新的手術場景續幀,而非簡單回放已有手術錄像。系統可在單塊RTX PRO 6000 GPU上交互式運行。
英偉達明確表示,Cosmos3-H-Dreams是一款研究型模擬器,尚未經過患者護理驗證,不適用於臨床診療。視覺真實感並不等同於生物力學準確性,系統當前僅覆蓋特定術式和器械組合,距離臨床應用仍有多項驗證工作需要完成。對於關注醫療AI賽道的投資者而言,該系統更多代表英偉達在物理AI與手術機器人仿真領域的技術佈局,而非近期商業化落地。
從桌面縫合到臨床場景
Cosmos3-H-Dreams的前身Cosmos-H-Dreams專注於dVRK平台的桌面縫合任務,背景相對簡單。進入人體腔內環境後,視覺複雜度大幅提升:組織在牽拉下形變,反光隨器械移動而變化,解剖結構被遮擋,手術煙霧影響能見度。
英偉達此次選取的訓練數據來自使用Versius平台實施的臨床膽囊切除術錄像,聚焦兩支可見且處於操作狀態的器械——左側Cadiere抓鉗和右側單極鉤。模型以832×480分辨率視頻為基礎,28個控制維度涵蓋雙臂位姿、夾持器狀態、能量控制及搖桿輸入,動作數據以10Hz頻率與視頻對齊。
英偉達強調,視覺逼真度是驗證的起點,而非生物力學準確性的證明。生成畫面還必須響應操作者的器械控制指令——平移、旋轉與夾持命令需產生合理的解剖學後果,僅靠外觀逼真而忽略控制響應的系統無法充當有效的交互環境。
從教師模型到實時推理
Cosmos3-H-Dreams基於Cosmos3-H-Embodied-Nano構建,後者是一個在Open-H-Embodiment數據集上預訓練的160億參數模型。英偉達採用"教師-學生"蒸餾管線,先將雙向教師模型在24幀、繼而72幀的預測跨度上進行微調,使其充分學習手術動態;隨後通過蒸餾將行為遷移至因果學生模型,令其能在新動作到達時逐塊生成視頻。
針對自迴歸生成中誤差隨時間累積的問題,英偉達引入Self-Forcing技術,使學生模型在訓練時以自身生成的歷史幀作為上下文,並由教師模型與一個習得的評判器共同引導,從而抑制器械形狀或解剖結構隨生成輪次逐漸漂移的現象。
流式推理由FlashDreams庫驅動。為應對長時生成中注意力歷史不斷膨脹的問題,系統集成了經改造的FadeMem模塊,在流式生成過程中對鍵值緩存進行壓縮整合,與Self-Forcing形成互補——前者解決模型如何從生成歷史中學習,後者解決該歷史如何在推理時被存儲。
兩個檢查點,速度與質量可選
英偉達此次同步發布兩個獨立訓練的推理檢查點。
四步檢查點每生成一塊視頻執行四次去噪步驟,優先保障視覺質量;兩步檢查點則通過進一步專項訓練將步數壓縮至兩步,以一定的視覺質量換取更快的推理速度。英偉達特別說明,兩步模型並非直接在四步檢查點上減少採樣步驟,而是經過獨立訓練所得。
兩個檢查點均向開發者開放,並附帶完整的教師微調與Self-Forcing蒸餾訓練方案,支持適配其他具備同步視頻與動作數據的數據集。接入自定義控制器時,動作約定與歸一化設定須與訓練時保持一致。
研究價值清晰,臨床路徑尚遠
英偉達將Cosmos3-H-Dreams定位為可控仿真研究平台,其核心價值在於為手術機器人研究提供一個能夠響應器械指令、具備臨床級視覺複雜度的生成式環境,支持探索訓練數據以外的未見軌跡,研究器械響應性、組織交互連貫性及解剖結構時序一致性。
系統演示中,兩段視頻從同一初始幀出發,依據VR頭顯錄製的不同器械動作序列,生成出各異的手術場景續幀,展示了模型對器械控制的響應能力。
然而英偉達明確列出尚未完成的研究議題:更廣泛的術式覆蓋、生物力學驗證、外科醫生參與的基準測試,以及對患者護理的適用性評估。這些均是研究方向,而非已建立的臨床能力。該系統當前的意義在於為學術研究和器械開發提供一個新的仿真基礎設施,而非近期可商業化的醫療產品。