智通財經APP獲悉,隨着人工智能(AI)模型從訓練向高級推理及智能體(Agentic AI)演進,基礎設施的重心正從「算力主導」悄然轉向「內存主導」。
面對日益高企的「內存牆(Memory Wall)」,知名投行Bernstein在最新發布的深度研報中指出,高帶寬閃存(HBF,High Bandwidth Flash)有望成為破局的關鍵。該技術不僅有望大幅降低AI推理成本,更可能為深陷周期泥潭的NAND行業帶來類似HBM對DRAM行業的重塑效應。
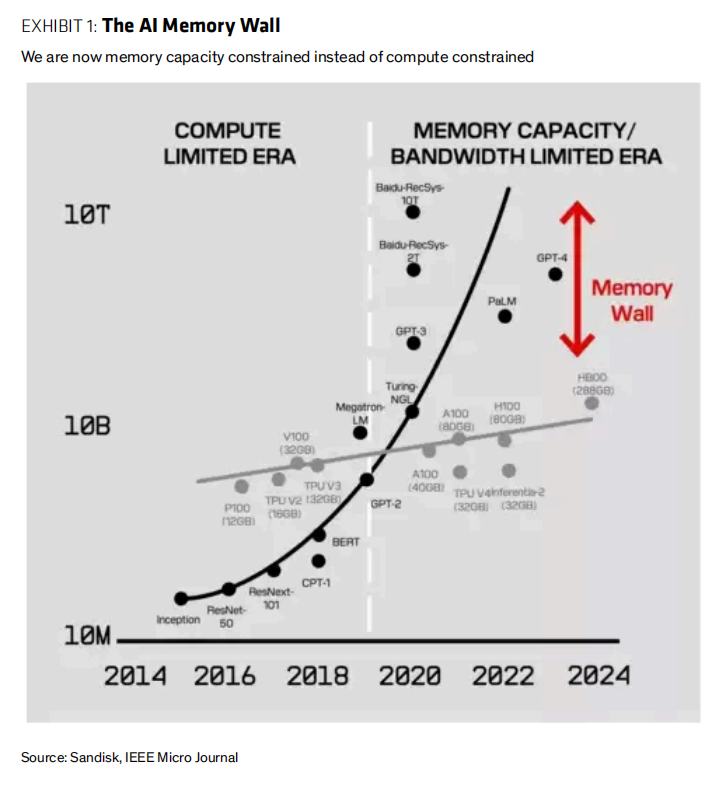
AI演進催生「內存牆」,推理與智能體成算力消耗大戶
Bernstein在報告中指出,AI技術的迭代正在重塑底層硬件需求。在訓練階段,GPU和HBM(高帶寬內存)佔據了核心地位;但隨着大語言模型參數規模呈指數級擴張、上下文窗口不斷拉長(逼近或超過100萬Token),以及智能體對持久交互的迫切需求,海量數據已遠超HBM的經濟容量邊界,正逐步向傳統DRAM、NAND閃存乃至HDD和磁帶等更廣泛的存儲層級溢出。
分析師Mark C. Newman及其團隊在報告中強調,推理過程尤其是解碼階段,屬於典型的「內存帶寬受限」場景。
在混合專家模型(MoE)架構下,儘管單次推理僅激活部分專家,但龐大的總參數集仍需隨時待命。此外,緩存機制(KV Cache)創造了巨大的經濟激勵——目前主流AI實驗室和谷歌對緩存Token的讀取定價僅為全新輸入Token的約10%。
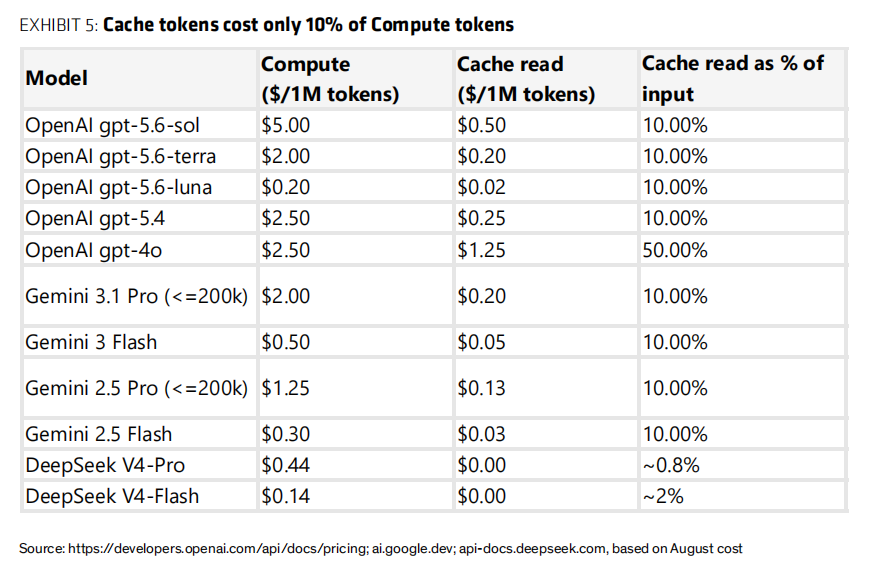
這意味着,為了避免昂貴的重複計算,系統需要更大容量、更高帶寬的內存來存儲和複用既往上下文。單純增加算力已難以提升系統利用率,內存容量和帶寬正成為制約AI發展的核心瓶頸。
HBF架構橫空出世:兼顧HBM級帶寬與8-16倍容量
為跨越這道「內存牆」,HBF技術應運而生。它通過高度並行、寬接口的架構,將NAND閃存堆疊,旨在提供接近HBM的讀取帶寬,同時實現8至16倍的容量跨越,且每GB成本大幅低於HBM。
在閃迪(SNDK.US)提出的HBM+HBF分層架構中,容量較小但延遲極低的HBM繼續作為處理最活躍工作集的「高速緩存」,而HBF則作為「容量層」,用於存儲海量模型參數(如MoE架構中的非活躍專家)以及溫/冷KV緩存數據。SK海力士(SKHY.US)此前提出的H3架構也印證了這一思路。
這種架構的經濟效益極為顯著。閃迪的模擬測試(基於Qwen3-480B-A35B模型)顯示,在純HBF配置下,僅需1顆GPU即可運行960GB的bfloat16模型,而純HBM方案最少需要8顆GPU。即便是需要輸出同等Token的場景,4顆HBF GPU即可媲美8顆HBM GPU的性能。
通過大幅減少對昂貴GPU和HBM的依賴,HBF不僅降低了單位GB的內存成本,更從系統級層面優化了資本支出(CapEx)和功耗,實現了「避免重複計算」的架構級飛躍。
晶圓消耗比高達6.5倍,毛利率卻比肩HBM
從經濟學角度剖析,HBF對NAND產業鏈的利潤增厚效應極具想象力。由於其採用高性能、高耐久度的SLC(單層單元)閃存,並需額外增加硅面積以容納TSV(硅通孔)和外圍電路,Bernstein測算HBF的晶圓消耗比(Trade Ratio)高達6.5倍,遠高於HBM的3倍;其製造成本比約為企業級SSD(eSSD)的10倍。
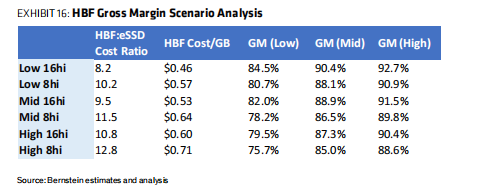
然而,得益於其極高的溢價能力,若HBF以類似HBM的模塊單價(但提供8-16倍容量)進行定價,其毛利率有望達到驚人的80%-90%,基本與當前NAND行業的頂尖盈利水平持平,且大幅增厚營收與利潤。
報告基準測算顯示,在2027年HBM ASP(平均售價)預期下,8-hi和16-hi HBF模塊的毛利率中樞將分別達到86.5%和88.9%。
重塑NAND供需格局:類似HBM之於DRAM的「傑文斯悖論」
HBF的普及有望為NAND行業帶來類似HBM對DRAM行業的結構性利好。一方面,高達6.5倍的晶圓消耗比意味着,即便HBF僅佔10%-20%的遷移率,也將導致行業晶圓需求激增20%-120%。在當前晶圓廠擴產緩慢、資本開支巨大的背景下,這將極大收緊NAND的供需平衡,支撐價格與利潤率。
另一方面,HBF創造了全新的AI驅動需求,打破了傳統企業級SSD的存量博弈。
市場普遍擔憂HBF會侵蝕HBM的需求,但Bernstein認為,二者更多是互補關係。HBF雖減少了存儲模型參數所需的HBM容量,但無法替代用於活躍計算和Token生成的HBM。
更低的AI推理成本將加速AI應用的普及,根據「傑文斯悖論」,整體效率的提升反而可能刺激更大規模的AI部署,從而帶動HBM、GPU以及NAND的總需求呈指數級增長。
生態博弈與落地挑戰:英偉達的缺席與閃迪的野心
儘管前景廣闊,HBF的全面商業化仍面臨架構限制與生態挑戰。由於底層仍是NAND,HBF的讀取延遲在微秒級,無法達到DRAM的納秒級;其寫入性能和耐久度也存在天花板。因此,HBF更適用於讀多寫少的推理場景。
更核心的挑戰在於生態支持。目前,HBF聯盟已吸納閃迪、SK海力士、谷歌(GOOGL.US)、Meta(META.US)和Tensorrent等巨頭,但行業風向標英偉達尚未明確背書。相反,英偉達(NVDA.US)正積極推廣其CMX(內容內存存儲)平台以及Storage Next方案。此外,台積電(TSM.US)也尚未披露針對HBF的先進封裝(CoWoS)產能規劃。
作為HBF的核心推手,閃迪正憑藉其在NAND IP、前端製造(與鎧俠合資)及系統級封裝上的垂直整合優勢,全力推進HBF落地。據披露,閃迪首代HBF產品已成功流片,並計劃於2027年推出首批面向推理的樣品,第二代產品則將瞄準邊緣計算領域的1000億參數級模型。
綜合來看,HBF為打破AI內存牆提供了一條極具性價比的演進路徑。雖然前路仍受制於延遲短板和英偉達等大廠的生態抉擇,但其一旦規模化落地,無疑將為NAND產業注入強勁的結構性增長動能,開啓存儲行業的「HBF時代」。