美東時間11月5日周四,英偉達發布公司博客文章,詳解其AI內存全棧協同設計策略,強調隨着大模型參數規模、上下文長度和智能體(Agent)應用持續擴張,AI基礎設施的內存壓力正在加劇,單純增加GPU內存容量已不足以解決問題。
英偉達提出,通過協同設計GPU、CPU、網絡、存儲和軟件,並結合模型權重量化、KV Cache壓縮與分層存儲、檢索數據優化等技術,可以提高整個AI基礎設施的內存利用效率。公司披露,從Blackwell Ultra到Vera Rubin平台,單顆GPU的HBM容量僅增加約3%,在特定Agent工作負載下,每美元可實現的吞吐量就能最高提升30倍。
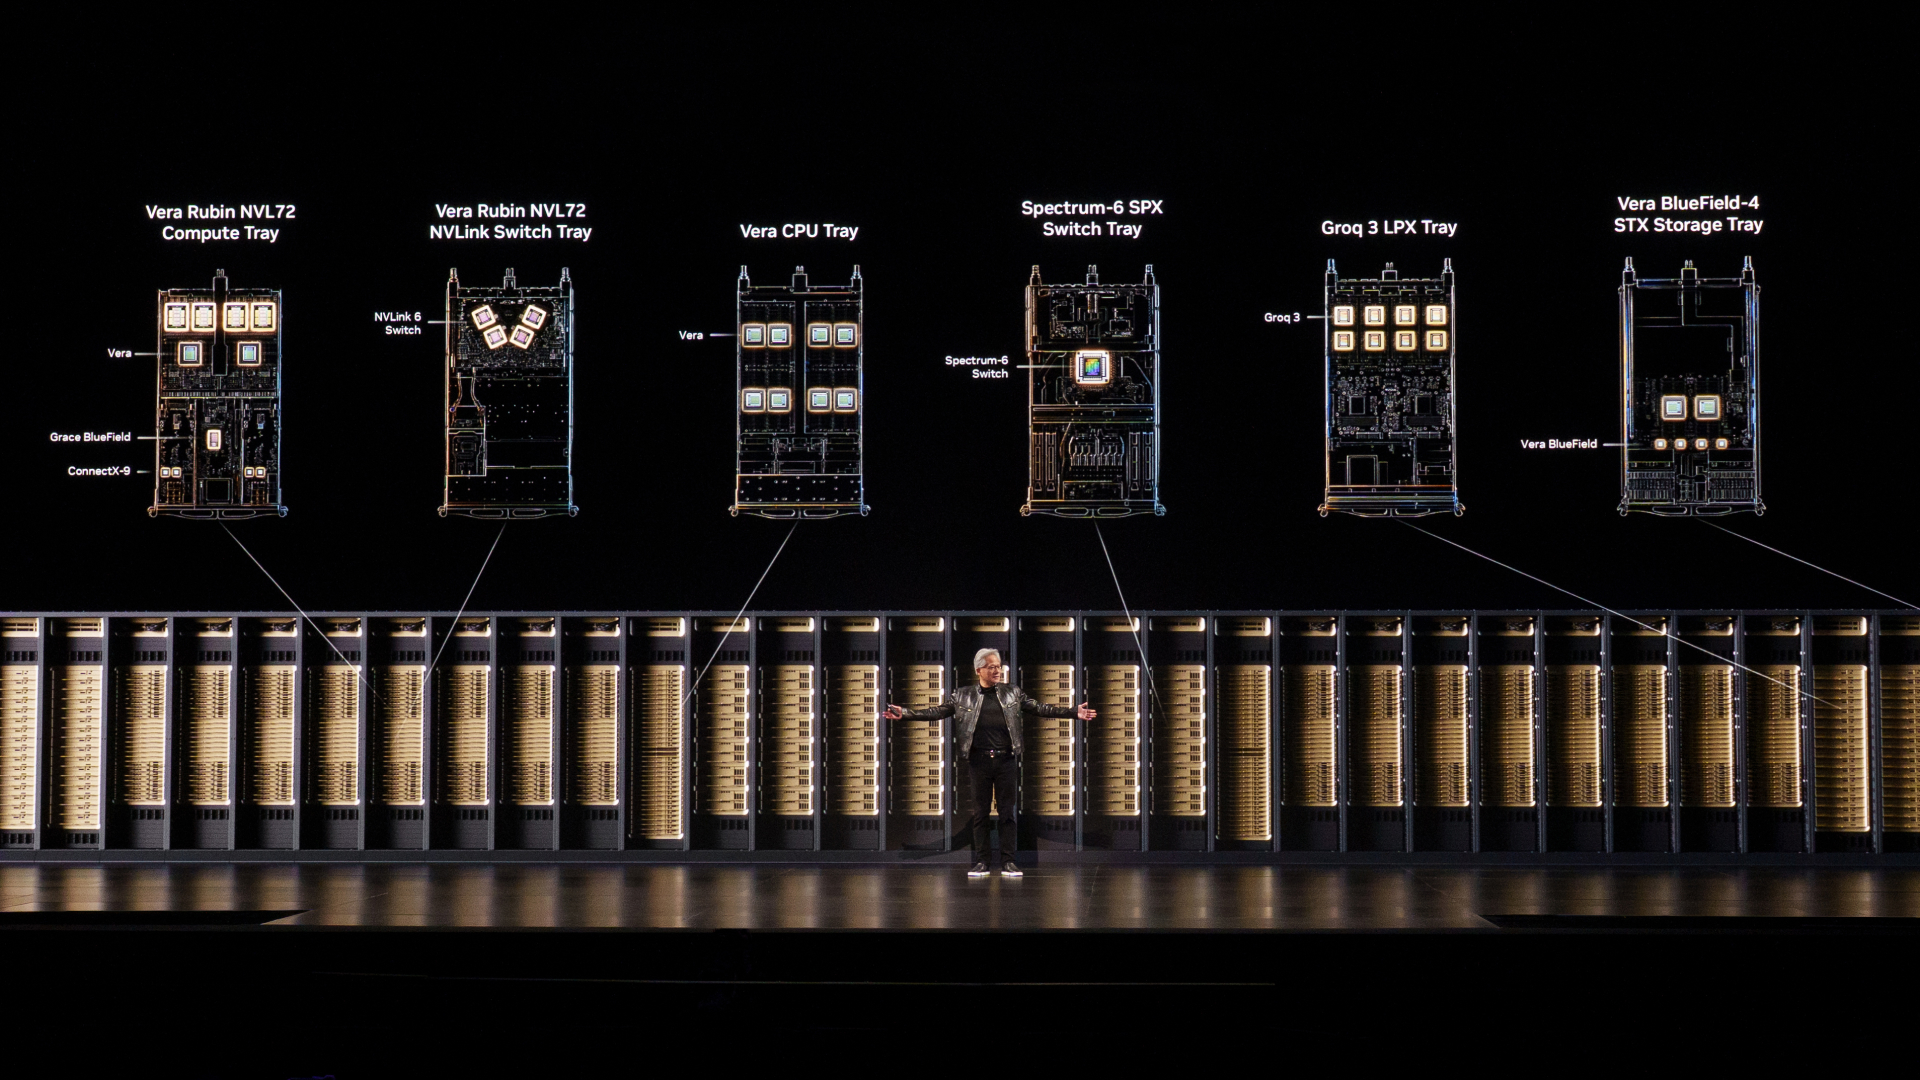
這一策略的核心,是將AI工廠的內存和存儲視為一個整體的數據層級,而不是一味追求將更多數據塞進速度最快、成本最高的GPU內存,以更低的單位成本處理更多AI任務。
值得注意的是,英偉達發布這篇技術文章當天,公司股票遭猛烈拋售。周四盤中,股價一度跌超9%,抹平今年內累計漲幅轉跌,市值較10月創下的最高紀錄蒸發近1.4萬億美元。
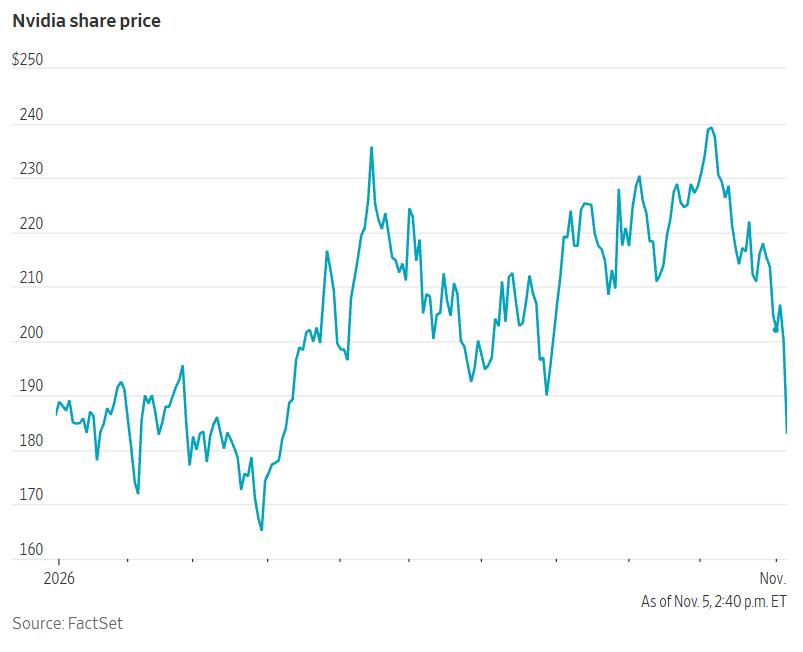
這輪拋售的背後,市場正在重新審視AI基礎設施投資的回報周期、數據中心建設進度以及AI產業鏈企業的估值,凸顯了AI產業從追逐算力擴張轉向關注投資效率的市場環境。英偉達此次強調的全棧協同設計,正是試圖從系統效率和單位Token成本的角度回應AI基礎設施持續擴張所面臨的資源與成本約束。
大模型和Agent推高內存壓力,單純增加HBM容量不夠
英偉達指出,大模型參數規模不斷擴大,上下文窗口越來越長,加上Agent需要在多輪推理和工具調用之間持續保留歷史信息,正在給GPU高帶寬內存(HBM)帶來更大壓力。
其中,KV Cache(鍵值緩存)是推理過程中重要的內存消耗來源。它保存模型處理請求時已經計算過的上下文信息,使模型在後續生成內容時不必重複處理相同信息。對於Agent而言,一次任務可能涉及多輪模型推理、工具調用和結果返回,歷史上下文會不斷累積,KV Cache也隨之擴大。英偉達稱,部分Agent任務軌跡涉及的處理上下文規模已經達到300萬Token。
此外,檢索增強生成(RAG)技術需要將企業文檔轉換為向量表示,並在模型推理時檢索相關內容,這也會增加需要處理和保留的數據量。
英偉達強調,推理過程中,模型權重和KV Cache都需要佔用HBM,而HBM恰恰是AI工廠中速度最快、成本最高、供應也最受限制的內存層級。
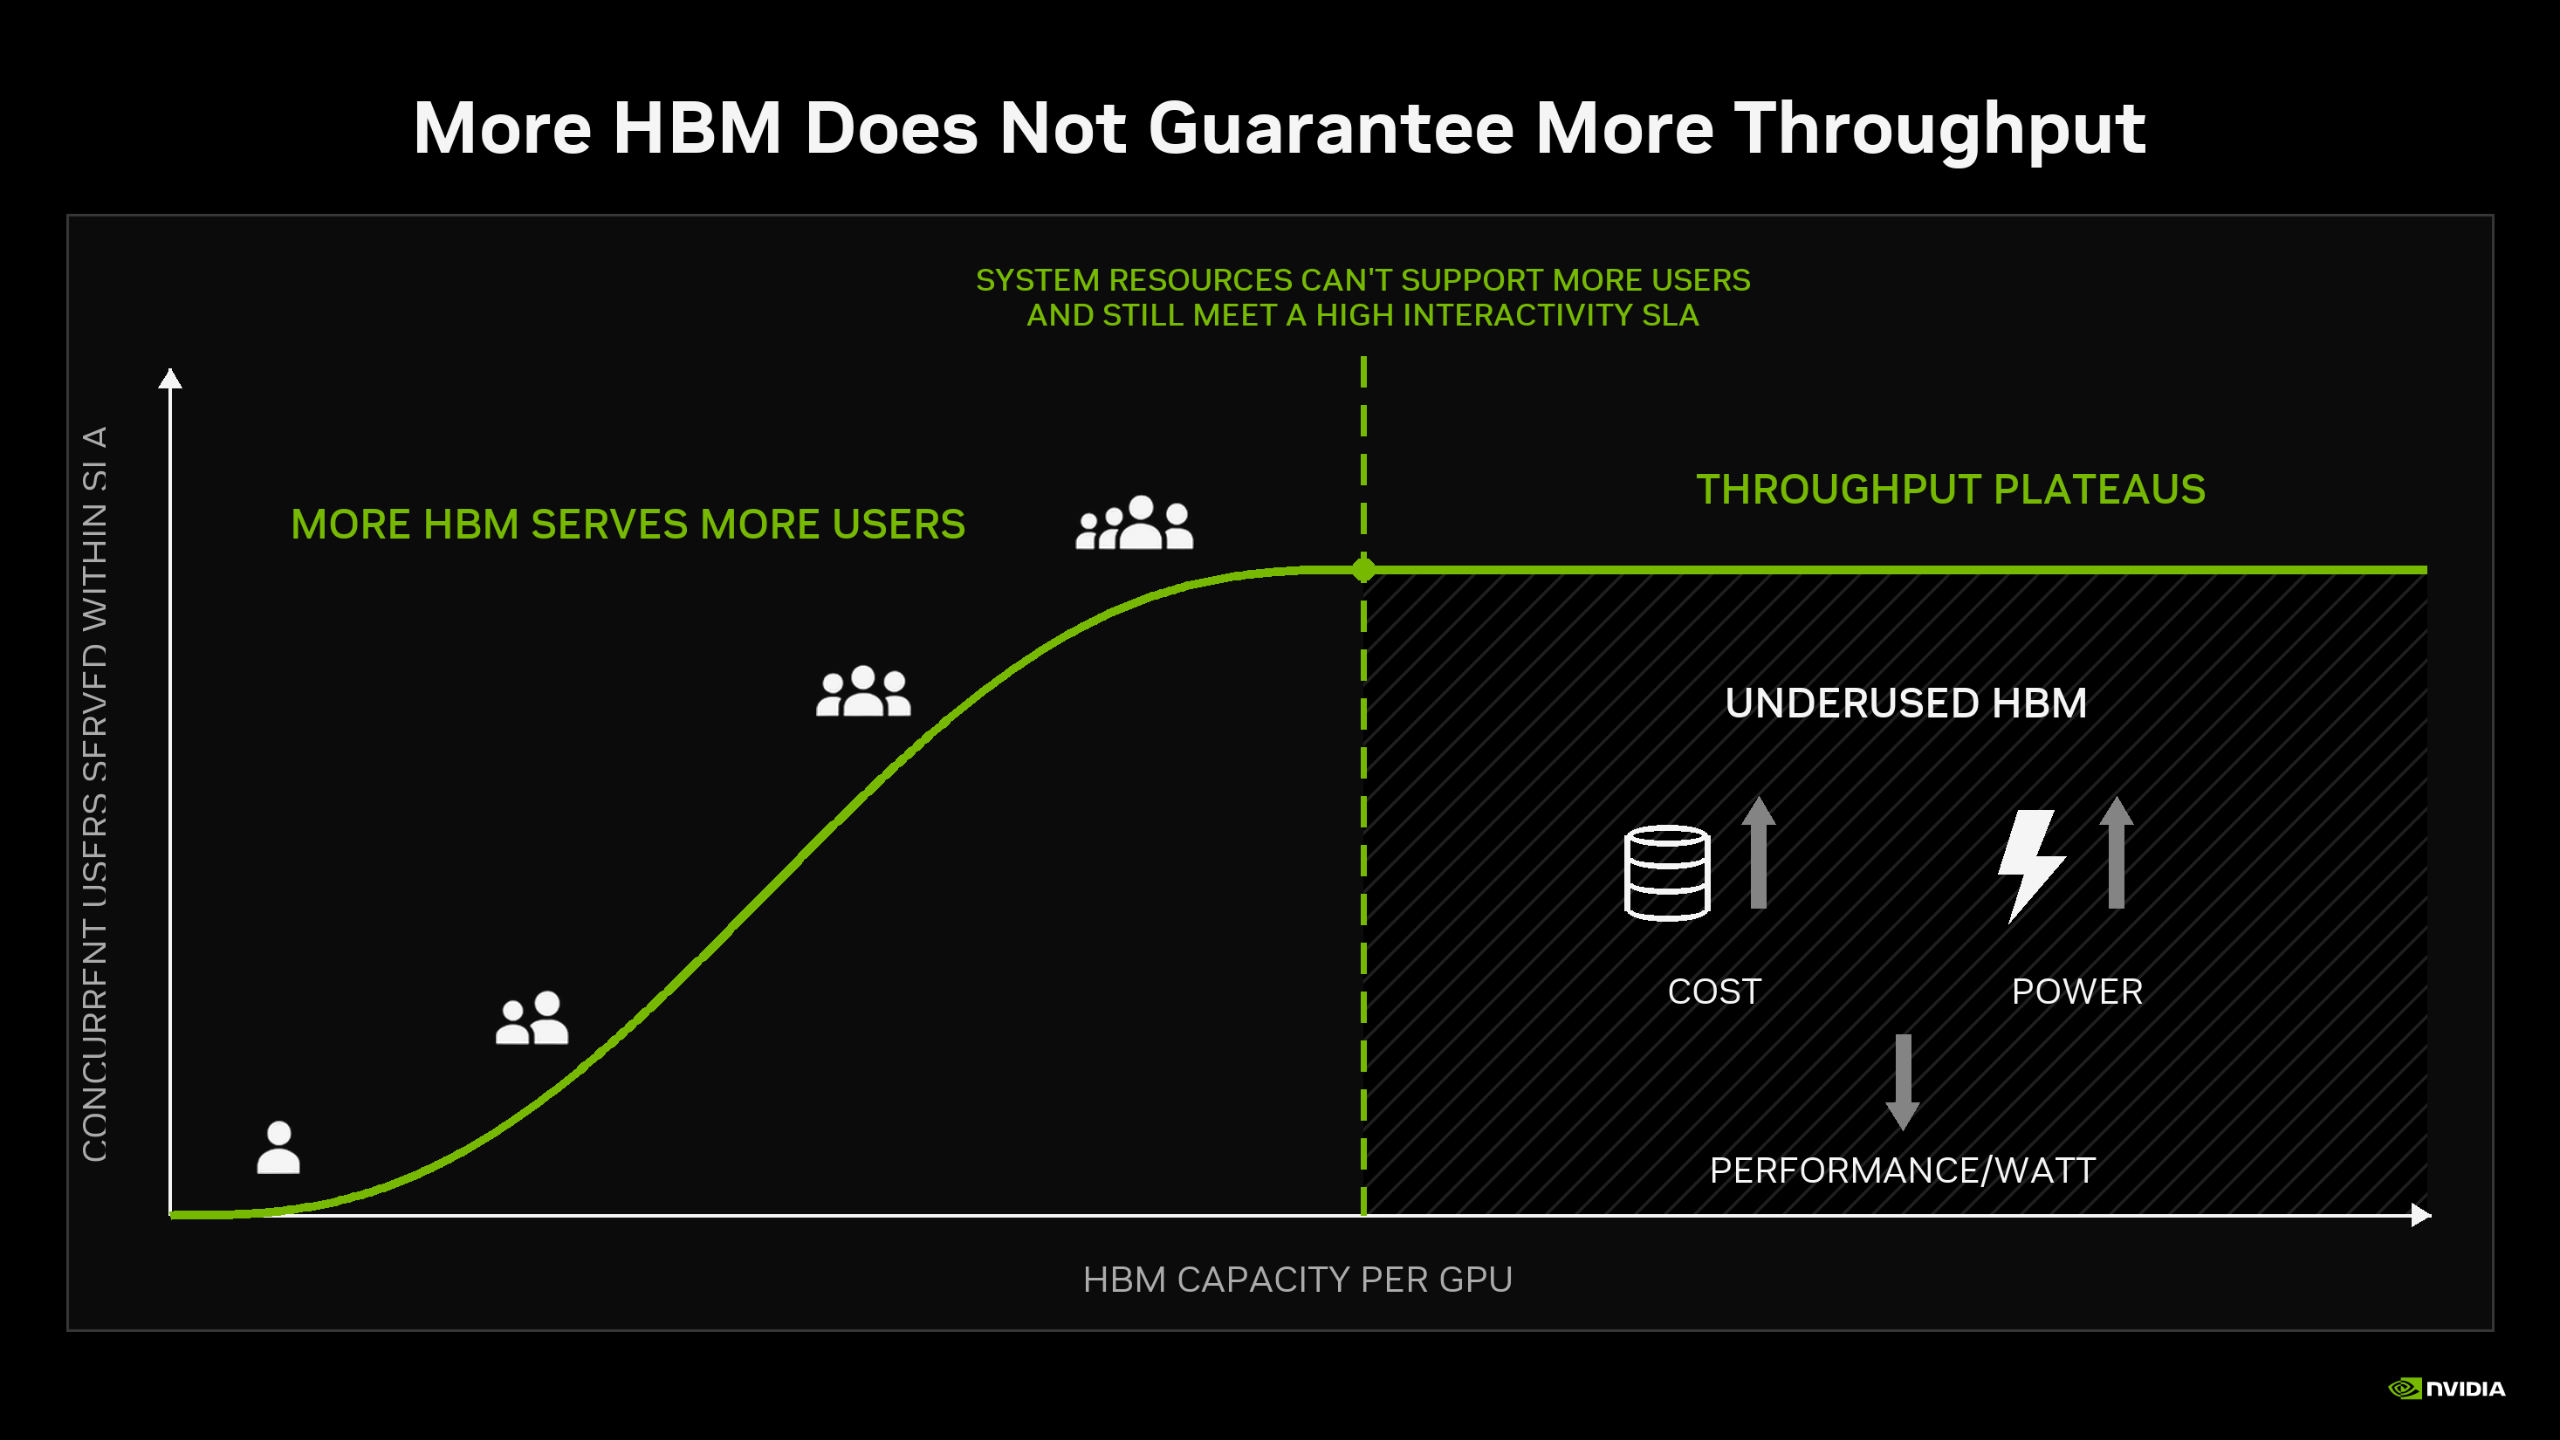
單純增加HBM容量並不能解決所有問題。英偉達將HBM比作倉庫,將內存帶寬比作倉庫的裝卸碼頭:更大的倉庫能夠容納更多貨物,但如果裝卸速度跟不上,增加倉儲空間也無法提高實際吞吐量。
在AI推理中,更多HBM確實可以容納更多用戶的模型工作負載和KV Cache,但所有用戶仍然需要共享GPU計算資源和內存帶寬。一旦計算能力或帶寬成為瓶頸,額外增加的內存容量就可能無法得到充分利用,反而增加成本和功耗。
因此,英偉達認為,真正重要的不是單純增加內存容量,而是讓不同類型的數據進入最合適的存儲層級,在需要時及時調回GPU,以提高整個系統的利用效率。
NVFP4壓縮模型權重,NVLink將權重分佈至72顆GPU
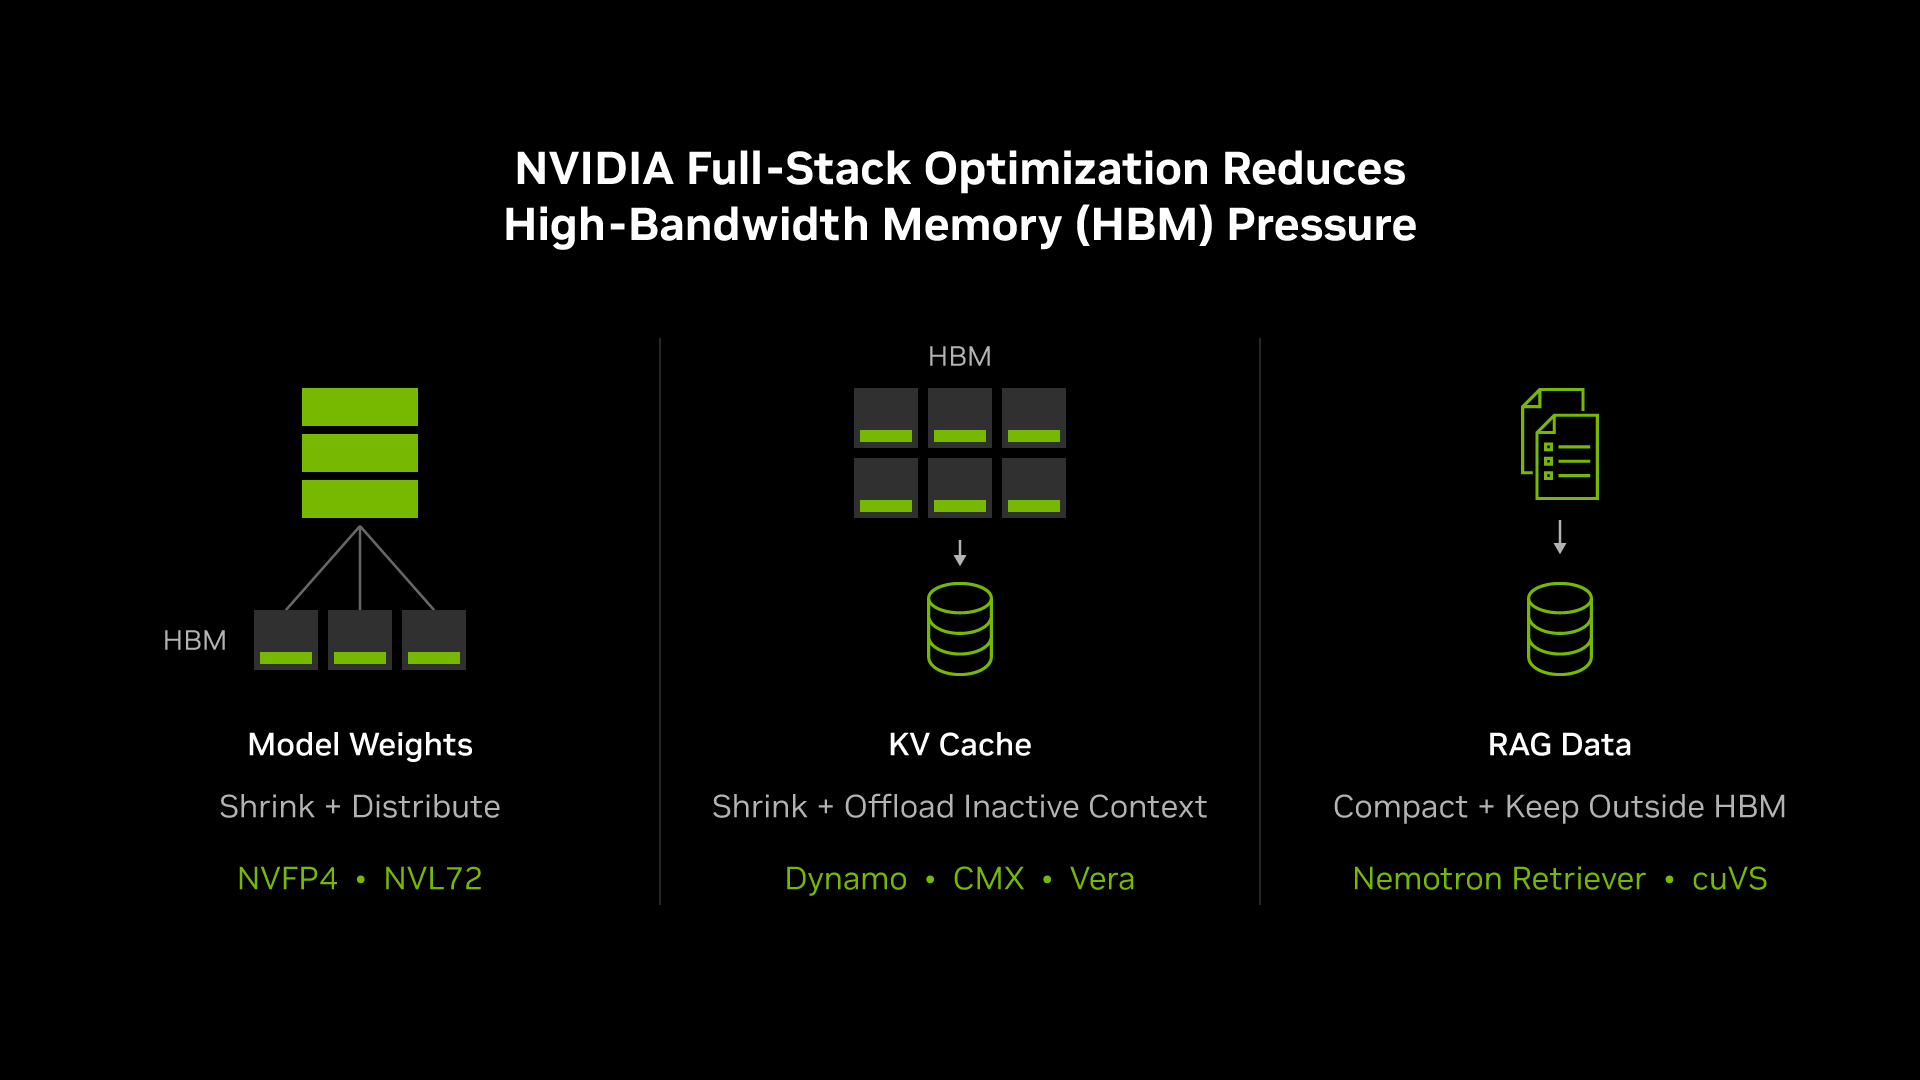
針對模型權重佔用大量HBM的問題,英偉達提出通過NVFP4低精度格式壓縮模型權重,並利用NVLink實現跨GPU分佈式存儲。
具體而言,NVFP4可以將模型權重壓縮至4位精度,相比FP8進一步減少存儲空間。英偉達稱,越來越多模型開發商開始採用NVFP4格式發布模型權重,包括Black Forest Labs、Thinking Machines Lab、Reflection、Meta等機構和公司的部分模型。
在硬件層面,英偉達通過NVLink構建NVL72機架級GPU互聯繫統,允許模型權重分佈在最多72顆GPU之間,使單顆GPU只需存儲模型的一部分,從而釋放更多HBM空間,用於容納KV Cache和服務更多併發用戶。
這意味着,英偉達試圖通過低精度量化和機架級互聯共同解決模型權重佔用內存的問題,而不是僅僅依賴單顆GPU不斷增加HBM容量。
KV Cache壓縮與分層卸載,Vera CPU和Dynamo協同管理內存
相比模型權重,KV Cache帶來的挑戰更加動態。隨着Agent持續推理、調用工具和等待外部結果,部分上下文需要保留,但並非所有信息都需要始終佔用速度最快的GPU內存。
對此,英偉達提出從壓縮、暫存和分層卸載三個方面優化KV Cache。
首先,NVFP4同樣可以用於壓縮KV Cache,相比FP8減少其內存佔用,使更多上下文能夠留在GPU的HBM中。
其次,Vera CPU負責加速工具調用,縮短Agent等待外部工具執行結果時KV Cache處於閒置狀態的時間。與此同時,Vera CPU配備大容量LPDDR內存,並通過NVLink-C2C與Rubin GPU連接,可以為暫時不活躍的上下文提供距離GPU較近的存儲空間,需要時再快速調回。
第三,英偉達Dynamo推理軟件可以將暫時不活躍的KV Cache從GPU內存卸載至CMX上下文內存存儲平台。CMX是一種面向大容量、低成本數據存儲設計的層級,每比特存儲成本遠低於HBM,並能夠在上下文再次被調用前將數據調回。
與本地SSD不同,CMX可以跨服務器共享;與傳統企業存儲不同,它不需要為這些短生命周期的上下文承擔長期數據保護所帶來的額外開銷。
英偉達還通過Dynamo的KV Cache Reuse功能,將GPU內存、CPU內存和存儲中的KV Cache作為一個系統級資源統一管理,使已經計算過的上下文能夠在整個系統內複用,減少重複計算。
NeMo Retriever和cuVS優化RAG,企業知識庫不再佔用HBM
除了模型權重和KV Cache,英偉達還針對檢索增強生成(RAG)帶來的內存壓力提出優化方案。
RAG需要將企業文檔轉換為向量嵌入(Embedding),並建立可供檢索的向量索引,以便模型根據用戶問題從龐大的知識庫中提取相關信息。這些向量數據如果全部放在GPU的HBM中,會進一步擠佔模型推理所需的寶貴內存。
英偉達提出通過NeMo Retriever和cuVS分別優化向量數據及索引的存儲。
其中,NeMo Retriever模型能夠生成更小的向量嵌入,同時提高檢索準確性,減少需要存儲和傳輸的數據量;cuVS則支持在CPU內存和存儲層級構建、運行大型向量索引,使整個企業知識庫不必佔用GPU的HBM。
只有真正被檢索出來、模型需要處理的相關文本片段,纔會進入模型上下文。
通過這一方式,英偉達希望減少模型權重、閒置上下文和RAG數據對HBM的佔用,將更多GPU內存留給實際推理任務和併發用戶。
從擴充內存轉向提升單位資源產出,Vera Rubin效率最高提升30倍
英偉達公布的性能數據,是此次全棧協同設計文章最值得關注的部分。
公司援引SemiAnalysis AgentX基準測試中的DeepSeek V4 Pro工作負載,比較不同代際AI計算平台的吞吐量與成本效率。
具體來看,在每位用戶每秒100個Token的服務速度下,英偉達GB300 NVL72相較H200平台,每美元可實現的吞吐量最高提升10倍,同時單顆GPU的HBM容量大約翻倍。
在每位用戶每秒125個Token的服務速度下,Vera Rubin NVL72相較GB300 NVL72,每美元可實現的吞吐量最高提升30倍,而單顆GPU的HBM容量僅增加約3%。
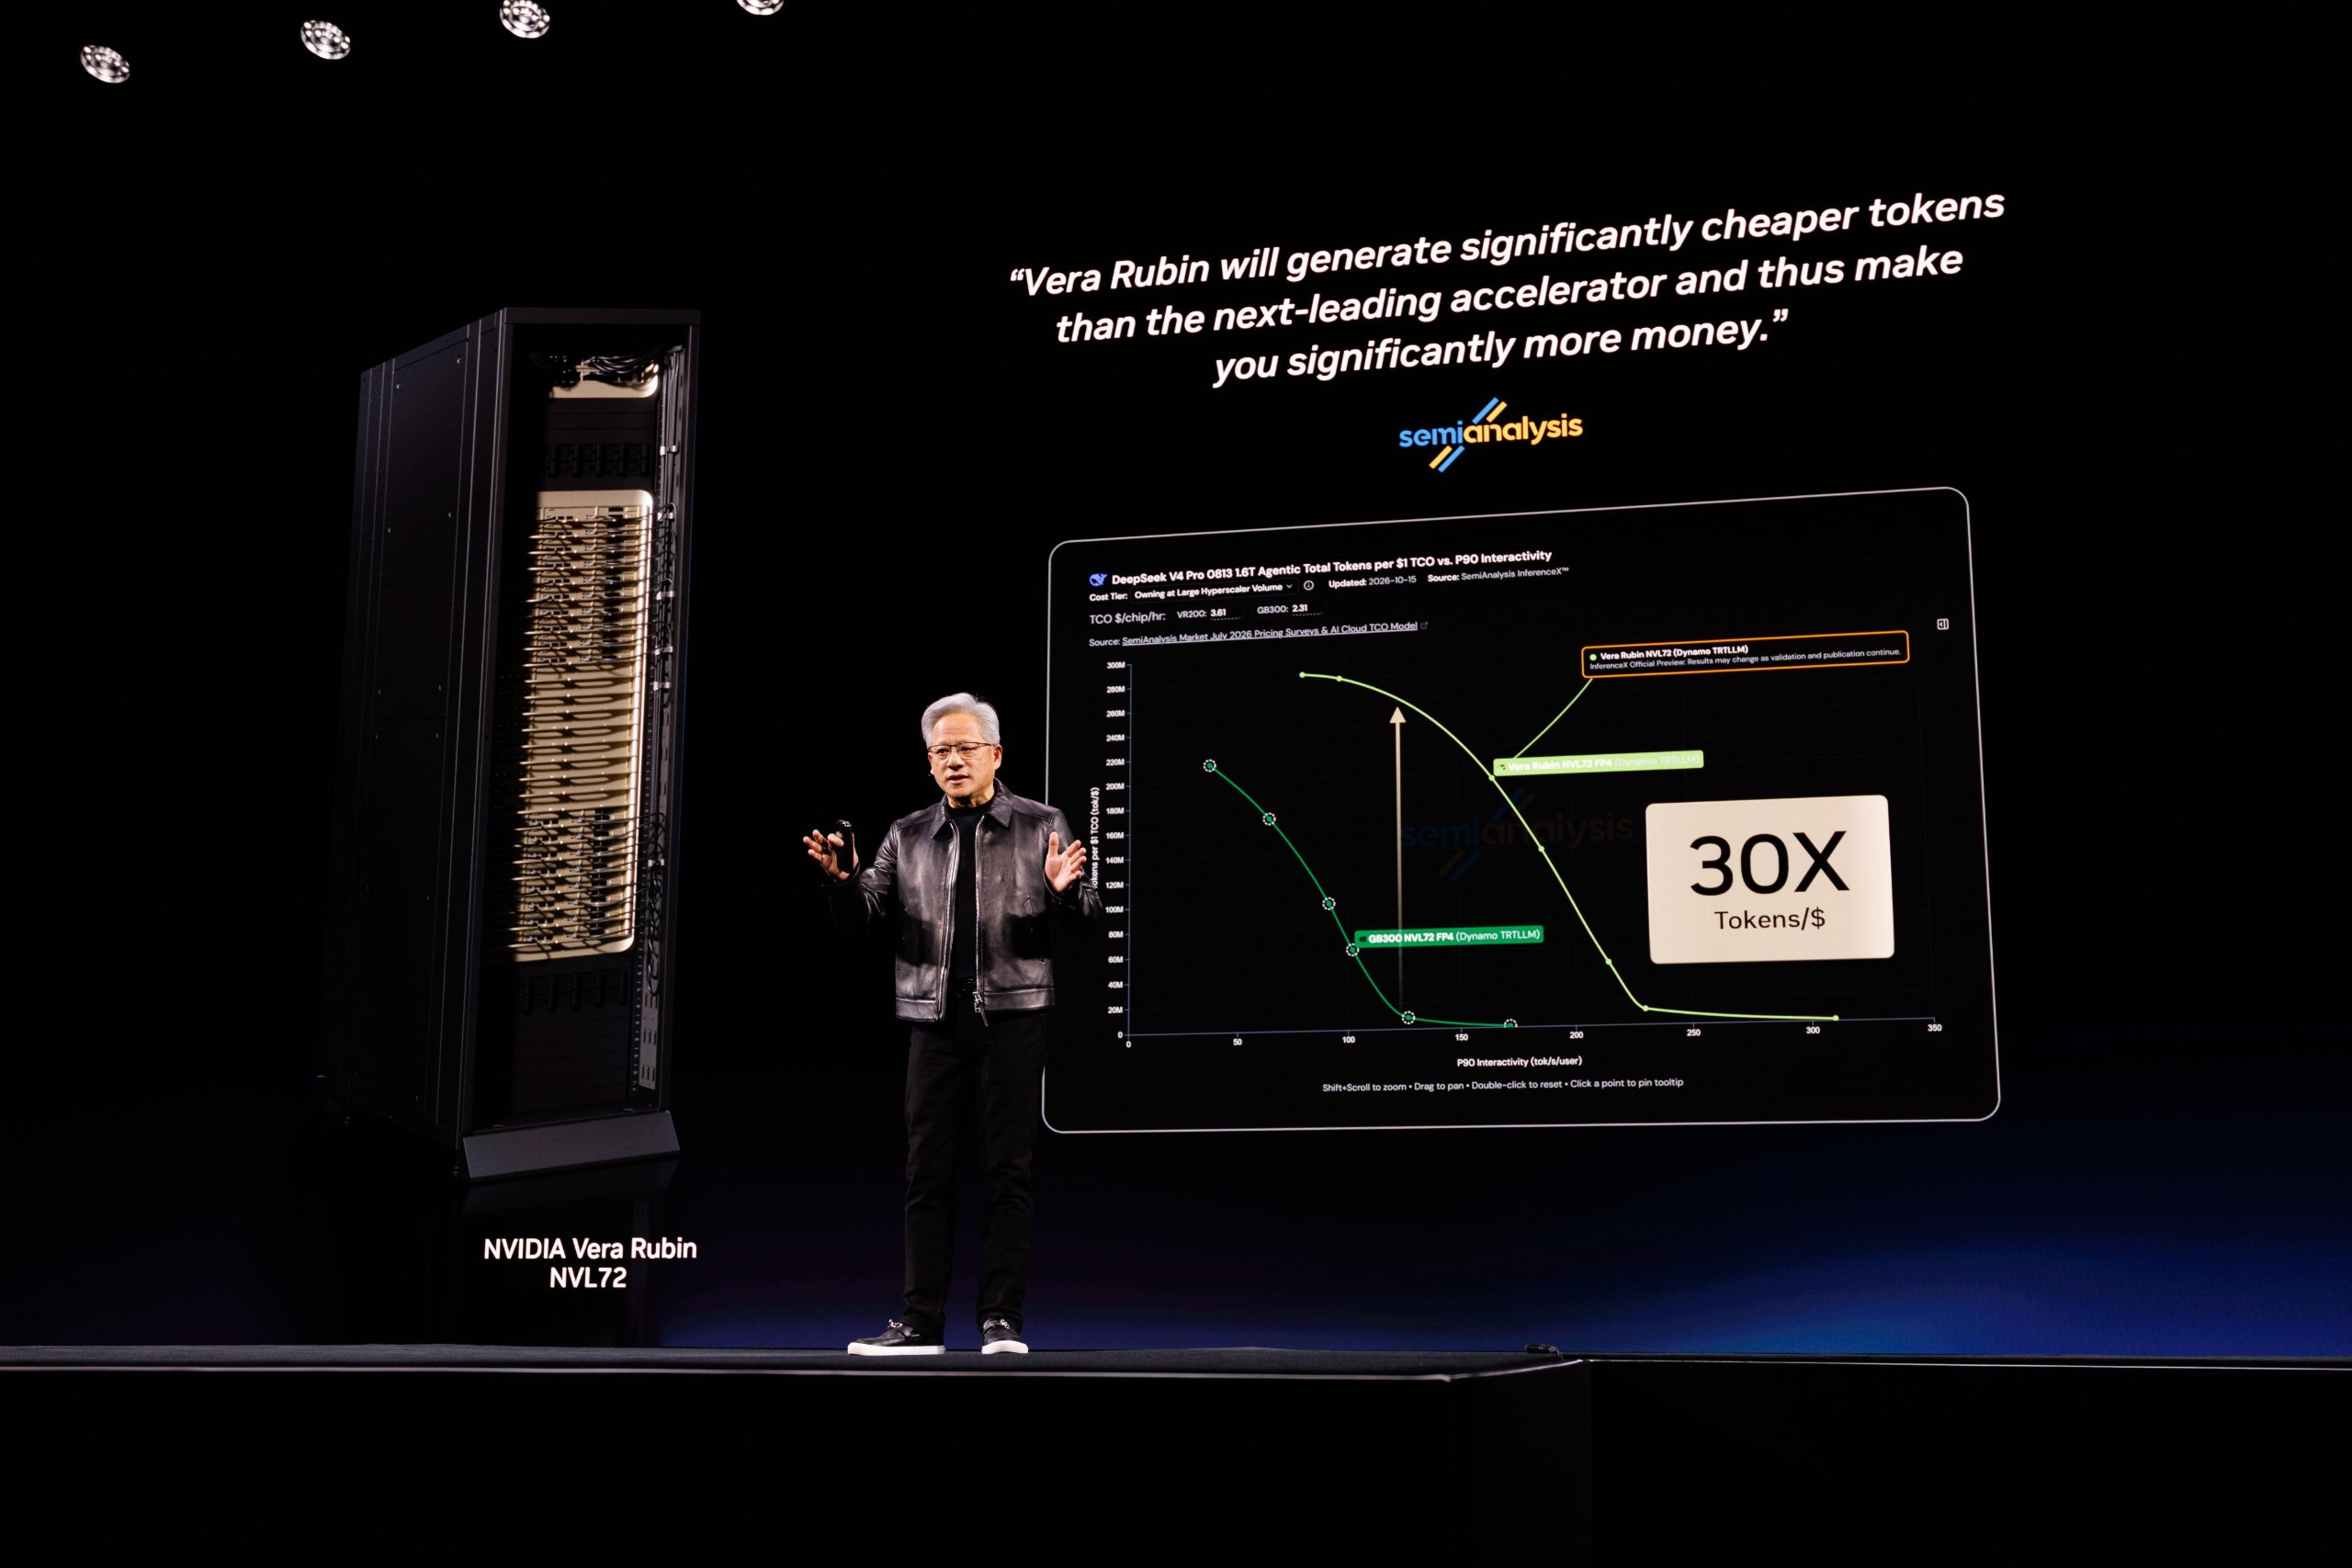
這意味着,在英偉達強調的特定Agent推理場景中,性能和成本效率的提升遠遠超過了單純增加內存容量所能帶來的收益。通過壓縮模型權重和KV Cache、將閒置上下文卸載至更低成本的存儲層級,以及優化GPU、CPU和網絡之間的數據調度,系統能夠從相近規模的內存資源中獲得更多有效計算產出。
英偉達強調,對於AI工廠運營商而言,真正重要的指標不是單純擁有多少GPU或多少HBM,而是在滿足用戶響應速度要求的前提下,在既定電力預算內能夠交付多少有用Token。每瓦能夠產生更多Token,意味着同樣的電力資源可以完成更多工作、創造更多收入,同時降低每個Token的成本。