新智元報道

Anthropic藏得極深的神祕「Model 4」,曝光了!
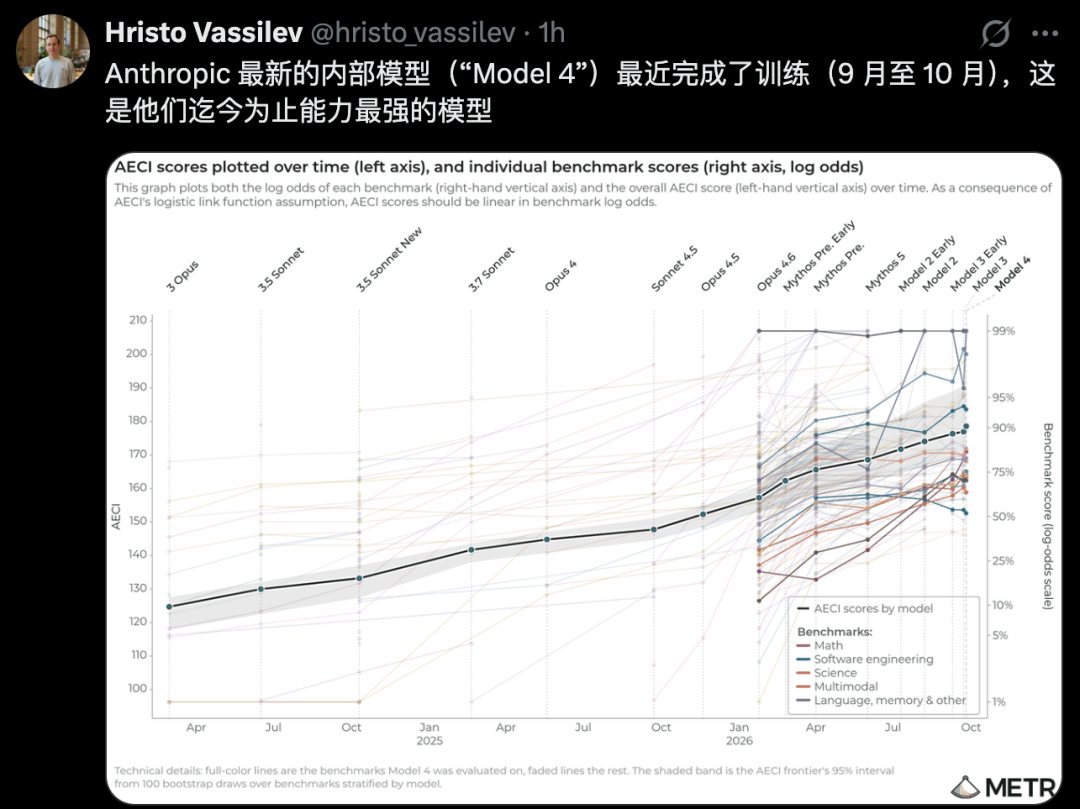
9到10月祕密練完,內部綜合能力指數(AECI)直接飆上178.6的逆天高分,現有的考卷已經快要壓不住它了。
|
|
就在今天,第三方評測機構METR甩出重磅調查。
連肝11周,深挖Anthropic內部敏感數據,最後只得出了一個結論——
Anthropic模型的進化速度,已經徹底失控,直接原地翻倍。
報告裏最炸的,是這幾組數字。
截至10月,Anthropic在明確任務上的能力提升速度,已是2024年3月-2025年10月那段時間的2倍。
轉折點,就落在2025年10月。
從那以後,內部能力指數AECI的增速直接拉到此前的1.9倍,一年就跑完了過去兩年的路。
更恐怖的是,這波狂飆裏,80%的推力居然來自AI自己!Claude正在親手造出更強的Claude。
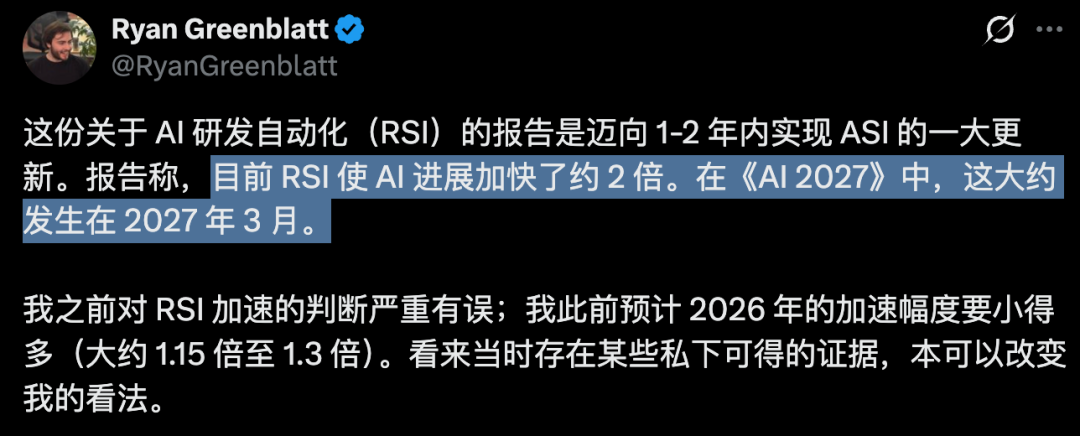
METR研究員Ryan Greenblatt直言,「這份報告就是通向一兩年內實現ASI的重磅信號」。
照這個速度下去,「AI 2027」劇本里的ASI,在短短的4個月後就會徹底降臨!
神祕Model 4突然現身
15張考卷刷爆50%
這份報告最抓眼的,就是一連串Anthropic從未公開過的神祕代號。
報告的附錄中,METR列出了四款內部未公開模型。
它們分別是2022年練完的「Unreleased 2022」、2026年7月練完的Model 2、8–9月練完的Model 3,以及9–10月剛出爐的Model 4。
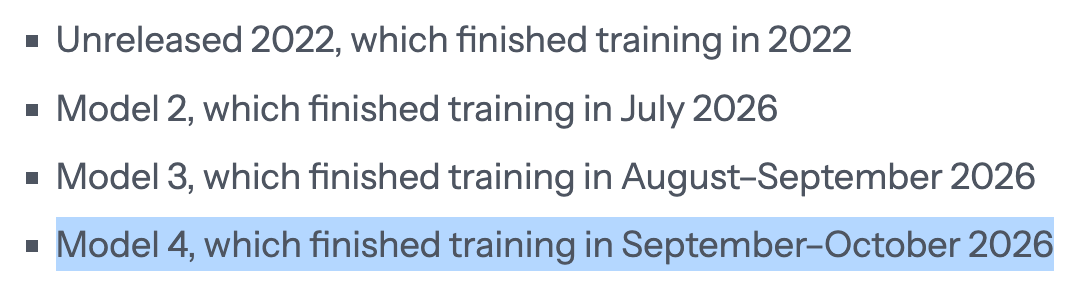
真正把全網點燃的,正是這款上個月剛訓完的Model 4。
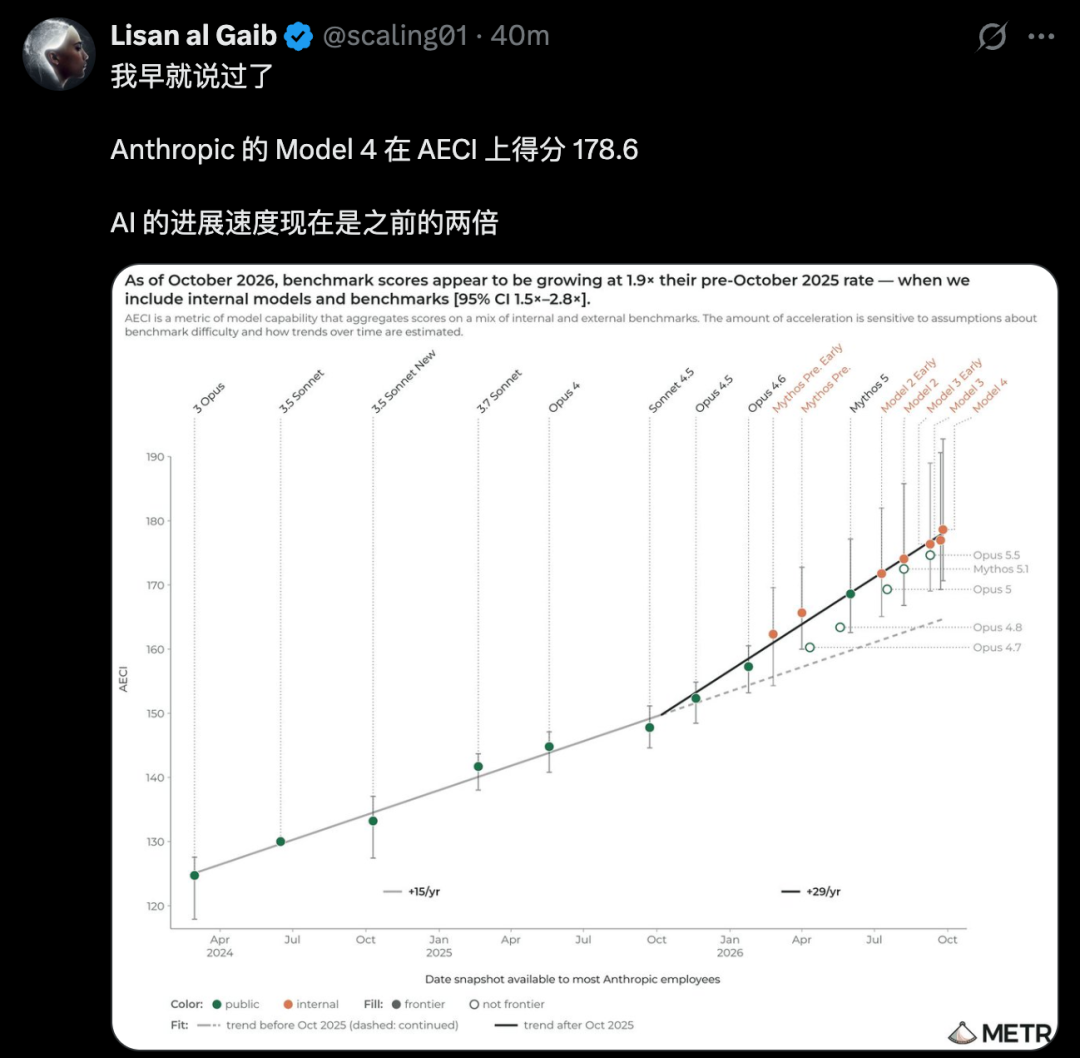
它在AECI上拿下了178.6分,遠超公開模型Opus 5.5(174.5分)與Mythos 5.1(172.5分)。
AECI就像大模型的「高考總分」,把各科基準測試的卷面成績折算成一個綜合段位分。
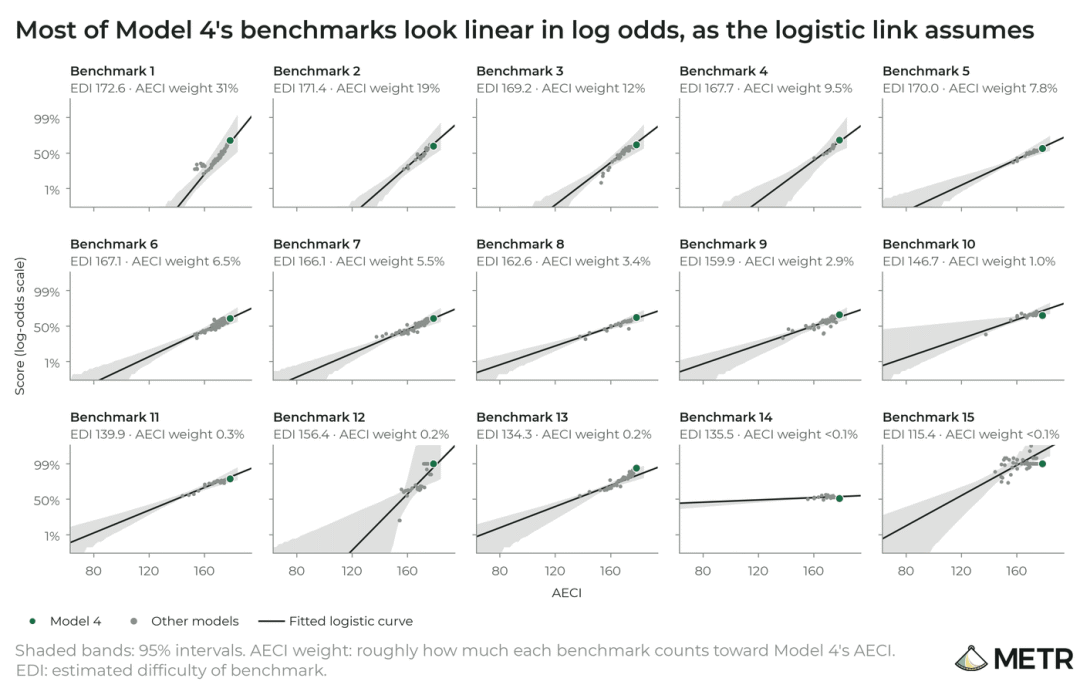
再看單科,Model 4參加的15項基準測試,每一項正確率都過了50%。而就在9個月前,Opus 4.6還有不少基準沒能過半。
但這還不是Model 4的真實極限!
METR團隊甚至在報告裏做了一次「除蟲測試」,他們發現15個測試基準裏有3個存在長尾過難或題目損壞的凹陷現象。
一旦把這3個干擾基準剔除重新計算,Model 4的AECI得分會進一步跳漲1.1分,衝上179.7分。
甚至在Token消耗量上,Anthropic內部測試也還沒有把Model 4的潛能徹底榨乾。
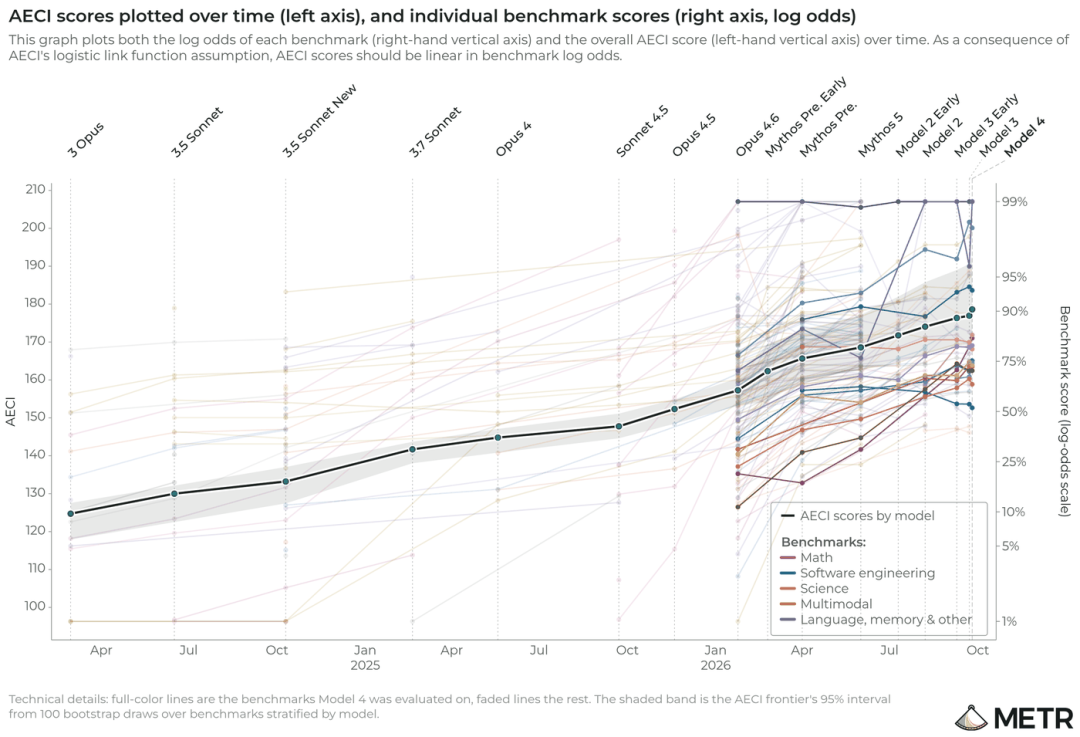
跑一次普通基準測試,單個任務平均就要消耗250萬輸入Token、生成7萬多輸出Token。
要是讓Agent去寫代碼,單任務直接喫下整整1000萬輸入Token,輸出也拉到9.4萬Token。
更讓METR評測人員感到棘手的是,現有的考卷已經快要測不出Model 4的極限了。
也難怪Anthropic在IPO前再次更新S-1招股書,專門新增了一條風險提示。
據內部估算,未來的模型很快就會觸發「AI顯著加速研發」閾值,1年就能幹完過去2年的活兒。
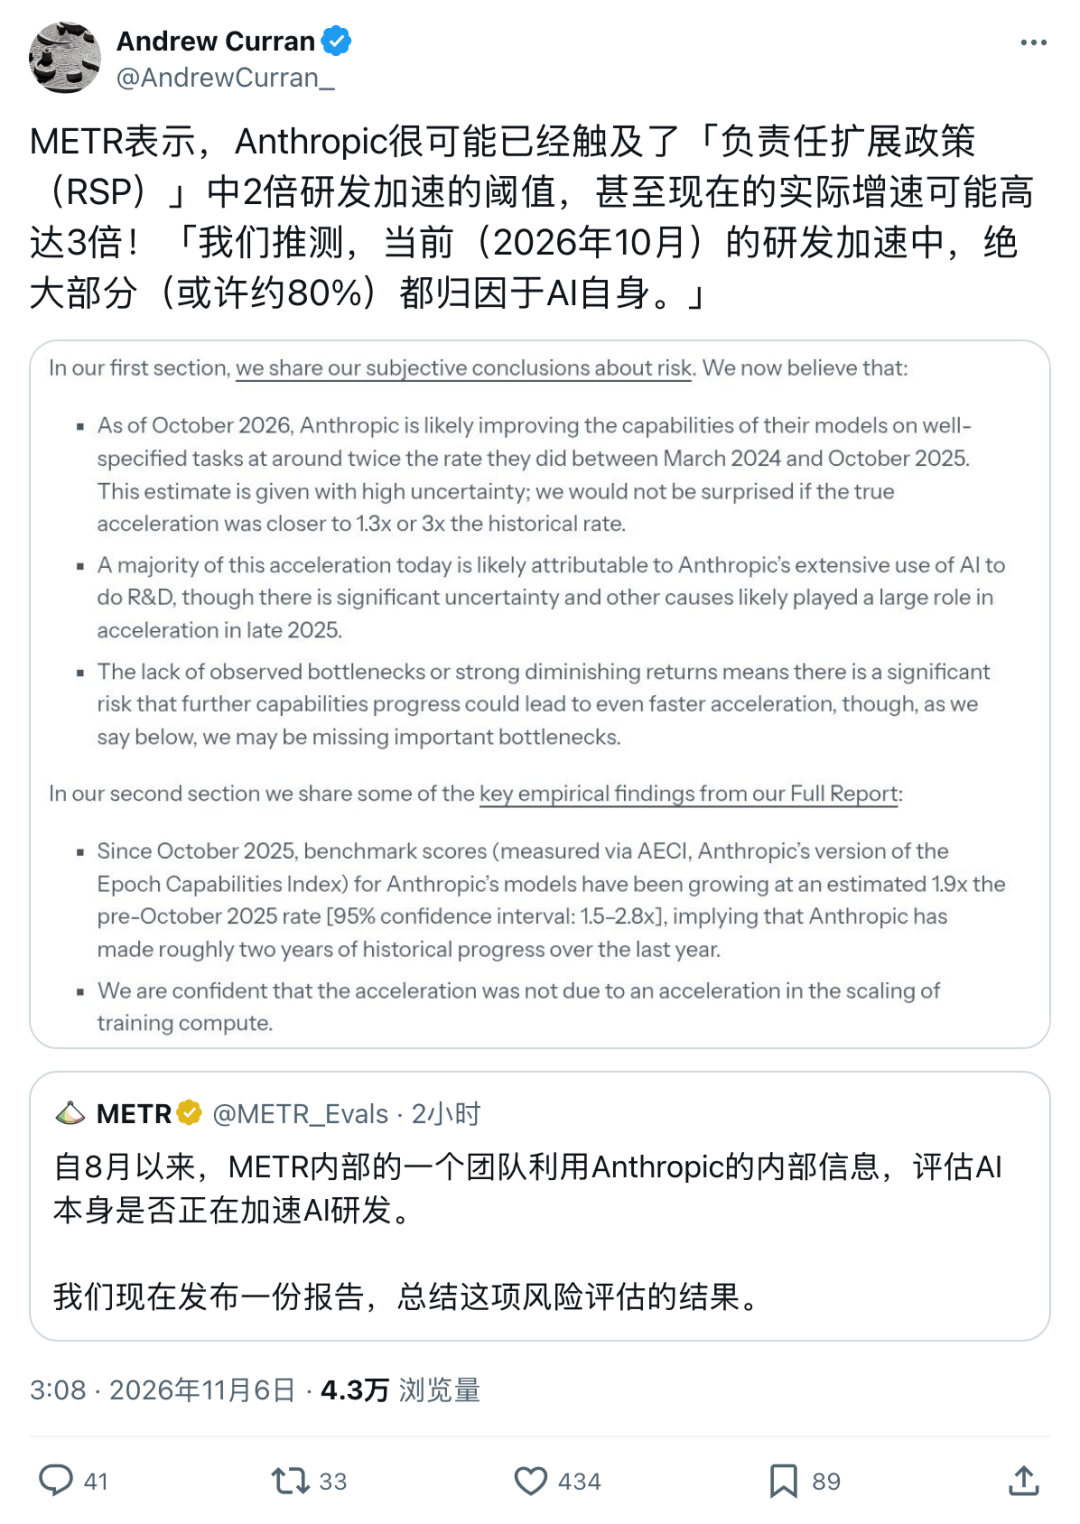
Model 4就是最好的證明。至於圖中的Model 3,網友推測它就是傳聞中的Mythos 5.5。
80%加速是AI自己
Model 4能衝上如此高分,背後是模型進化的速度正在明顯加快。
歷史性拐點,停在了2025年10月7日。
在這條分界線之前,Anthropic模型的AECI得分每年大約上漲15分。
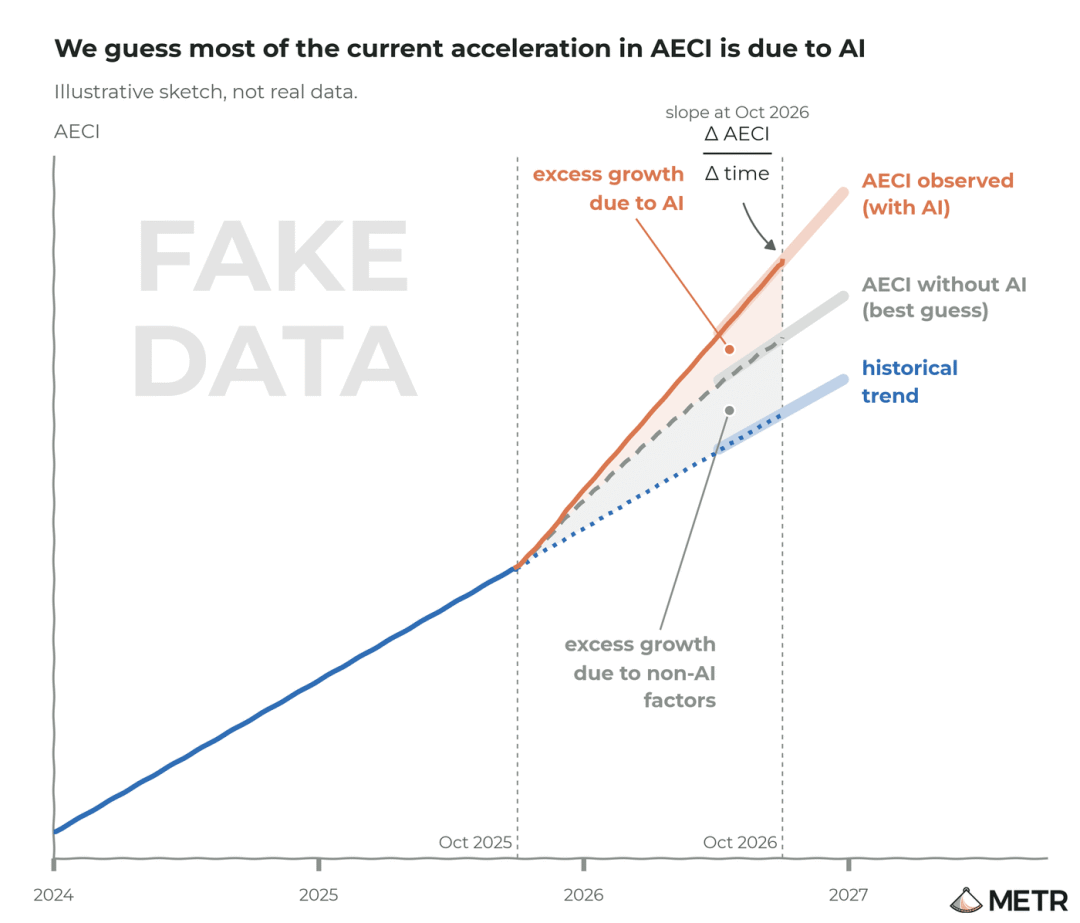
從2025年10月開始,這條曲線的走勢直接猛拐向上,變成每年大漲29分,增速達到過去的1.9倍(95%置信區間在1.5倍到2.8倍之間)。
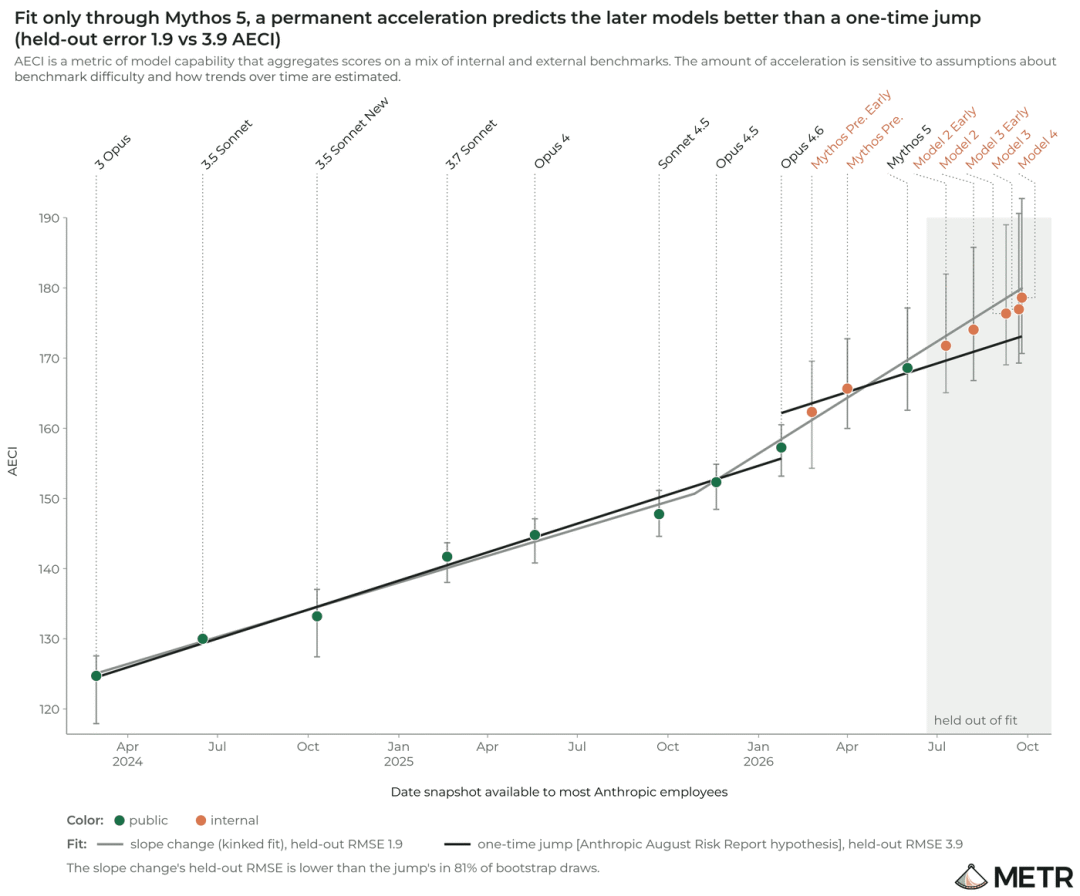
Anthropic曾在今年8月的風險報告裏提出一種溫和假設,認為這只是啓用新工具和新評測方法帶來的一次性「台階式跳躍」。
於是METR做了一組嚴格的盲測對比實驗。
研究人員用Mythos 5及更早的模型數據畫出兩條預測線,再去盲測後來出爐的Model 2、Model 3、Opus 5.5和Model 4。
結果非常清晰。在81%的統計抽樣中,按「長期持續提速」預測的誤差只有1.9分,遠比「一次性跳漲」更吻合真實數據。後者的誤差高達3.9分。
2倍加速度,也就意味着過去短短1年時間裏,Anthropic走完了過去整整2年的技術路程!
如果放在指數增長的維度下,原本每年翻3倍的指標,在2倍加速度下會變成每年狂翻9倍(3^2)!
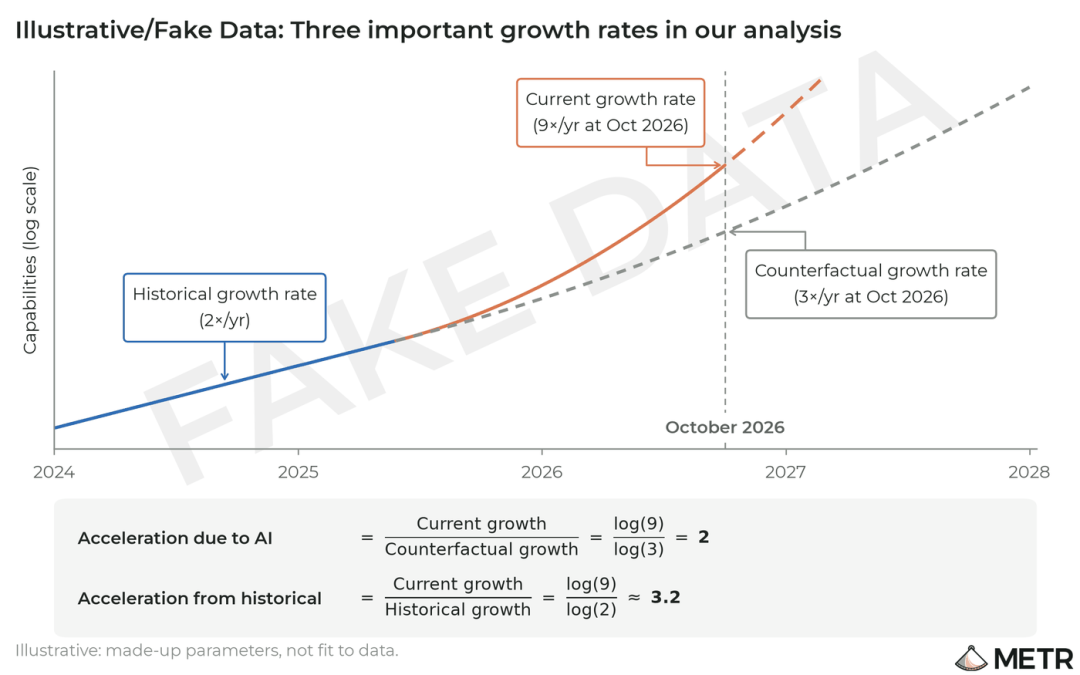
為了查清這股推力從哪來,METR把算力、算法和人員投入拆開算了一筆總賬。
METR明確排除了「靠猛堆訓練算力提速」的可能,因為2025年10月之後訓練算力的增長率反而比以前更慢。
真正的推手落在了研發端。
METR估算,當前約2倍的研發加速中,大約80%都來自AI自身的研發輔助,剩下的小部分纔來自研究員人數增加和推理算力擴容。
內部員工提速12倍
10個點子同時丟給Agent
既然外部還沒有人能親手測試Model 4,Anthropic內部研究員的日常實測就成了唯一的窗口。
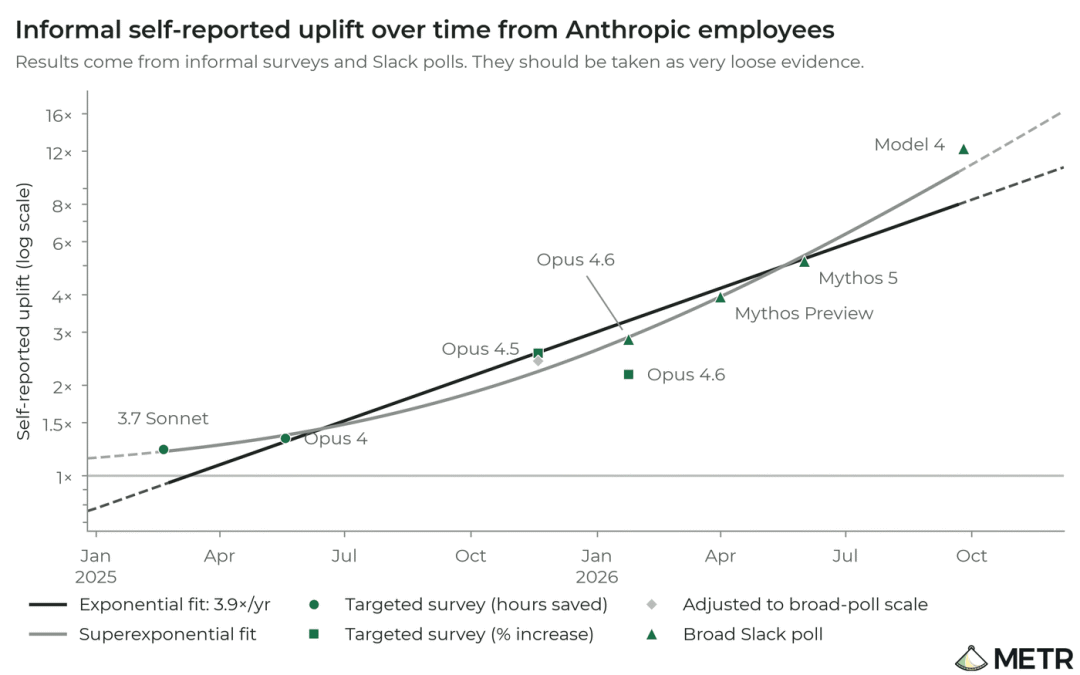
METR在報告裏公開了一張Anthropic內部非正式調查與Slack全員投票的趨勢圖。
2025年春天用3.7 Sonnet和Opus 4時,員工自報的效率提升還只有1.3倍到1.4倍。
到了今年6月的Mythos 5,自報提速跳到了5倍左右。
等到今年10月用上Model 4,員工自報的研發提速已經衝到了約12倍,按指數擬合相當於每年暴漲3.9倍。
為了搞清這12倍是怎麼來的,METR在9月底深度訪談了11位Anthropic一線技術研究員。
受訪研究員J用三個階段概括了他們工作流的變化。
第一階段只是拿Claude當自動補全,順手寫點一次性小腳本。
第二階段變成人類在旁邊盯着單個Claude實例,讓它開發完整功能。
到了現在的第三階段,內部掀起了「全面Claude化」運動,研究員開始同時指揮一大群Agent並行跑實驗。
受訪研究員C、D和E透露,公司今年專門發起了內部懸賞,鼓勵大家把平時不敢試的瘋狂點子全交給AI Agent去跑。
於是大家直接把10個研究點子同時丟給內部Agent系統,看看哪個能跑出結果。
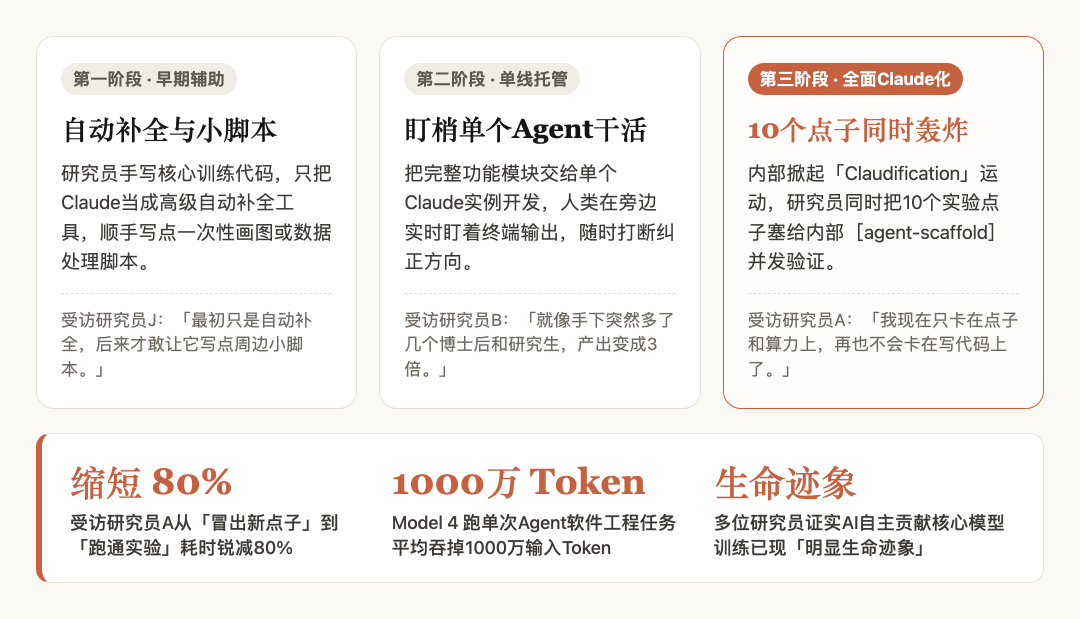
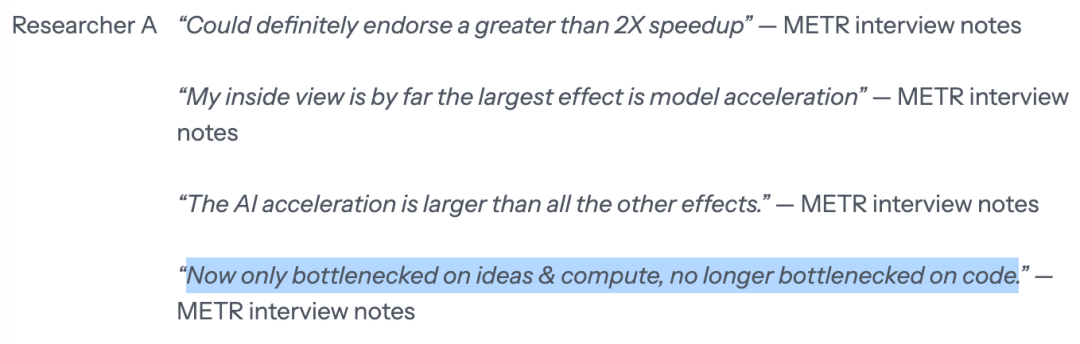
受訪研究員A表示,手寫代碼做實驗原本很耗時間,靠Claude輔助後,從冒出想法到跑通實驗的時間縮短了80%。
用這位研究員自己的話說:
我現在只卡在點子和算力上,再也不會卡在寫代碼上了。
受訪研究員B則估算自己整體提速了3倍,感覺就像手下突然多了幾個隨叫隨到的博士後和研究生。
目前AI還沒有完全獨自接管最核心的模型訓練設計,但多位受訪研究員向METR證實,AI自主貢獻核心訓練已經出現了明顯的「生命跡象」。
自進化找不到剎車
整份評估裏最具衝突感的一幕,藏在那些沒有公開的頁面裏。
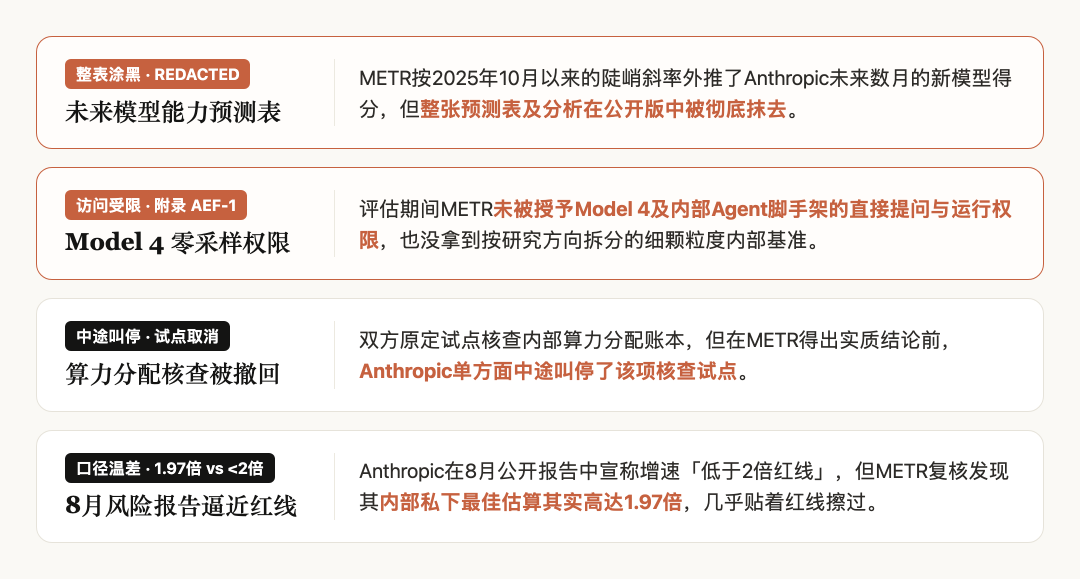
METR在官方帖中直言,他們向Anthropic提交了約100頁的完整報告,但Anthropic在公開版中刪掉了大部分信息量最大的核心證據。
翻開公開版報告,敏感位置到處都是「[REDACTED]」塗黑標記。
其中一張原本用來預測Anthropic未來幾個月新模型能力得分的表格,連同整段分析被整塊塗黑。
在METR看來,未來12個月內,無論是算法、算力還是數據,都沒有看到任何會讓這台加速機器停下來的明顯瓶頸。
更強的Claude幫研究員省下80%的實驗時間,省下來的時間立刻被用來孵化178.6分的Model 4。
而人類現有的考卷,已經快不夠它刷了。
沒看到瓶頸,也沒找到剎車。而速度,還在翻倍。