出品|虎嗅科技組
作者|易玉琴
編輯|苗正卿
頭圖|Google DeepMind
具身大模型,差點被判「死刑」。
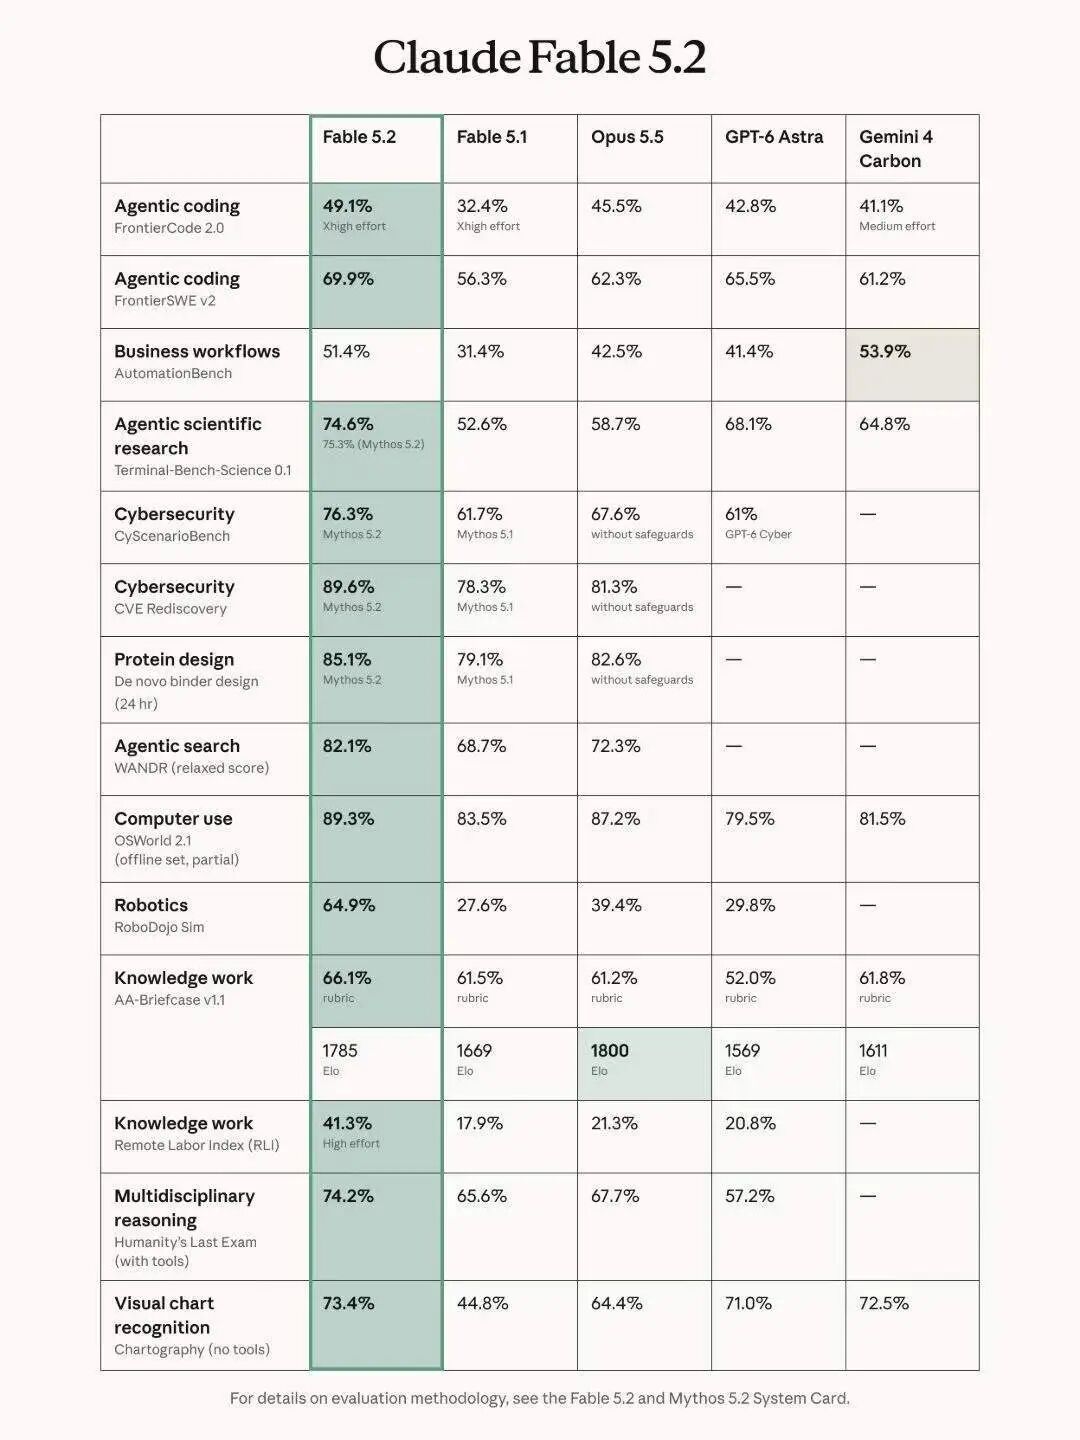
就在前一天,Anthropic發布的Claude Fable 5.2,讓不少機器人研究人員感嘆:專門訓練的具身模型,難道要被通用大模型淘汰了?
在測試機器人操作能力的RoboDojo Sim基準中,Claude Fable 5.2在42項任務中取得64.9%的平均成功率,遠超GPT-6 Astra的29.8%,表現也優於多數機器人專用模型。
更令人意外的是,在沒有針對部分任務進行專門訓練的情況下,Claude已經能夠控制真實機器人擰瓶蓋、解魔方,甚至畫畫。
當通用模型開始展現如此強的機器人操作能力,具身專用模型的價值也受到質疑。
然而,僅僅一天後,谷歌就給出了不同的答案。
11月10日,Google DeepMind發布Gemini Robotics 2.5,號稱其迄今最強的機器人視覺-語言-動作(VLA)模型。
根據谷歌公布的數據,新模型在200多項任務中接受評測,相比此前基準,部分任務的成功率相對提升30%至100%,執行速度提高20%至30%。
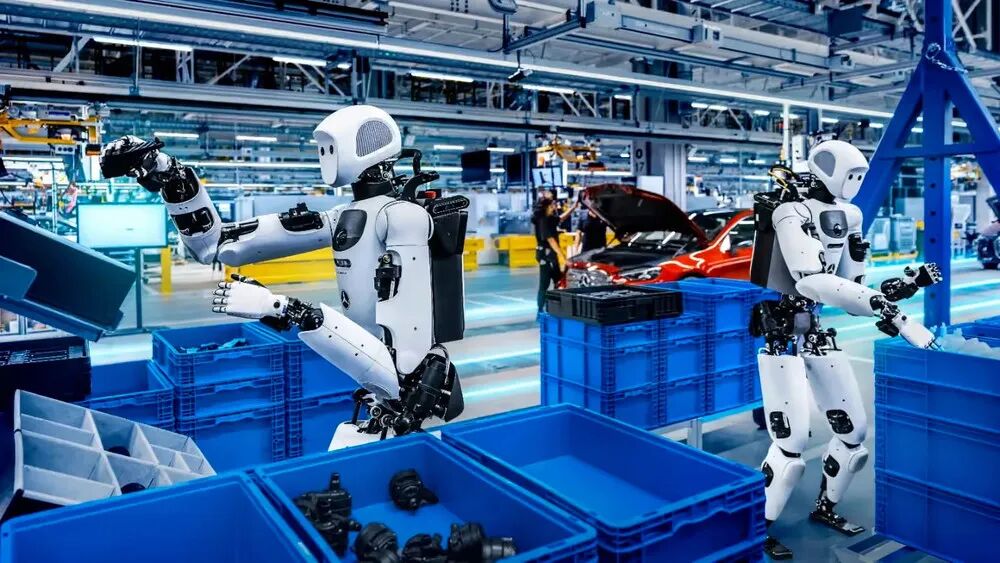
並且,這款模型已經走進汽車工廠。在德國和匈牙利的奔馳生產線上,搭載Gemini Robotics 2.5的Apollo 2人形機器人,能夠自主完成汽車零部件分揀、抓取和擺放,任務成功率達到96%。
啱啱被質疑的具身模型,真的被谷歌救了?
谷歌讓具身大模型進廠了
這一次,谷歌拿出的成績單,比以往更接近真實工業需求。
根據官方披露,Gemini Robotics 2.5主要在三個方面實現提升:靈巧操作、任務可靠性和物理安全性。
首先是操作能力。
谷歌對新模型進行了超過200項任務測試,涵蓋使用夾子夾取食物、給禮盒系蝴蝶結、使用移液管等操作。
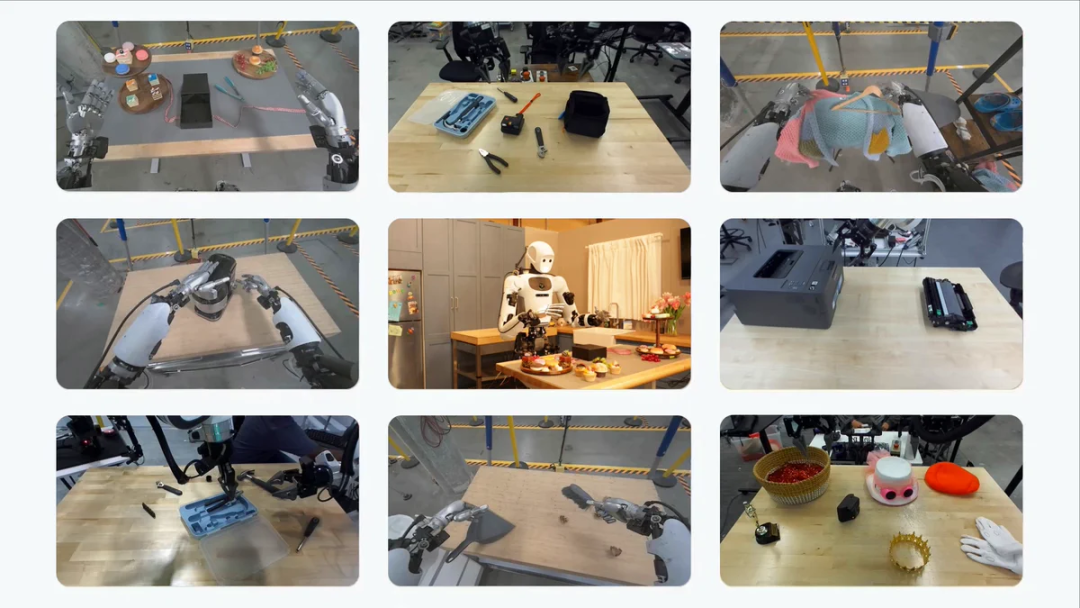
這些任務看起來簡單,對機器人卻並不容易。
以系蝴蝶結為例,機器人需要同時控制雙手,感知絲帶形狀,並根據材料變形不斷調整力度和動作。稍有偏差,絲帶就可能滑落或打結失敗。
在谷歌公布的測試中,新模型用夾子裝取糕點的成功率由此前的5%提高至100%,解開蝴蝶結的成功率由0提高至70%,合上工具箱蓋子的成功率則由0提高至93%。
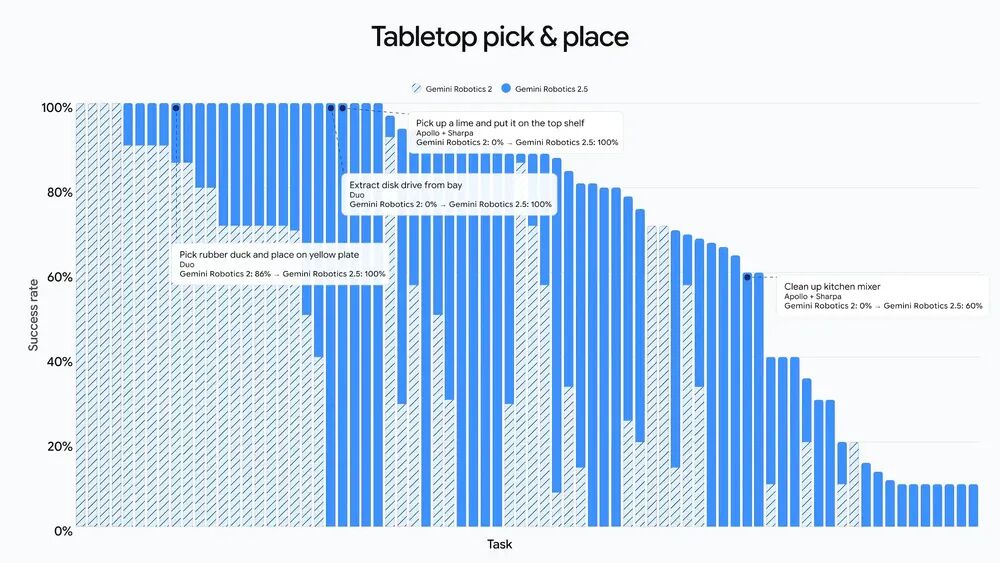
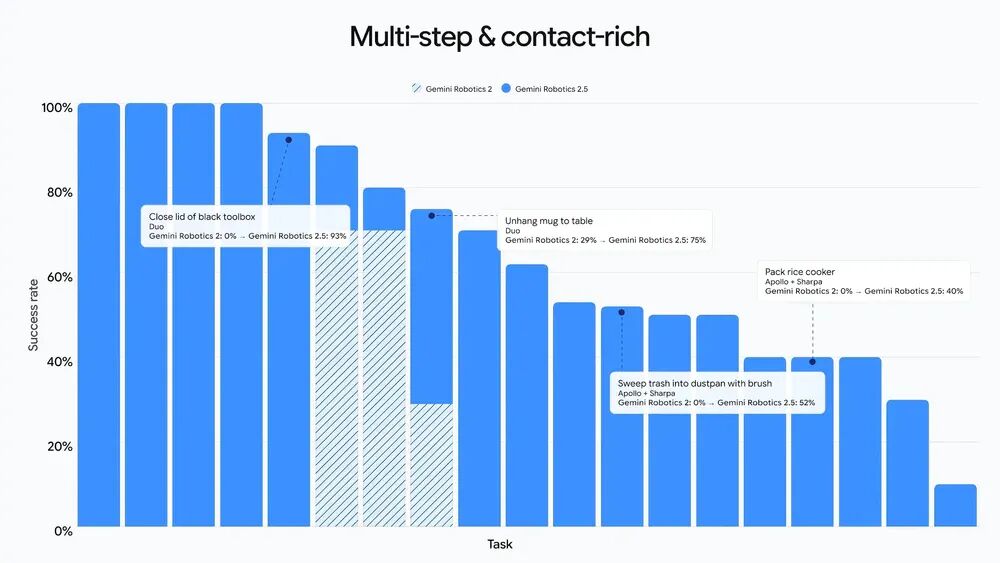
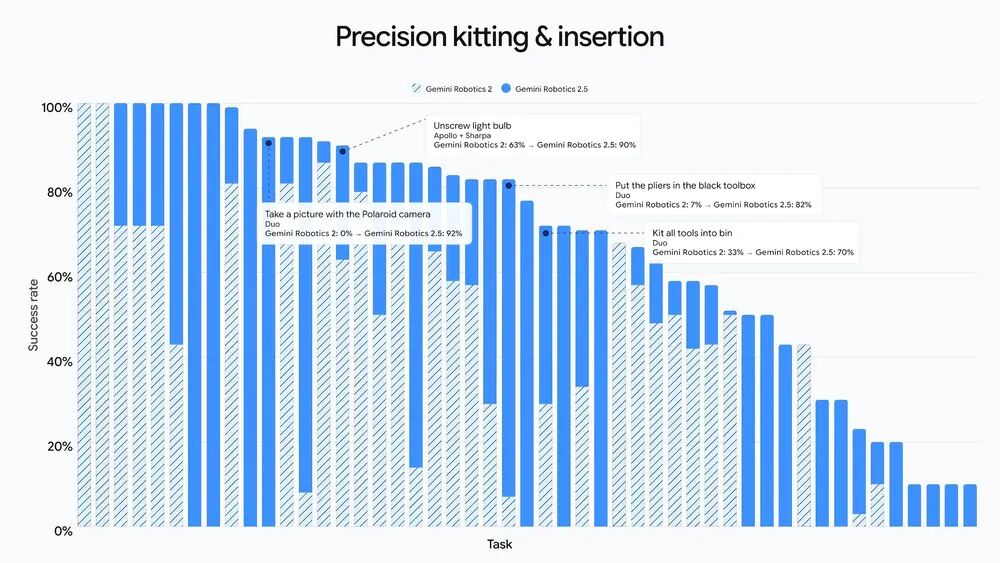
整體來看,相比此前的基準模型,Gemini Robotics 2.5在不同類別任務上的成功率相對提升30%至100%,執行速度提高20%至30%。
同時,新模型能夠適配不同類型的機器人,包括配備五指靈巧手的Apollo 2,以及使用雙指平行夾爪的Franka Duo。
這意味着,谷歌正在嘗試讓同一套機器人智能能力適用於不同硬件形態,減少每換一副機器人身體就重新訓練模型的成本。
但更值得關注的進展發生在奔馳工廠。
在德國辛德芬根和匈牙利凱奇凱梅特的汽車生產線上,谷歌與Apptronik、奔馳合作,讓Apollo 2人形機器人承擔汽車零部件的分揀與配套工作。
具體來說,機器人需要從裝有金屬支架的料箱中取出零件,再按照生產順序放入指定托盤,為後續汽車裝配做好準備。
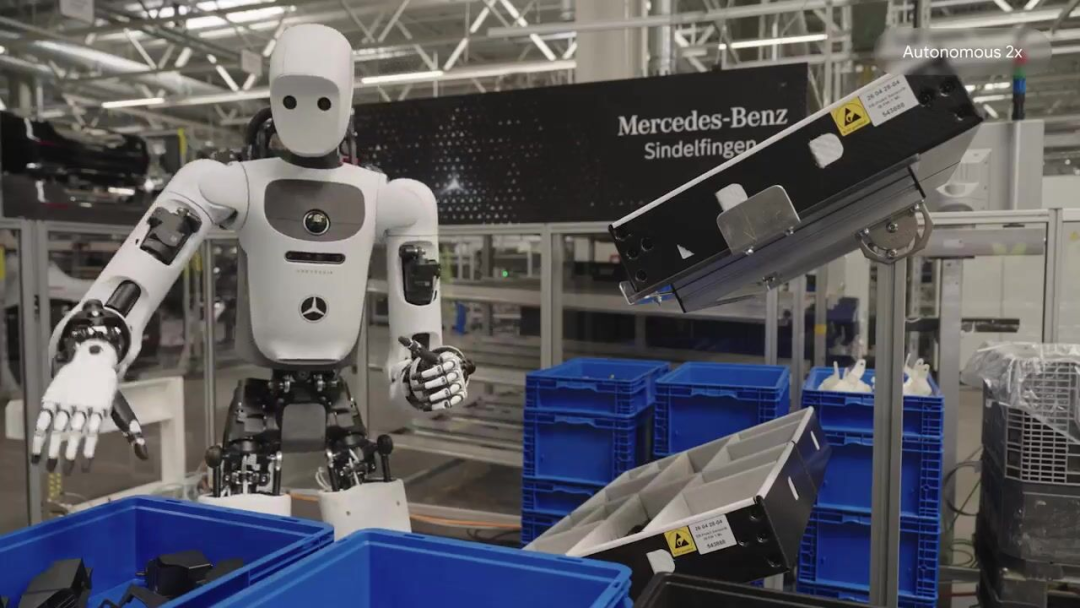
這類工作高度重複,卻要求機器人準確識別、抓取和擺放零件。一旦出現偏差,還需要及時糾正。
谷歌採用了兩套模型協同工作的方式:一套模型理解任務和工作流程,另一套負責控制機器人的手臂與靈巧手,完成具體操作。
最終,Apollo 2在這項概念驗證中取得了96%的任務成功率。
Apptronik聯合創始人兼CEO Jeff Cardenas表示,藉助Gemini Robotics,Apollo 2在短短几周的後訓練中就實現了明顯進步,遷移到奔馳真實生產線後,性能也沒有出現明顯下降。
不過,96%的成功率距離規模化工業應用仍有差距。
谷歌尚未披露完整測試次數、持續運行時長、人工接管頻率,以及機器人與工人之間的生產節拍差異。
對於汽車工廠而言,完成一次分揀和連續穩定工作數千小時,是兩回事。
尤其是在工業生產線上,真正決定機器人能否留下來的,除了操作成功率,還有故障恢復能力、維護成本和投資回報率。
因此,Apollo 2的表現更像是一次頗具說服力的技術驗證,距離大規模商業部署仍有不少問題需要回答。
但至少,谷歌已經證明,具身模型的能力可以從實驗室延伸到真實工業環境。
谷歌讓AI開始訓練AI
相比機器人學會了多少新動作,這次發布還有一個容易被忽略的變化:谷歌正在改變具身模型的訓練方式。
過去,機器人學習新技能,往往需要研究人員反覆採集數據、設計訓練任務,再通過真機測試不斷修正。
這個過程既昂貴又耗時。
尤其是涉及靈巧操作時,機器人需要學習如何控制抓取力度、處理物體變形,以及應對接觸過程中產生的複雜變化。
即便模型在某項任務上取得進展,換一件物品、換一個場景,也可能需要重新訓練。
如今,谷歌試圖讓通用基礎模型承擔一部分工作。
根據Google DeepMind披露,Gemini 4 Argon已經被引入機器人研發流程,用於生成仿真訓練場景、分析失敗原因,以及輔助研究人員改進訓練策略。
例如,研究人員只需要提供真實場景的攝像頭畫面,Argon就能夠幫助構建數字孿生環境,生成數千次不同條件下的模擬練習。
如果機器人在某次操作中失敗,模型還可以分析失敗視頻,提出可能的原因,並協助研究人員在仿真或真機環境中驗證改進方案。
相當於讓機器人擁有了一個能夠反覆組織練習、分析錯誤的AI助手。
當然,這套方法依然需要真實世界的數據和訓練示範,現階段還無法完全擺脫真機採集。
但其潛在價值十分明顯。
過去,機器人掌握一項新技能,需要大量人工參與的試錯過程。隨着通用模型介入,部分訓練工作可以在虛擬環境中完成,研究人員也能更快找到有效的改進方向。
這意味着,具身模型的競爭可能出現新的變化。
此前,行業普遍關注誰擁有更多機器人數據、誰建立了規模更大的數據採集中心。
未來,除了數據規模,模型能否高效利用數據、能否自動發現問題、能否通過仿真加快學習,也將成為重要競爭指標。
而在這方面,擁有強大通用基礎模型、算力和仿真技術儲備的科技巨頭,顯然具備一定優勢。
對於谷歌而言,Gemini 4 Argon和Gemini Robotics 2.5正在形成相互配合的研發體系。
通用模型可以輔助機器人學習,專用模型則持續積累真實世界的操作能力。
這種組合,也為近期的具身模型路線之爭提供了一個新的觀察角度。
具身模型,被谷歌救了?
過去兩年,具身智能行業一直存在兩條不同的技術路線。
一條是專門訓練機器人模型,通過大量真機數據、動作數據和物理交互經驗,讓機器人掌握操作能力。
另一條則是利用通用基礎模型已有的視覺理解、推理和規劃能力,進一步拓展到機器人控制。
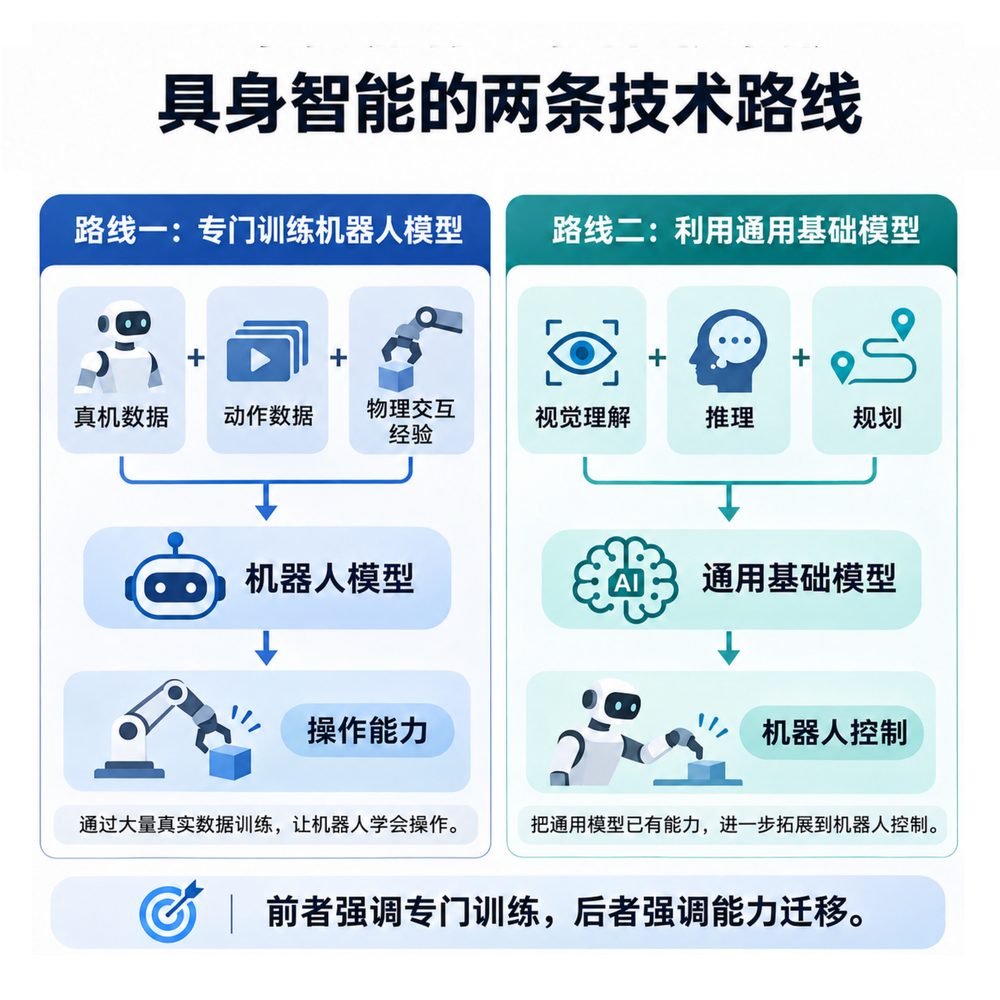
隨着GPT-6 Astra、Claude Fable 5.2等通用模型在機器人任務中不斷取得突破,第二條路線開始受到更多關注。
其背後的邏輯並不複雜。
如果通用模型已經能夠理解環境、規劃動作,甚至控制機器人完成部分任務,那麼企業是否還有必要投入大量資金,從頭訓練一套具身基礎模型?
不過,谷歌的最新進展表明,問題可能沒有這麼簡單。
儘管通用模型已經展現出較強的機器人操作能力,但理解任務與在真實世界中穩定完成操作之間,依然存在差距。
例如,模型可以準確判斷應該怎樣抓取杯子,但真正執行時,還需要處理手指與杯子之間的接觸、抓取力度、機械臂運動,以及物體滑落等問題。
這類連續的物理交互,對控制頻率、動作精度和環境反饋有着更高要求。
通用基礎模型目前還難以獨立解決所有問題。
值得注意的是,即便Anthropic的Claude Fable 5.2在RoboDojo Sim測試中取得了64.9%的成功率,該成績也主要反映特定仿真條件下的操作能力,無法直接等同於真實工業環境中的可靠性。
因此,谷歌依然選擇保留專用VLA模型,通過與推理模型協作來控制機器人。谷歌之外,誰在分層控制機器人?
英偉達最新發布的GR00T 2也採用了類似思路。
在其展示的系統中,通用推理模型負責拆解任務、規劃步驟和檢查進度,GR00T 2則承擔具體的物理動作控制。
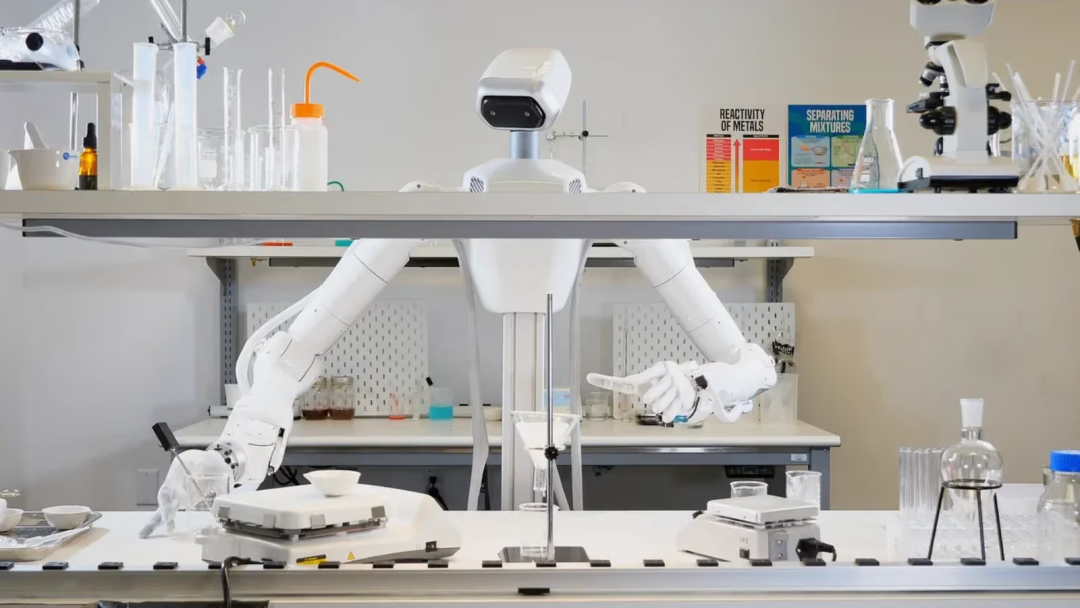
在50項目標機器人未見過的任務中,GR00T 2經過每項任務5次示範和少量微調後,平均成功率達到95%。
兩家巨頭正在探索相似的方向:讓通用模型承擔更多理解與推理工作,同時由專門的機器人模型負責物理操作。
這意味着,具身模型短期內仍有明確的技術價值。
但對於專門研發具身模型的創業公司而言,這未必是個好消息。
當谷歌、英偉達等巨頭同時擁有基礎模型、機器人模型和相關訓練工具時,初創公司的競爭門檻可能被進一步抬高。
尤其是那些主要依靠自研VLA構建技術壁壘的企業,未來需要回答一個更尖銳的問題:相比直接使用巨頭提供的基礎模型,自己訓練的模型究竟好在哪裏?
當然,巨頭也尚未完全掌握機器人市場。
目前,Gemini Robotics 2.5主要向谷歌的機器人合作伙伴開放,尚未全面提供公共API服務。工業客戶的場景需求、硬件配置和數據條件也千差萬別,通用模型距離全面適配仍有較長距離。
這給專業具身模型企業留下了發展空間。
回過頭看,谷歌這次發布或許已經給近期的爭論提供了一個階段性答案。
具身模型仍然有存在的必要,但未來未必需要每家公司都從頭訓練一套。
當通用基礎模型不斷擴張能力邊界,機器人專用模型也將面臨更嚴格的價值檢驗。
谷歌可能救下了具身模型,卻讓一部分具身模型創業公司面臨更殘酷的競爭。
本內容未經允許不得轉載。授權事宜請聯繫 hezuo@huxiu.com。
End
點擊下方【虎嗅嗅小程序】,獲取 AI 行業最新變化。看完記得【添加到我的小程序】中哦~