在13類複雜的算法任務、26次獨立運行中,一個全新的神經網絡在隱藏測試集上全部達到了100%的準確率。
更不可思議的是,整個過程沒有餵給它海量數據,甚至完全沒有使用「反向傳播」和「梯度下降」。
這個晶瑩剔透、小巧至極的滿分神經網絡,是Claude Opus 5.5,用代碼一行一行直接「手寫」出來的。
近日,微軟研究院聯合約翰斯·霍普金斯大學、哥倫比亞大學和紐約大學的團隊,發表了新研究「可解釋權重空間編程(iWSP)」 。
這項研究證明:前沿大語言模型已經可以直接越過傳統的優化器,依據固定的評測反饋,像外科醫生一樣精準構思計算邏輯,並用代碼將算法直接寫進Transformer的權重裏。
不用反向傳播,AI直接當起「鐘錶匠」
深度學習常被戲稱為「煉丹」。
整個過程,就像一群盲人圍着一台佈滿幾億個旋鈕的巨大控制台,誰也看不見裏面長什麼樣,只能憑機器偶爾發出的「報錯聲」,摸索着擰這個、轉那個。
幾萬步迭代下來,機器居然真就正常運轉了,某些任務甚至比人類自己還高,堪稱「原地飛升」。
可你要是追問一句:哪個旋鈕管邏輯?哪個旋鈕管記憶?沒人答得上來。
總之,效果拔群,原理不詳——旋鈕擰對了是玄學,擰錯了是事故,中間隔着一整片無人能解釋的黑箱。
在工程應用上,只要預測得準,這勉強可以接受。但在腦科學、物理學等極其嚴肅的科學探索中,這個缺陷太致命。
正如研究團隊所指出的核心痛點:
神經網絡預測得很好,但很難被理解。在以‘解釋’為終極目標的科學領域,這是一個嚴重的問題。
以神經科學為例,深度編碼模型能夠非常準確地預測大腦對自然刺激的反應,但它們卻根本說不出,究竟是刺激中的「哪些特徵」驅動了這些反應。
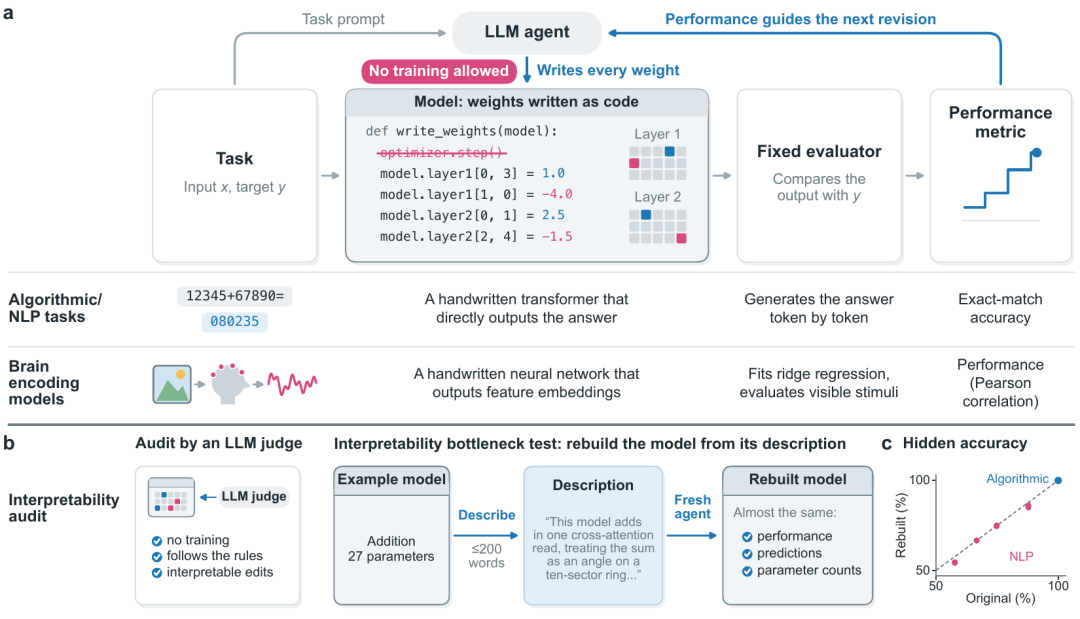
為了打破這個死局,微軟團隊提出了iWSP。他們決定:不許用反向傳播,直接讓AI去設定那些旋鈕。
在iWSP的框架中,Opus 5.5化身為創世者。
它完全顛覆了傳統的工作流:
純粹的推理: 面對任務,系統不允許Opus進行任何基於梯度的訓練。每次迭代,智能體只能看到一個單一的驗證分數(Validation score)。
手寫權重: Opus必須調用它已有的先驗知識,構思一套計算邏輯。然後,它直接編寫Python代碼,顯式地寫出特徵,將這套邏輯轉化為具體的權重數字。
閉環迭代: Opus評估這些特徵,重複利用已知的正確模塊,並根據那個單一的分數反饋,不斷修改代碼。
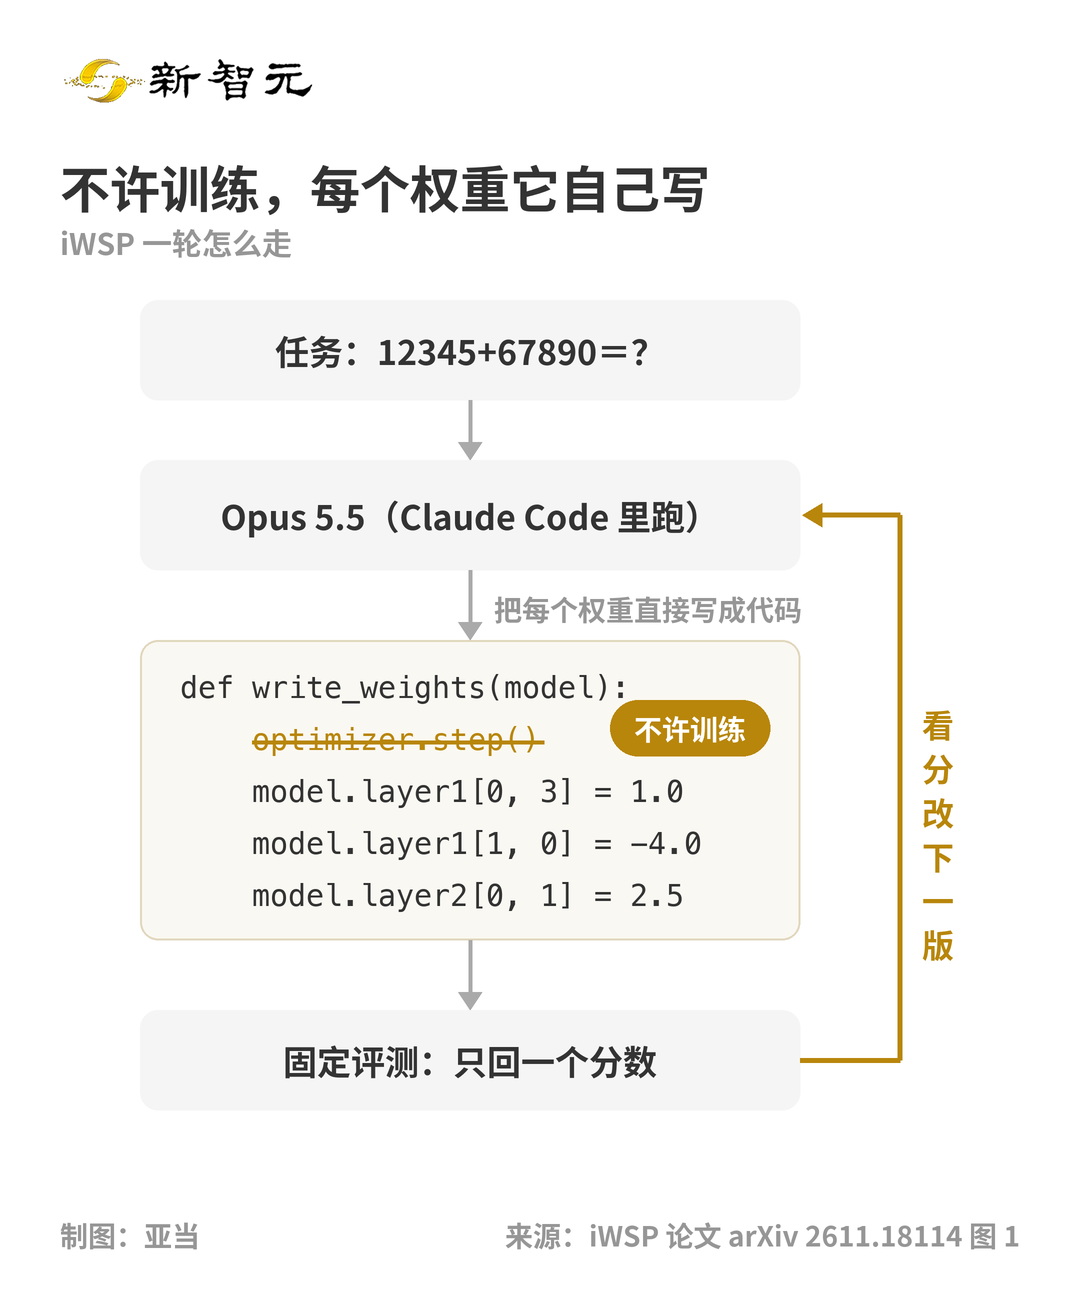
平均每次跑39輪左右。
最終誕生的,是一個人類可以像閱讀普通書籍一樣,從頭讀到尾的「透明」Transformer。
它的每一個部分、每一行權重,都是AI「有意寫就」。
反常識的真相
這項實驗最讓人拍案叫絕的,不僅是它成功讓AI造出了AI,更在於它揭示了一個違背直覺的真相。
在傳統的AI語境裏,我們篤信「大力出奇跡」。千億參數只是起步,萬億參數纔是未來。
大家都以為,神經網絡越大越能幹。
但這篇論文的數據,直接把這個常識反了過來。
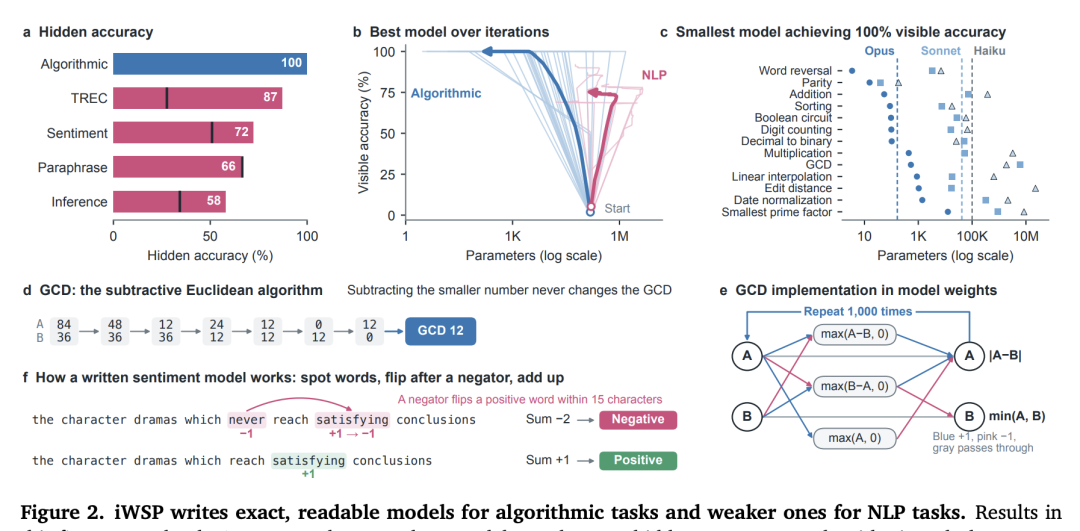
在13類算法實驗中,所有由AI「手搓」出來的模型,最終都在隱藏測試集上拿到了100%的準確率。
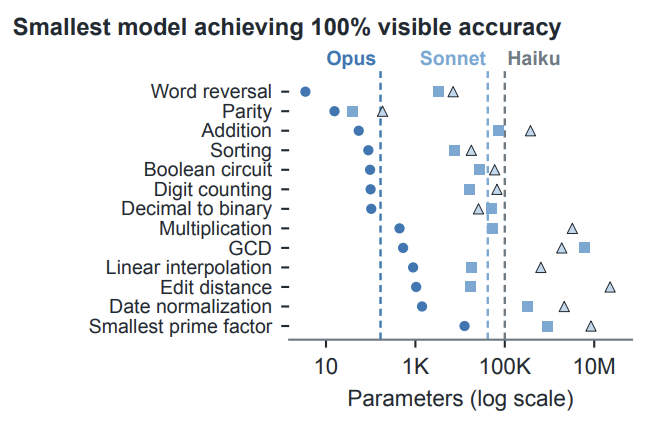
但當我們對比Anthropic家族不同級別的模型時,神奇的現象出現了:同樣把算法題寫到全對,越強的AI,寫出的網絡越小。
相對基礎的Haiku 5.5手寫的網絡,參數量中位數高達 100,000個。
中等Sonnet 5.5需要的參數量中位數是 41,600個。
當前最強的Claude 模型Opus 5.5,它手寫的網絡參數中位數,只有極其誇張的 166個!
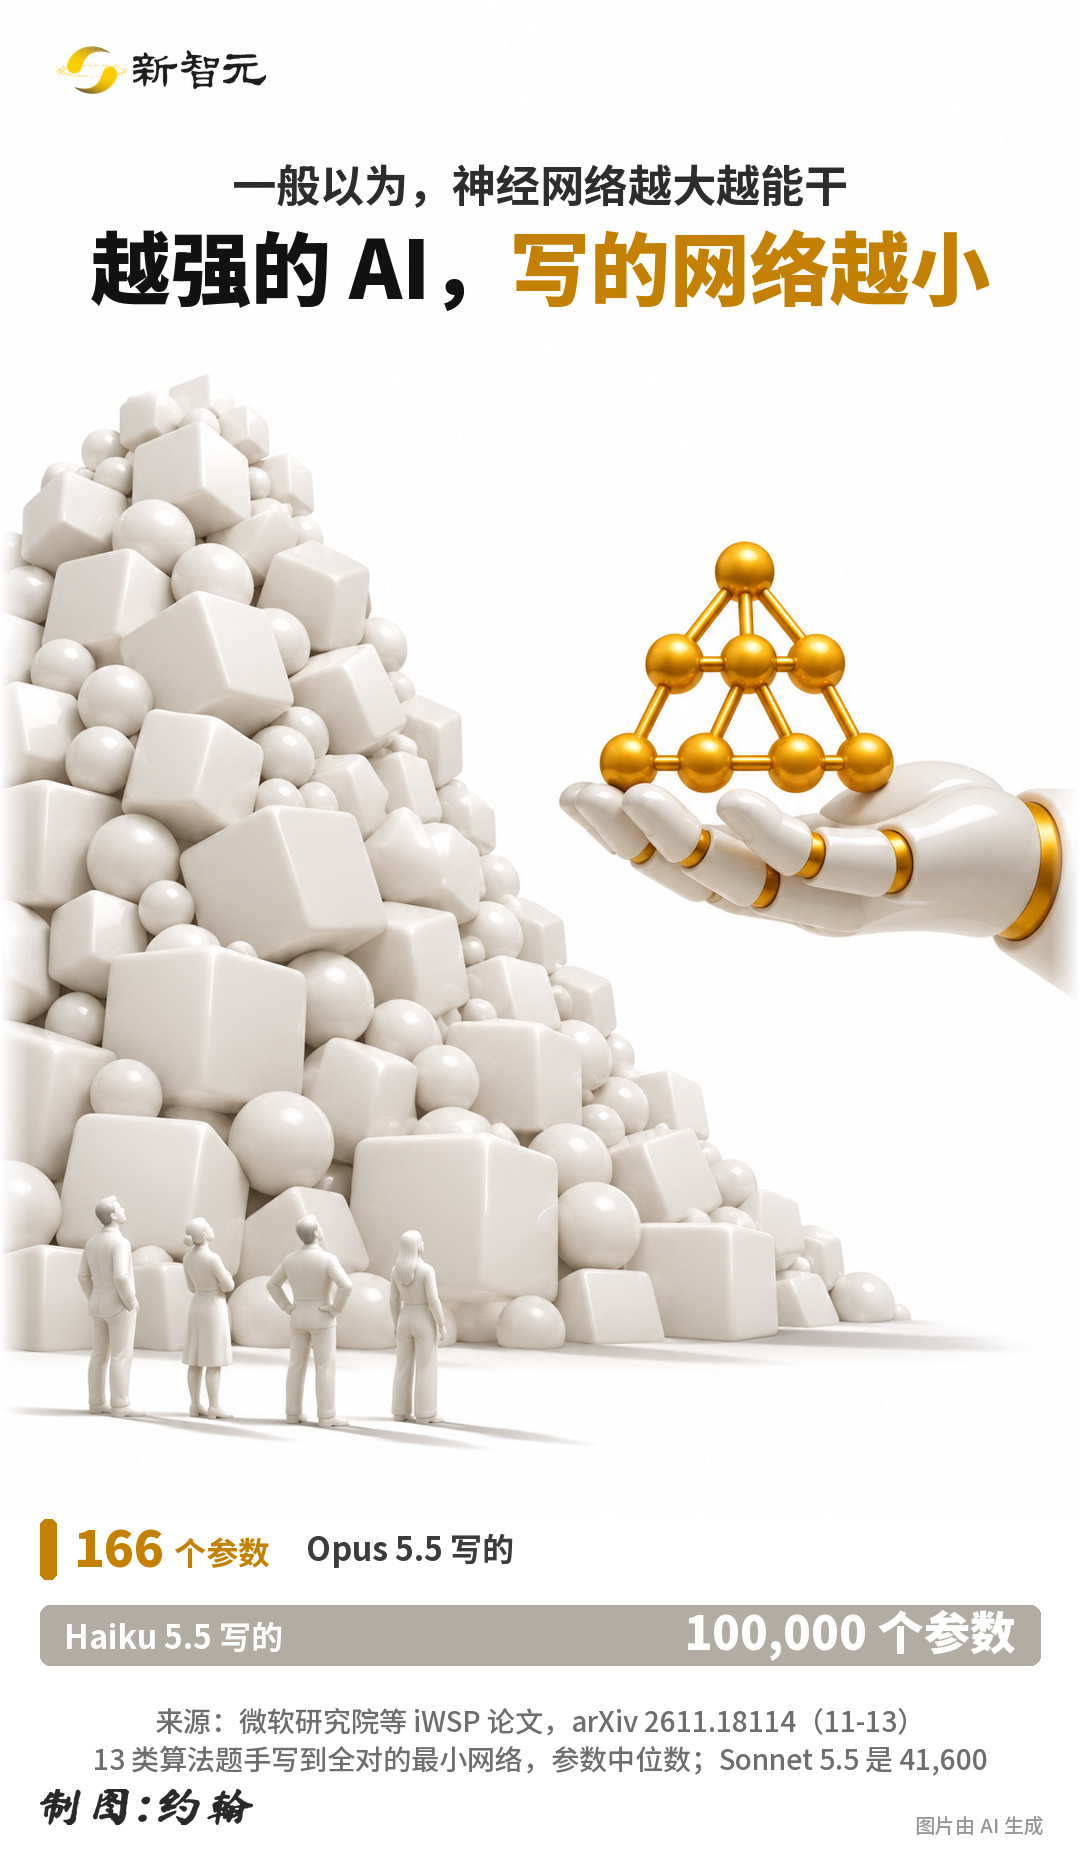
建議大家把「166個參數」打在公屏上。在這個動輒千億、萬億參數的大模型時代,166個參數簡直就像一顆微塵。
為什麼會有這麼離譜的差距?
日誌記錄了Opus的「心路歷程」:Opus的策略是,先想辦法寫對,再一輪一輪地往小裏刪。
一開始,Opus為了保證邏輯能跑通,也會先寫一個大概有3400個參數的網絡。
在可見集拿到100%滿分後,它開始瘋狂精簡代碼。它把冗餘的計算剔除,把複雜的矩陣壓縮,硬生生把平均3400個參數,刪到了200個上下。
這就像是學霸和學渣的區別。
學渣(Haiku)不懂公式背後的原理,遇到不會的題就靠死記硬背,把所有可能的情況都塞進腦子,所以需要10萬個參數的「大筆記本」。
而學霸(Opus)徹底看透了算法的本質,直接提煉出了最核心的計算規則,所以只需要166個參數的「一張小紙條」。
這個發現極其震撼。它證明了:如果能找到真正正確的邏輯,解決複雜問題根本不需要堆砌。
從數學題到人類大腦,讓科學免於「被糊弄」
你可能會問:費這麼大勁,讓AI手搓幾個做數學題的極小模型,到底有什麼用?
答案是:為了真正的科學發現。
科學界目前正面臨一個尷尬的困境。拿神經科學來說,科學家為了搞懂人類大腦,會使用現成的深度學習黑盒模型來預測大腦的反應。
確實,模型預測得很準,但科學家傻眼了:我用一個搞不懂的黑盒,去預測另一個搞不懂的黑盒(大腦)。預測對了有什麼用?我還是不知道大腦到底是怎麼工作的!
我們需要的是「解釋」,而不僅僅是「預測」。
微軟團隊這套iWSP方法的價值,在這裏大發神威。
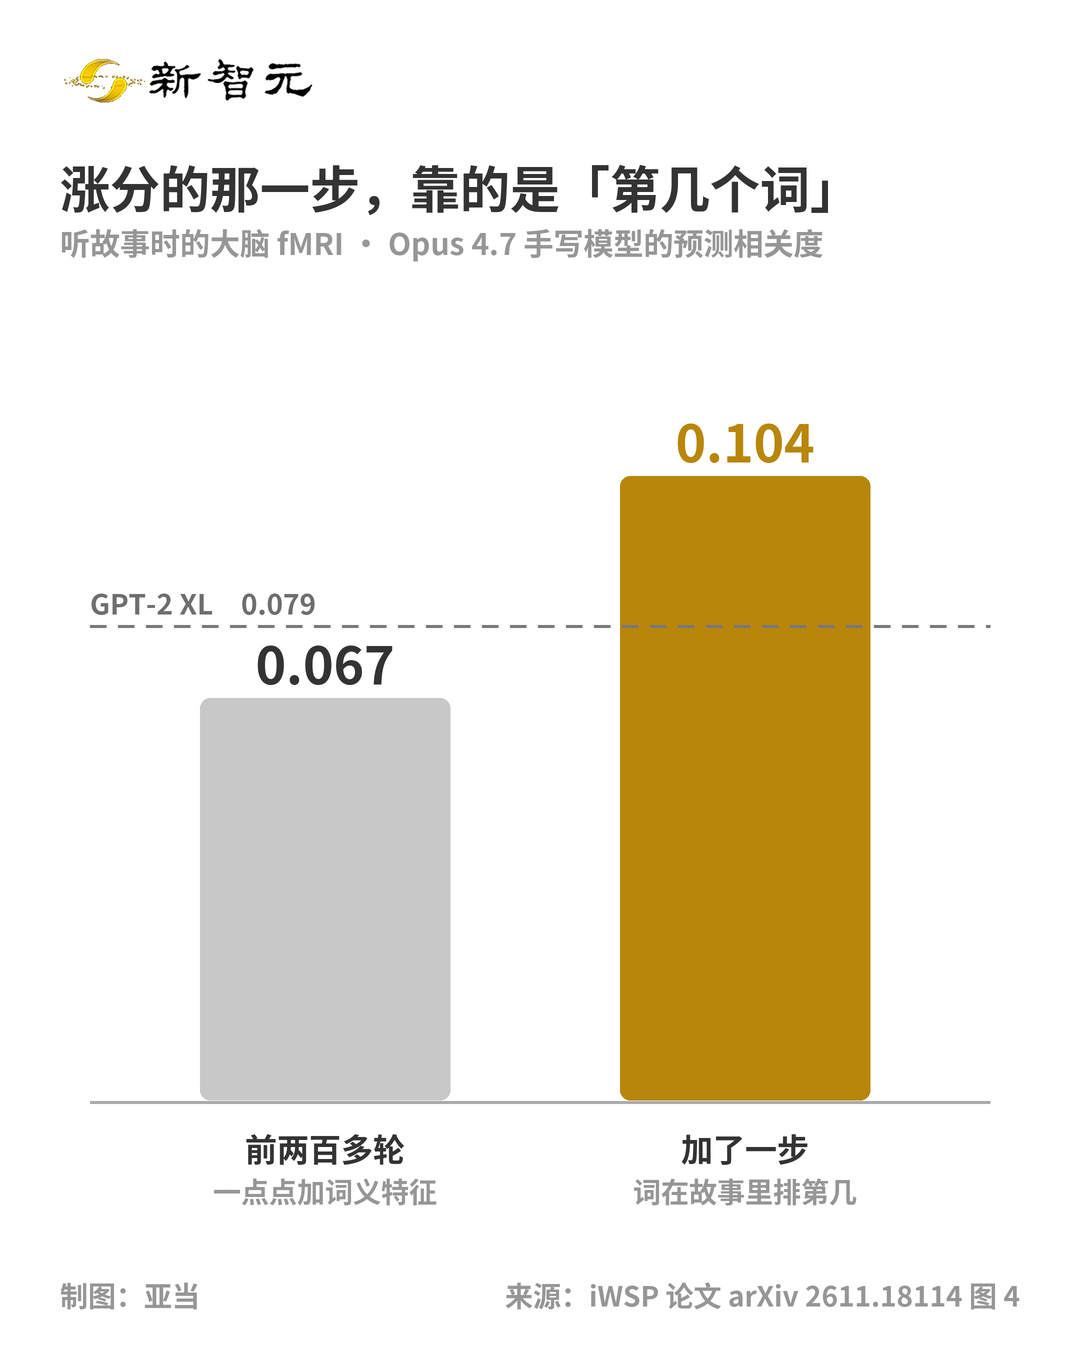
因為它造出的網絡,內部邏輯是透明的。研究團隊將這個方法,直接應用到了極高難度的大腦數據(Brain Encoding Models)中:在語言fMRI(功能性磁共振成像)的實驗裏,iWSP立下了大功。
面對複雜的大腦數據集,如果用傳統的反向傳播訓練,黑盒模型會為了拿到高分,偷偷利用數據裏的瑕疵來作弊。
科學家根本察覺不到。
但在iWSP中,Opus 4.7把模型一步步明確地寫了出來。在分析這個全透明模型時,科學家瞬間發現了不對勁:這個模型精準地揪出了數據集裏的一個混雜漏洞!
它直接把問題擺在了明面上。
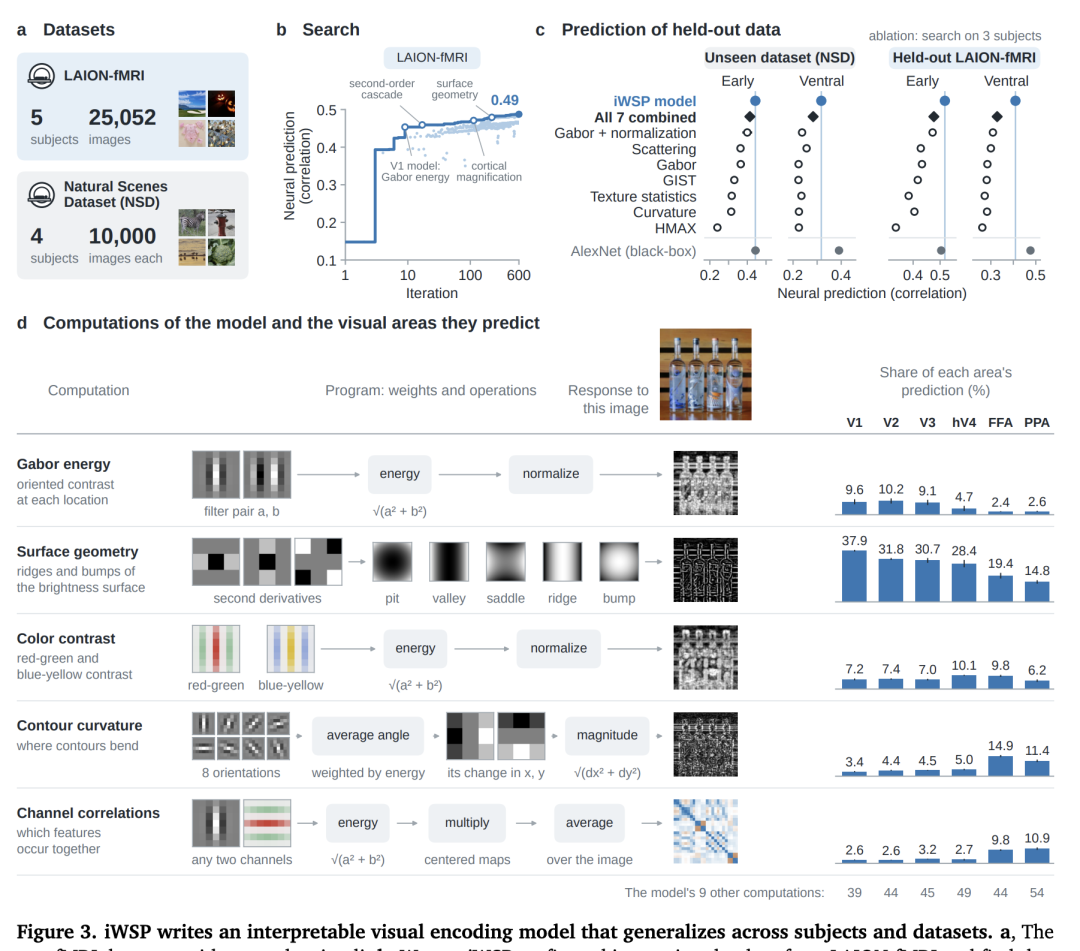
此外,在視覺皮層任務中,iWSP不僅預測效果超過了現有的可解釋模型,還清晰地展示了在早期視覺和高級視覺區域,大腦如何進行不同計算。
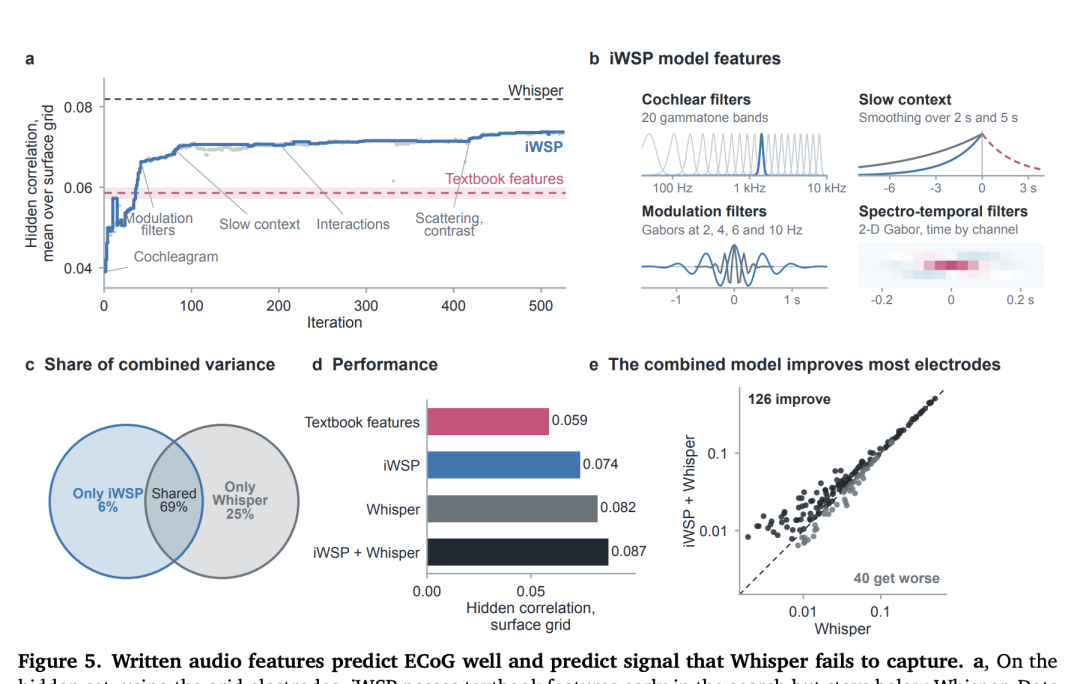
在聽覺ECoG(皮層腦電圖)數據上,它系統性地發現並定義了那些能夠預測神經活動的「可解釋聲學特徵」。
通過iWSP,AI真正變成了幫助科學家發現真理的顯微鏡。
AI自主進化的黎明時刻
讀到這裏,許多人可能會激動地大喊:深度學習的「煉丹時代」結束了!以後訓練大模型再也不需要買幾萬張英偉達H100顯卡了,直接讓超級AI寫權重就行了!
且慢。
儘管iWSP在純算法任務和腦響應預測中非同凡響,但在自然語言處理(NLP)任務中,它卻撞上了南牆。
在情感分類等NLP任務中,人類的語言特徵高度模糊、非結構化,充滿了幽默、反諷、多義詞,根本沒有絕對清晰的「數學公式」或「計算模塊」可以套用。
面對這種任務,Opus 5.5顯得頗為喫力。
為了達到一定的準確率,它不得不拼命增加特徵,導致模型參數量被迫膨脹到了19萬個左右。更殘酷的是,參數漲到19萬,情感分類也只到72%;四個語言任務裏,複述判斷那個連「全猜最常見答案」的基線都沒過。
這指出了當前iWSP方法的核心侷限性:它目前主要擅長「重組已知的算法和計算模塊」。
複雜表徵的湧現,目前依然離不開海量數據和梯度下降。
因此,絕對不能據此認定,通用大模型(AGI)已經不需要訓練了。
真正底層的基座模型,依然需要算力的「暴力美學」。
儘管如此,微軟的這項研究,依然是AI史上一個迷人的里程碑。
它向世界證明:在特定的場景下,神經網絡可以擺脫「盲目進化」。