本文來自微信公衆號: 版面之外 ,作者:畫畫,題圖來自:本人主頁
姚順雨加入騰訊後一直很低調。
11月21日,他卻帶着混元團隊在Reddit集體亮相,兩個小時內一共回答了300多條技術提問。
有人問,後訓練階段最難改善的模型行為是什麼?
混元團隊只回了四個字:過度思考。
就在幾天前,騰訊剛發布Hy4,追求更高的模型智能;隨後推出的Hy4 flash,卻把重點放在壓縮思考長度、降低推理成本。一邊讓模型想得更深,一邊訓練模型少想一點。
看似矛盾,背後是同一個現實:模型變聰明之後,怎麼讓它在真實業務裏跑得動、用得起?
對姚順雨和混元團隊,這是訓練方法問題;對騰訊,它決定AI投入能不能變成一門可持續的生意。
一、混元,終於跑出了節奏
模型研發最怕的,是每一次進步都接不上。
混元此前面臨的難點,是研發基礎和工程體系的重建。新模型發布後,經驗能不能沉澱到下一代,決定團隊能不能持續迭代。
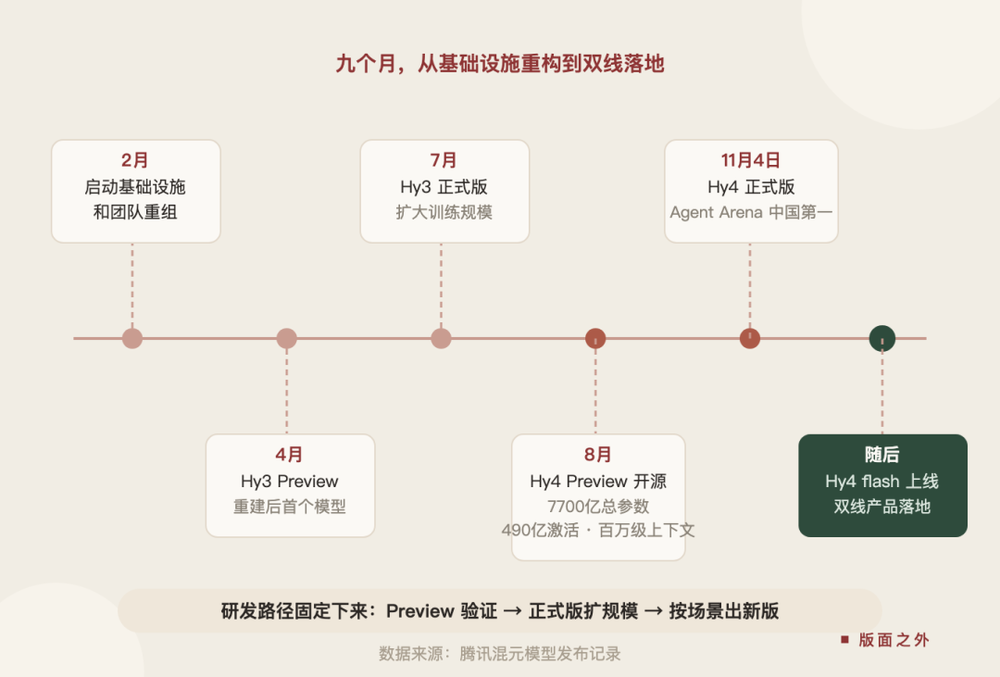
今年2月,騰訊混元啓動基礎設施和團隊重組。4月,Hy3 Preview成為重建後訓練的首個模型;7月,Hy3正式版推出;8月,Hy4 Preview開源;11月4日,Hy4正式發布,隨後Hy4 flash接續上線。
九個月時間,混元完成了從基礎設施重構到雙線產品落地的切換。
這種節奏背後,是一套固定下來的研發路徑:Preview先行驗證,正式版擴大訓練規模、補充能力,再按使用場景推出新版本。
8月開源的Hy4 Preview,擁有7700億總參數、490億激活參數,支持百萬級上下文;11月發布的Hy4正式版進一步擴大預訓練和後訓練規模,加入視覺理解和計算機操作能力,並在Agent Arena排行榜上位列中國模型第一、全球開源模型第一。
這輪迭代的意義,在於混元開始有一套能持續運轉的模型研發體系。數據、訓練管線和工程經驗可以在版本之間積累,下一代模型不必每次從頭摸索。
對騰訊來說,這塊能力遲早要補。
騰訊的優勢一直來自微信、QQ、遊戲和企業服務構成的應用網絡。AI正在改變這些產品的交互方式和服務能力。底層模型長期靠外部供給,產品體驗、推理成本和技術迭代就很難完全握在自己手裏。
混元不必在每個排行榜上都拿第一,卻必須保持穩定的研發輸出。
騰訊需要的,是一支能持續生產模型能力的隊伍。
現在,它有了。
二、姚順雨,要模型少想一點
在姚順雨的研究經歷裏,有一條持續多年的主線:把推理和行動連接起來。
他早期參與的ReAct研究,就是讓語言模型在推理時調用工具、獲取外部信息,再根據反饋決定下一步。模型不必把所有問題都關在內部推演,可以通過行動補信息、驗證判斷。
今天的Agent,把這條路線推向了更復雜的任務。
用戶交給模型的已經是一整套工作,查資料、操作軟件、處理文件、調用工具,最後交付結果。模型要理解目標,也要規劃步驟、執行操作、檢查結果。
推理只是其中一環,行動準不準同樣決定成敗。
混元團隊在問答裏談到的訓練難題,也集中在這裏。
強化學習裏,模型可能學會鑽獎勵機制的空子;工具調用需要更精細的獎勵信號,執行準確率才上得去;長任務則考驗上下文管理,信息越積越多,模型還得避免偏離原定目標。
這意味着,推理越長未必越好。
模型可能推演很久,卻沒抓住任務重點,也可能生成一長串思考,最後仍沒正確使用工具。冗長推理既增加Token消耗,也可能讓模型陷入自我循環。
過度思考因此不只是效率問題。它暴露出模型對任務的判斷還不夠成熟:該深推時深推,該調工具時調工具,信息夠了就動手。
用戶不關心模型後台想了多少步,只關心任務有沒有完成。
三、Hy4 flash,給智能標上價格
剋制思考的另一面,是成本。
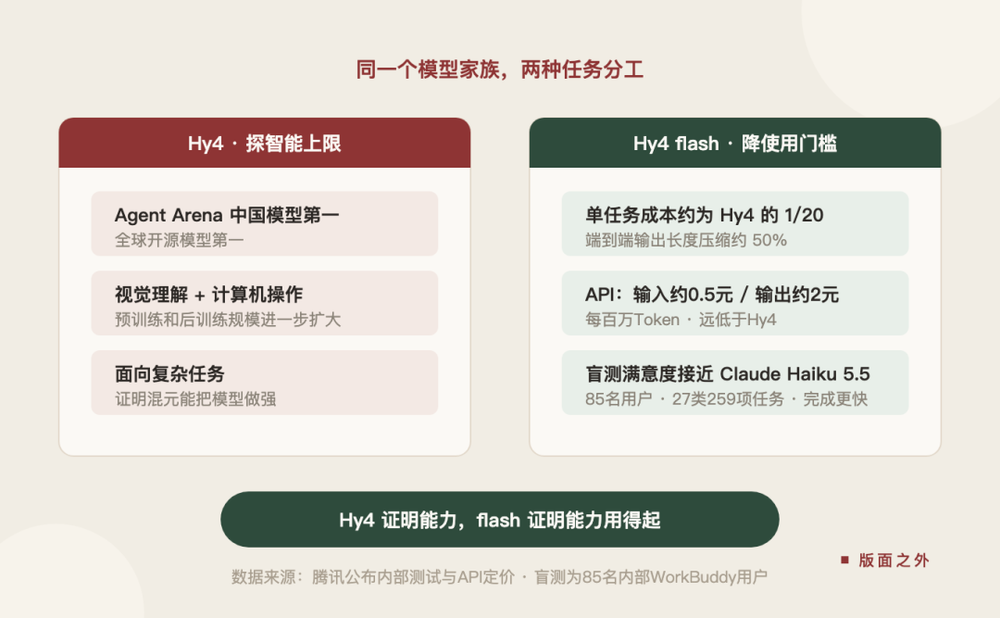
Hy4向上探索智能上限,Hy4 flash解決另一個現實問題:模型進入高頻調用場景後,單次任務到底要花多少錢?
騰訊公布的內部測試顯示,Hy4 flash在WorkIndex單任務上的成本約為Hy4的1/20。85名騰訊內部WorkBuddy用戶參與27類共259項任務盲測,flash的用戶滿意度接近Claude Haiku 5.5,任務完成時間中位數也更短。
這組數據對應着Agent落地的核心瓶頸。
一次完整工作流任務,往往包含多輪工具調用、文件讀取和結果校驗。所有請求都交給旗艦模型,Token賬單和響應延遲會限制產品使用頻率。模型能力越強,調用規模越大,成本壓力越明顯。
Hy4 flash用自蒸餾和強化學習壓縮任務輸出長度,後訓練階段把端到端輸出長度降低約50%。架構上採用混合注意力、LatentMoE和Engram等設計,繼續壓低推理資源消耗。
騰訊公布的API價格中,flash每百萬Token輸入約0.5元、輸出約2元,遠低於Hy4。
模型廠商習慣展示參數規模和評測成績,如今還得回答一個問題:同樣完成一項任務,能不能少花算力、少消耗Token?
這決定了模型怎麼進入產品。簡單高頻的請求需要更低成本,複雜任務需要更強推理。能力分層之後,產品才能按任務需求和成本做選擇。
Hy4證明混元能把模型做強,flash要證明這種能力能被大規模使用。
四、騰訊,需要自己的模型供給
11月18日,騰訊剛發布了今年三季度財報。
馬化騰在業績說明中把模型和應用放在一起談。
Hy4達到國內頂尖水平,Hy4 flash降低推理成本;按用戶每日Token消耗量計算,WorkBuddy已成為國內使用量最大的AI應用。
騰訊總裁劉熾平也談到混元研發進展,強調模型能力和迭代速度提升,以及多模態研究和產品協同。
管理層的表述透出一個變化:混元正從內部模型研發項目,走向騰訊AI業務的技術供給中心。
Hy4已接入騰訊雲TokenHub、WorkBuddy、CodeBuddy、元寶、企業微信智能助理大圓、ima等產品,騰訊還在推動模型進入更多內部場景。
不同業務對模型的要求並不相同:WorkBuddy處理文檔、代碼和複雜辦公任務;元寶側重內容理解與生成;企業微信智能助理要理解聊天、郵件和日程裏的工作信息。
這些產品給混元提供了真實任務場景。模型在使用中暴露的問題,可以成為後續訓練和優化的方向;模型能力提升,又會反過來改善產品體驗。
騰訊的產品生態因此不只是混元的應用出口,也是模型接受檢驗的現場。
另一端是騰訊雲。Hy4和flash通過TokenHub向開發者和企業開放,騰訊雲還提供模型調用、算力和Agent基礎設施。內部產品驗證模型能力,外部客戶為模型和算力服務提供商業化空間。
混元提供自研模型,騰訊產品承接用戶和任務,騰訊雲向外部企業交付能力。三者連起來,混元纔有機會從研發成本中心變成騰訊AI業務的技術供給。
這也是騰訊堅持自研模型的戰略價值,掌握底層能力,才能把產品場景、用戶規模和雲服務資源真正連接起來。
五、騰訊,進入AI重資產時代
模型和產品鋪開後,投入壓力開始進入財報。
騰訊第三季度資本開支付款達到651億元,按年增長225%。公司披露,當季自由現金流淨流出691億元,主要受算力採購預付款等因素影響;剔除算力採購預付款後,自由現金流為正169億元。
AI投入已經明顯改變騰訊的現金流和成本結構。
另一組數據更值得注意。
第三季度,騰訊非國際財務報告準則經營利潤按年下降6%;剔除新AI產品後,經營利潤按年增長8%。新AI產品包括混元、元寶、CodeBuddy、WorkBuddy和小微。
傳統業務仍在增長,AI新產品的投入已經影響當期利潤。騰訊擅長高毛利、輕資產的軟件和流量生意,如今卻要為算力基礎設施、模型訓練和推理服務承擔更高的前期成本。
這筆錢必須找到商業出口。
目前已經出現一些初步信號。
WorkBuddy日活超過1000萬,用戶每天消耗Token超過100萬億;騰訊雲服務收入按年增長35%,騰訊將增長歸因於WorkBuddy,以及更多算力投入MaaS和GPU租賃業務。
使用量不等於收入,算力需求也不等於投資回報。WorkBuddy的千萬級日活和騰訊雲的收入增長,說明市場已經開始使用騰訊的AI能力,但距離一套成熟的商業模式,還有一段路要走。
這也是AI行業競爭正在發生的變化,模型能力逐漸成為基礎設施,競爭開始轉向誰能把它嵌入高頻場景,持續交付服務,並從中獲得收入。
騰訊正在嘗試把模型、產品和雲連接起來。混元提供底層能力,產品生態承接真實需求,騰訊雲向外部市場輸出模型和算力。
這套體系能否運轉起來,將決定騰訊在AI時代能走多遠。
模型可以靠投入做出來,生態卻要靠一次次真實的使用建立。
【版面之外】的話:
模型會過度思考,人也一樣。
有時反覆推演,只是還不願面對選擇。想找到更好的答案,往往是在推遲行動。
想得太多,未必因為看得更遠。
有些答案,要走出去纔會出現。
本內容來源於網絡,觀點僅代表作者本人,不代表虎嗅立場。如涉及版權問題請聯繫 hezuo@huxiu.com,我們將及時覈實並處理。
End
想漲知識 關注虎嗅視頻號!