两周时间,10 万颗国产 AI 加速器,一个开始优化自己的模型。
就在刚刚,智谱 GLM 首席科学家唐杰在 X 平台分享了一项关于 GLM-5.3-Flash 推理系统优化的研究。
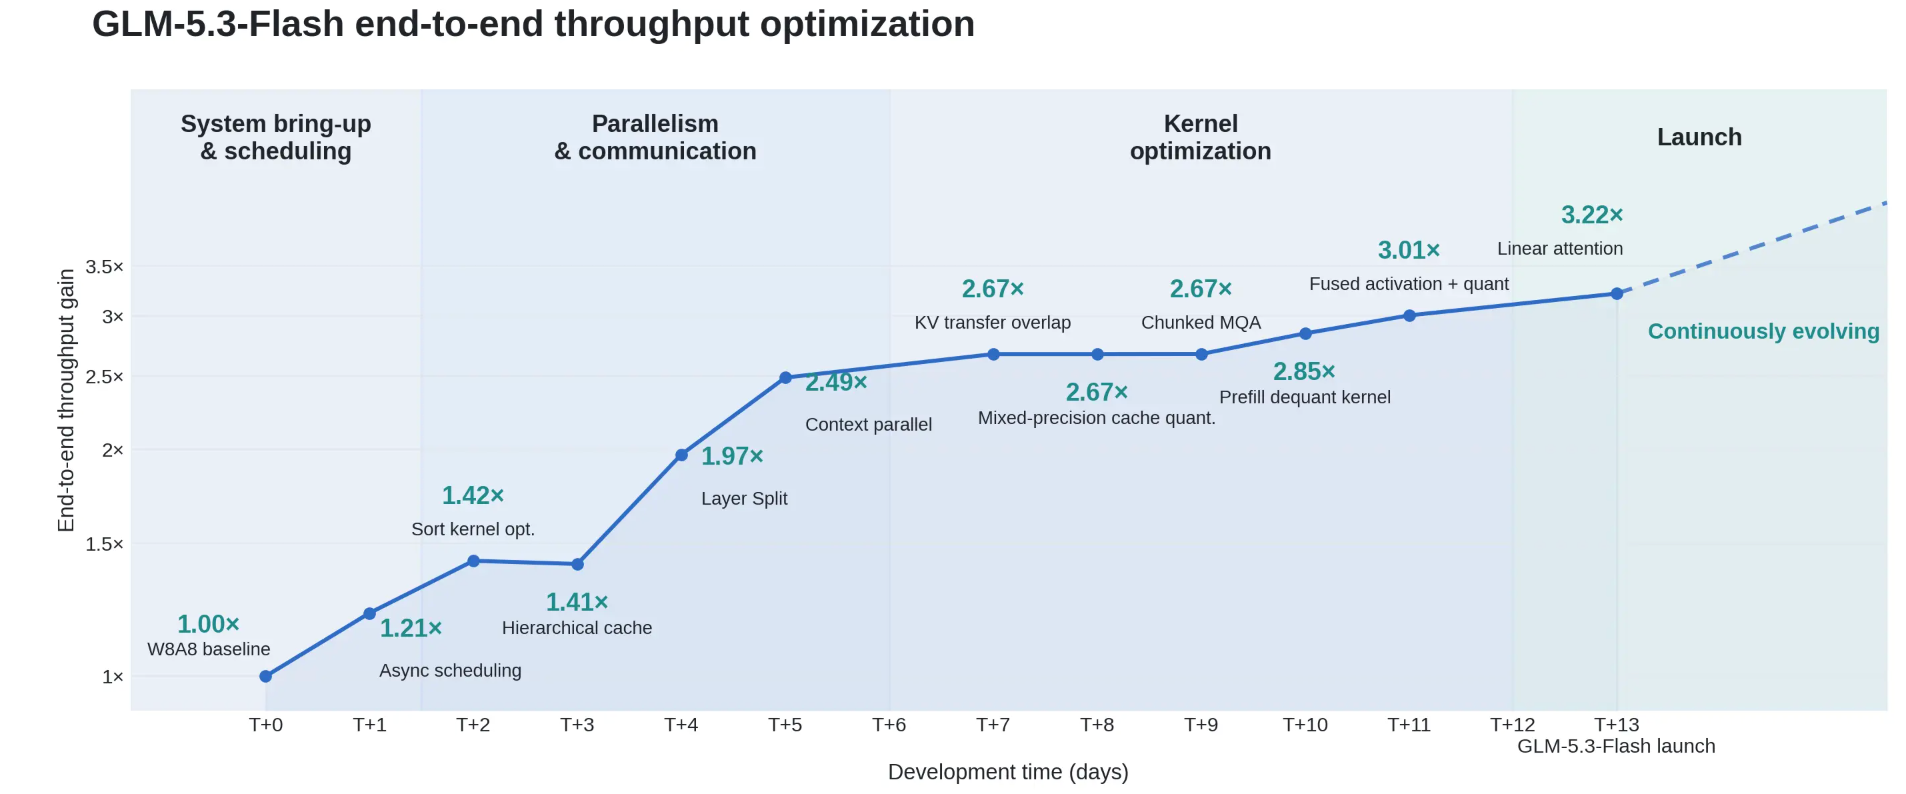
他透露,从 GLM-5.3-Flash 首次运行在国产 AI 加速器上,到完成全部生产流量承载,仅用了两周时间。在这个过程中,系统端到端吞吐能力提升了 3.2 倍。
最让唐杰印象深刻的是,完成大量优化工作的并非只有基础设施工程师,还有一个由 GLM-5.3 驱动的 Infra Agent。
“一个帮助优化服务自身的模型。”唐杰这样描述这一变化。
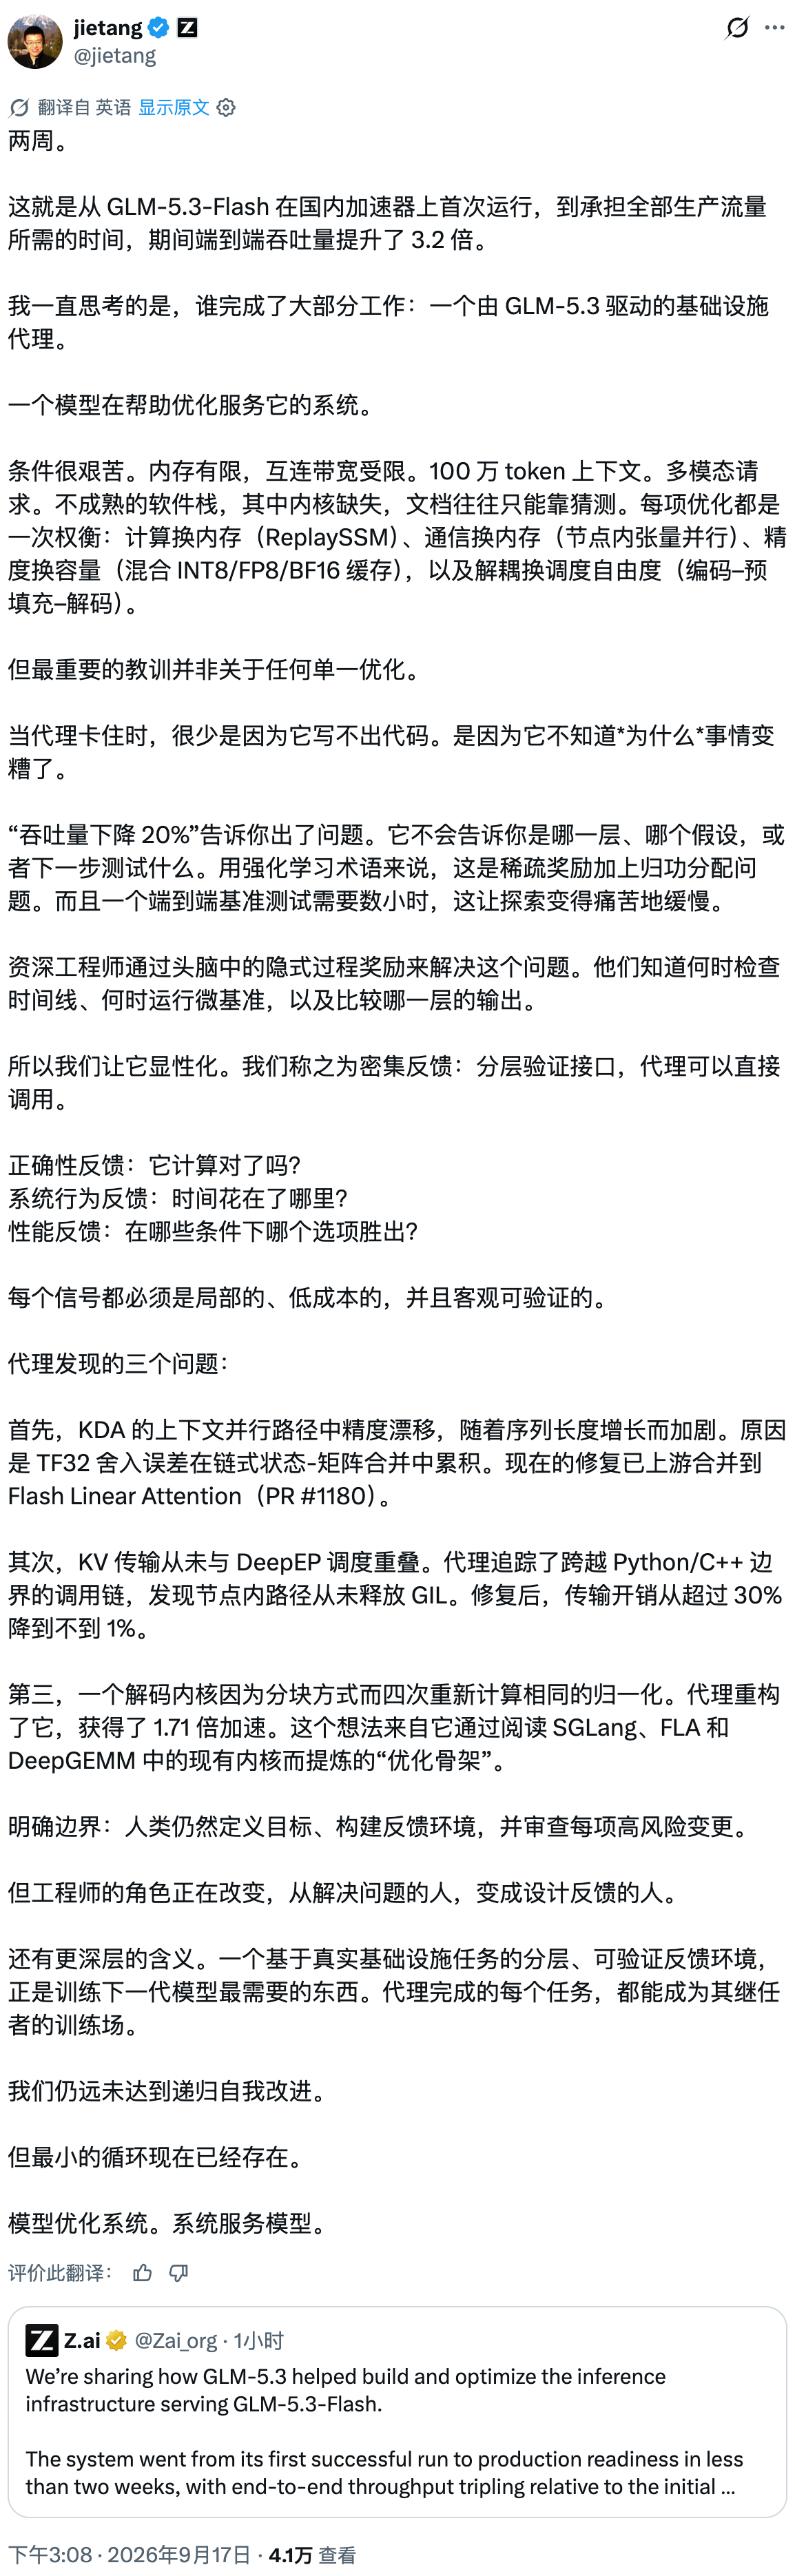
在他看来,这意味着 AI 开始参与优化承载自身运行的系统。虽然距离真正意义上的递归自我改进(Recursive Self-Improvement,RSI)仍然很远,但一种早期形态已经出现。
智谱团队也提到,过去一年里,他们观察到 GLM 的角色正在发生变化。
最初,团队探索 GLM 在代码理解和网络安全领域的能力,希望让模型帮助分析复杂代码中的漏洞。但随着模型能力提升,GLM 开始参与构建 AI 系统本身。
团队表示,他们曾观察到模型完成一些过去需要资深基础设施工程师团队花费数周才能完成的任务,而这些工作又会直接影响下一代模型训练和部署方式。
两周完成国产算力集群部署
将一个大模型从新硬件上的首次运行,推进到能够稳定承载生产请求的推理服务,需要大量系统工程工作。
GLM-5.3-Flash 此次部署运行在超过 10 万颗国产 AI 加速器组成的集群上。智谱团队表示,这是一次此前缺少成熟经验参考的大规模部署。
团队需要解决多个问题,包括国产芯片显存容量和互联带宽限制、新模型架构适配、100 万 token 长上下文支持,以及多模态请求处理等。与此同时,国产 AI 加速器的软件生态仍处于发展阶段,部分 Kernel 支持不足,很多资料也需要工程团队自行探索。
唐杰表示,在这些限制条件下,GLM-5.3 驱动的 Infra Agent 参与了推理系统优化过程,帮助分析性能瓶颈、提出优化方案,并完成部分代码修改。
整个优化过程并不是简单增加计算资源,而是在算力、内存、通信和调度之间寻找新的平衡。
智谱团队采用了一系列优化方案。例如,通过 ReplaySSM 用计算换取内存空间,通过节点内张量并行降低显存压力,通过 INT8、FP8、BF16 混合精度缓存提高容量利用率,同时引入 Encode-Prefill-Decode(EPD)分离式架构,让不同推理阶段能够更加灵活地调度。
最终,GLM-5.3-Flash 的端到端服务性能相比初始版本提升约 3 倍,硬件利用率和单 token 成本达到接近主流 NVIDIA GPU 平台的水平。
部署完成后,GLM-5.3-Flash 还进入真实使用环境测试。智谱团队介绍,该模型曾以匿名模型名 Ox-Alpha 运行在 OpenCode 和 OpenRouter 平台,一周内成为两个平台使用量最高的模型之一,六天处理超过 62 万亿 token。
不过,这次实验真正的变化,并不只是让 AI 写代码,而是让 AI 能够理解复杂系统为什么出现性能变化。
唐杰提到,Infra Agent 遇到困难时,很少是因为无法编写代码,而是无法判断“为什么结果变差”。
例如,当系统反馈“吞吐下降 20%”时,它只能说明某个地方出现异常,却无法直接告诉 Agent 哪一层出了问题,当前假设是否错误,以及下一步应该验证什么。
对于资深工程师来说,这类判断依赖长期经验。工程师知道什么时候查看执行时间线,什么时候运行微基准测试,以及应该比较哪个模块的输出。
智谱团队希望把这种工程经验转化为 AI 可以调用的反馈机制,并将其称为“dense feedback”。
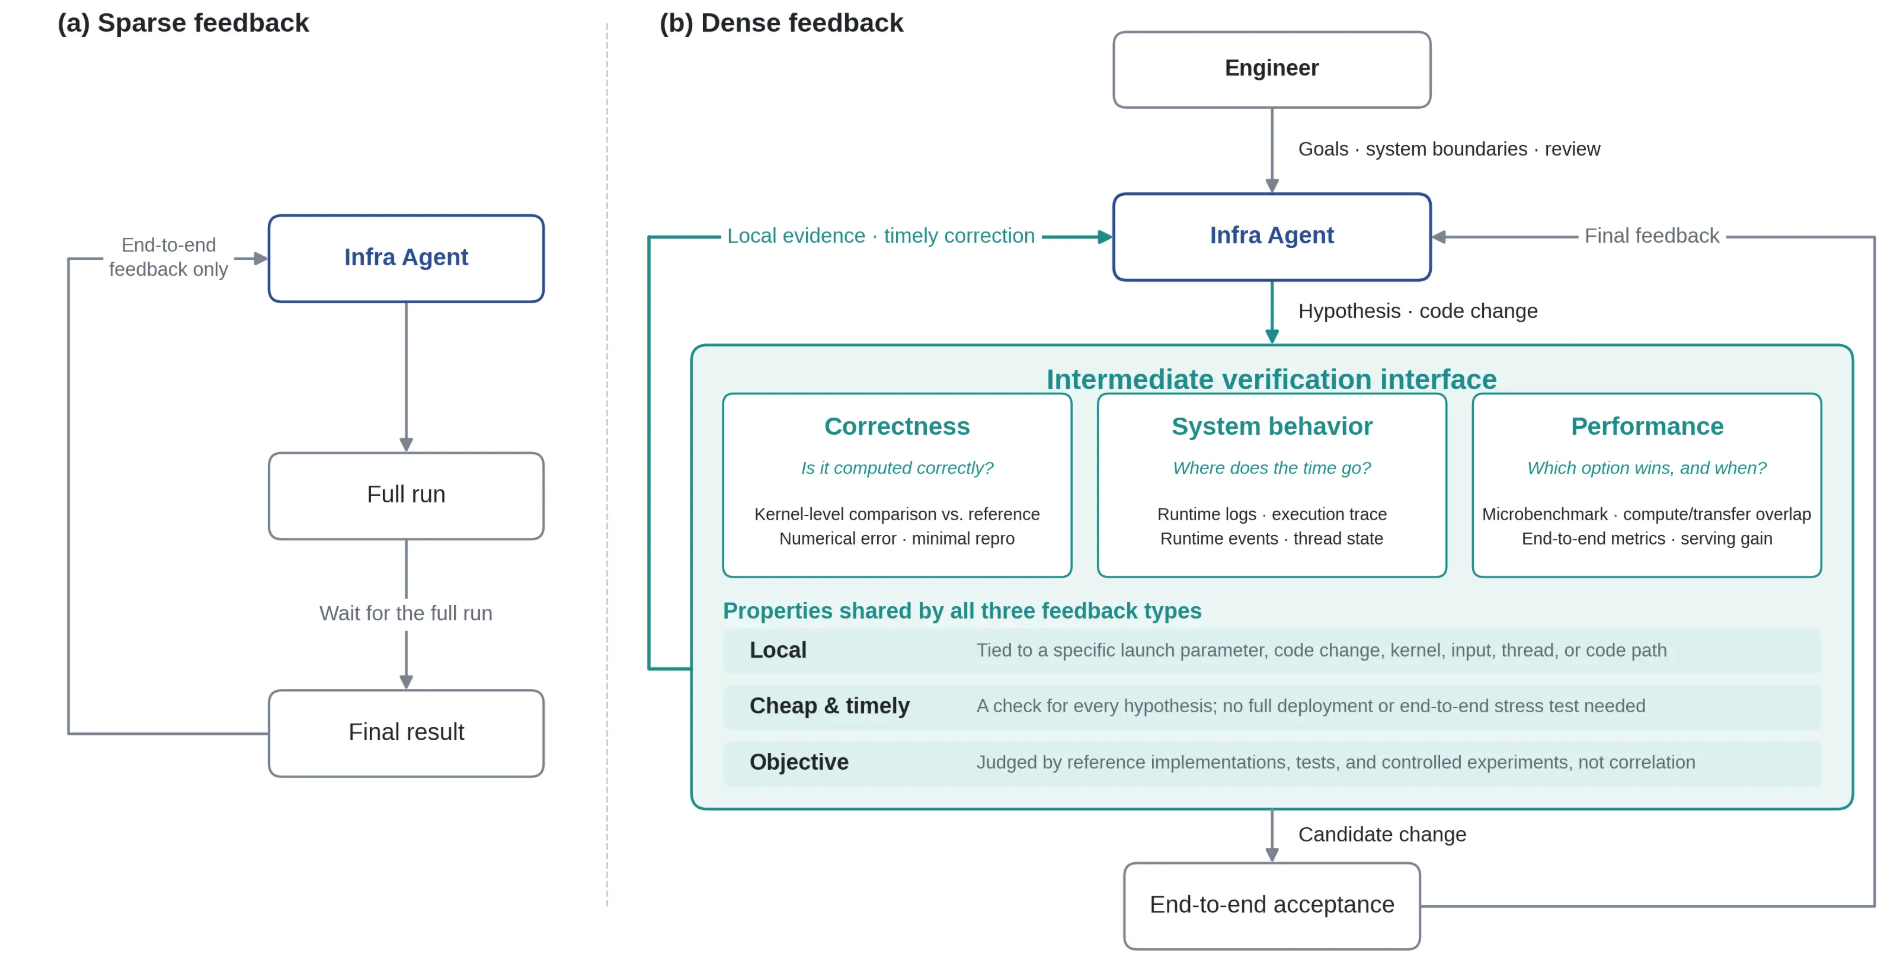
这套机制的核心,是让 Agent 获得更加接近工程判断过程的信息。
当模型需要确认计算是否正确时,它可以获得对应的正确性反馈;当模型需要分析性能下降原因时,它可以查看系统运行过程中的时间消耗;当模型尝试新的优化方案时,它可以通过实验判断该方案是否适用于当前场景。
智谱团队认为,真正有效的反馈需要满足几个条件,它必须足够接近具体问题,能够快速获得,同时能够通过客观实验验证。否则,大量日志和指标反而可能让 Agent 难以判断下一步行动方向。
“模型优化系统,系统服务模型”
在 dense feedback 的帮助下,Infra Agent 开始参与定位推理系统中的隐藏问题。
在 KDA 的上下文并行路径中,Agent 发现了一个影响长上下文计算精度的问题。
由于不同上下文分片之间需要不断合并状态矩阵,TF32 计算产生的舍入误差会随着序列长度增加不断累积,最终导致计算结果偏差。
Agent 通过比较不同执行路径的结果,将问题定位到状态传播和合并过程中的精度处理。相关修复已经合并到 Flash Linear Attention 项目 PR #1180。
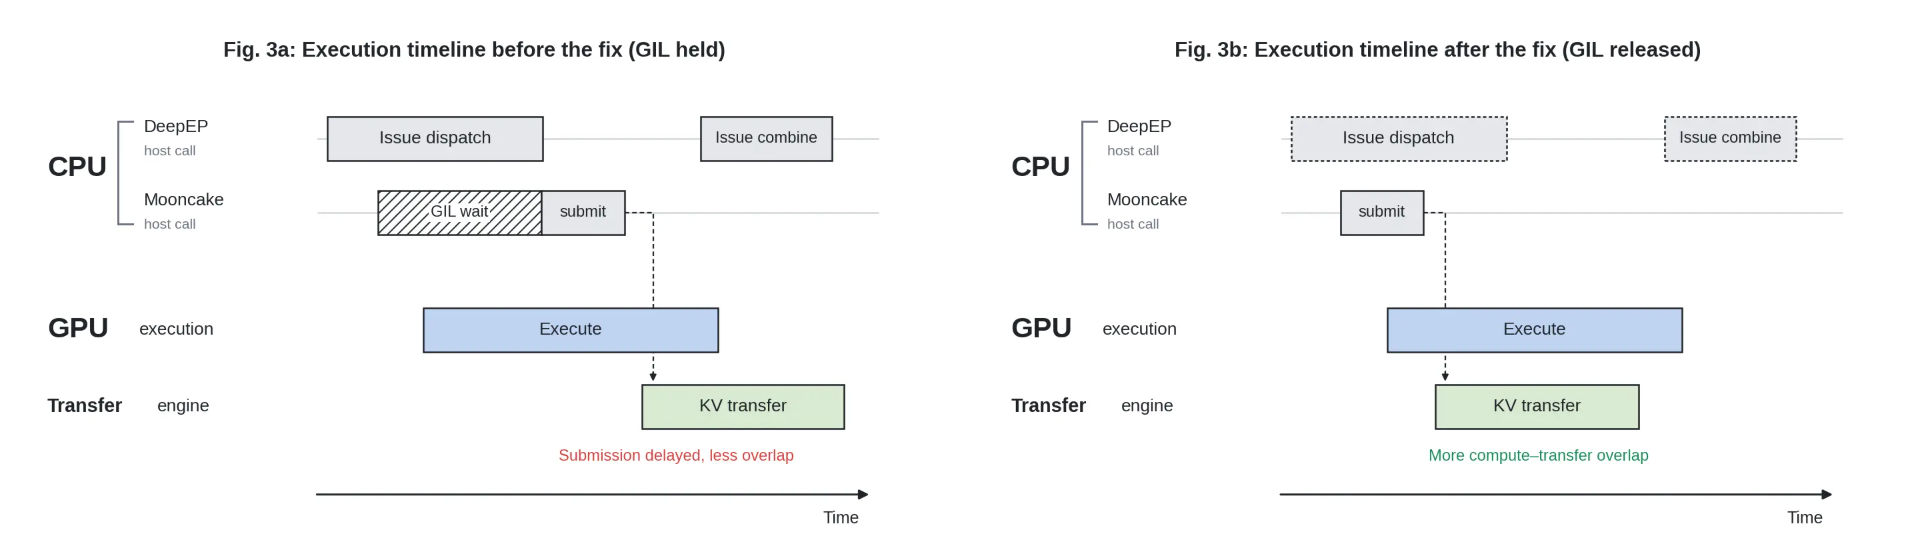
另一个问题出现在 KV Transfer 与 DeepEP 调度之间。
测试过程中,Agent 发现 KV Transfer 没有与 DeepEP Dispatch 形成有效重叠,导致部分场景下传输开销超过 30%。
随后,Agent 沿着 Python 与 C++ 调用链继续分析,发现节点内路径没有及时释放 Python GIL,使传输任务无法及时推进。
完成修改后,KV Transfer 带来的额外开销从超过 30% 降低到 1% 以下。
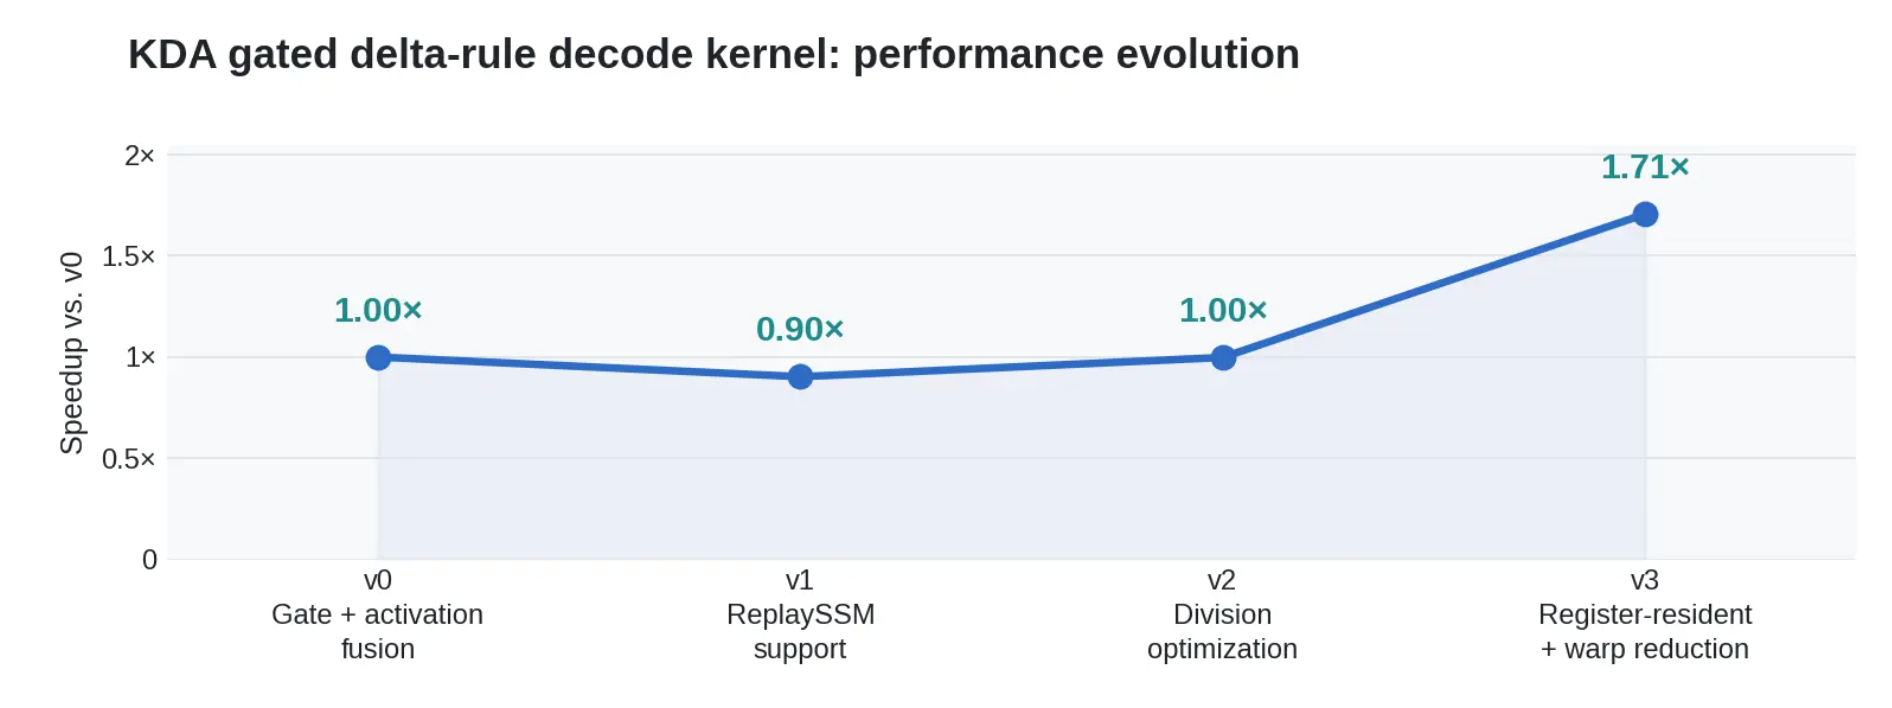
此外,Agent 还优化了一个 Decode Kernel。
它发现,由于 Kernel 切分方式的问题,同一组归一化计算被重复执行四次。通过重新组织计算结构,减少重复计算,该 Kernel 最终获得 1.71 倍性能提升。
这一优化思路来自 Agent 对 SGLang、Flash Linear Attention 和 DeepGEMM 等项目现有 Kernel 的学习。它将这些代码中的优化经验提炼成“optimization skeleton”,再结合当前系统反馈判断是否适用。
过去,类似优化经验主要依赖工程师个人积累。
而在这一过程中,Agent 开始能够从已有代码中学习优化方法,再通过实验验证这些方法是否适合新的硬件和模型环境。
唐杰表示,人类工程师仍然负责设定目标、搭建反馈环境,以及审核高风险修改。
但工程师的角色正在变化,从直接解决每一个问题的人,逐渐转向设计反馈系统的人。
智谱团队认为,建立在真实基础设施任务上的可验证反馈环境,可能也是训练下一代模型的重要基础。每一次 Agent 完成工程任务,都可能成为下一代模型学习的数据。
目前,GLM-5.3-Flash 的案例距离真正意义上的递归自我改进仍然存在距离。
但唐杰认为,一个最小规模的循环已经出现。
模型优化系统,而系统服务模型。