克雷西 发自 凹非寺
量子位 | 公众号 QbitAI
GPT-5.6和Fable 5联手,解决了一道悬置25年的数学难题。
微软研究院首席研究员Dimitris Papailiopoulos,证明了一个多项式时间算法,能让MIMO检测精确命中最大似然阈值。
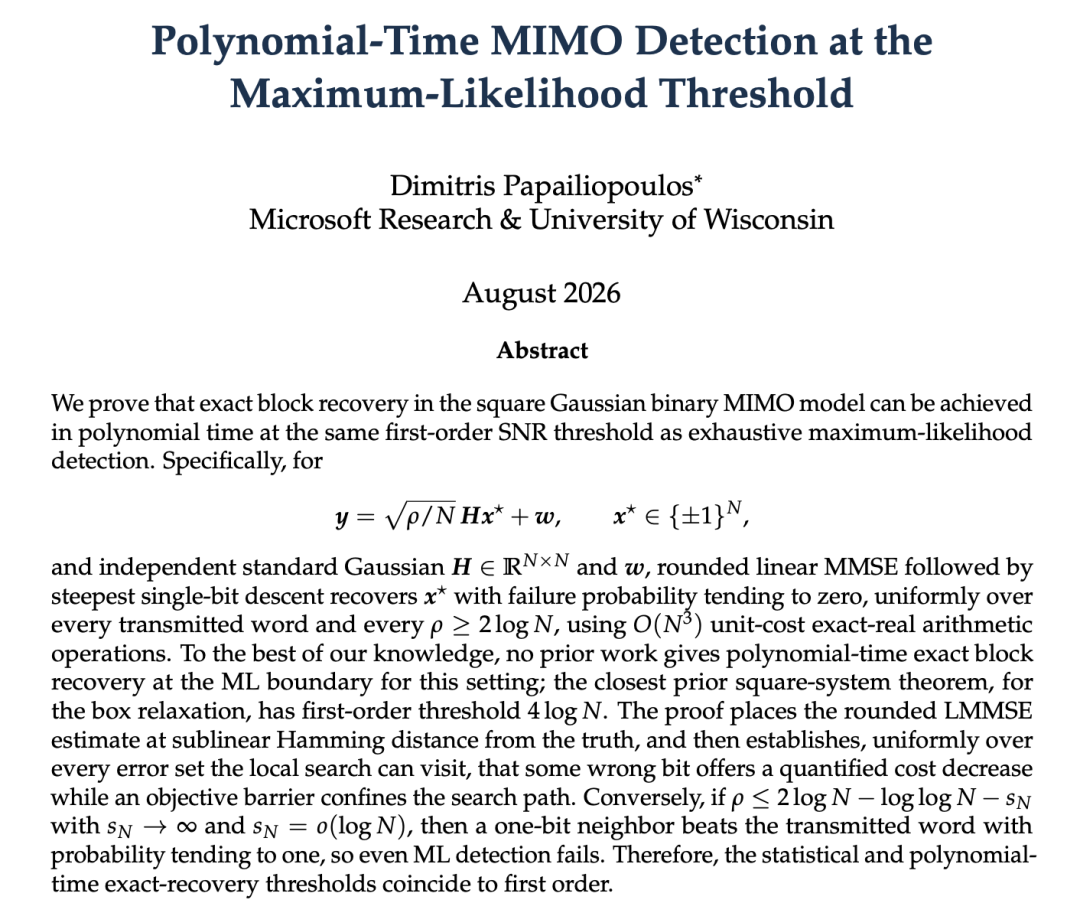
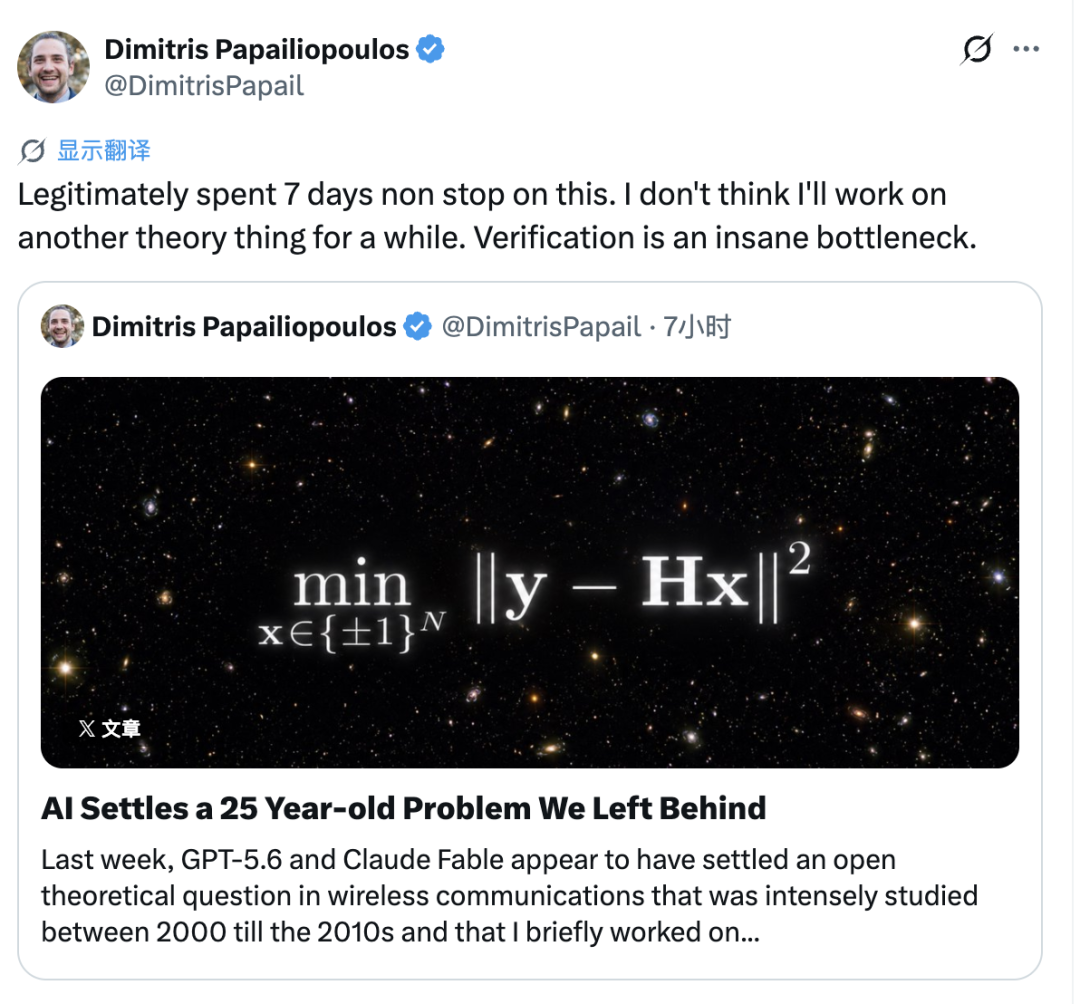
作者表示,这个过程花了他整整七天。
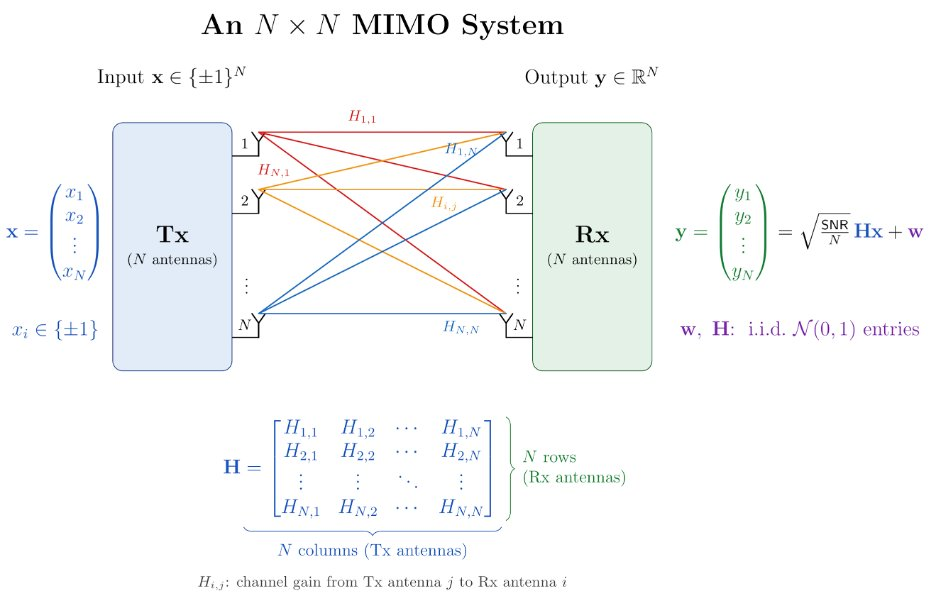
MIMO检测是无线通信领域的一个经典问题,需要接收端从被噪声搅乱的信号中,把发送端原本发出的信息完整还原。
统计上这种操作已经可以做到,但过去的方法,是穷举搜索,耗费的时间是指数级的。
所以问题就变成,能不能不通过穷举,利用快速算法实现还原。
2001年,Hassibi和Vikalo以为找到了突破口,但2005年这条路又被Jaldén和Ottersten证明走不通。
此后学界又先后试过半正定松弛、比特翻转局部搜索、AMP、统计物理方法,最接近的结果也只能停在比理论门槛高一倍的地方。
25年,一波又一波学者轮番上阵,但谁都没能啃下来。
25年来,只能靠穷举
MIMO检测,是无线通信里的一个基础问题。
发送端把N个比特通过一个N×N的信道发出去,信道会把这些比特混在一起,还会叠加噪声;
接收端手里只有一份被搅乱过的信号,要把发送端最初发出的N个比特,一位不差地找回来。
理论上有一个万无一失的办法,叫最大似然检测,也就是把所有可能的比特组合都算一遍,找出跟接收到的信号最匹配的那一个。
这种方法一定能找到正确答案,前提是你愿意等——N个比特意味着2的N次方种组合,N稍微大一点,穷举就要算到天荒地老。
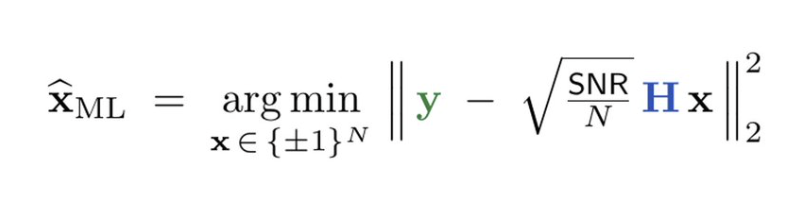
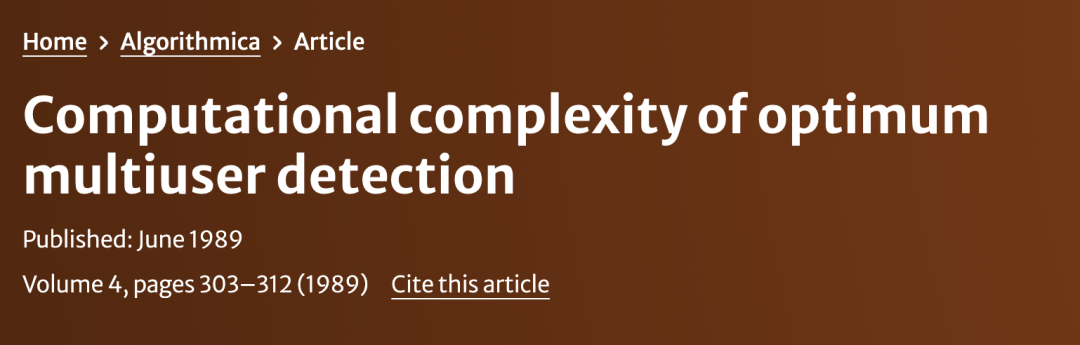
1989年,Sergio Verdú证明了这类问题在最坏情况下是NP-hard的,也就是不管用什么算法,都存在某些输入让计算量指数级爆炸。
但“最坏情况”说的是数学上刻意构造出来、专门为难算法的信道矩阵。
现实里的无线信道不是谁刻意构造的,它的每一次衰减、每一次噪声都是随机产生的,不会挑那些最难算的情况来为难接收端。
于是学界从2000年代初开始问一个更具体的问题——
如果信道是随机产生的,只要统计上存在恢复原始比特的可能,是不是就一定能找到一个不需要穷举的算法?
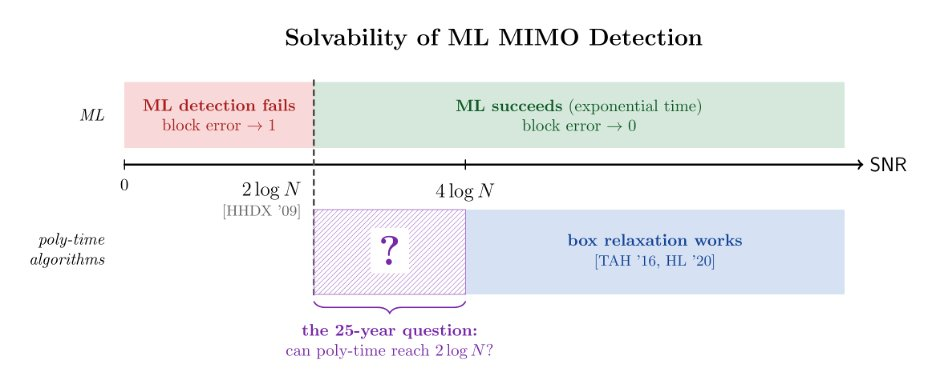
后来的研究给出了一条精确的分界线,当信噪比达到2logN,发送的比特能够被完全恢复的概率趋近于1。
低于这条线,连最大似然检测本身都会开始出错,这条分界线因此被称为最大似然阈值。
问题于是变得具体——能不能设计一个跑得快的算法,精确命中最大似然阈值?
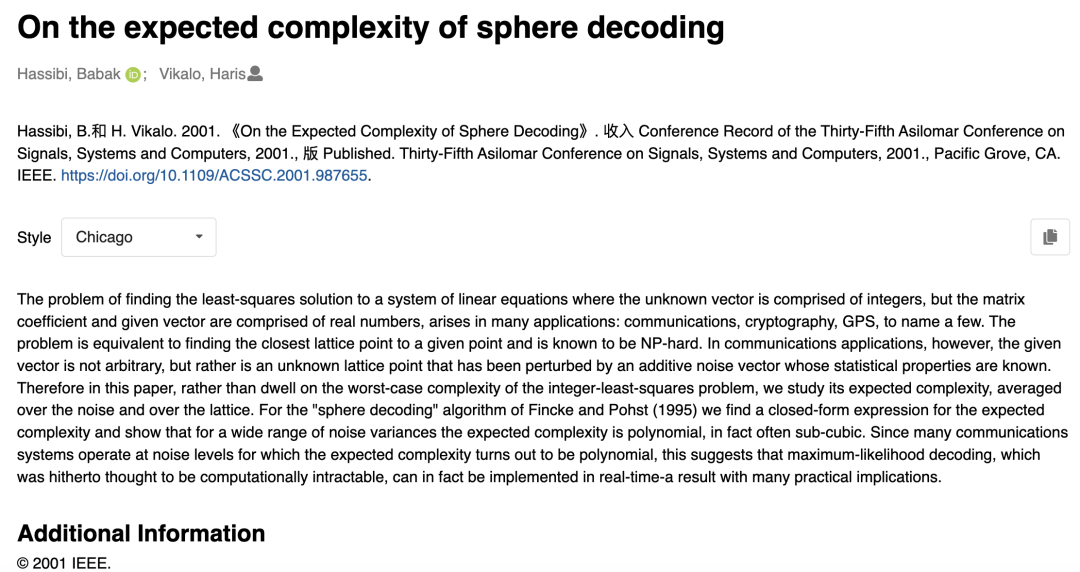
2001年,Babak Hassibi和Haris Vikalo以为找到了答案。
他们分析的是一种叫球形译码(sphere decoder)的算法。
这种算法先在接收信号周围划出一个“球”,只在球内的候选里搜索,球外的直接跳过,靠这一步压缩搜索范围。
Hassibi和Vikalo推导出这个算法的期望复杂度公式,结果看起来是多项式时间的。
如果这个结论成立,这道题基本就解决了。
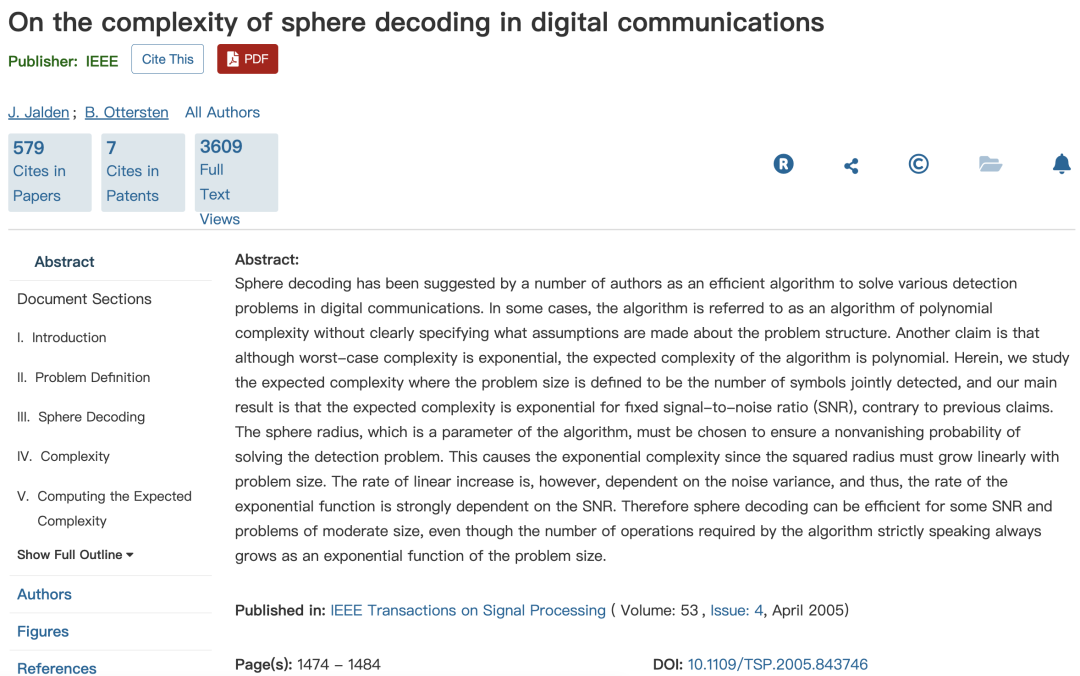
但2005年,Joakim Jaldén和Björn Ottersten把这个结论推翻了。
他们证明,在任意固定的信噪比下,球形译码的期望复杂度其实是指数级的,不是多项式的。
原因是要以不趋于零的概率把发送的信号包进“球”里,球的半径必须跟着问题规模一起变大,球一旦变大,球内要搜索的候选数量也跟着指数级增长。
球形译码这条路走不通之后,学界转向了各种近似方法——半正定松弛、比特翻转局部搜索、AMP(approximate message passing)、统计物理里的方法。
结果,每一种都能给出漂亮的分析,但没有一种被证明能精确匹配2logN这条阈值。
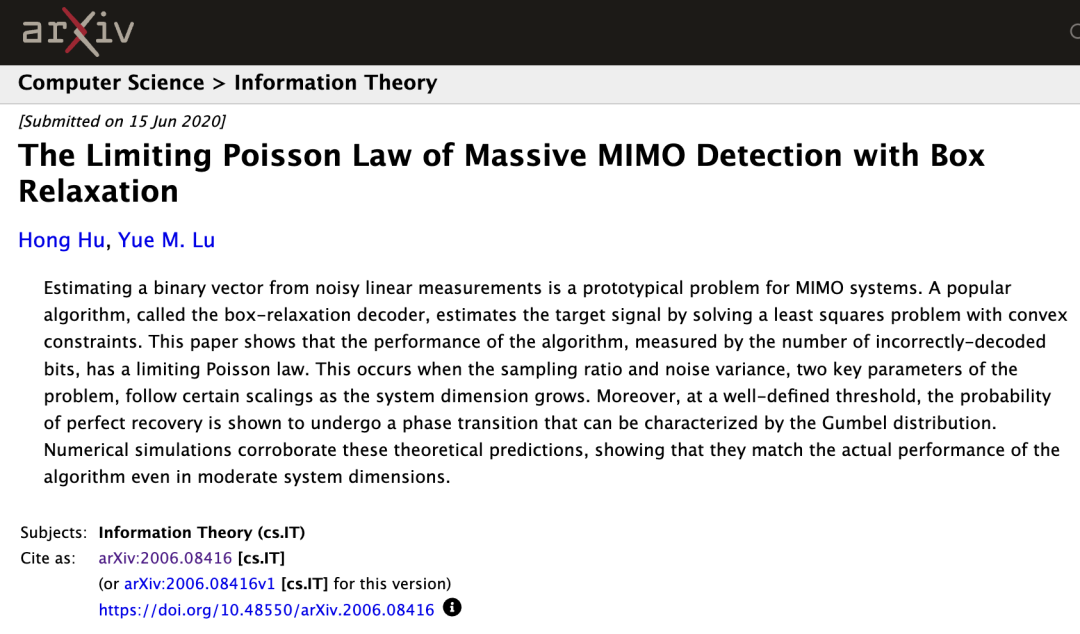
2020年,一种把离散问题放宽成连续优化问题来解的方法,叫box relaxation,拿到了当时最好的严格证明结果,能在信噪比达到4logN时做到精确恢复,但复杂度依然是理论门槛的两倍。
25年过去,统计上“能恢复”和用快算法“能恢复”之间,一直隔着这条鸿沟。
上周,这条鸿沟被填平了。
Dimitris Papailiopoulos和GPT-5.6、Claude Fable 5证明,一个只有两步的简单算法,同样能在信噪比等于2logN时精确恢复全部比特,而且是多项式时间,只需要O(N³)次运算。
而且这篇论文证明的是一个双向结果。
一头证明了这个算法能在信噪比等于2logN时,信号能被精确恢复;另一头则进一步证明,信噪比只要略低于2logN这个最大似然阈值,连“笨办法”最大似然检测也会开始失败。
GPT-5.6和Fable 5联手证明
Dimitris找GPT-5.6和Fable 5来试这道题,两个模型很快分别给出了自己的证明思路,但接下来的打磨过程一波三折。
GPT-5.6的路径用了一种叫AMP的算法,这是Dimitris一直没能吃透分析方法的一类工具。
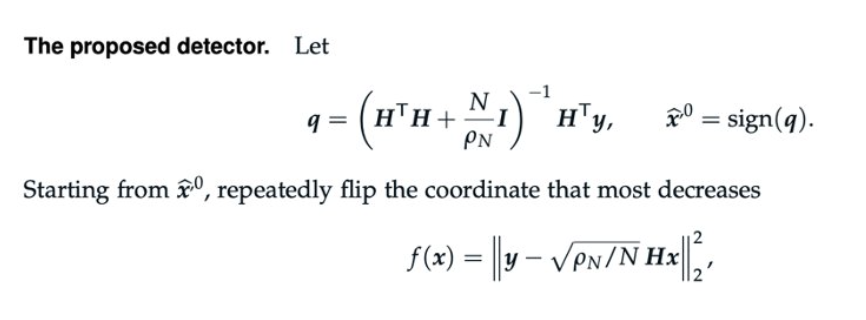
Fable 5给出的路径不同,用的是“符号LMMSE,加贪心逐位翻转”,一个业内实际在用、却从没被严格证明过的老算法。
两条路径都各自给出了完整的证明,声称能在信噪比2logN精确恢复。
Dimitris最终选择了Fable给出的这条路,让GPT接手检查和修补里面的漏洞。
GPT把漏洞修好了,但修好之后的证明是一堵“符号墙”,变量指着变量,被指着的变量又指着更多变量,而且塞满Dimitris看不懂的矩阵分析工具。
接下来的几天,他反复让两个模型互相简化对方给出的论证,唯一的底线是,不管怎么简化,最后都要保住2logN这个门槛。
除此之外,只要他自己能看懂,怎么改都行。
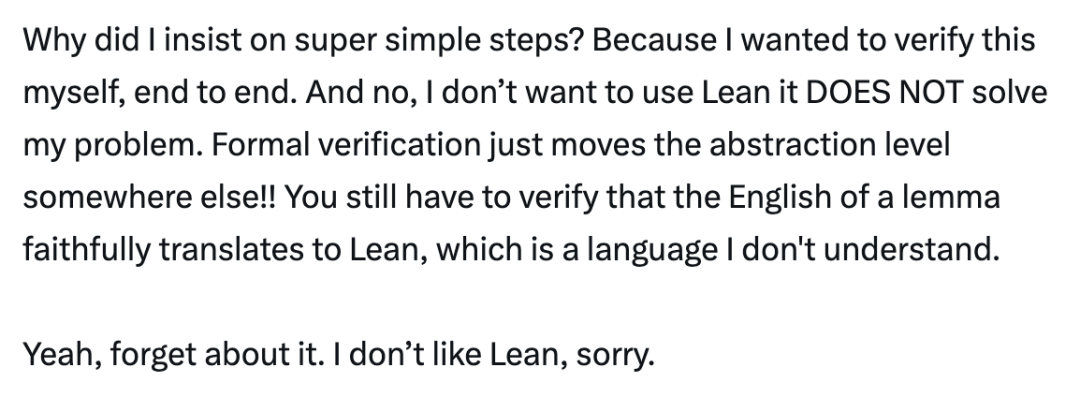
他还拒绝了用Lean做形式化验证,原因也很抓马,因为……他不懂。
Lean是一种能让计算机自动检查数学证明是否成立的工具,但要用它,得先把证明翻译成Lean能读懂的形式语言。
这道翻译工作本身也可能出错,而Dimitris不懂Lean,也就没法检查翻译对不对。
总之折腾了一周后,他终于拿到了一份可以逐行手算核对的证明。
拆开看,这个算法只有两个核心步骤。
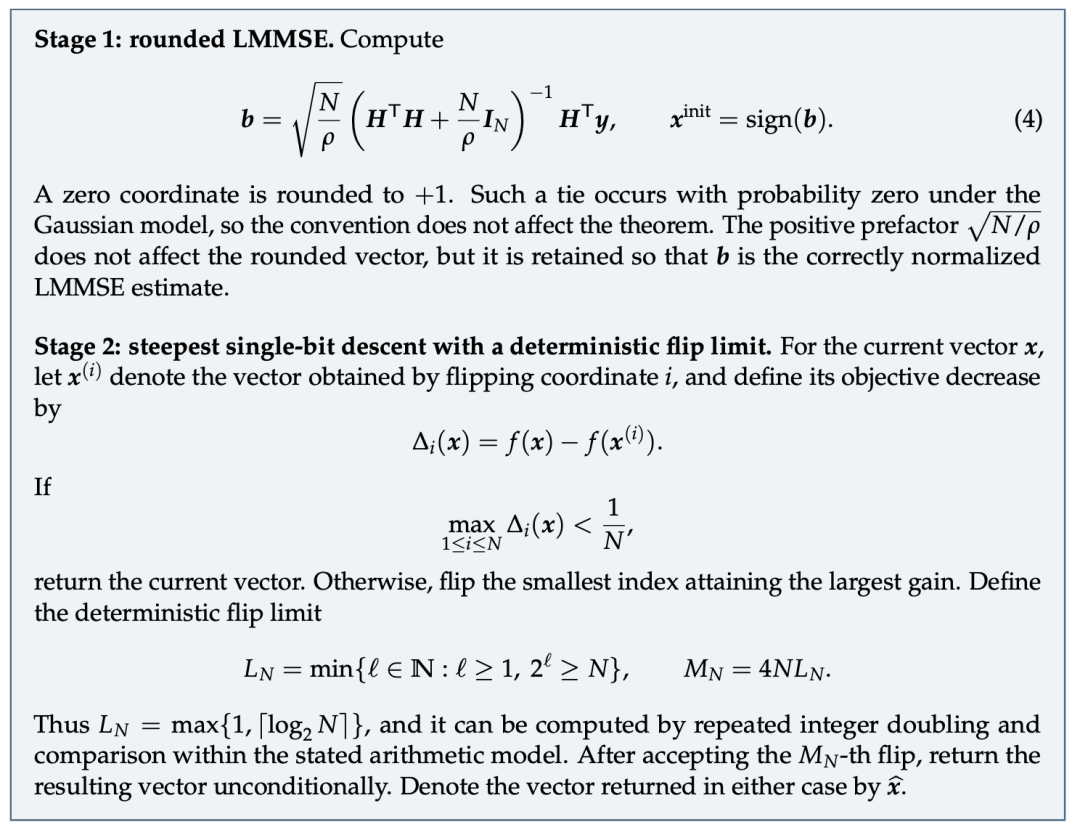
第一步,叫LMMSE取整。
LMMSE(linear minimum mean square error,线性最小均方误差估计)是信号处理里的一种标准估计方法,先给出一个不是整数、连续取值的粗略猜测,再把每个坐标按正负号取整成+1或-1。
这一步不需要精确猜中每一个比特,论文证明的是,取整后的结果和真实发送的比特之间,汉明距离(两个等长比特串之间不同的位数)只有o(N)。
也就是说,随着N变大,猜错的比特数占总数的比例会趋近于零。
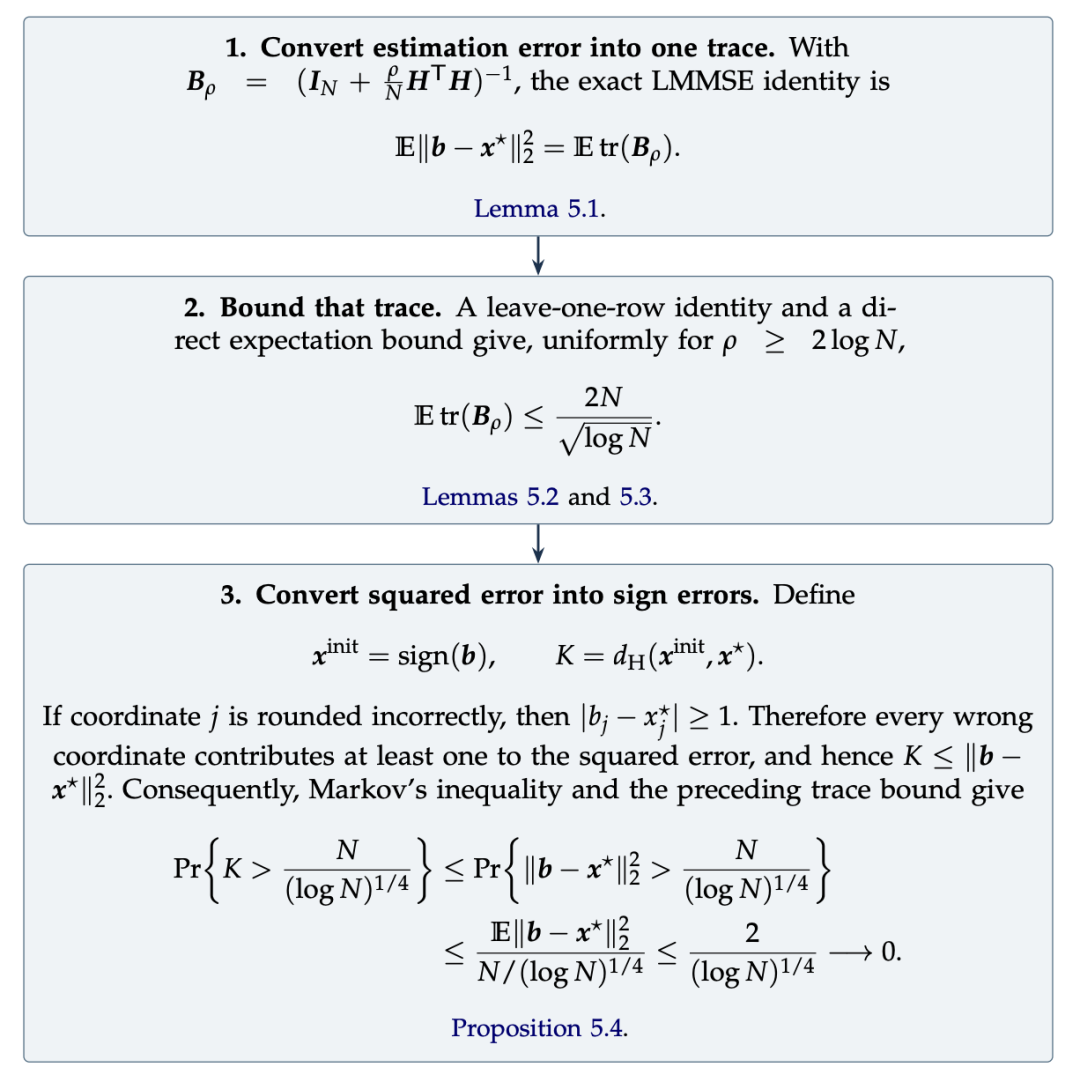
第二步,叫贪心逐位翻转。
这步从第一步给出的猜测开始,每一轮检查所有N个比特,找出翻转哪一位能让代价函数(衡量当前猜测和接收信号匹配程度的一个数值,越小越匹配)下降得最多,就翻转那一位,然后重复这个过程。
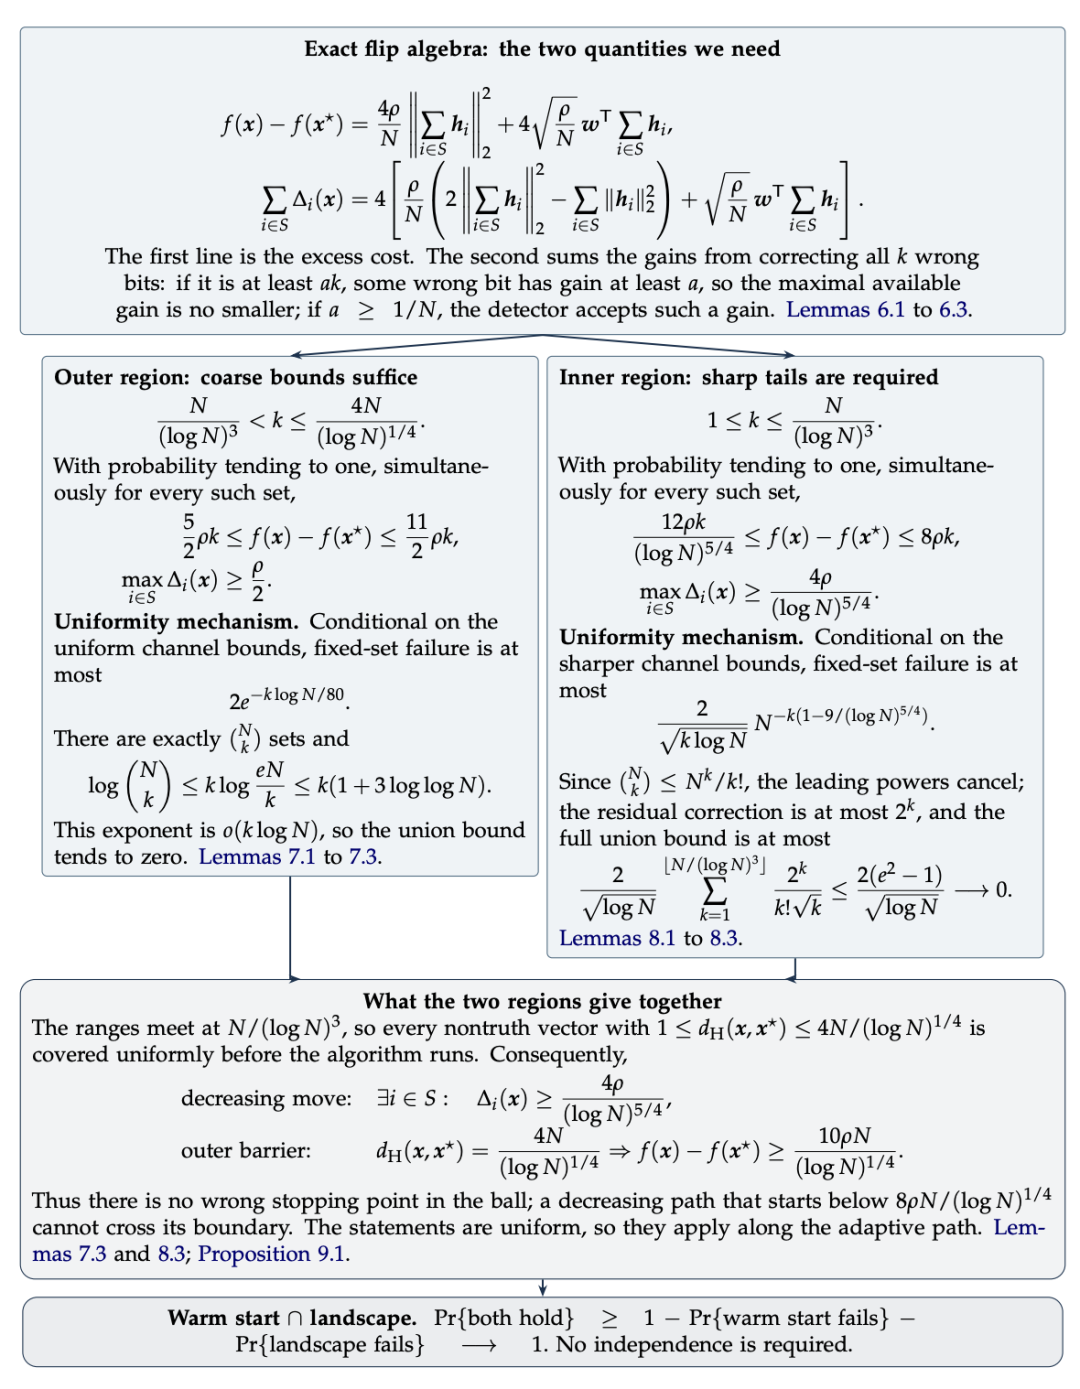
问题是,这样的贪心搜索凭什么能找到正确答案,而不是在中途卡在一个错误的地方不动?
为了回答这个问题,论文证明了两件事。
第一,在猜测起点周围的一个范围内,每一个还没猜对的点,都至少存在一位翻转能让代价函数严格下降,而且下降的幅度有一个不趋于零的下限,不会随着N变大而消失。
这意味着贪心搜索不会卡死不动,永远能找到继续往下走的一步。
第二,代价函数本身会随着汉明距离(也就是猜错的比特数)增大而增大。
这形成一道天然的护栏——搜索路径就算中途某一步猜错的比特数量暂时变多,代价函数也回不到起点,没法翻越这道护栏跑到猜测范围之外。
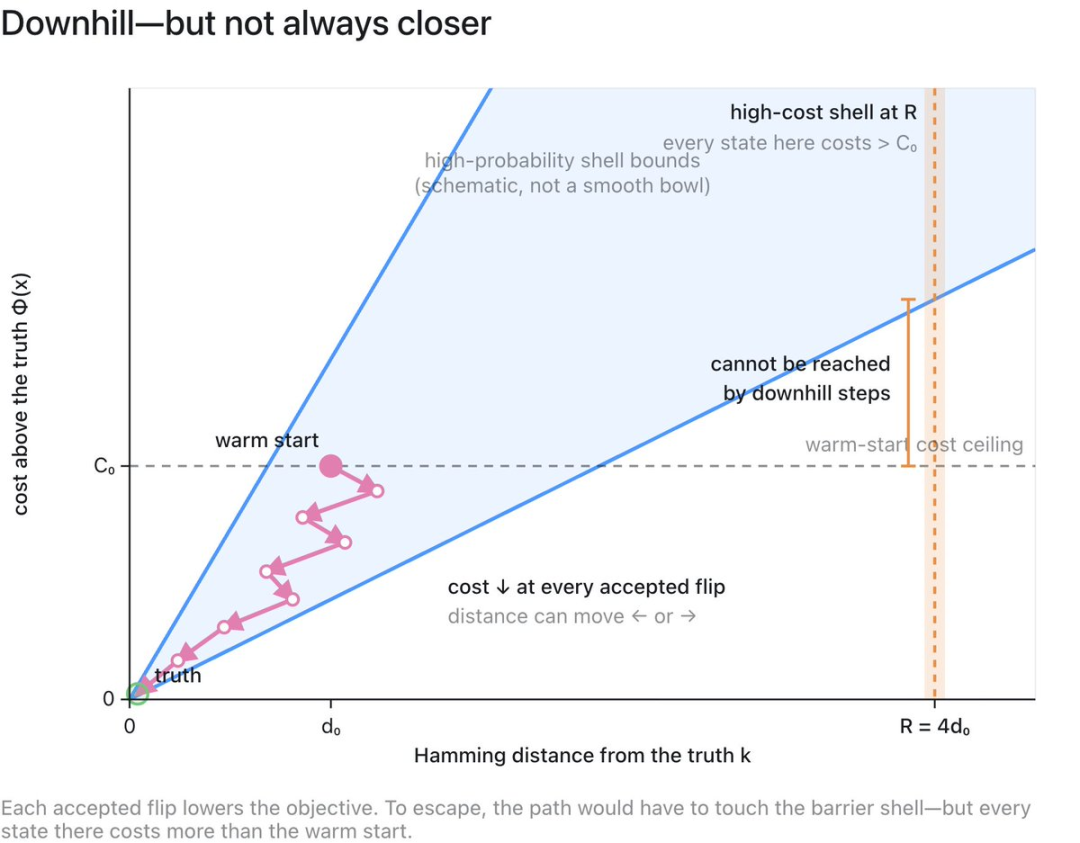
把这两件事放在一起看,每一步至少能降低多少代价,除以起点距离最优解总共差多少代价,就得到贪心搜索的算法复杂度,论文算出来的答案是O(NlogN)步。
贪心搜索有一条停止规则,那就是找不到任何能让代价下降的翻转时,就停下来。
前面已经证明,护栏内每一个猜错的点,都还有至少一位翻转能让代价下降。
也就是说,只要还没猜对,算法就一定能找到下一步该翻哪一位,不会停。
等真的猜对了,任何一次翻转都只会让代价变得更差,这时候才没有能改进的翻转可选,算法这才会停下来。
贪心搜索唯一能停下的地方,就是真实发送的那个比特串。
算法最终只会停在真实发送的比特串上,证明也就完成了。Dimitris表示,这一整套论证过程,自己已经从头到尾验证过一遍。
作者简介
Dimitris Papailiopoulos,现在是微软研究院的首席研究员,同时是威斯康星大学麦迪逊分校电子与计算机工程系的副教授。
他早年的研究方向是信息论和编码理论。
2009年,他还是博士一年级学生,写下了第一篇论文,并于次年发表,合作者是导师Alex Dimakis。
那篇论文用一种叫MCMC(马尔可夫链蒙特卡洛,一种靠随机采样逼近答案的计算方法)的方法,尝试解决MIMO检测这道题,但没有成功。
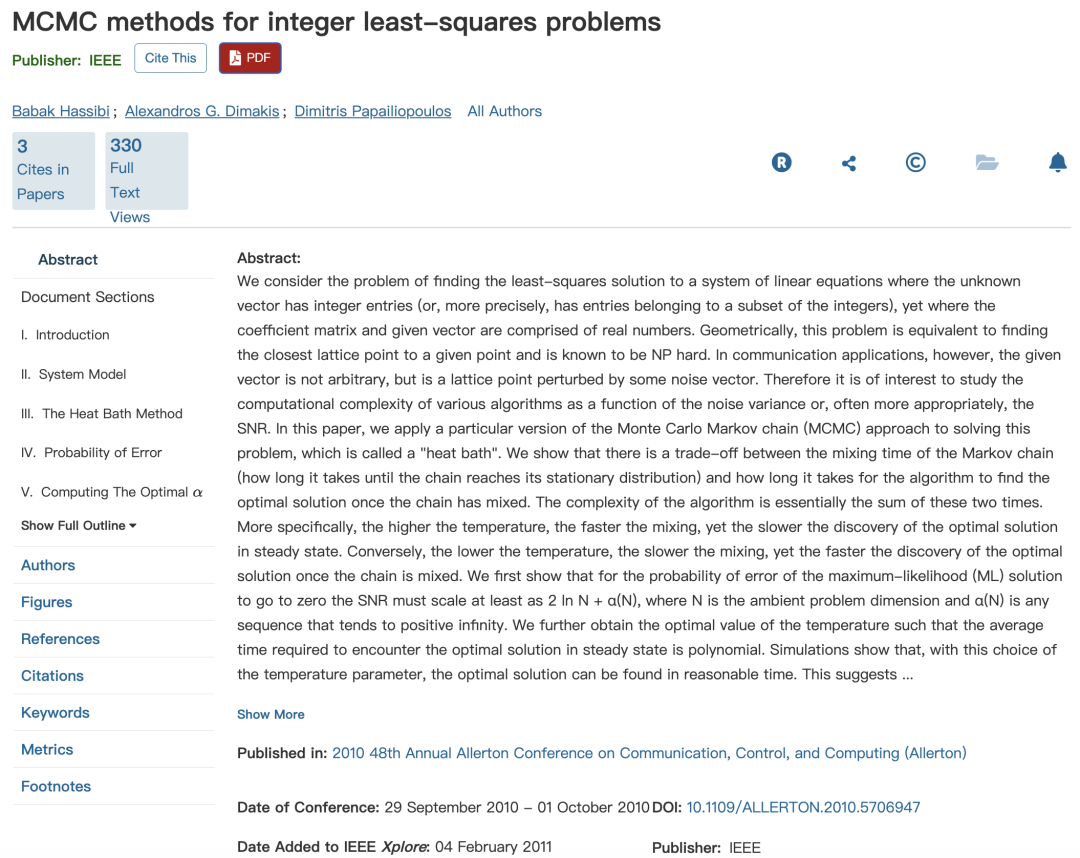
这次被GPT-5.6和Fable 5证明拿下的,正是同一道题。17年前那道让他卡住的题,这次被他自己解开了。