
机器之心编辑部
8 月 9 日,长期关注 OpenAI 模型动向的 X 用户 ChrisGPT 爆料称,OpenAI 正在推进一个代号为 Doug 的新一轮大型预训练模型。
按照他的说法,Doug 将是 OpenAI 迄今规模最大的一次预训练项目,而且它与 GPT-6 并不是同一个模型。
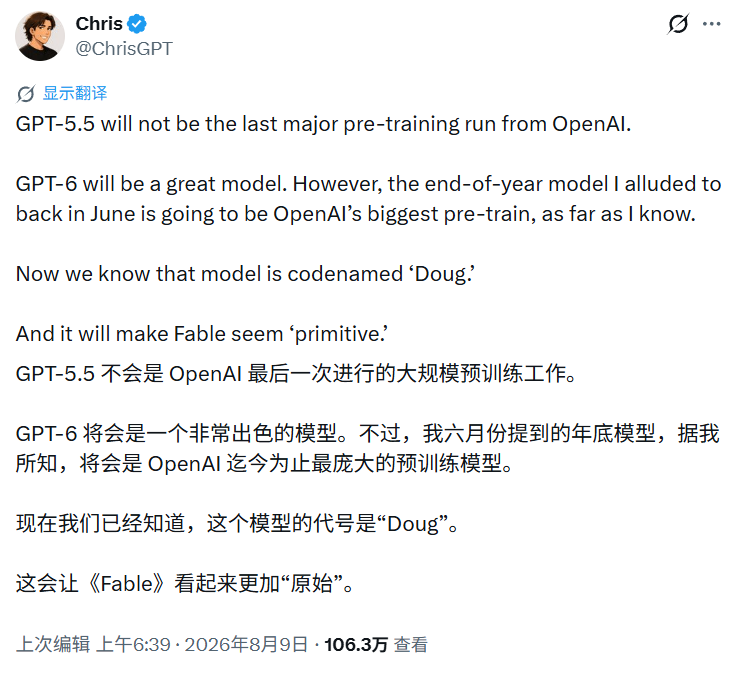
在后续回复中,ChrisGPT 进一步表示,GPT-6 很可能就是昨天 OpenAI 因安全问题紧急暂缓发布的自家最强模型 Astra。
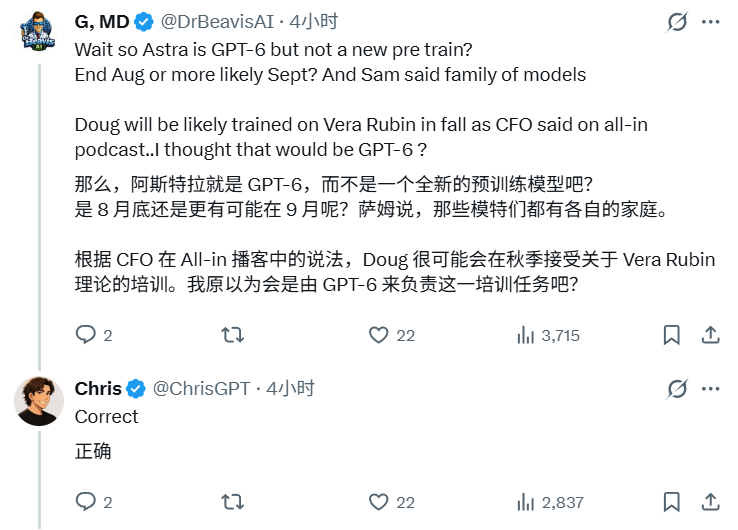
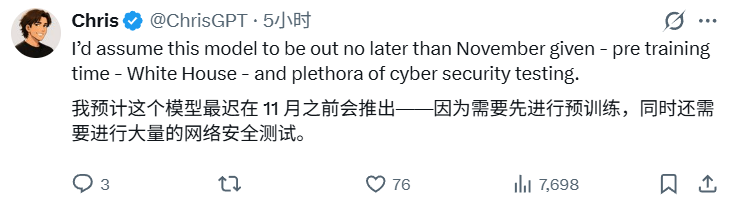
至于 Doug,他预计最迟可能会在 11 月之前推出。
ChrisGPT 并不是第一个公开提到 Doug 的消息源。
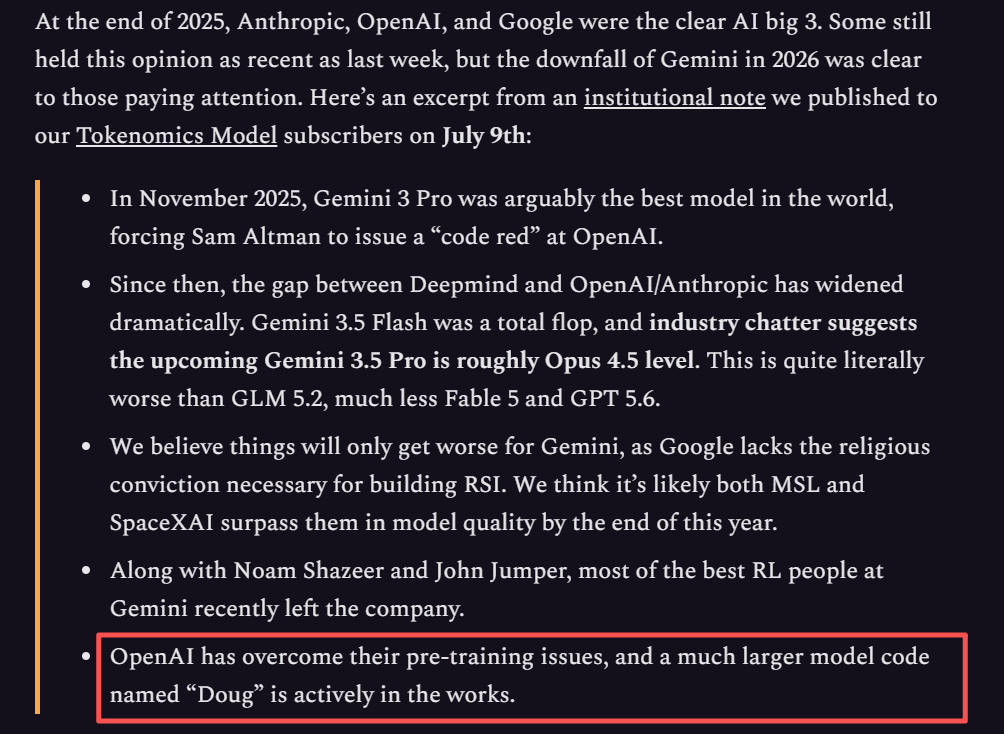
8 月 7 日,半导体和 AI 行业研究机构 SemiAnalysis 在一篇讨论 Gemini 和 Google Cloud 的文章中,公开了一段此前发送给机构客户的研究备忘录。这份备忘录的时间是 7 月 9 日。
文章地址:https://newsletter.semianalysis.com/p/gemini-is-cooked-but-gcp-is-cooking
其中有一句很关键:OpenAI 已经克服了预训练方面的问题,一个代号为 Doug、规模大得多的模型正在积极推进。
如果相关消息准确,Doug 可能意味着,在过去接近两年主要依赖 post-training、强化学习和 inference-time compute 推动能力增长之后,OpenAI 正在重新启动一次大规模的基础模型换代。
故事要从 GPT-4o 说起。
OpenAI 把更多增长交给了 RL
2024 年 5 月 13 日,OpenAI 发布 GPT-4o,并将其称为新的旗舰模型。
此后接近两年,OpenAI 虽然训练并发布了 GPT-4.5 等新的预训练模型,却始终没有完成一轮能够被广泛部署为下一代主力 frontier model 的全规模预训练。
与此同时,OpenAI 的模型能力增长开始越来越多地来自另一条路线。
2024 年 9 月 12 日,OpenAI 发布 o1-preview。
相比过去依靠更大规模预训练推动能力增长,o1 展示了另一种 scaling 方法:通过大规模强化学习,让模型学会投入更多计算进行推理。此后,post-training、RL 和 inference-time compute 在 OpenAI 的模型体系中变得越来越重要。
2025 年 4 月,o3 正式发布。OpenAI 再次强调,o 系列的推理能力来自 large-scale reinforcement learning。
2025 年 8 月,GPT-5 发布。它不再只是一个单一模型,而是一套由快速模型、深度推理模型和路由系统组成的统一架构。
SemiAnalysis 认为,o1、o3 乃至 GPT-5 系列背后,并没有伴随一次与 GPT-4o 相当的全新 base model 世代跃迁,相关模型实际上仍建立在 GPT-4o 时代的基础模型体系之上。
OpenAI 从未确认这一训练血缘,但如果 SemiAnalysis 的信息成立,过去近两年的路线就很好理解了:底座没有发生同等级别的世代跃迁,能力增长主要由越来越强的 post-training 和 RL 推动。
模型 scaling 也由过去主要依赖 pre-training,逐渐扩展到了 pre-training、RL 和 inference-time compute 三个维度。
问题在于,如果基础模型长期没有发生同等级别的换代,仅依靠后训练和推理计算继续 scaling,迟早会面临边际收益下降的问题。
而 Gemini 3 的出现,把这种潜在的训练路线问题迅速转化成了现实的竞争压力。
Garlic:pre-training 开始重新运转
2025 年 11 月 18 日,Google 发布 Gemini 3。
十天后,SemiAnalysis 在 TPUv7 分析中抛出了一个引发广泛讨论的判断:自 GPT-4o 以来,OpenAI 没有完成一轮能够被广泛部署为新 frontier model 的成功全规模预训练。
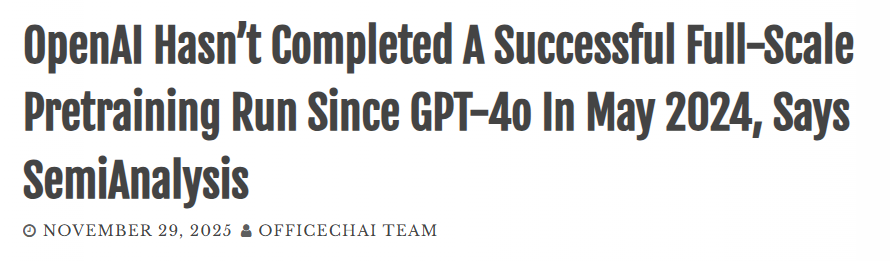
当 Google 推出 Gemini 3 后,这种差异也从训练路线问题,变成了直接的竞争压力。
12 月 1 日,多家媒体报道称,Sam Altman 在 OpenAI 内部宣布“Code Red”,要求团队优先提升 ChatGPT,并重新配置部分资源。
一天之后,更关键的训练信息浮出水面。
2025 年 12 月 2 日,《The Information》报道称,OpenAI 正在开发一个代号为 Garlic 的新预训练模型。报道援引内部消息称,Garlic 在 coding 和 reasoning 评测中表现不错,同时使用了 OpenAI 在此前训练过程中发现的一系列 bug fixes。
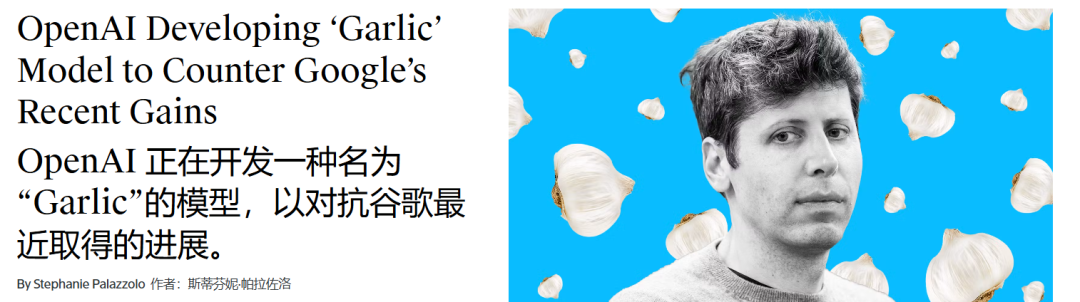
更关键的是,OpenAI 首席研究官 Mark Chen 据称向团队表示,公司已经解决了此前 pre-training 中的一些关键问题。报道还提到,这些训练改进能够让更小的模型容纳过去需要更大模型才能获得的知识。
同一篇报道里,还有一句后来显得格外重要:OpenAI 已经基于 Garlic 学到的经验,开始开发一个“even bigger and better model”。
Doug 的故事,其实从这里就已经开始了。
2026 年 1 月 6 日,SemiAnalysis 再次谈到 OpenAI 的模型路线。这一次,他们直接写道:OpenAI 已经解决了预训练方面的问题。
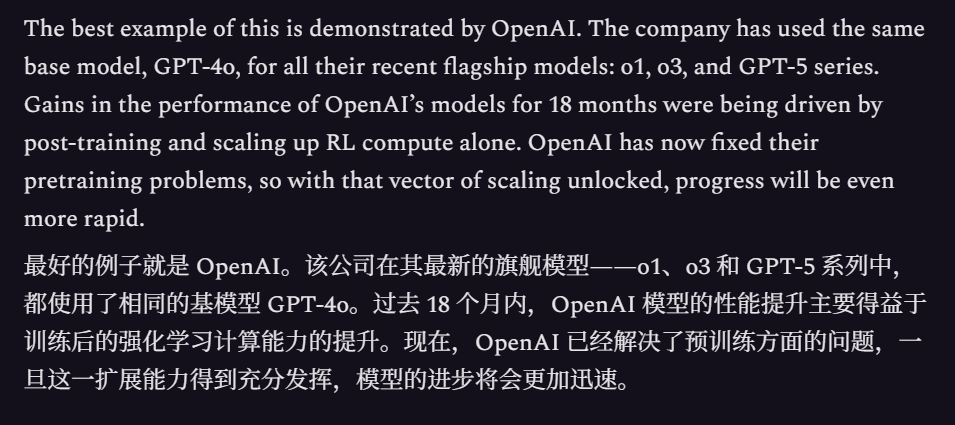
也就是说,按照 SemiAnalysis 掌握的信息,OpenAI 此前困扰全规模预训练的问题已经得到解决。
Garlic 很可能承担了验证这些修复是否有效的角色,而 Doug,则可能是这些训练方法真正被放大到更大规模之后的结果。
OpenAI 可能准备重新启动底座 scaling
如果上述消息准确,那么 OpenAI 可能正在连续推进至少两轮重要模型项目:已经进入高级评测阶段的 Astra,以及规模据称更大的 Doug。
而 Doug 指向的则是另一件事:重新推动底座本身的 scaling。
过去两年,OpenAI 已经证明,旧底座仍然可以通过 RL、reasoning 和 inference-time compute 被不断向上推。
Doug 要回答的是另一个问题:当底座本身重新完成一次大幅跃迁之后,这套已经被推到极致的后训练体系,还能把能力再带到哪里。
这可能才是 OpenAI 下一轮模型竞争真正的起点。