衡宇 发自 凹非寺
就离谱?
GPT-6 Astra刷到快满分的ARC-AGI 3,一个手机能跑的4B小模型也能刷爆。
更准确地说,是4B Qwen+753B GLM 5.2的组合。
其中,GLM-5.2待在云端,手机端只需运行4B的Qwen-3.5。大模型全程不输出一个字,小模型负责把最终答案写出来。
具体技术细节尚未公开,背后团队Mostik拒绝在此刻披露,“因为比赛还没结束”。
但他们公开了核心发现:
AI模型之间一直在用一种极其低效的方式交流。
Mostik认为,他们搭了一座桥,让模型之间的信息传递效率提升了几个数量级。
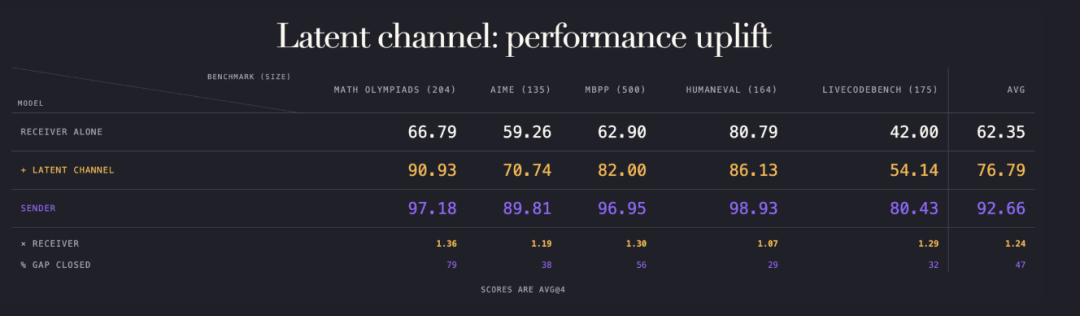
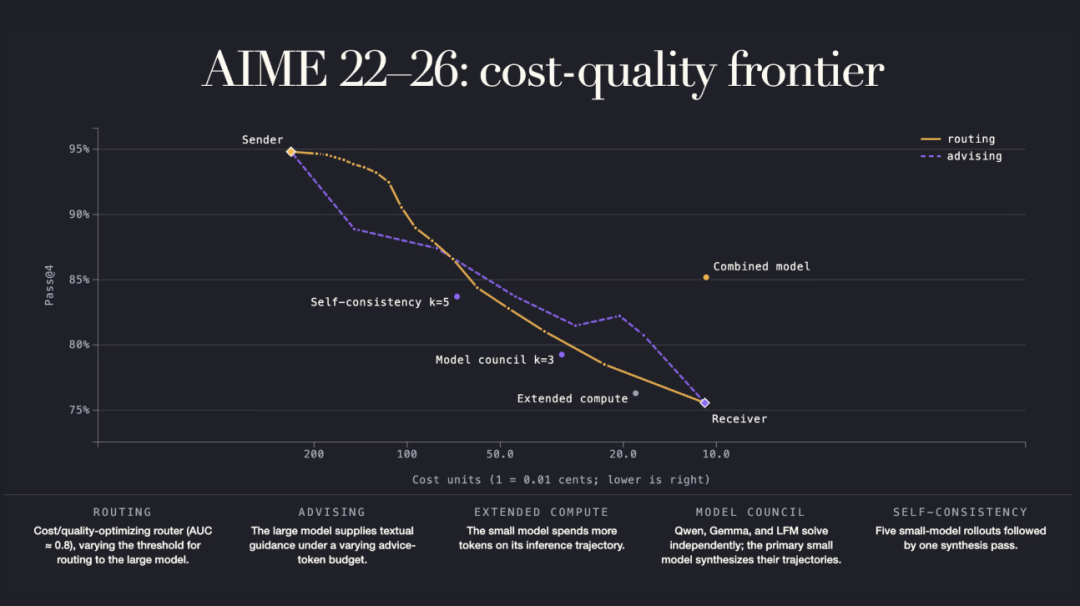
按团队披露的实验结果,这套方案能让4B模型补上与753B模型之间约50%的性能差距,自身准确率提高25%。在大小模型差距更明显的难题子集上,提升达到2倍。
而大模型侧的推理成本,被压到了原本约二十分之一。
Mostik成立仅4个月,团队共15人,其中12名博士。
团队里还有一位菲尔兹奖得主——2010年证明了统计物理中“渗流模型”和“平面Ising模型”的共形不变性的俄罗斯数学家Stanislav Smirnov(斯坦尼斯拉夫·斯米尔诺夫)。
两兆字节与十七比特
大模型生成一个token的过程中,内部会构建超过一百个隐藏向量,总共包含大约一百万个数值,约两兆字节的内部状态信息。
然后,它从大约15万词的词表中挑出一个token输出。
17个比特离开模型,两兆字节被丢弃,不会再被使用。
目前所有让多个模型协作的系统,包括编程子智能体、模型委员会、路由调度,全部建立在这17个比特之上。
模型之间唯一的沟通渠道就是文本。
那么被丢掉的两兆字节里到底装着什么?
近两年的可解释性研究给出了明确答案,是深层计算的核心内容。
一篇ICLR 2026发表的论文显示,Qwen-3在写出“accountant”这个词之前好几个token,内部就已经携带了这个词的表征,正是这个表征让模型提前选对了冠词“an”而非“a”。
而且模型越大,这种提前规划的能力越强,内部状态中携带的”未说出口”的信息越多。
Anthropic的可解释性团队在Claude 3.5 Haiku上也观察到了类似现象:模型写诗时,落笔之前就已经确定好了韵脚。
他们进一步发现了一种叫”J-space”的结构——模型在任意时刻都维护着一组未表达的概念,既不是输入的回声,也不是对下一个token的猜测,而是当前正在处理的信息。
Anthropic团队自己总结道,这些测量揭示了从未出现在输出中的内部推理和反应。
这意味着,当一个模型为另一个模型写出一段文字时,丢失的不是格式信息,而是做出选择背后的深层计算过程。
给大模型和小模型架桥
用一句话概括Mostik做的事情:
让一个模型把自己的隐藏状态通过一个小型的、经过训练的桥(bridge),直接传递给另一个模型,接收方拿到这些内部状态后直接使用。
整个过程不产生任何文本,两个模型的权重完全冻结不动,桥是系统中唯一被训练的部分。
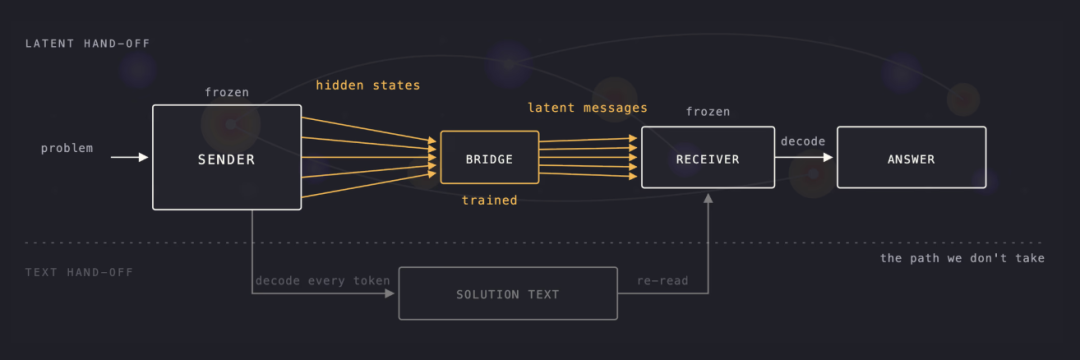
在公开演示中,他们选了智谱的GLM-5.2(753B参数)做发送方,阿里的Qwen-3.5(4B参数,可在手机端运行)做接收方。
大模型自始至终不生成任何文字,它只读取问题,隐藏状态穿过桥传递出去,然后停止。
所有文本生成都由小模型完成。
这里有一个关键的成本设计——
模型运行中,逐个生成token的”解码”环节最贵,而一次性读取整个输入的”预填充”环节便宜得多。
Mostik的做法恰好让大模型只做预填充、不做解码,把最贵的活全交给小模型,算力开销因此大幅下降。
结果4B小模型在“桥”的加持下,弥补了它与753B大模型之间50%的性能差距,自身准确率提升25%。
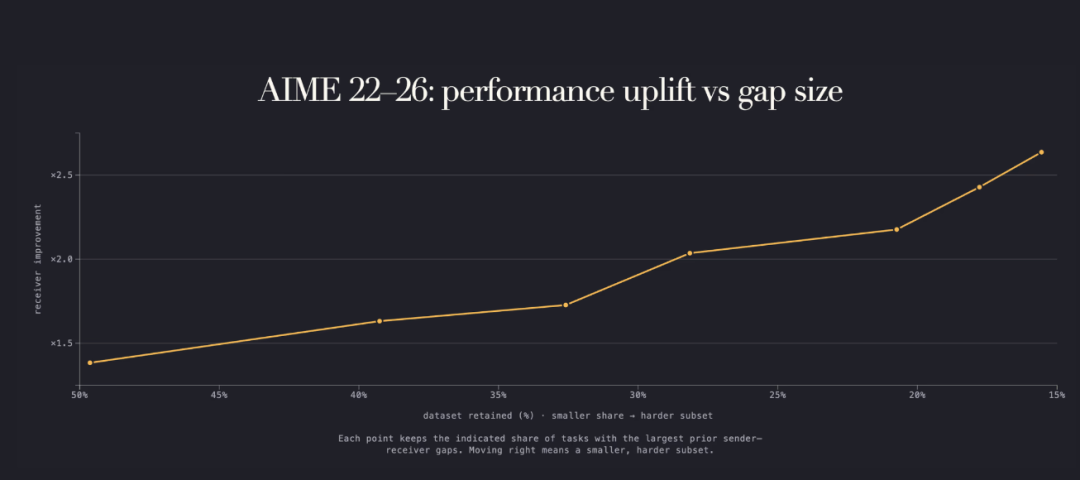
在更难的题目子集上,也就是大小模型之间差距更明显的地方,提升达到了2倍。
从算力角度换算,要在不用桥的情况下跑出同样的成绩,需要部署一个中等规模的模型,而桥方案的计算成本仅为这个中等模型的五分之二。
团队还把这套方案和其他标准的模型组合方法做了对比,包括传统的文本接力。
在所有测试的大模型算力水平上,桥方案都表现更好。
优势在“交接点极早”的情况下最明显,此时文本接力根本没有内容可传,因为大模型还没来得及写出任何文字,但隐藏状态中已经包含了模型在处理问题过程中积累的信息。
随着给大模型分配更多算力,两种方案的表现最终都会趋近大模型本身的水平,但桥方案在整个过程中的性能-算力权衡都更优。
值两个模型在实验中完全冻结。
GLM-5.2和Qwen-3.5大家都熟悉,一个来自智谱,一个出自阿里,由不同团队、用不同数据训练而成,但它们的内部表征能通过一个桥完成有效的信息传递,而不需要对任何一方做微调。
Mostik团队表示,他们刻意冻结双方来做严格测试,如果有用信息能在这种条件下通过,说明桥所利用的结构是模型训练过程中自然产生的。
Mostik首席科学家、菲尔兹奖得主Stanislav Smirnov指出,在两个AI模型之间找到数学上的共同基础其实非常困难,“目前似乎还没有合适的数学语言来描述这件事”。
15人团队,菲尔兹奖得主坐镇
Mostik在俄语里意为“小桥”。
这家公司成立仅4个月,团队共15人,其中12人为博士。
首席科学家Stanislav Smirnov是日内瓦大学教授,也是2010年菲尔兹奖得主。
Smirnov认为,在两个AI模型之间找到可用的数学共同基础,其实极难。目前似乎还缺一套合适的数学语言,来描述模型表征究竟如何对应、如何迁移。
CEO Sasha Malysheva则是这套核心方法的开发者之一。
她曾提到,自己最早发现数学天赋,源自她亲哥的一句“你解不出我准备数学奥赛的题”。
公司内部还有个关于AI未来的比喻。
猜一头猪有多重时,一群普通人各自报数,取平均值,常常能得到比单个专家更接近真实值的结果——多个AI模型协作,也可能有类似潜力。
眼下的问题恰好出在协作成本太高,模型们要先把内部计算压缩成文字,再把文字重新展开成下一轮计算。
现在,Mostik想跳过这道手续。
Malysheva判断,未来未必由单一巨型模型包打天下。更有可能是让前沿模型与生物、物理等领域的专用模型高效配对。
“桥”的下一步
连接已经训练好的模型只是第一步,Mostik正探索两条后续路径。
其一是蒸馏。
传统蒸馏里,学生模型看到的多为教师模型最终输出层的信号。倘若“桥”能把教师的内部状态同步给学生,监督就能更早进入生成过程。
团队表示,早期结果显示,学生模型在相同训练预算下能更接近教师。
其二是专项化。
小模型带着桥训练某一专业领域能力时,学习效率更高,同时有机会保留原来的通用能力。若这一方向继续成立,给大模型增加新技能,或许不再总要重训整套系统。
团队还提到了安全上的可能性。链式思维能提供一部分监控线索,但部分异常行为仍可能绕开它。
桥在两个模型间增加了一个新的观察面,发送方隐藏状态、转换结果与接收方行为都可以被记录。
当然,这些方向仍在早期阶段。
桥是否能跨越更多模型、更多任务和真实业务负载,能否成为可靠的可观测性工具,都还得继续验证。
但至少在ARC-AGI3上,一座让大模型“闭嘴思考”、再由小模型代为表达的小桥,已经刷出了相当离谱的成绩。