金磊 发自 凹非寺
量子位 | 公众号 QbitAI
这个世界模型,着实是有点“反骨”在身上——
上岗前花了大把时间陪机器人训练,等机器人真要开始干活了,它却先从部署链路里退了出去。
要知道,以前的世界模型对机器人来说,就像是一个随身携带的“脑内沙盘”,机器人先借助它预测未来会发生什么,再据此决定下一步怎么动。模型想得越多,推理链路往往也越长。
但这个“反骨”世界模型,却把思路给换了一下。
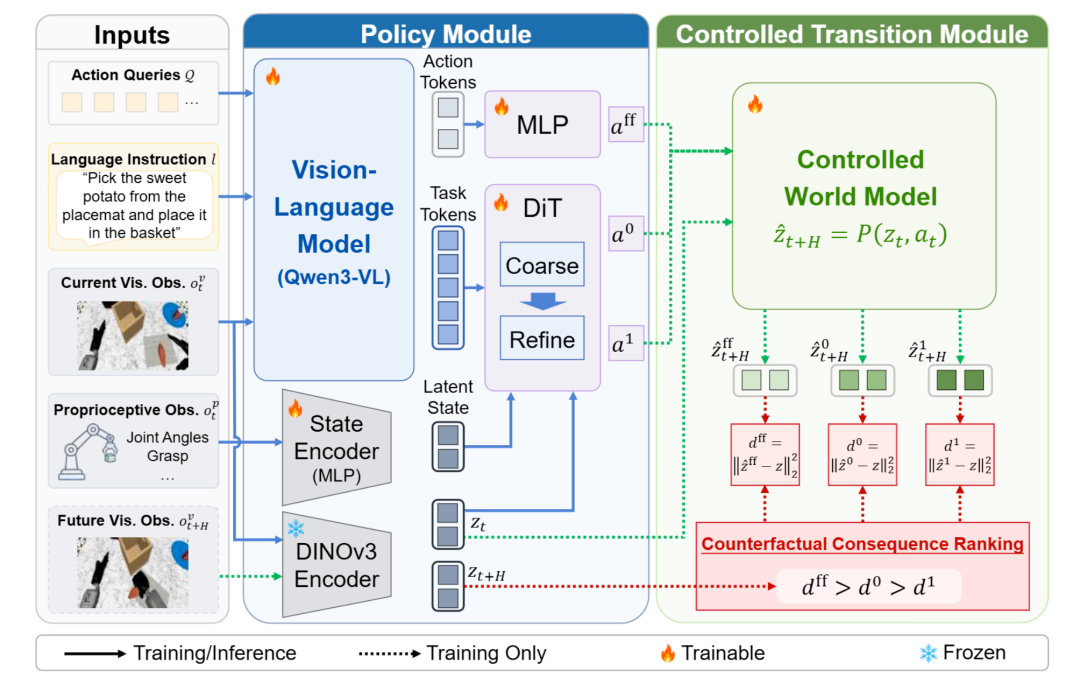
它只停留在训练场里,专门检查机器人自己提出的动作会造成什么后果,再把这种检查变成策略优化的反馈。等训练完成,受控世界模型便退出部署链路,机器人执行任务时无需继续展开未来、搜索候选动作。
结果呢?
机器人反倒是更能干活了!
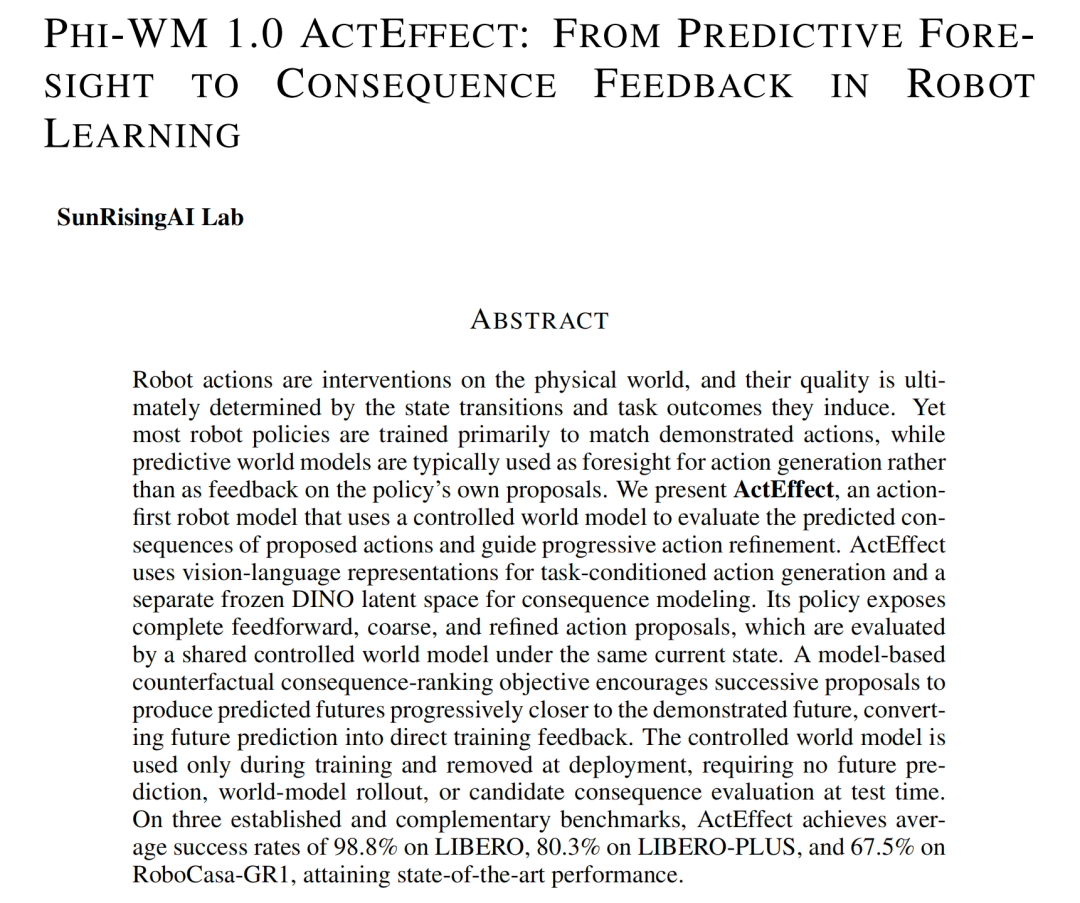
这便是由光象科技联合清华大学李升波教授课题组发布的第一代物理原生世界模型Phi-WM 1.0 ActEffect(下文简称ActEffect),整体来看,这项技术试图回答的是具身智能里一个长期存在的问题:
机器人从演示数据里学会了动作长什么样,能否进一步利用动作可能造成的后果,反过来改善自己的策略?
毕竟这个问题最终也会落到真实部署上。工业机器人每多运行一步模型,都对应新的时延、算力和成本。世界模型如果能在训练时发挥作用,并在执行阶段保持轻量,技术价值才有机会继续转化为部署价值。
从测试结果来看,答案也是比较明确的。
这项工作在LIBERO上取得98.8%的平均成功率,在加入七类分布偏移的LIBERO-PLUS上达到80.3%,面对29维动作空间的RoboCasa-GR1,平均成功率为67.5%。
那么如此“反骨”的方法,具体又是怎么实现的?
我们这就深入了解一波。
先让机器人交出三版答案
ActEffect的突破口,其实藏在机器人最熟悉的模仿学习里。
目前很多通用机器人策略都建立在VLA之上。摄像头负责告诉机器人眼前有什么,语言指令交代任务,模型再照着演示数据生成动作。训练时,自己的答案和示范动作越接近,通常就会得到越高的分数。
可到了物理世界,动作接近和结果正确之间,还是有明显的差距的。
例如夹爪早合上一点,零件可能就没抓稳;手腕角度稍微偏一点,原本顺滑的插接便会卡住。两段动作在数值上看着差不多,落到机械臂上,结局可能完全不同。
所以,ActEffect没有急着给机器人接上一条更长的思考链,而是先让策略把三版答案都交出来:
第一版来自前馈分支,像是机器人的“第一反应”;
第二版是MIP动作头给出的粗提案;
第三版在粗提案上继续精修,生成最终会被执行的动作。
这个过程的关键就在“完整”两个字。因为扩散、流匹配一类策略在训练中会经过不少带噪的中间状态,很难把每一步都当成可执行动作送进世界模型。所以ActEffect选出的三份提案则各自完整,放在同一个起点下,谁会带来更好的后果,也就有了比较的基础。
接下来,受控世界模型登场。
它拿到当前的视觉状态和一份动作提案,随后预测这段动作执行下去,场景会发生什么变化。三份动作要分别走一遍,等于让机器人在训练场里提前看了三次结果。
这里还有一个颇有意思的处理。语言指令继续留在VLA策略一侧,负责告诉机器人要做什么;受控世界模型只看当前画面和动作,不再读取任务语言。
例如同样伸手推一下杯子,杯子如何移动,取决于它现在的位置、周围环境以及机械臂施加的动作。至于指令写的是“挪开杯子”还是“清理桌面”,并不会改写这次推动产生的物理变化。
除此之外,ActEffect还把未来状态放进冻结的DINOv3视觉特征空间。它不用费力生成一张逼真的未来画面,只需抓住物体位置、姿态和场景结构如何变化。所谓“物理原生”,落点也正在这里。任务语义仍由VLA处理,动作带来的状态变化则被单独拎出来学习。
不过,看过三版结果还不够的,还有一个重要的关键环节,是把差别传回策略。
训练数据里本来就有动作执行后的真实观测。受控世界模型会把三次预测与这个真实未来逐一比较,要求精提案比粗提案更接近,粗提案又要胜过第一版前馈提案。
于是,策略每改一次动作,都能知道这次修改究竟有没有把结果往正确方向推。
为了避免模型钻空子,ActEffect还给排序损失加上了梯度截断。差答案不能靠变得更差来衬托好答案,训练只能继续推动更好的提案靠近真实未来。
通过反馈信号进行学习,世界模型对“后果”的判断被写进策略权重。到了机器人上岗那一刻,受控世界模型和未来观测分支会一起拿掉,只留下MIP动作头完成粗提案和精修。
在了解完方法之后,接下来我们就得看它有没有真把机器人教会。
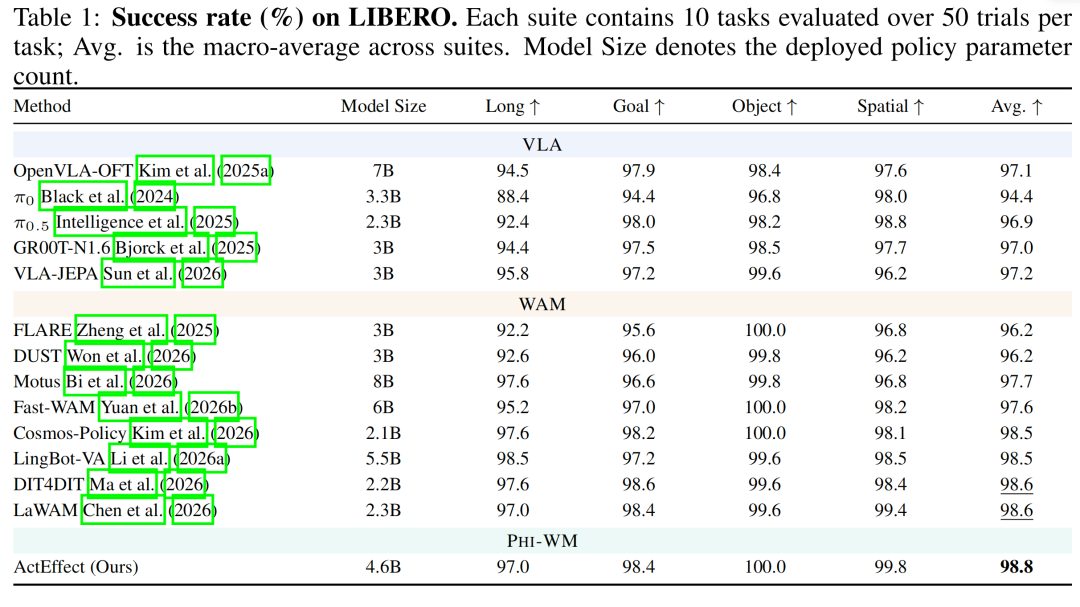
先来看下LIBERO。这个基准包含四组单臂、多任务桌面操作,ActEffect在此拿到了98.8%,比DiT4DiT的98.6%高出0.2个百分点。虽然领先不算大,但更值得看的信息是引入后果反馈之后,机器人原有的基础操作能力没有被练丢。
再来看加大难度后的LIBERO-PLUS。
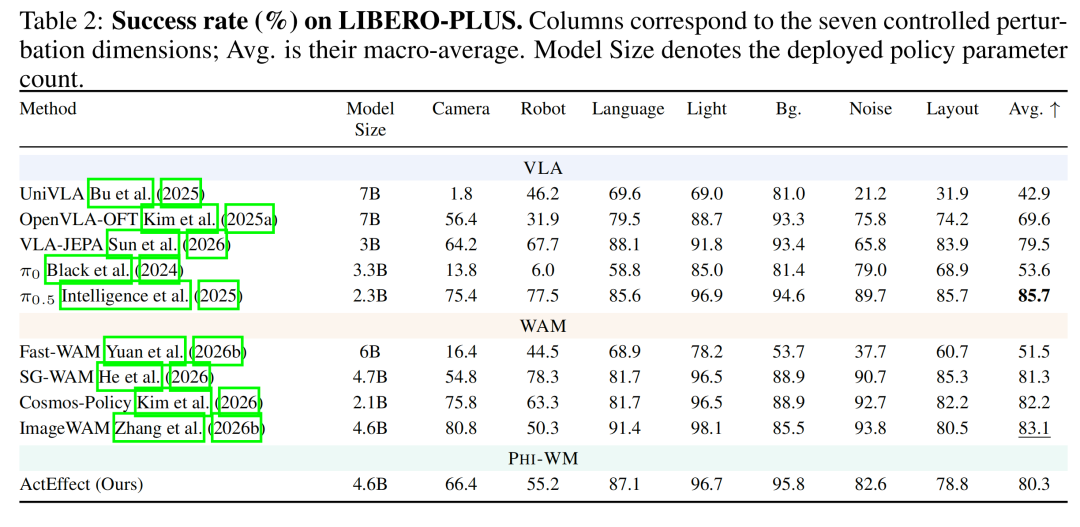
这套测试会改相机视角、机器人初始状态和语言表述,还会在光照、背景、传感器噪声、物体布局上制造变化。ActEffect的平均成功率为80.3%,相比Fast-WAM的51.5%高出不少。
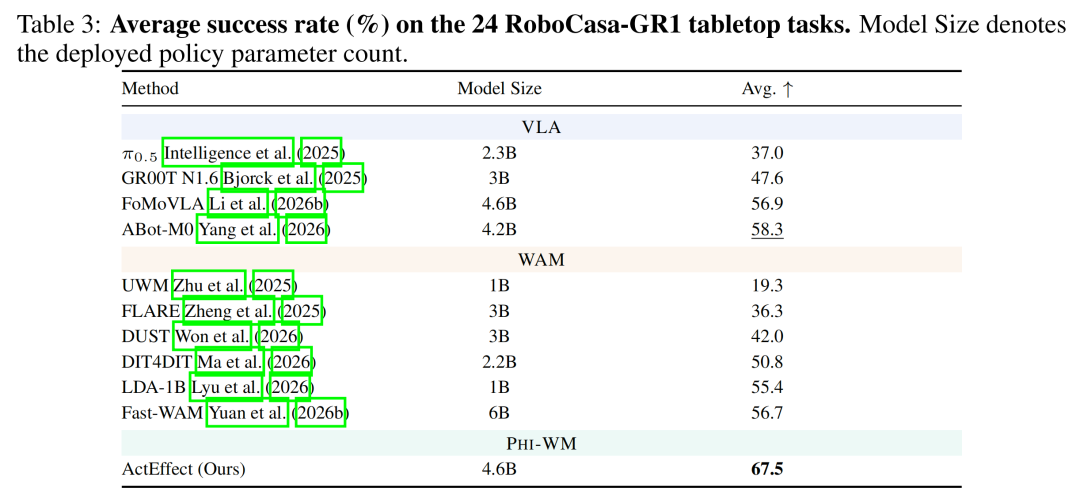
到了RoboCasa-GR1,任务又不一样了。模型要控制拥有双臂、灵巧手和腰部自由度的GR-1人形机器人,在29维动作空间里完成24项桌面操作。
ActEffect的平均成功率达到67.5%,比表中第二名ABot-M0高9.2个百分点,比Fast-WAM高10.8个百分点。动作维度更高、身体结构更复杂,后果反馈的作用也变得更明显。
消融实验则是把这套方法拧开来看了一遍。
去掉后果反馈,LIBERO平均成功率从98.8%降到97.0%;把DINOv3特征空间换成VLM表示,成绩来到97.3%;拿掉排序损失后,则回落到98.1%。
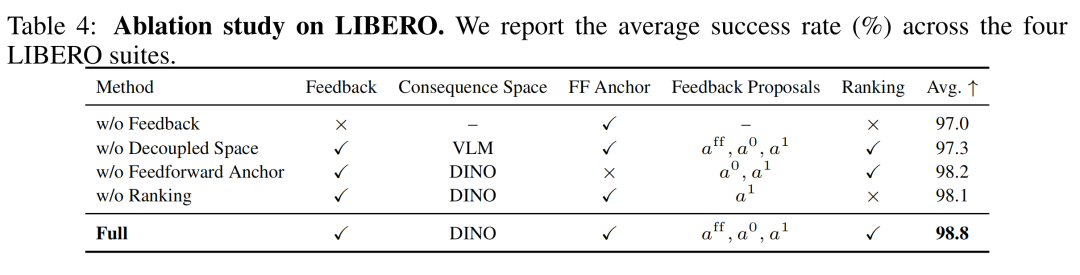
从这几组实验结果来看,ActEffect确实证明了这套训练方式的有效性。
为什么这种用法会与工业部署发生关系?
说到这里,受控世界模型为什么非得“退场”,也有了一个更现实的答案。
在实验室里看具身智能,我们的评价维度基本上就是任务成功率。但一旦进入到真实生产环境,这个维度就大变样了。
因为机器人在仿真环境里多跑一层模型,最后可能只是表格里的一项计算开销。而把同样的链路搬进汽车工厂,每一次推理都会进入产线的账本。
不仅如此,算力也会随着规模被放大。单台机器人每一步多做一次未来展开,看起来尚能接受。等方案复制到几十个工位、几百台设备,额外的显卡、功耗和维护都会变成实打实的成本。
而ActEffect把受控世界模型留在训练阶段,正好避开了这部分在线开销。它想从现有演示数据中再榨出一层监督,让机器人提前吃到“后果”的经验,上岗后又不必背着整套世界模型继续往前跑。
换句话说,它把“多想一会儿”留给了训练,把更短的链路留给了执行。
而光象科技选择这样的技术路线,也与它正在进入的场景有关。
汽车制造里有大量散乱件上下料、复杂曲面质检等任务。传统自动化设备往往围绕固定工位开发,一套夹具、一段轨迹服务一种零件。零件位置发生变化,或操作空间变得狭窄,原本稳定的流程就可能卡住。具身智能想补上的,正是这一段适应能力。
目前,光象科技已经围绕焊接上下料、移动质检等典型高价值工位完成真实场景验证,并与多家国内外头部汽车企业展开商业合作。在2026ATC展会上,团队把Phi-Bot X1放进了蔚来汽车焊接上下料场景,机器人连续运行3天,累计作业21.5小时,期间零失误、零中断。
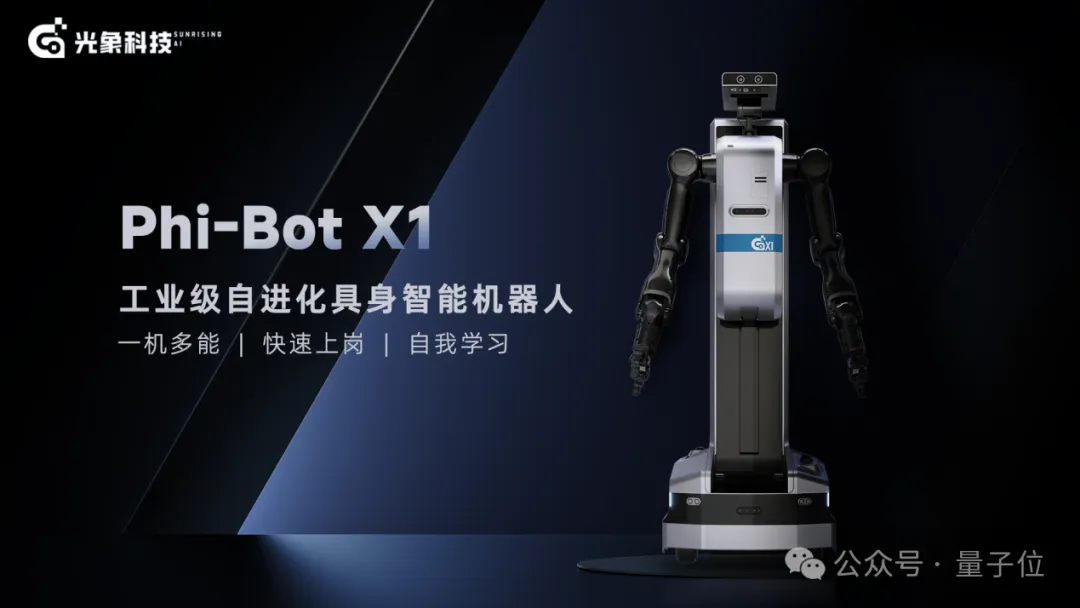
眼下,ActEffect已经在三项仿真基准上跑通了训练方法。真机这一棒,光象科技手里已有Phi-Bot X1接着往下跑。21.5小时的记录来自整套工业具身系统,下一步才轮到新模型沿着这条真实链路继续接受验证。
好在,光象科技并不缺少汽车产业里的工程经验。
光象科技成立于2025年4月,由清华大学车辆与运载学院和人工智能学院联合孵化。创始人兼CEO张涛是清华大学博士、米兰理工大学博士后,此前担任阿里巴巴高德地图技术总监和空间感知引擎负责人,相关技术曾进入汽车量产体系。联合创始人李升波长期从事自动驾驶与具身智能研究,也有多项技术进入产业应用。
因此,这家公司一边做强化学习和世界模型,一边也在搭机器人本体、数据算法体系和开发平台。进入工厂以后,模型只是整套系统中的一环。硬件要扛得住连续运行,系统得方便部署,出了问题还要能迅速维护。缺了任何一块,算法成绩都很难完整落到产线上。
具身智能的分野,最终会落在商业化能力上
过去两年,具身智能最不缺令人惊艳的演示。
机器人会跑、会跳、会叠衣服,也能听懂一长串指令。可到了客户现场,演示视频里的几十秒,很快就会被拉长成一天、一个月,甚至一整年的连续运行。
当然,工厂也不会因为一项基准成绩就签字验收。交付以后,少成功一次,都可能变成停线和维修工单。具身智能公司的差距,也会在这个过程中慢慢拉开。
机器人先要在约定时间里完成正式交付,随后是节拍、精度、安全性、故障率等一项项验收指标。过了这一关,同样的能力还得从一个工位迁移到相似工位,从一家工厂复制到更多工厂。
复制得越多,另一个问题也随之而来:每换一个客户,方案需要重新定制多少?部署要花多长时间?机器人和算力的投入,能否被节省下来的人力与停线损失覆盖?
这也是ActEffect把世界模型留在训练场的商业意味。
如果后果反馈能让策略在真机上更稳,又能省掉执行阶段的世界模型开销,那么机器人复制到更多工位时,算力成本不会跟着推理链路一起膨胀。对于一套准备规模部署的工业系统,这比单次演示里多完成一个动作更实在。
只是这条推论,目前还差真机数据来补上最后一段。光象科技现阶段已经完成一部分真实场景验证,并与头部车企达成商业合作。它选择的工位有明确需求,团队也兼具学术研究和汽车产业经验,这些条件让它有机会继续向交付环节推进。
验收和复制仍要一关关过。Phi-Bot X1在真实产线上复现验证中的稳定表现,同一套能力复用到新的车型、零件和工位,部署与运维成本持续压低,将让这些合作走得更远。
ActEffect同样要接受这张考卷。它已经在仿真里证明,世界模型未必需要一直跟着机器人,让它在训练阶段反复检查动作后果,也能把经验留给策略。这给世界模型进入具身智能提供了另一种位置安排,也碰到了工业部署最现实的两件事——稳定性和成本。
再往后,VLA、WAM等技术边界还会继续变化,各种方案也会互相吸收。对客户来说,这些缩写终究只是手段。客户是否愿意验收,方案能否快速复制,账能不能算得过来,都会给出更直接的答案。
ActEffect这个有些“反骨”的世界模型,它已经在训练场里完成了第一轮工作。
未来,在产线上顶住节拍、误差和一天天的连续运行,才是更难的一场考试。