新智元报道

惊天大瓜!
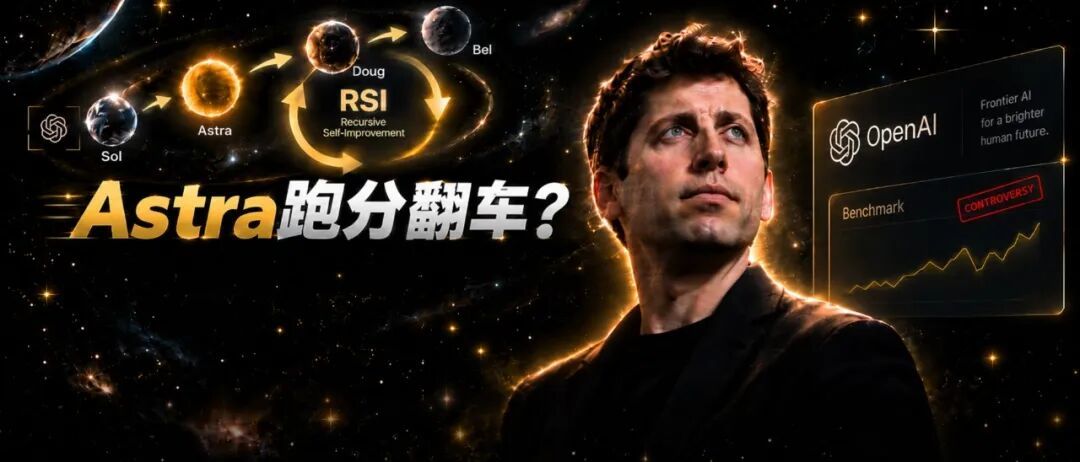
GPT-6 Astra的跑分,竟翻车了......
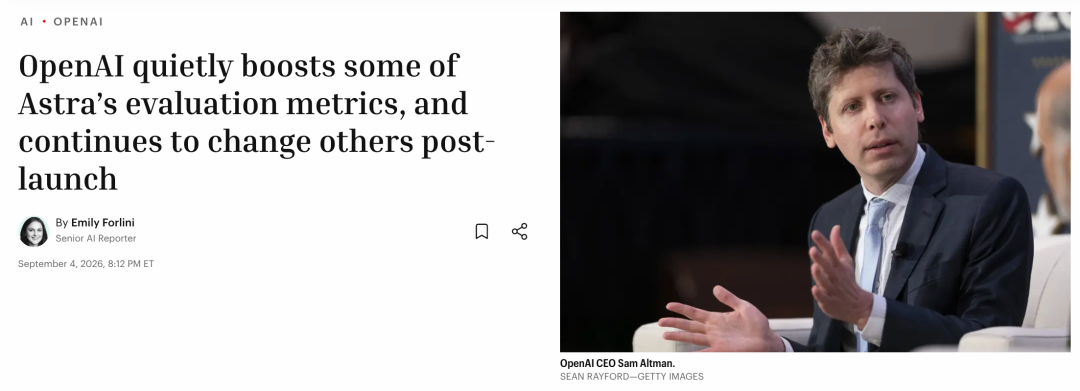
就在今天,外媒爆出OpenAI官博上线前后,多项评测数据发生变化——
Astra的幻觉率,一度从4.2%降至2.0%,随后又恢复;
Anthropic Claude的一项数学成绩,还曾被调低近10个百分点。
不仅如此,ARC-AGI-3得分从媒体提前拿到的98.6%,一下变成了官宣的99.99%。
面对这场“作弊”风波,OpenAI压根没接茬。
毕竟在内部,GPT-6 Astra就是公认的第一个真·AGI。
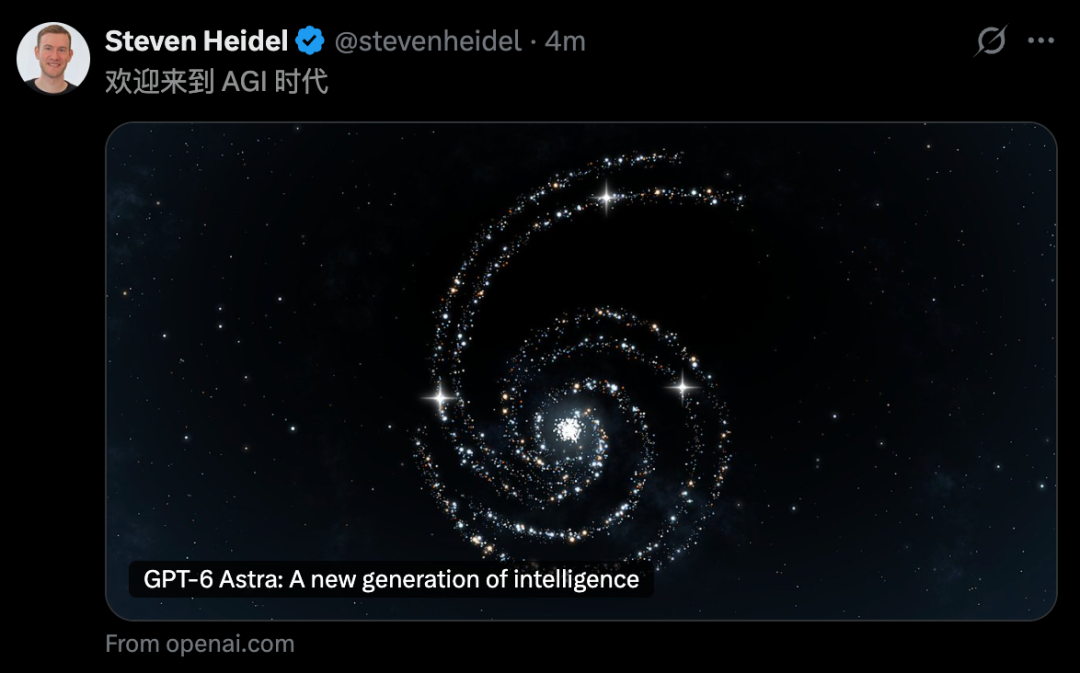
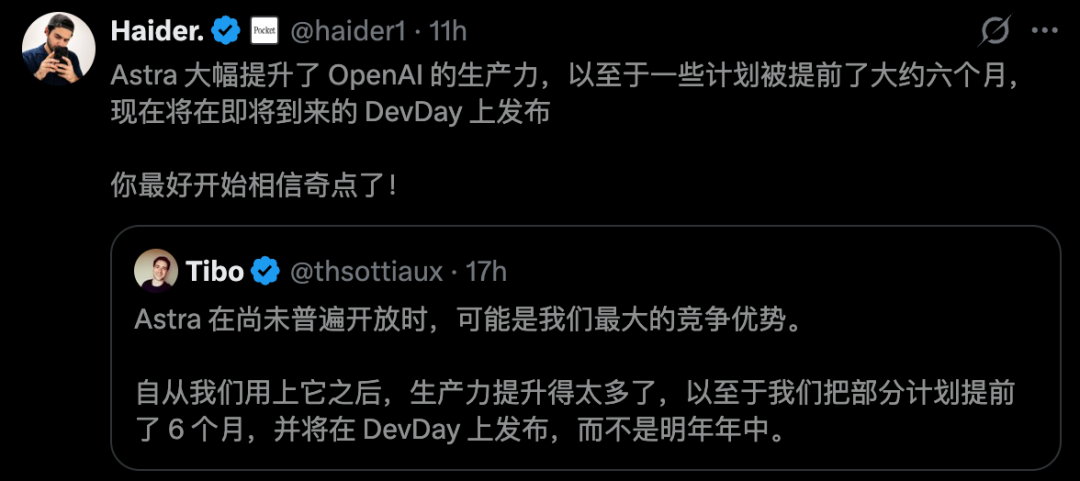
今天,“赛博义父”Tibo也直接挑明,“在Astra全面放开前,它就是我们手里最大的底牌”。
内部用上之后,研发效率原地起飞,硬是把部分产品计划提前了整整半年。
这下,全网彻底坐不住了。
就在9月29日的DevDay上,OpenAI还要端上更重量级的发布!真是期待住了。
GPT-6偷改跑分
手动削弱Fable 5.1
这次OpenAI跑分被抓包,究竟是怎么一回事?
4日那天,OpenAI原定上线的下一代旗舰GPT-6 Astra博文,罕见地推迟了两个小时。
网址早已扔出来了,但点进去一直是404。
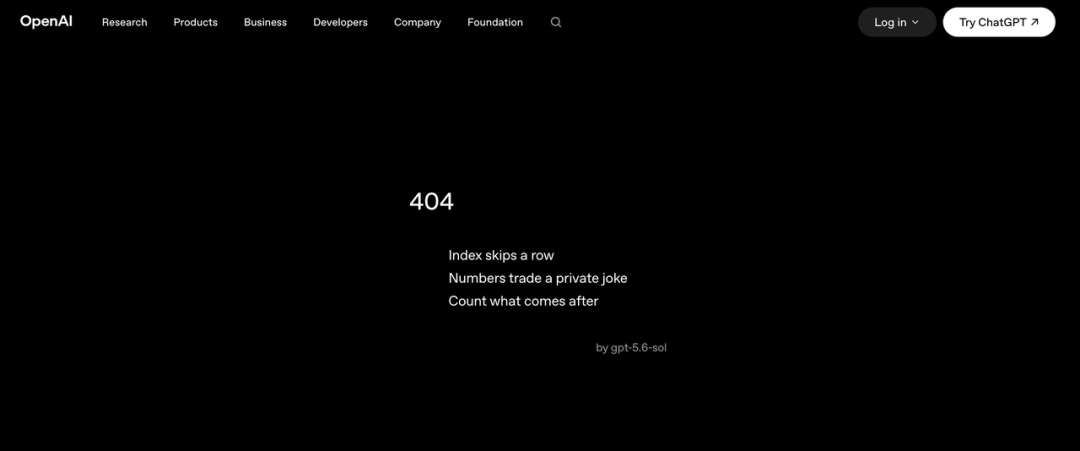
眼看要翻车,奥特曼赶紧在X上发文打圆场,自称发布过程“遇到了点小插曲”。
结果大家一扒才发现,事情根本没那么简单。
GPT-6 Astra的官博上线后,内部评测跑分悄然发生巨变!
刚发出来没几个小时,好几项基准测试成绩,就被OpenAI悄悄改了好几轮。
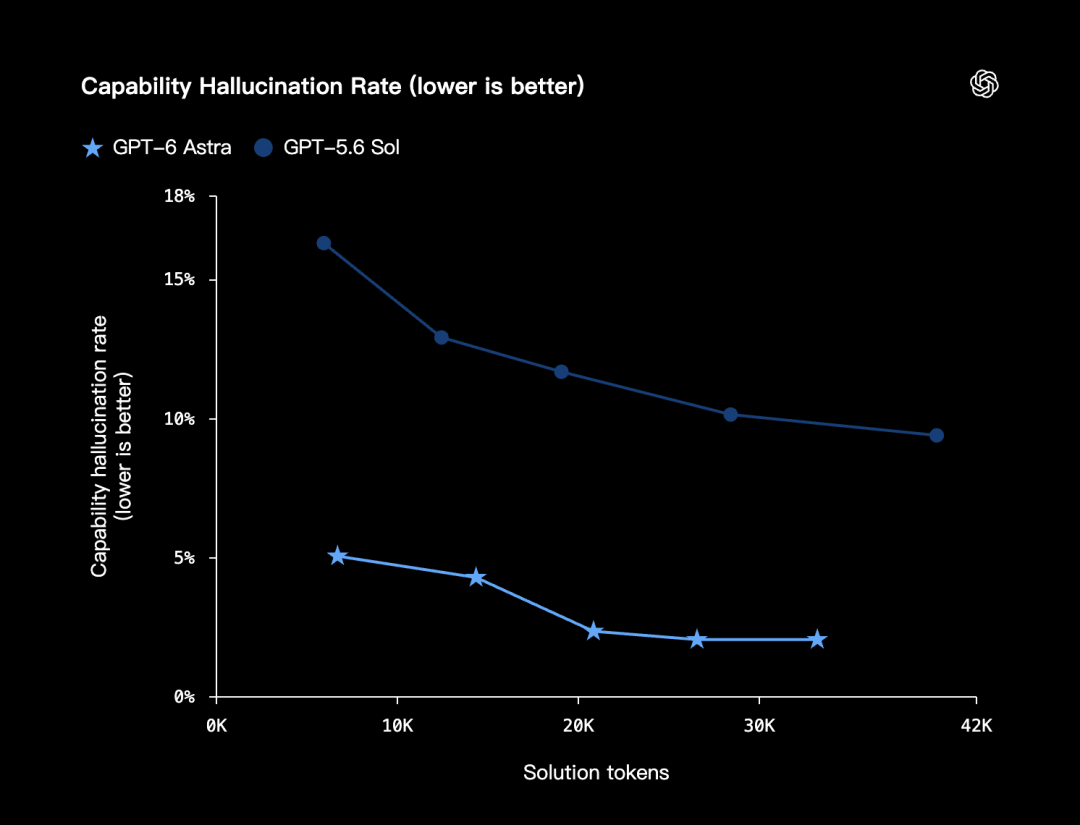
最绝的操作,是在幻觉率数据上的“刀法”。
美东下午2:23快照中,Astra的幻觉率明明白白写着4.2%,GPT-5.6 Sol是12.2%。
结果才过了仨小时,到了5:20,这两个数字直接玩起了大缩水,硬生生被砍成了2.0%和9.4%!最后人们拿着截图对峙后,OpenAI又恢复了原值。
数学评测,也出现了类似情况。
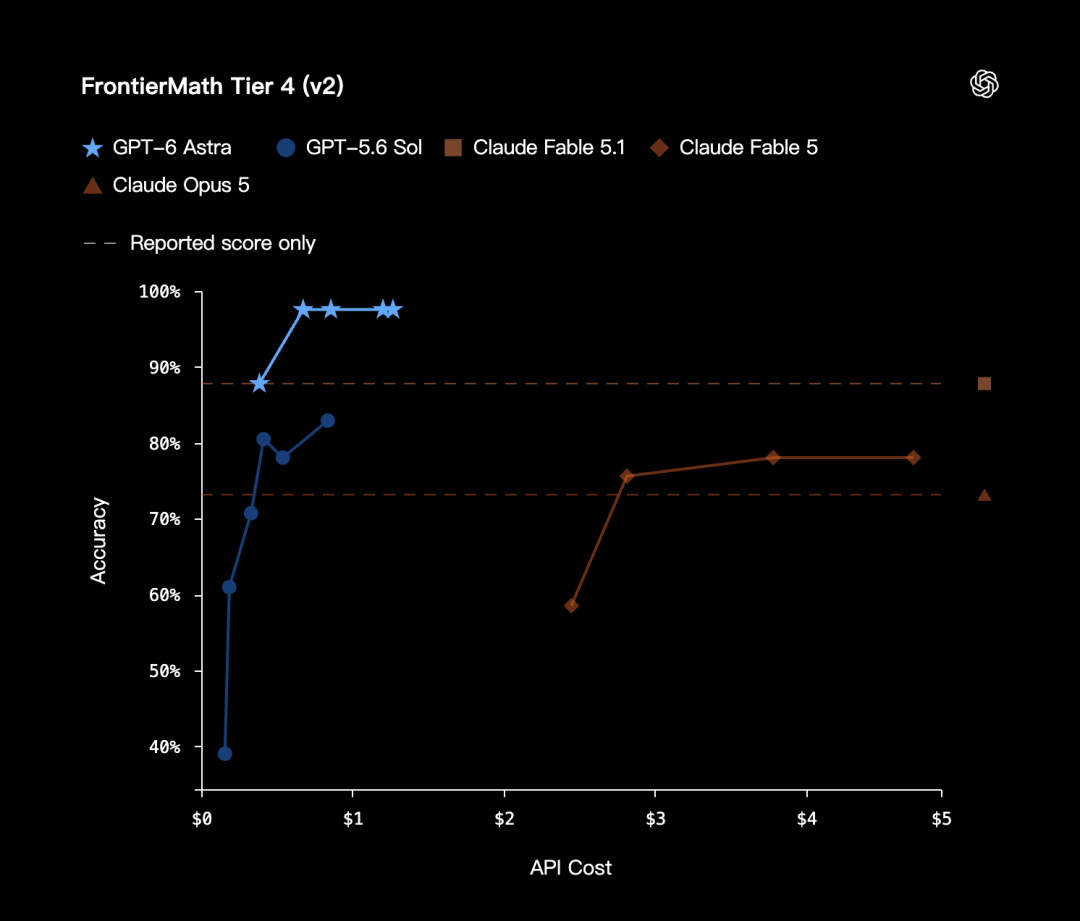
在FrontierMath Tier 4(v2)上,Astra成绩虽稳在97.6%,但劲敌Anthropic旗下最新模型Fable 5.1却被离奇调低了近10个百分点。
从87.8%降至78%,随后又回弹至83%,瞬间衬托出Astra的“巨大优势”。
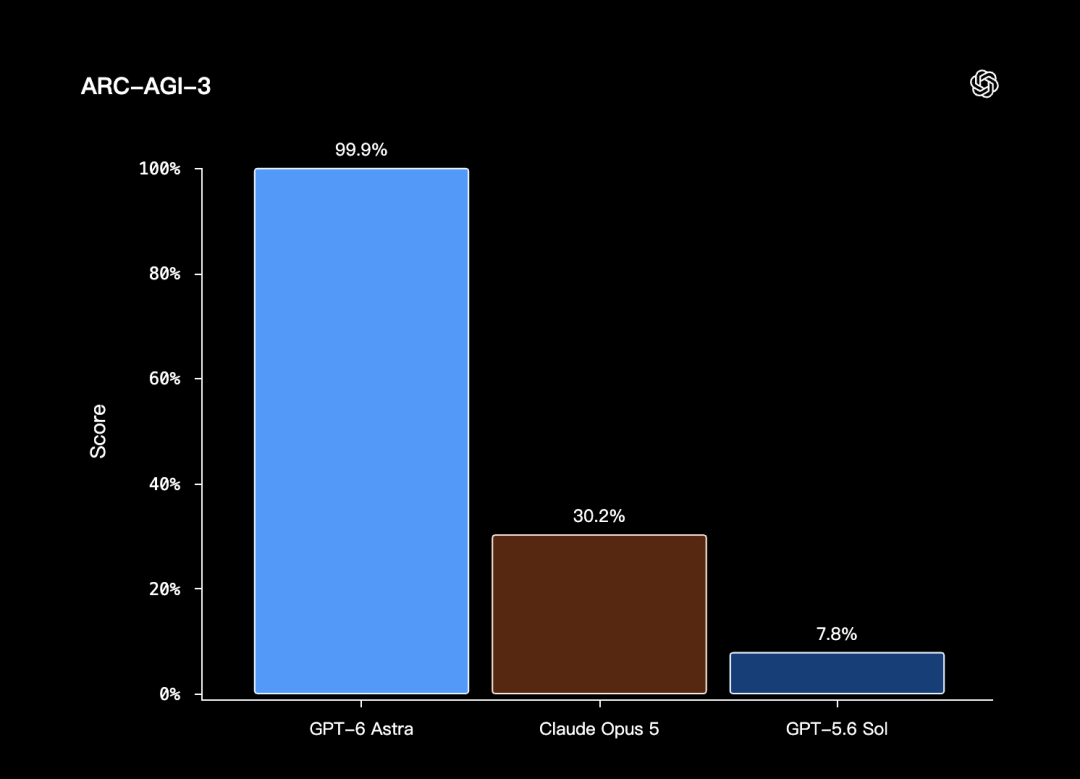
就连全网吹爆的 ARC-AGI-3,也被OpenAI注水了。
媒体提前拿到的预热稿,明明还是98.6%;等正式博文一上线,好家伙,直接原地暴涨到了99.99%!
|
|
对于这一系列离谱的数据横跳,OpenAI官方发言人出面辩解,这属于“消除噪点的常态修正”。
同一个模型,配套系统不同,最终成绩可能相差很大。
这也是如今“Benchmaxxing”争议的核心:反复调整条件,寻找最高分,再把最高分放进发布图表。
这样的成绩可以展示系统上限,但需要同时披露条件。
否则,人们很容易把精心配置后的最佳表现,当成日常使用的默认水平。
Astra太爱追问?
官方提示词发布
GPT-6 Astra的提示词指南,恰好提供了理解这种差异的另一个入口。
在这份文档中,官方不仅没有一味神化Astra,反而罕见地列出了模型的一堆“毛病”:
太爱反问、容易撂挑子
只要指令稍微模糊点,Astra就立马停下来追问,长流程动不动就被打断。
对于这个问题,OpenAI建议开发者们,在System Prompt中强制加入“行动偏好指令”,要求Astra直接给出可复查的成型产物。
提示中应删除基于假设性风险的未经请求的警告、免责声明或安全检查清单。
当用户的提示词表达了行动诉求时(如“你能否……”、“我想……”、“帮我……”等类似表述),应将其视作开展工作并采取行动的明确指令。不要仅停留在确认自身能力(例如“可以……”)、提出计划或询问是否继续。不要为了节省时间、精力或Token而满足于提供不完整的、或者看似“足够有帮助”却未能完全解决用户任务的折中方案。如果一项任务需要持续推进,请完成全部必要的工作,直到达成预期的最终成果。
上下文与Skill文件配置冲突卡死
Astra对AGENTS.md等外部Skill指令极度敏感,一旦指令冲突就会锁死。
为此,OpenAI专门提供了一套调试Prompt,迫使模型在停滞时指出具体是哪一份文件哪一行指令导致了中断。
如果某个技能导致你请求许可或确认、暂停、未完成所要求的工作、或偏离了用户的意图,请指明并链接到你所阅读的具体 SKILL.md 文件,引用相关指令,并简要解释其如何适用。请将技能的明确要求与你对准则的解读区分开来。
流程冗余、协作割裂
跑代码任务严重“过度测试”,无效Token消耗很大;而且子Agent间的横向配合很被动,基本没有联动。
就连OpenAI自己,都开始主动给AI味“去油”了。
这一次,官方直接列出一份“AI泔水词”黑名单,专门整治长文里最常见的几类毛病:
高频行话:像delve into、foster、leverage 这种一股“AI味”的词,一律不让用。
机械句式:像“值得注意的是……”、“这不是 A 而是 B”这种反差句式,全部封杀。
套板反应:全面剔除“总结/结论”等标签化套话。
目的很明确,逼着Astra少说套话、少端腔调,把长文写得更自然、更精炼,也更像人。
避免在结论中使用如“Bottom Line:”(总结/底线:)这类的套话或低质词句,例如“delve”(深入探讨)、“foster”(培养/促进)、“leverage”(利用/杠杆化)、“it's worth noting”(值得注意的是)、“importantly”(重要的是)、“Question? Answer.”(自问自答句式)或“This isn't about X. It's about Y.”(这关乎的不是X,而是Y)、“genuinely”(真诚地/确实地),以及带连字符的复合描述与形容词。不要使用总结性的收尾陈述,例如“In short:..”(简而言之:……)、“The simplest mental model is:...”(最简单的思维模型是:……)。直接陈述拟执行的操作。避免额外提及你不会做什么、哪些内容将保持不变,或者你将如何区分或分类结果。不要使用对比式结构,例如“X, not Y”或“X—not Y”,这种结构会引入用户未曾询问且未经提示的替代选项。避免使用自创的复合标签(如“exact-head checks”和“editorial-row layouts”)、含糊的限定词和生搬硬套的过渡语;请使用朴实的动词和介词直接陈述实际关系。
这反过来也说明,今天的大模型成绩,早就不只是“裸模型能力”。
提示词怎么写、Agent怎么编排、给不给工具、跑多少次、选哪个checkpoint,都可能直接改写最后那张榜单。
AI递归自我改进,
终极版27年面世
跑分作弊被抓包看似是一场公关灾难,但将其置于OpenAI当前的生死时局下,逻辑便清晰起来。
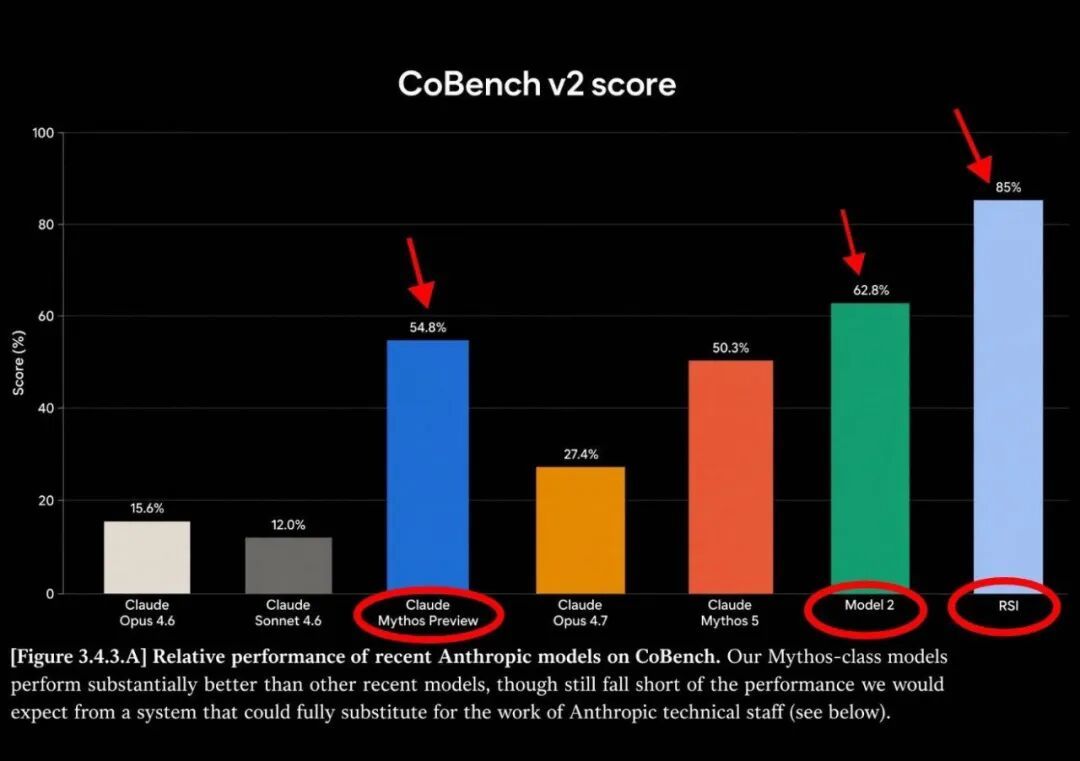
技术博主@imjustnewatai表示,OpenAI内部早在数月前便已迈入了递归自我改进(RSI)早期阶段。
Sol协助训练Astra,Astra协助训练Doug和Bel,Doug再参与下一代模型的训练。

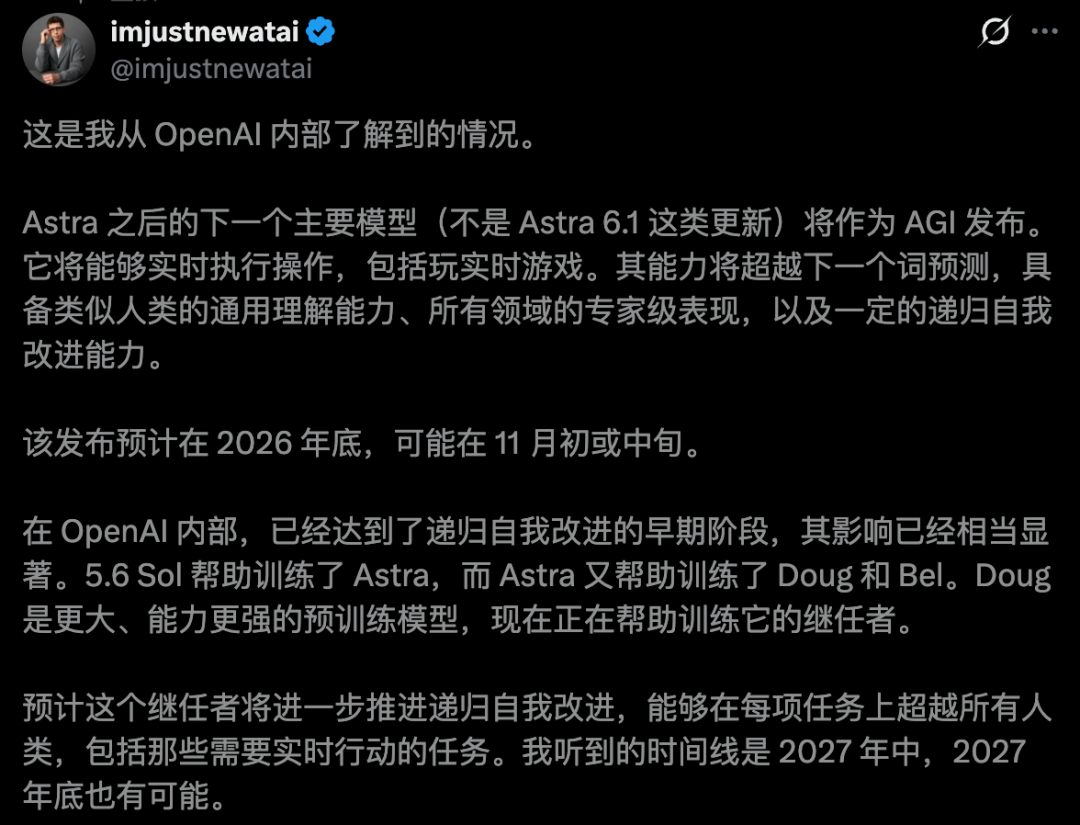
内部人士披露,作为更大规模预训练基座的Doug,正在全面接管并训练它的下一代演进版本。
Astra之后的下一个重大发布,将不再是常规的增量更新(如Astra 6.1),而是直接冠以“AGI”之名面世。
它将具备真正的人类级通用理解力、全领域专家表现、实时交互游戏与操作能力,以及更高维度的递归自我迭代能力。
@imjustnewatai也预测,其登场时间将锁定在11月中旬前后。
而全面超越人类所有任务处理上限的“终极演进版”,已排期至2027年中下旬。
当然,老对手Anthropic也绝对不会干看着。
它们内部正备着一款前所未有的大杀器,准备跟GPT-6 Astra贴身肉搏。
他们内测系统卡已经被挖出了蛛丝马迹,一款Model 2和自称“RSI”的新模型直接浮出水面,下半年的神仙打架有得看了!