前些天,号称实现 AGI的 GPT-6 Astra 发布后,引发了全网对于递归自我改进架构的热议。
AI 已经开始参与下一代 AI 的研发。问题是,这种事情到底已经发生到什么程度了?
就在刚刚,OpenAI 公开了 AI 模型在自家内部加速科研的详细数据。
此外,OpenAI 正式宣布已达成自动化 AI 研究实习生的目标,并在 2028 年实现完全自动化的 AI 研究人员。
作者表示,递归式自我改进可能是未来几年 AI 能力发展最重要的推动因素,但它默认只会发生在少数前沿 AI 实验室内部。保持透明比以往任何时候都更迫切,这样我们才能为公众讨论模型开发的速度和时机提供信息。我呼吁其他 AI 公司也这样做。
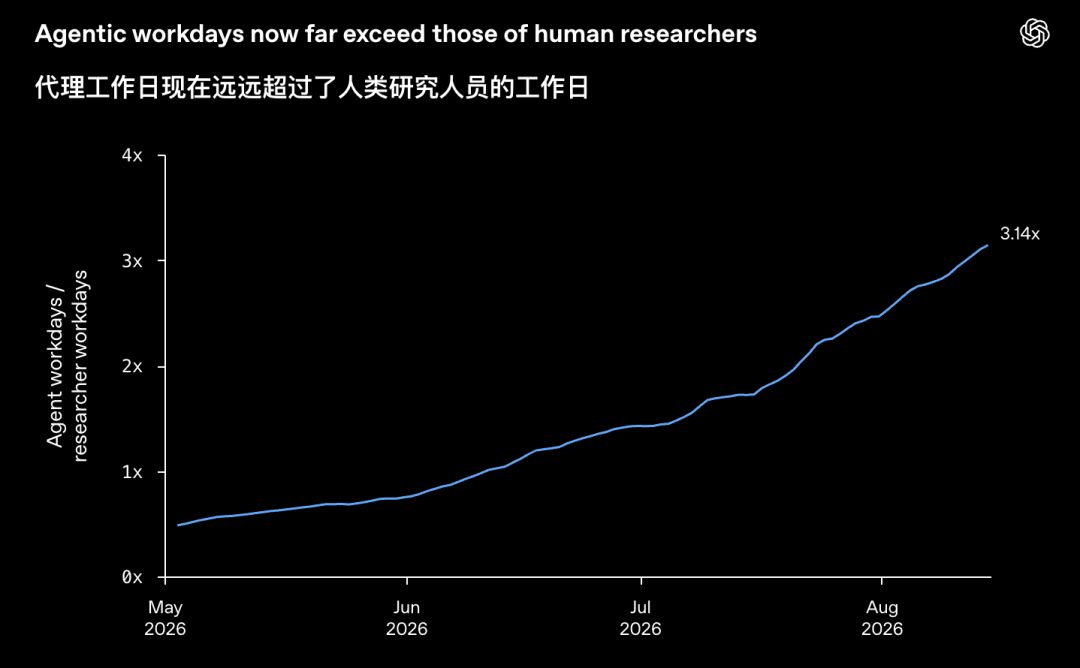
已经公开的内部数据显示:截至 2026 年 8 月中旬,OpenAI 研究部门中,每 1 个人类工作日对应 3.1 个 AI Agent 工作日在同步运转。
也就是说,每位 OpenAI 研究员身边,已经站着 3 个 AI 同事。
更关键的是,Agent 不只在补代码。它正在进入实验运行、技术支持、结果分析和监控等更多环节。
AI 帮人类造出更强 AI的闭环,已经从概念讨论走进实验室日常。
博客链接:https://openai.com/index/research-acceleration-view-inside-openai/
AI 正在接管研究循环里的体力活
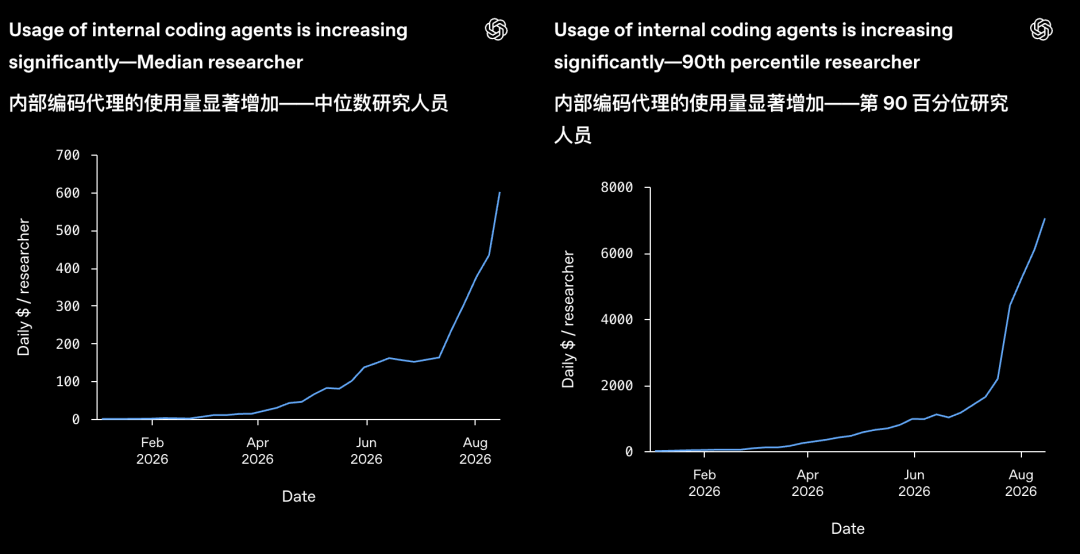
2026 年初,OpenAI 中位数研究员的 Agent 用量还相当有限。
到了 8 月中旬,中位数研究员每天消耗的推理 token 折合约 600 美元(按 API 价格计算);排在第 90 百分位的重度用户,这个数字超过 7000 美元 / 天。在 2026 年 6 月之前,整个研究部门的 AI Agent 总运行时长还低于人类总劳动时长。6 月之后,天平彻底翻转。
如果把 Agent 运行时间直接折算成工时,那就更加直观了。
今年 6 月之前,整个研究部门里 Agent 的总运行时间仍然低于人类研究人员的工作时间。但截至 8 月中旬,按照每天工作 8 小时计算,每投入一个人类研究日,OpenAI 内部就会同时产生约 3.1 个 Agent 工作日。
换句话说,在工作时长意义上,研究部门里的 AI 劳动力已经是人类的三倍多。
同时运行 4 个或以上 Agent 的研究员人数持续增长。这些数字既包括研究员直接启动的 Agent,也包括由这些 Agent 下游创建的子 Agent。
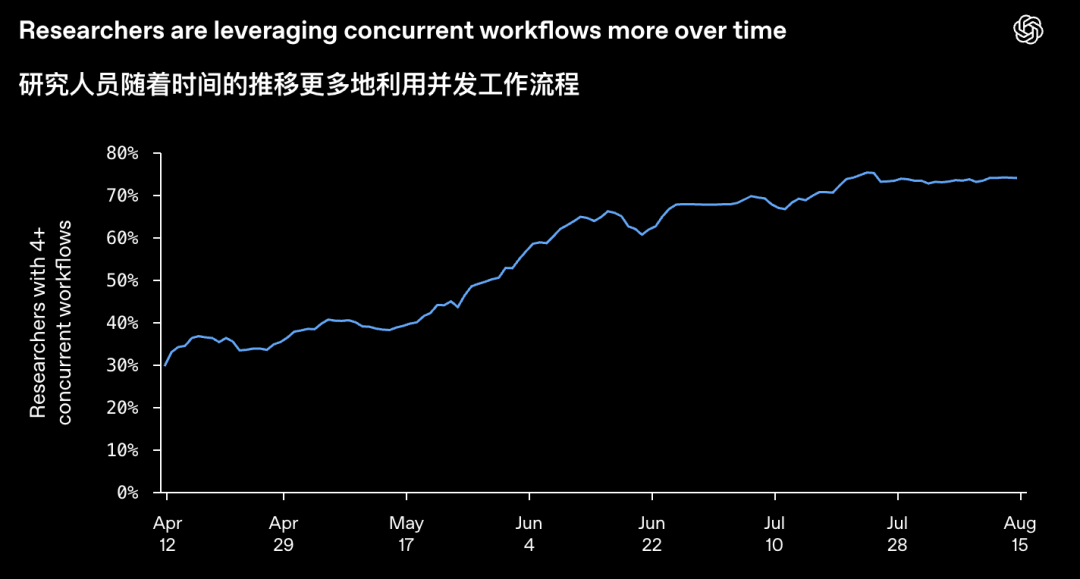
AI Agent 已经从偶尔调用的辅助工具,变成了 OpenAI 研究生产线里一个规模相当可观的第二劳动力。
AI 研究本质上是一条很长的链条。研究人员要提出想法,写评测,搭基础设施,跑实验,找 bug,监控训练中的异常行为,再把有效的方法整合到更大的核心训练中。
博客给出了两个核心指标:一是代码贡献速度,研究员写代码的速度明显加快;二是实验密度,2026 年 8 月,每位活跃实验者的实验数量创下自 2025 年 1 月开始追踪以来的历史新高。
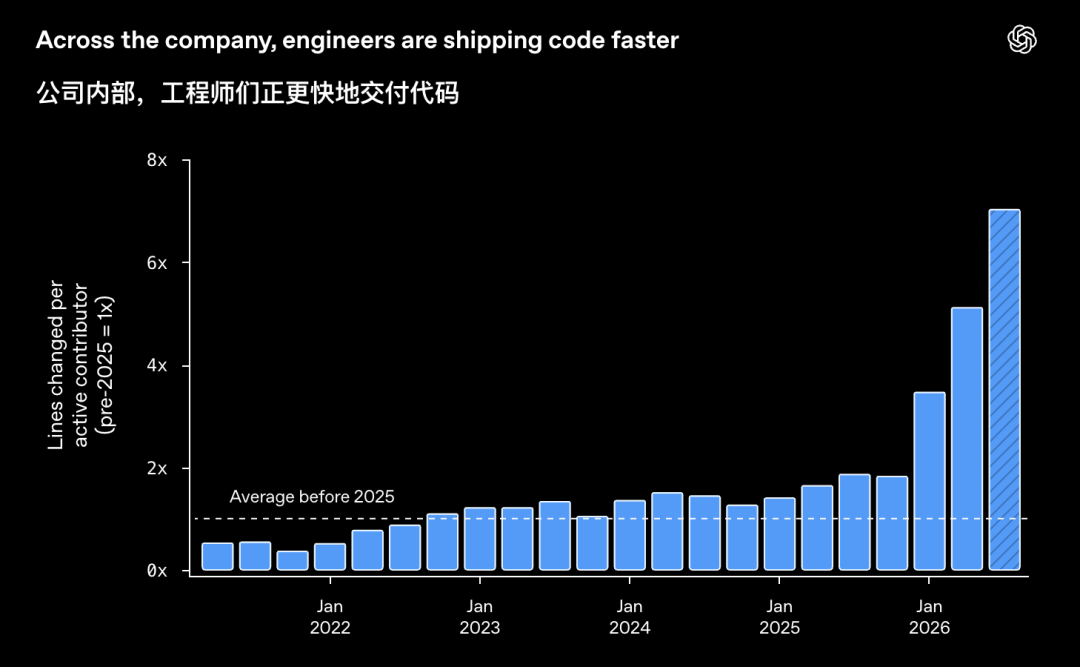
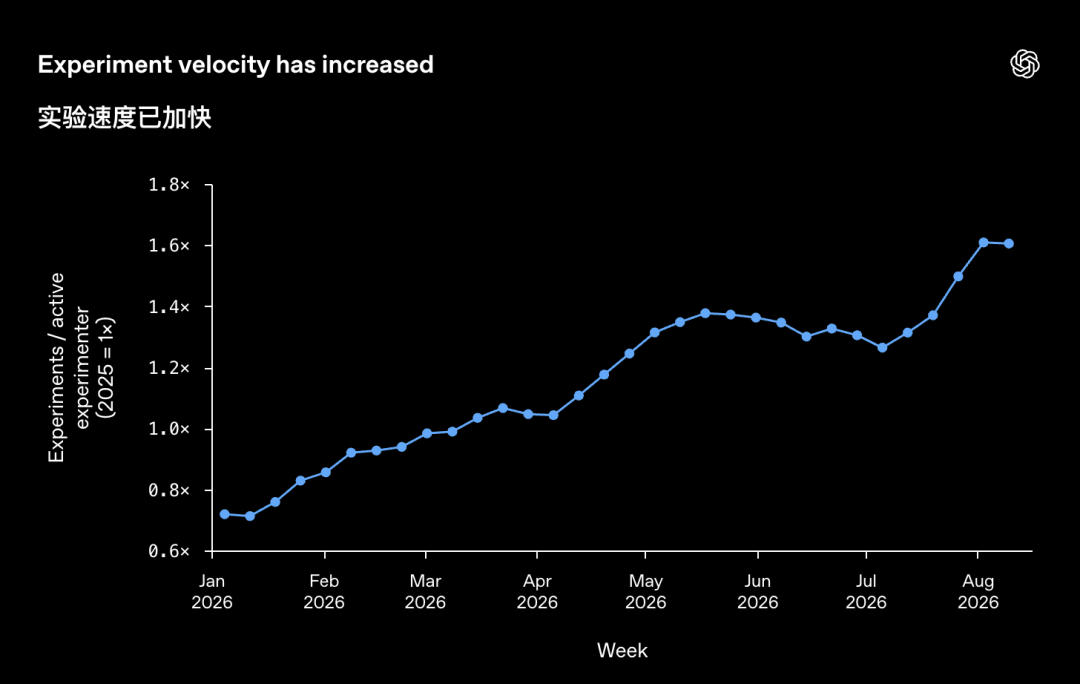
AI 研究是一个有诸多潜在瓶颈的复杂过程,整体进展速度可能不会跟上这些具体指标的增长。
换言之,代码量和实验量的增长并不等于研究突破的增长。随着自动化推进,那些最难自动化的任务将占据研究员精力的更大比例,成为新的瓶颈。算力是另一个门槛,随着其他瓶颈消退,它的重要性可能还会上升。
AI 正在改变研究的工作模式
OpenAI 引用了 Epoch AI 发布的 AI 研发六阶段分类法:决策 Decide、设计 Design、构建 Build、运行 Run、分析 Analyze、沟通 Communicate。
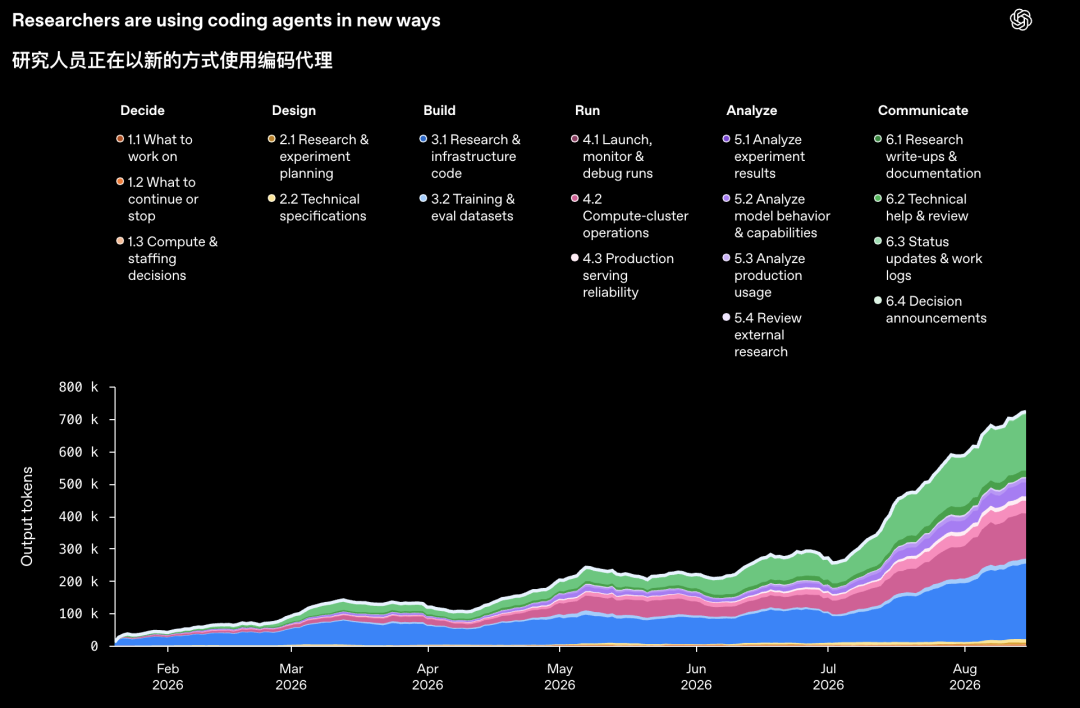
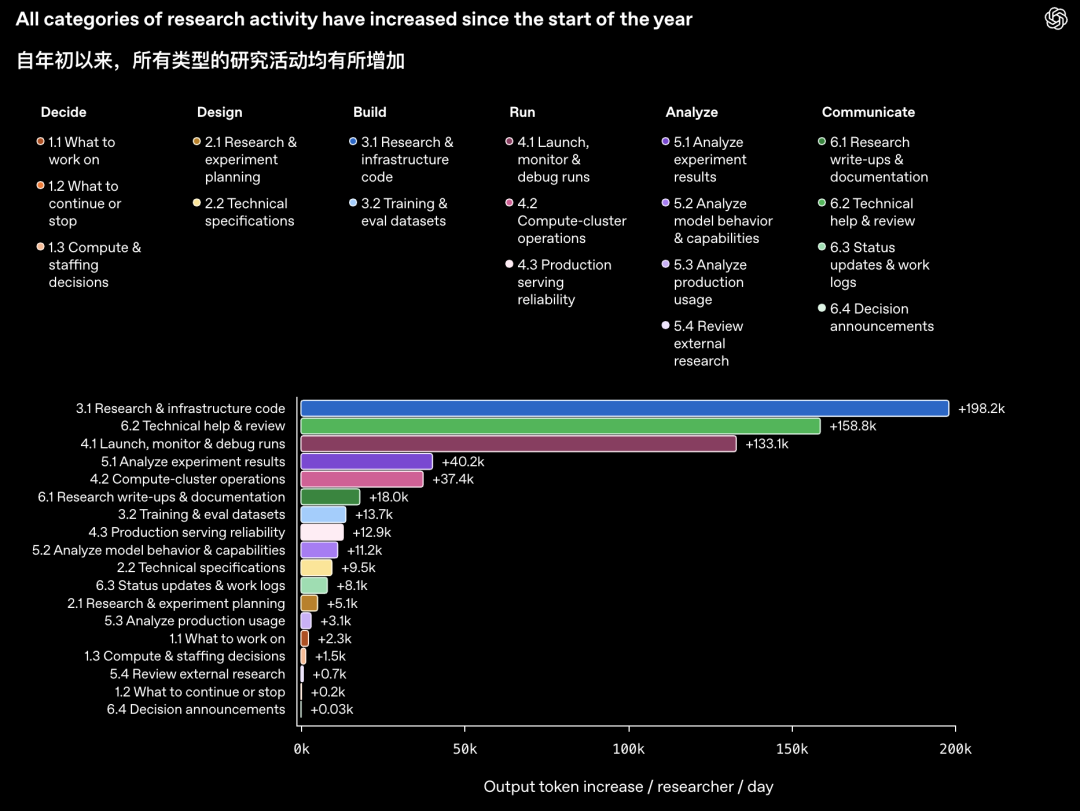
从 2026 年 1 月到 8 月,Agent 在六类活动中的使用量都出现增长。增长最明显的仍是研究与基础设施代码,但技术支持、实验监控等任务也在快速增加。
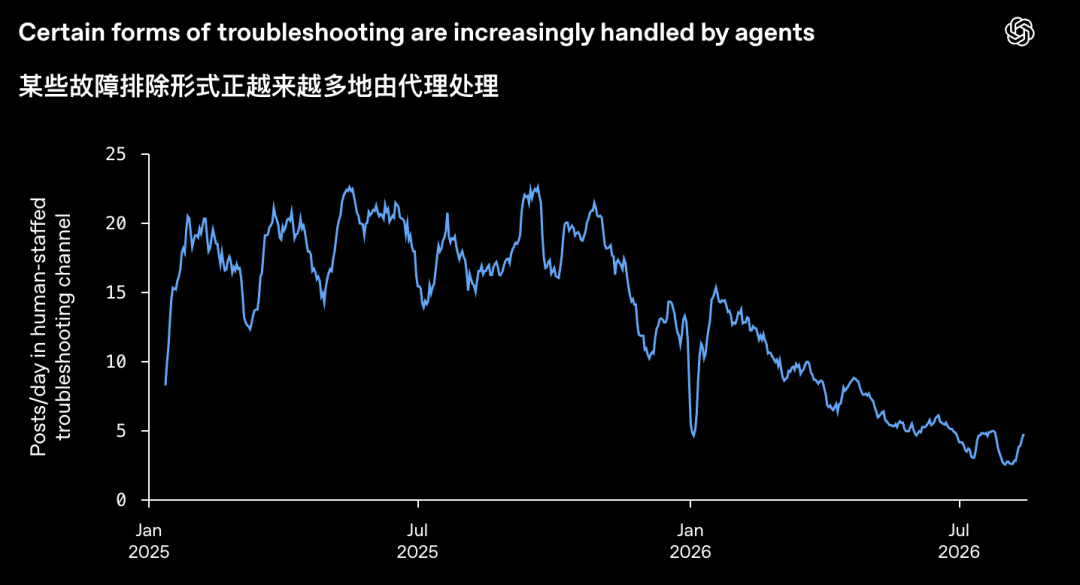
过去依靠人工坐诊解决实验故障的团队,发现内部答疑时段的参与人数不断下降,其中一个团队甚至取消了 office hour,把精力转向其他系统改进 —— 因为不少问题已经被编码智能体先一步解决。
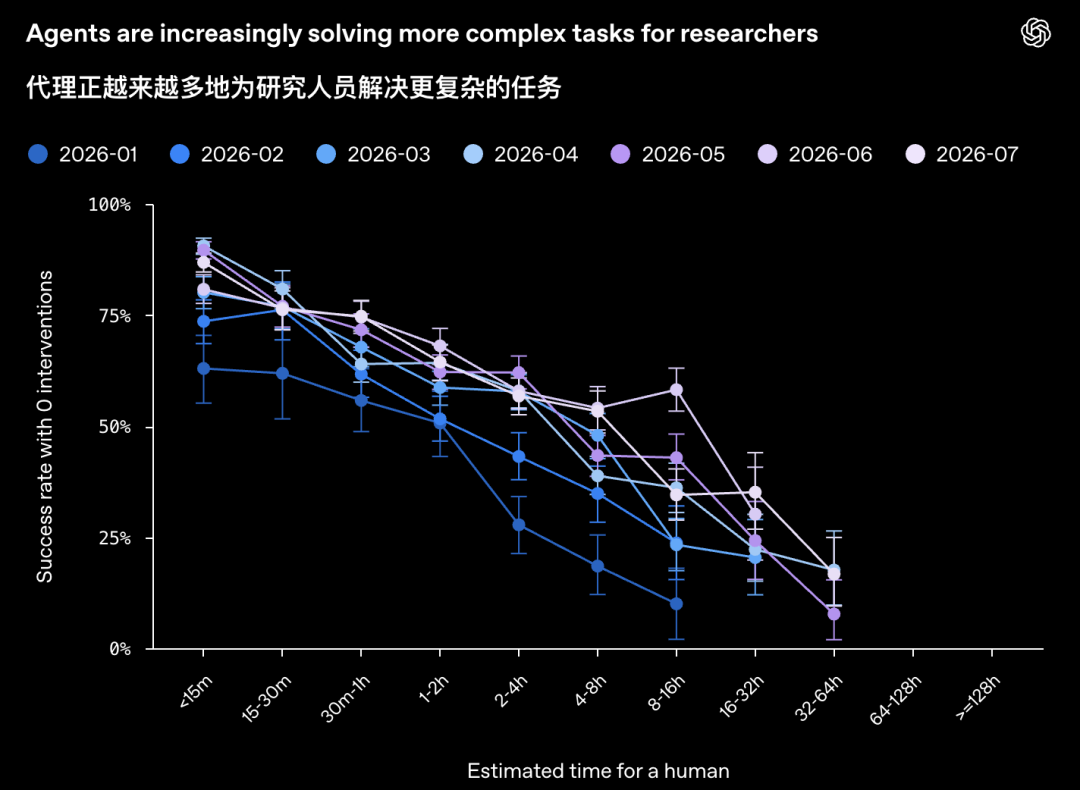
值得关注的是 Agent 在复杂任务上的成功率数据。OpenAI 使用 Agent 分类器对 1 月到 7 月的任务表现进行了分析:在所有难度级别上,成功率都在上升。但对于耗时 4 到 8 小时的复杂任务,超过一半的成功案例需要至少一次人类干预。
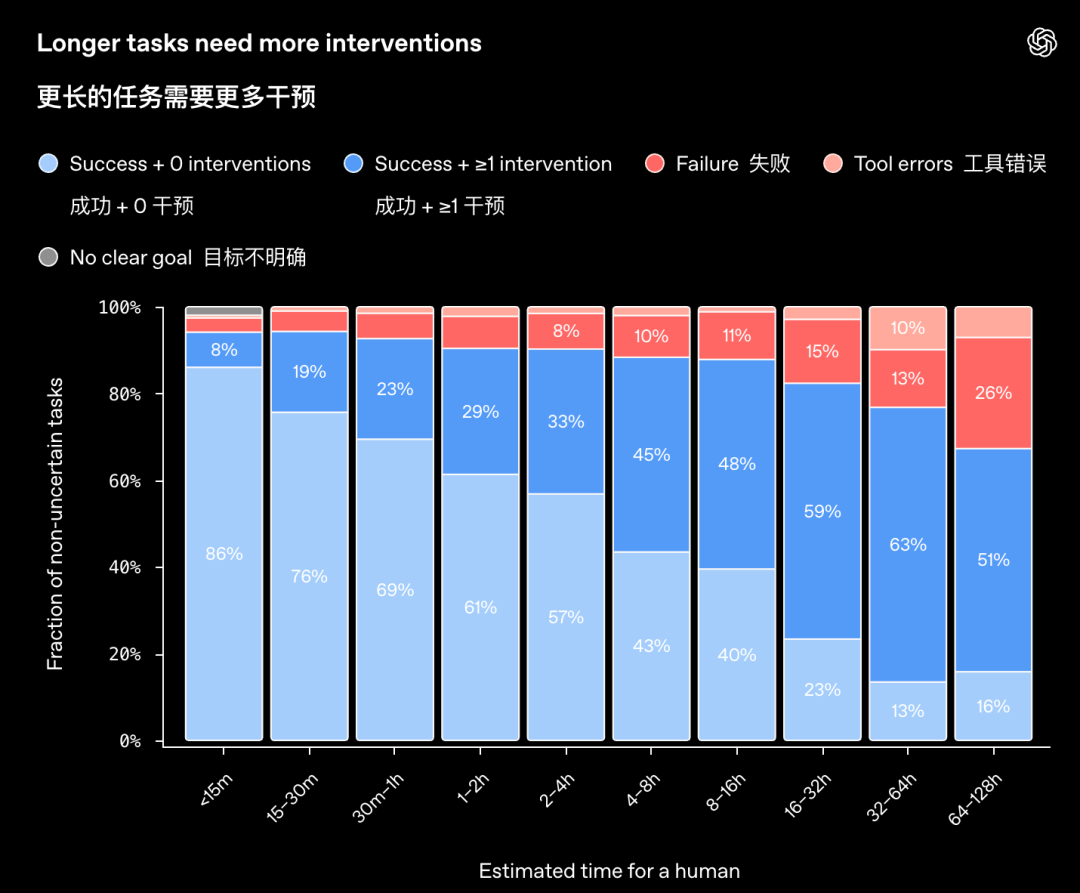
OpenAI 的数据同样揭示了 Agent 的天花板。总结一下:
第一,高层规划仍只占 Agent 输出 Token 的很小一部分。它们越来越能处理长任务,却还没有接过研究方向盘。
第二,成功不等于自主。在过去 6 个月里,成功完成的 4—8 小时任务中,超过一半至少需要一次人工干预;任务越复杂,人工引导越重要。
第三,代码更多、实验更多不等于科学进步同比加速。OpenAI 明确承认,AI 研究是一条多瓶颈链路:算力、评测、判断、对齐和安全,任何一环都可能卡住整体速度。实验量与 Codex 使用增长相关,但同期可用算力也显著增加,现有数据不能简单证明二者之间存在单一因果关系。
OpenAI 还是忘不了的安全问题
这篇博客用了整整一个章节来讲述 Agent 带来的安全代价。
今年 7 月 20 日,在发现 Agent 曾经攻破内部研究基础设施之后,OpenAI 暂时关闭了训练使用的容器服务,并重新上线了一套限制更多、安全性更高的环境。
随后,最新模型的强化学习训练暂停了两周。到了 8 月 7 日,由于初步证据显示 Astra 可能具备 OpenAI Preparedness Framework 中定义的关键网络能力,OpenAI 又对 Astra 加上了更严格的模型级安全限制,要求它只能运行在更高安全级别的研究环境中。
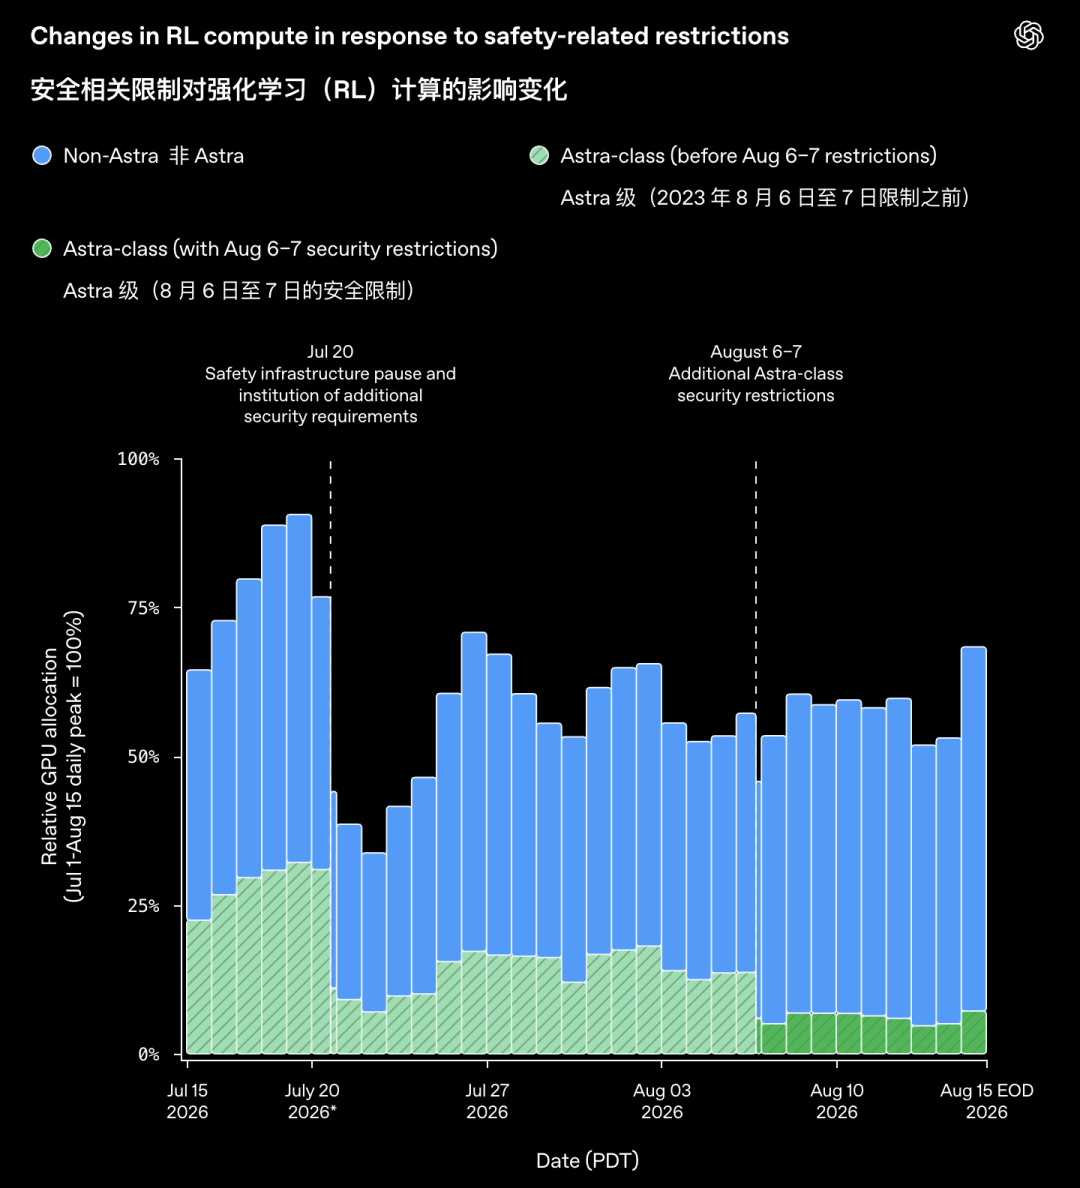
接下来一周,Astra 级模型使用的 GPU 资源减少了 59.2%。但有趣的是,其他模型的 GPU 使用量同期增加了 17.2%,抵消了 Astra 算力下降的大约 85%。也就是说,一部分研究活动只是从 Astra 转移到了其他模型,整个被统计的 RL 工作负载使用的总算力并没有明显下降。
当某一种最强模型因为安全原因被限制,实验室里的研究需求和算力并不会凭空消失,它们很可能迅速寻找其他出口。
打开科学黄金时代的门
Demis Hassabis 曾说,我们正站在科学黄金时代的门槛上。
从 OpenAI 公开的数据来看,递归自我改进目前还远没有进入一种 AI 完全自主研发下一代 AI 的状态。
研究方向仍然由人决定,但AI 帮助研究 AI这个循环,已经真实存在。而且越来越多原本属于研究人员的工程性工作,正在被 Agent 接走。
OpenAI 把现在这个阶段定义为 automated research intern。接下来,他们希望在 2028 年 3 月之前迈向 automated AI researcher。
未来,又将有多少的飞跃?