闻乐 发自 凹非寺
数学史级别的大新闻,愣是被OpenAI整成了一出连续剧。
刚被数学家指控抢成果,OpenAI紧急官宣:
一个尚未发布、能力显著超过GPT-6 Astra的内部模型,已经解决了纳维–斯托克斯存在性与光滑性问题。
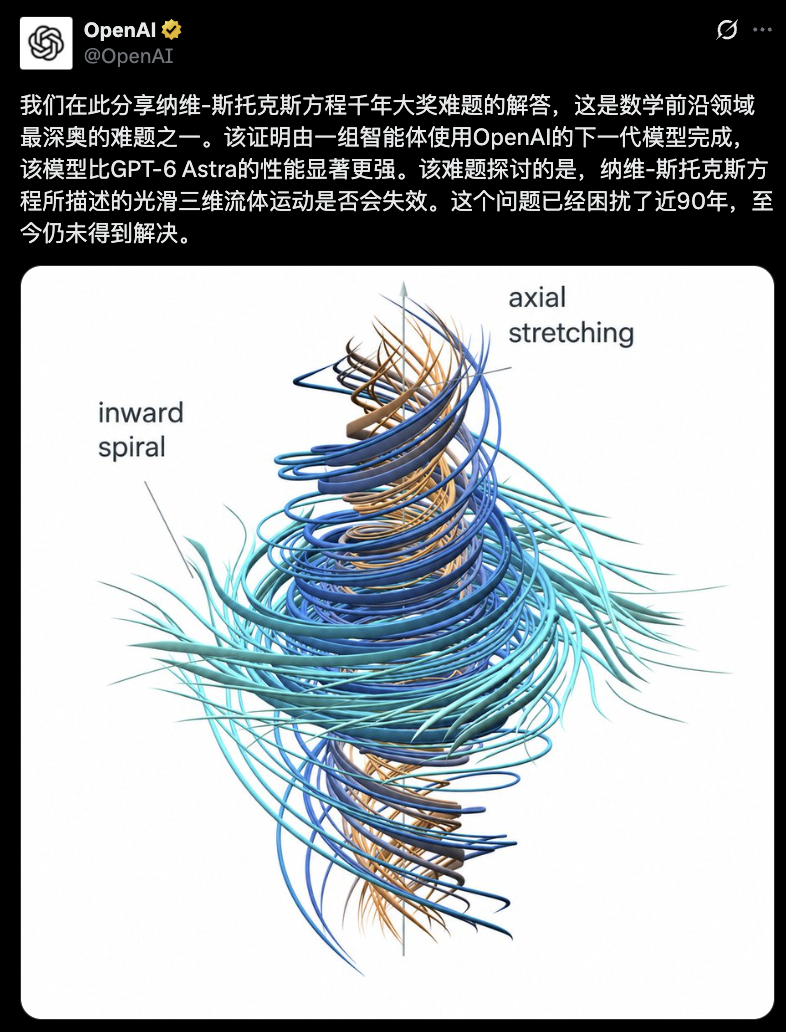
这是悬赏100万美元的七大千禧年难题之一,之前只有庞加莱猜想成功下榜。
现在,OpenAI宣布第二道也被拿下了。
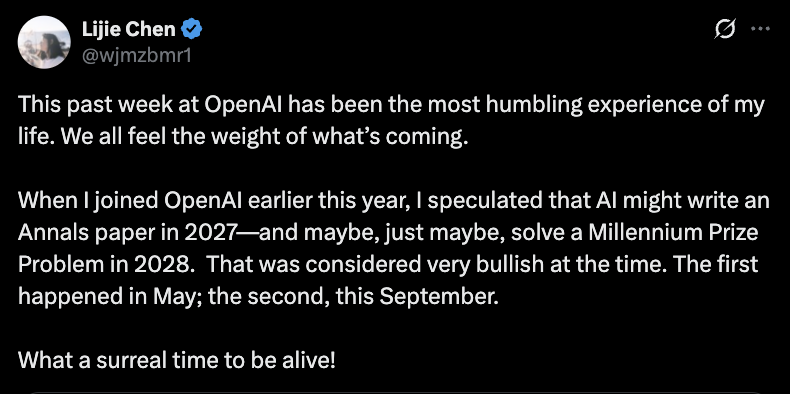
陈立杰表示今年年初加入OpenAI时他还预测AI在2028年能解决千禧年难题,没想到进度条直接被AI拽飞了——
5月破一个,9月一次破俩。
而且吧,OpenAI话里话外还剧透了下一代模型:
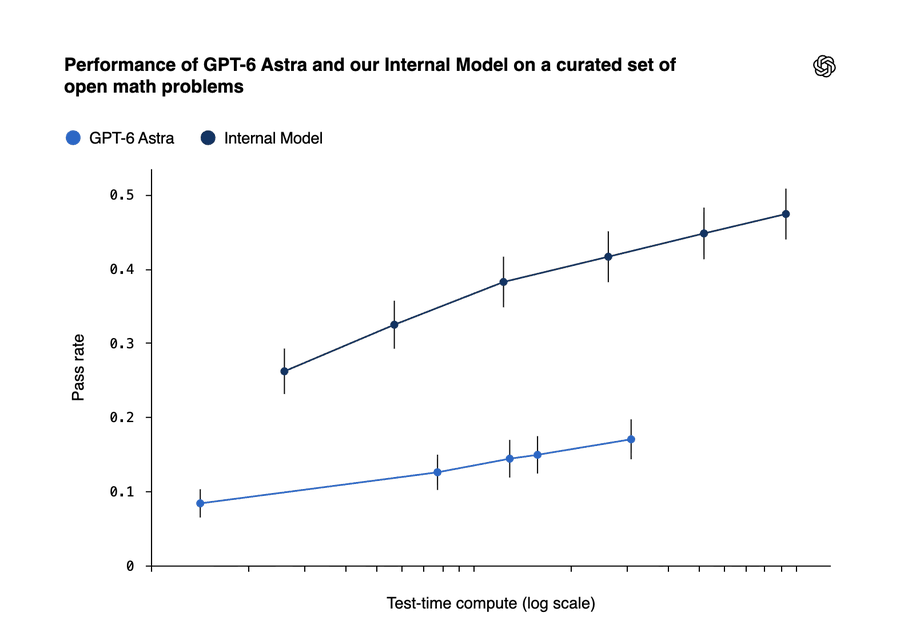
真正完成证明的不是GPT-6,是OpenAI一个仍在训练中的内部模型,能力比刚发布没几天的Astra还要更更更强。
Astra这次只能排在后面,负责检查作业。(doge)
为了做出这道题,OpenAI直接摇来约1万个Agent,并行工作88小时,发出270万条消息,消耗了约1300亿输出Token。
Agent写完证明之后,GPT-6 Astra又跑了17小时,将整份证明形式化成Lean版本,逐步检查里面有没有漏洞。
《科学美国人》上来就是一句:
这可能是数学界至少20年来最重要的一天。
话都说到这个份上了,AI数学属于是直接一脚踹开历史大门了!
然而还没等数学圈把掌声送出去,事情就开始变得不太对劲……
传闻OpenAI之所以突然出手,是因为听说外面有人快做出来了。
而那个被抢先的团队,此前一直在使用OpenAI Codex,尚未公开的草稿、证明和中间推导都放在里面。
紧接着,OpenAI还被指控想把其中一名Anthropic研究员从作者名单里拿掉。
不er,咱们刚才讨论的,真的是数学证明对吧???
1万个Agent,88小时拿下一道千禧年难题
先说说OpenAI到底证明了什么。
纳维–斯托克斯方程描述的是流体如何运动。
浴缸排水口的旋涡、飞机周围的气流、血液在血管中的流动,乃至天气系统的变化,背后都能看到它。
但数学家近百年来始终无法证明:
一个最开始平滑、正常的三维流体,在方程描述下,会不会永远保持平滑?
还是说,它可能在有限时间内突然出现“奇点”,让速度等数值冲向无穷大?
后者在数学里通常被称为有限时间爆破。
现实中的流体当然不可能跑出无限速度。如果这种奇点真的能够出现,就意味着在某些极端情况下,纳维–斯托克斯方程就无法继续作为连续介质模型描述流体。
这个问题从1934年一直悬到今天。2000年,克雷数学研究所将其列入七大千禧年难题,谁能证明它永远平滑,或者找出一个会爆破的反例,谁就能拿走100万美元。
而OpenAI这次给出的答案是:
真的会爆。
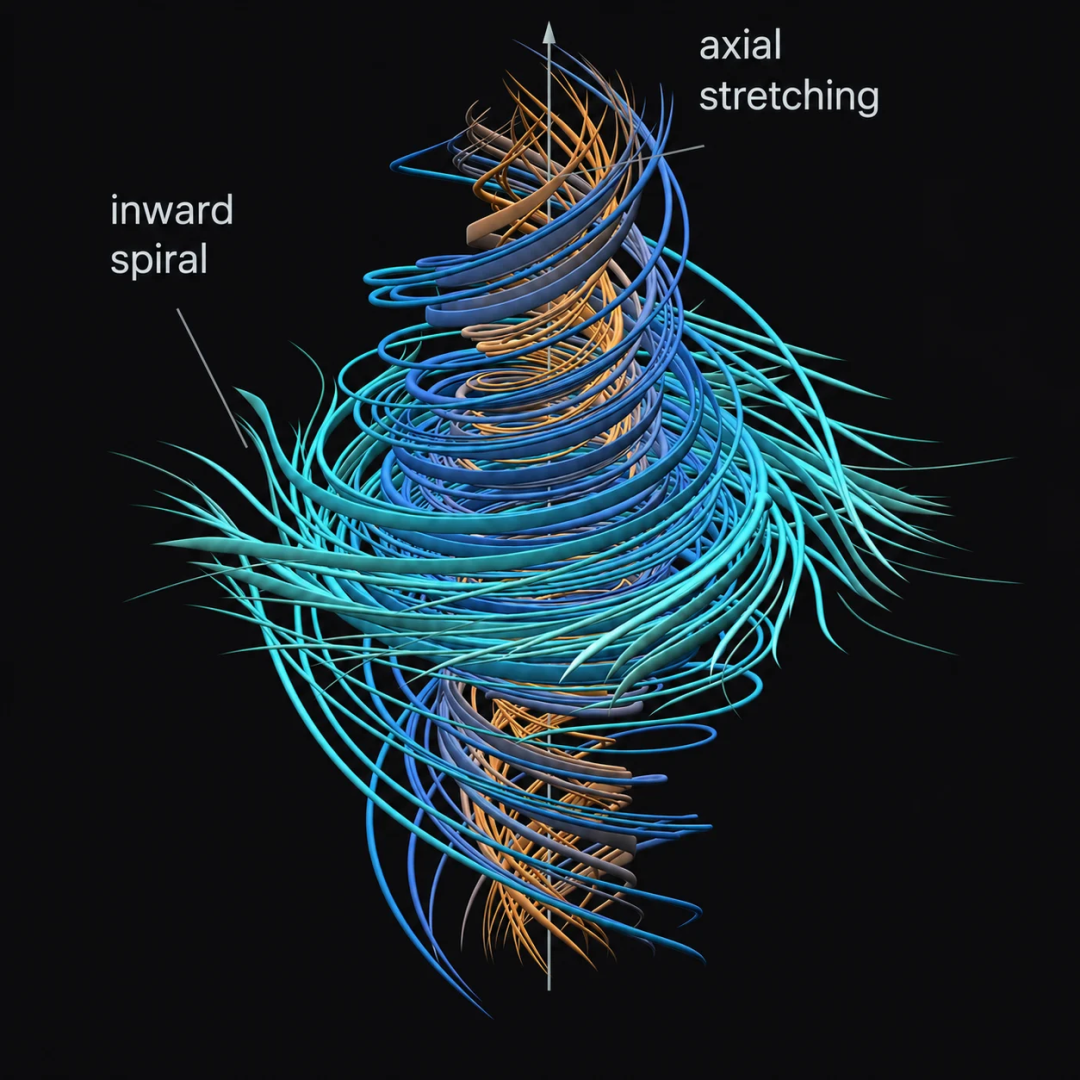
其构造了一种最初处于静止状态的平滑流体,并对它施加平滑外力。
流体内部的旋涡不断向中心收缩、拉长,像一把越拧越细的意大利面;与此同时,旋转速度持续增大,最终在有限时间内冲向无穷大。
而在整个过程中,流体的总能量依旧保持有限。
OpenAI表示,这份证明完成了克雷研究所官方题目中的C和D两种情况,纳维–斯托克斯千禧年难题就此解决。
不过,这个找答案的过程就比较有看头了。
9月1日,OpenAI听到传闻,说可能有人解决了千禧年难题。
恰好公司正在训练一个新的内部模型,在数学测试中表现出“前所未有”的能力,于是干脆把尚未解决的千禧年难题全部扔给它试了一遍。
不同Agent群组分别负责不同版本的问题,可以读取缓存的互联网资料、运行代码,并在组内交换发现。
最初,近100个Agent花费约50小时,先解决了一个相对简单的无外力欧拉方程爆破问题。
OpenAI一看这条路线有戏,立即把其他题目的Agent全部调了过来。
Agent们一边尝试不同方法,一边由Codex汇总各组的有效线索,再把中间成果重新分发,参与规模随后膨胀到约1万个Agent。
88小时之后,证明出现了。
全程总计产生490万条Agent消息和约*3000亿输出Token,其中纳维–斯托克斯一题就吃掉了1300亿Token。
OpenAI还透露,这次实验花费了数百万美元。
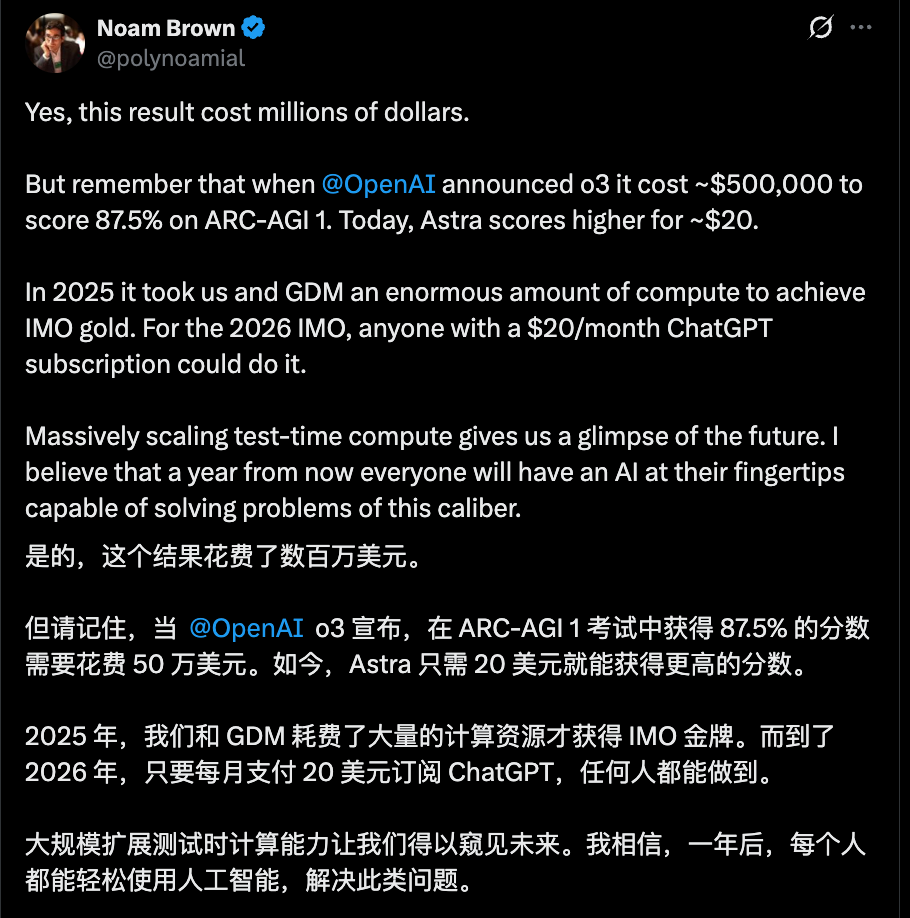
百万美元的题,用数百万美元的算力解出来……
好消息是题做出来了,坏消息是奖金好像连电费都报不了(doge)。
当然,OpenAI也明确表示不准备领取这100万美元。
但故事到这里,另外两名研究人员坐不住了。
OpenAI到底从哪里学会了这条路线?
纽约大学数学家Tristan Buckmaster和Anthropic研究员Levent Alpöge,过去一年一直在研究流体方程爆破。
他们走的,正是后来被OpenAI用于攻克纳维–斯托克斯的方向:
通过足够平滑的外力,构造有限时间爆破。
这条路线最早来自数学家Diego Córdoba和Luis Martínez-Zoroa。
两人已经沿着这个方向研究多年,只是此前得到的外力还不够平滑,距离真正完成题目仍差着关键一步。
Buckmaster和Alpöge接棒后借助Claude、Codex等模型继续往前推。
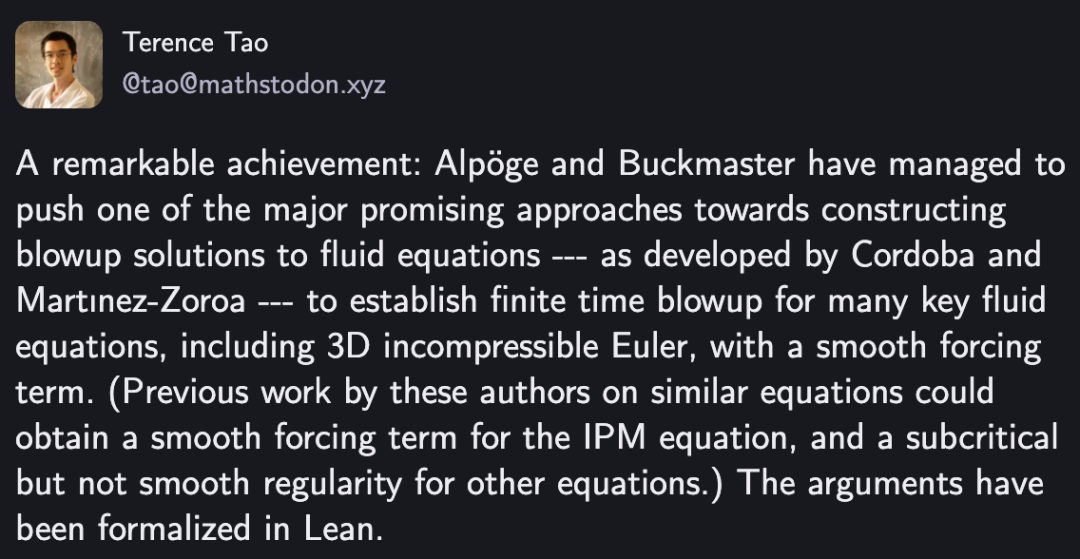
8月15日,这两位取得突破,证明三维不可压缩欧拉方程、Boussinesq方程和不可压缩多孔介质方程,在平滑外力作用下都能发生有限时间爆破。
8月22日,欧拉方程结果通过Lean验证。
陶哲轩看完之后,也给出了相当高的评价:
“一项了不起的成就。”
陶哲轩进一步判断,从这套方法继续推进到带黏性的纳维–斯托克斯方程,目前看不出有什么根本性障碍。
翻译一下就是:
Buckmaster和Alpöge虽然还没有正式拿下纳维–斯托克斯,但路已经快铺到大门口了。
两人原本计划再花几周,把证明好好整理一下再发布,主要是AI给出的原始版本,实在太难读了。。。
即使经过整理,公开版本依旧只能被称为“AI垃圾”。
所以两人当时的想法是,成果可以晚几天,至少先把论文改得像人写的。
结果硅谷显然不太讲究这种节奏,他们没等到慢慢修稿的机会。
9月初,“Anthropic解决了重大数学难题”的消息开始流传。
9月1日,OpenAI听到风声,启动Agent项目。
9月3日,Buckmaster主动联系OpenAI,解释他们尚未解决纳维–斯托克斯,并透露成果即将发布。
9月5日,OpenAI的1万个Agent完成证明。
也就是说,数学家还在修改AI草稿,OpenAI已经把1万个Agent和数百万美元算力压了上去,一脚油门冲过终点。
然后,问题来了。
Buckmaster和Alpöge在研究期间一直在使用Codex,并将论文草稿与大量推导放进了会话。
当OpenAI给出的结果恰好也是这条少有人走的“平滑外力”路线时,Buckmaster立即警觉起来,并询问OpenAI:
内部模型是否访问过他们的Codex会话,或者是否在训练中使用了这些数据?
按照Buckmaster的说法,他得到的回答是,模型没有主动检索用户数据;但当他继续追问训练数据问题时,没有得到明确回应。
OpenAI则公开否认研究人员或Agent查看过两人的工作,称直到论文公开后才接触到具体内容。
不过,它同时留下了一句非常微妙的表述:
虽然可能性很低,但无法排除两人使用OpenAI产品产生的去标识化数据曾帮助改进模型。
好家伙,没有专门翻你的论文,但不保证模型没有从你使用产品留下的数据中受益……
这下,事情彻底从数学问题变成了AI时代的学术产权问题。
AI助手用着用着,变成竞争对手了。
“把Anthropic的人从作者名单里拿掉”
接下来发生的事儿更火药味十足。
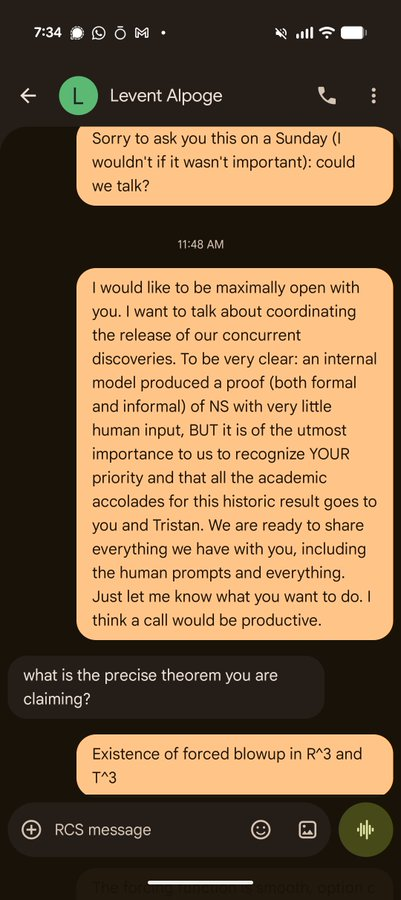
根据Buckmaster公开的四页声明,OpenAI在得知双方研究方向接近后,曾向他提出两套发布方案。
第一套:
Buckmaster和Alpöge先公开欧拉方程成果,OpenAI第二天再发布纳维–斯托克斯证明。
第二套:
由Buckmaster出面撰写论文,公布OpenAI内部模型得到的纳维–斯托克斯结果。
但Buckmaster称,OpenAI研究员Sebastien Bubeck两次表示,希望把Alpöge排除在作者名单之外。
为啥呢?
原因很简单,Alpöge就职于Anthropic。
数学成果可以谈,竞争对手的人,不太方便上桌。
Buckmaster拒绝了两种方案,并表示如果OpenAI按照这种方式发布,自己会把整个过程公开。
然后,对话开始逐渐从数学论文滑向硅谷商战片……
据Buckmaster转述,OpenAI反问Buckmaster
你为什么要毁掉自己的职业生涯?
Buckmaster人家也很纳闷,我是一个学者,把事实公开,怎么就叫毁掉职业生涯?
对方则回复:
“如果你不希望我保持友善,那我也不必友善。”
嚯,咱就是说偏微分方程没听懂,但这威胁的意思倒是挺光滑的(doge)
不过,Buckmaster也非常谨慎地划清了范围:
他没有看过OpenAI的证明,不知道内部模型具体做了什么,也不知道两人的数据是否真的被使用。
因此,他也并没有直接指控OpenAI窃取成果,只是把自己听到的话、事情发生的时间和收到的提议全部公开了。
很快,OpenAI的这位Sebastien大哥也回应了,而且按照他的版本,整件事情完全是另一个画风。
Sebastien首先表示,自己联系Alpöge,本来是想协调双方的发布时间,避免OpenAI抢发,并尽可能认可两人在欧拉方程上的成果。
“毁掉职业生涯”这句话,是说过,但没有威胁意味,也道歉了。
至于“把Anthropic的人从作者名单里拿掉”,他认为Buckmaster混淆了两份工作。
Sebastien强调,自己从未要求将Alpöge从他和Buckmaster自己的欧拉方程论文中除名。
当时讨论的是另一个方案:
由Buckmaster担任主要作者,帮助重新撰写OpenAI内部模型生成的纳维–斯托克斯证明。
正是在这个语境下,Bubeck才表示:
如果Levent不是Anthropic员工,事情会简单得多。
他的理由是,让一名Anthropic员工署名OpenAI内部模型完成的工作,这不太合适吧。
尤其两人的欧拉方程证明还使用过Anthropic内部模型。。。
所以是否认了“要求把Alpöge从研究中除名”,但不想让人家署名OpenAI的研究也是真的。
你们这个硅谷,还真是有节目。
OpenAI真把这道题解了吗?
这事儿吧,其实还有一个问题,OpenAI解决的真是大家平时理解的那道纳维–斯托克斯难题吗——
算是吧,但又不完全是。
OpenAI证明的并非是核心的问题,“没有外力时,流体自己会不会爆”。
它证明的是,在施加一个精心构造、但始终保持平滑的外力之后,流体会在有限时间内形成奇点。
从克雷研究所公布的正式题面来看,C和D两种情况确实允许存在平滑外力。
所以,只要证明最终经受住数学界检验,OpenAI确实完成了题目白纸黑字写下的要求。
这点没法硬说人家不算。
但过去几十年,数学家真正关心的核心版本,通常是无外力情况下,三维纳维–斯托克斯方程能否自己形成奇点。
于是现在的局面就有点微妙了。
按照官方题面,OpenAI可能已经通关;
但按照大家脑海里默认的终极版本,它打的又不完全是同一个Boss。
只能说,大家通常讨论的无外力纳维–斯托克斯正则性问题,还没有大结局。
但不管这场争议最后怎么收场,OpenAI展示出来的能力还是有点吓人,甚至已经开始和数学家抢时间了。
数学界那么多悬赏,还有多少会变成AI的电费呢?