文丨AI价值官 星野
生成式AI的竞争,正在从图片、短视频等平面内容,快速延伸到更具想象空间的三维世界。
过去一周,四场重磅发布接连落地,三条技术底色完全不同的路线,不约而同在同一个方向上重兵集结——可实时交互的3D空间。
9月1日,Anthropic推出新一代旗舰Claude Fable 5.1,同一天李飞飞创办的 World Labs发布新一代原生世界模型Atlas。
9月3日,OpenAI 正式发布GPT-6 Astra,智能体直接操作专业软件生成3D交互场景的能力迅速引爆开发者社区。
9月7日,彭博社援引知情人士消息称,字节跳动正基于Seedance视频模型研发实时空间视频生成模型,创始人张一鸣亲自跨部门协调资源,最快10月推出,目标直指可响应用户动作、声音的实时虚拟环境,覆盖直播、互动短剧、游戏场景,并计划适配Pico VR头显。三条技术路线正在逐渐清晰:OpenAI与Anthropic同属LLM,字节跳动Seedance代表视频模型,World Labs则是原生世界模型派,三者起点各异,路径不同,最终却指向同一个产业拐点:内容产业的形态,正在转向 “可进入、可交互的空间”。
LLM的新角色用通用智能驱动3D内容生产
OpenAI与Anthropic两家头部大模型公司,选择了相似的技术路径:依靠大语言模型的通用推理、任务规划与工具调用能力,切入虚拟内容的生产管线,把AI能力直接嵌入创作者沿用多年的专业软件体系,最终产出可编辑、可交互的3D场景。
这条路线上,GPT-6 Astra的表现最受瞩目。OpenAI将其定位为新一代通用智能体模型,能力覆盖计算机操作、编程、网络安全与科学研究,其中就包括对Blender、Unreal Engine等三维创作软件的完整操作权限。
在官方演示里,Astra能独立走完从概念到交付的全链路:给出一段文字描述后,模型先在Blender里完成建筑建模、材质贴图与光影渲染,再自动编写导出脚本,把成品导入Unreal Engine 5,生成一个可以自由漫游的交互场景,期间不需要人工分步介入。
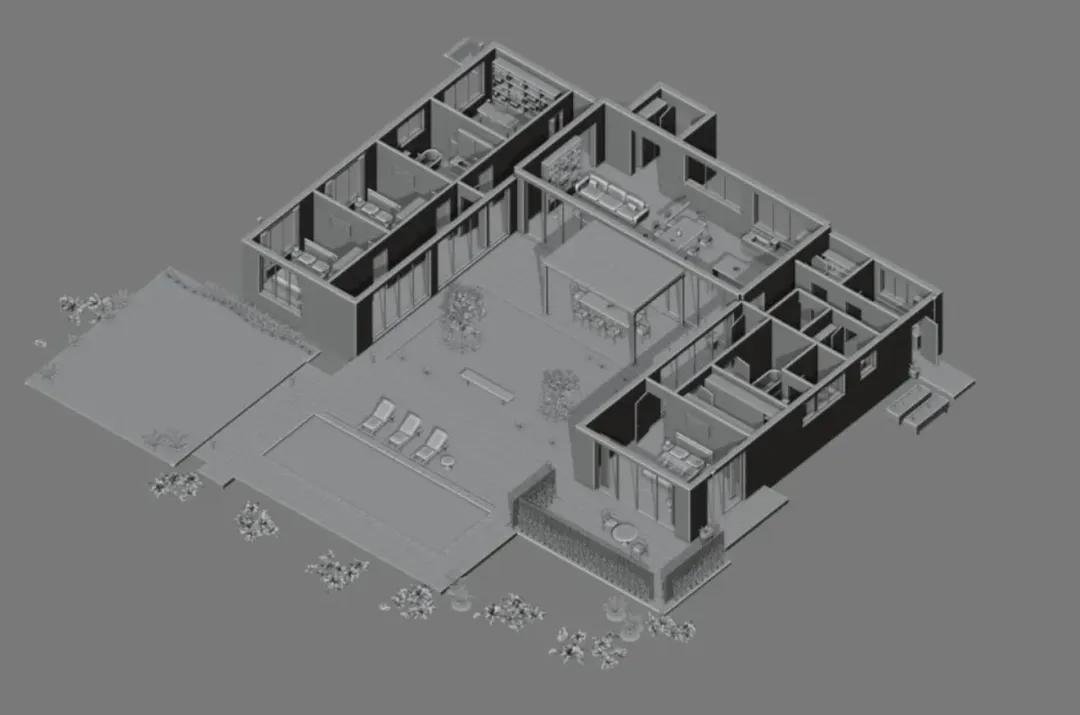
Astra开放测试后,开发者社区很快涌现出大量实测案例。有人只给一张房屋照片,就能在Blender里还原出完整的室内空间,家具、电器等细节一应俱全,重建结果能以接近游戏的帧率在本地运行;也有人在虚幻引擎里逐街区搭建出可以自由漫游的城区场景,精细到每条街道;分钟级生成的城市白模、二十多分钟内搭出的城市漫游demo、当天成型的第一人称射击地图,也都在社区里流传开来。
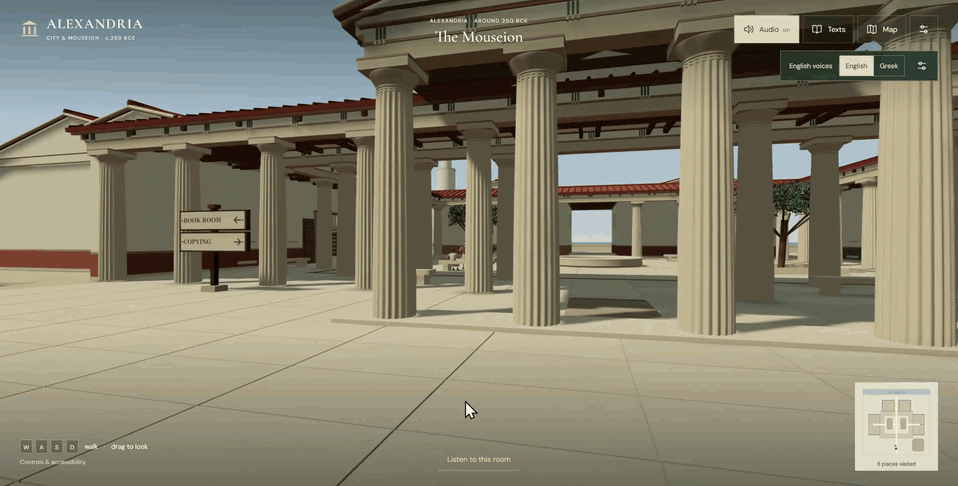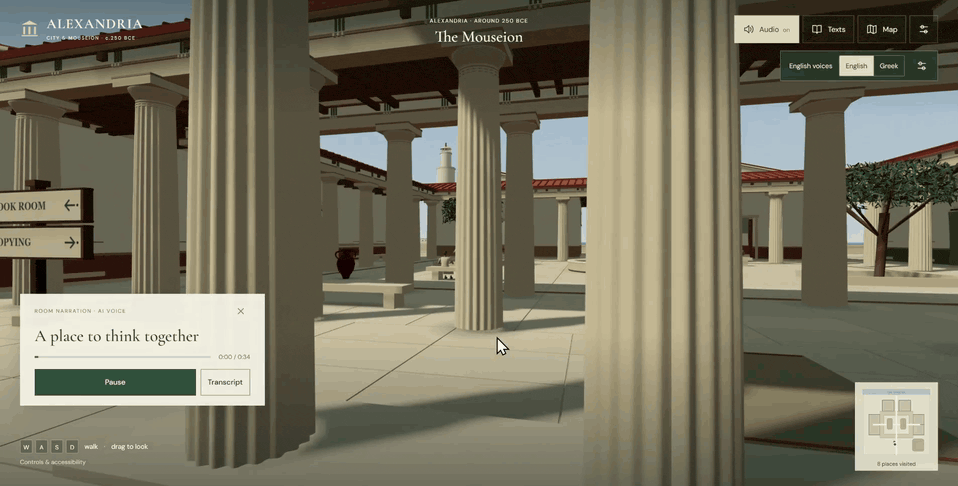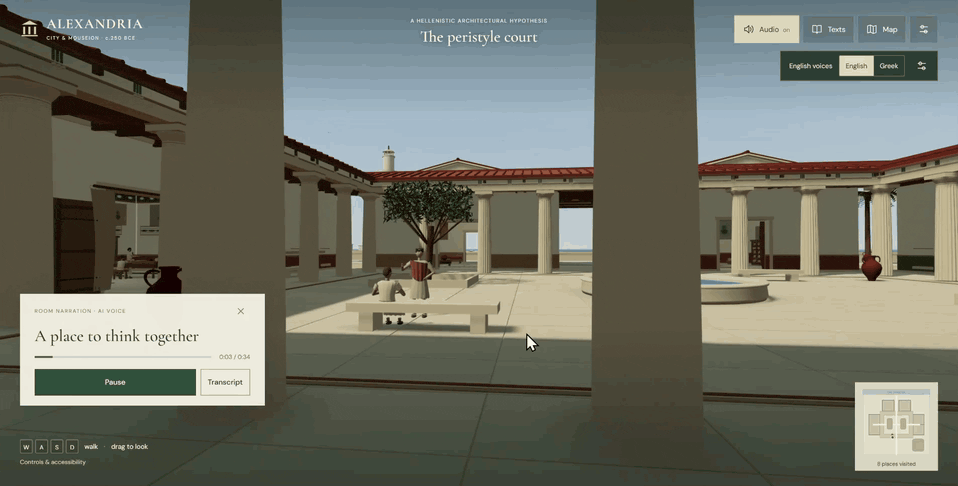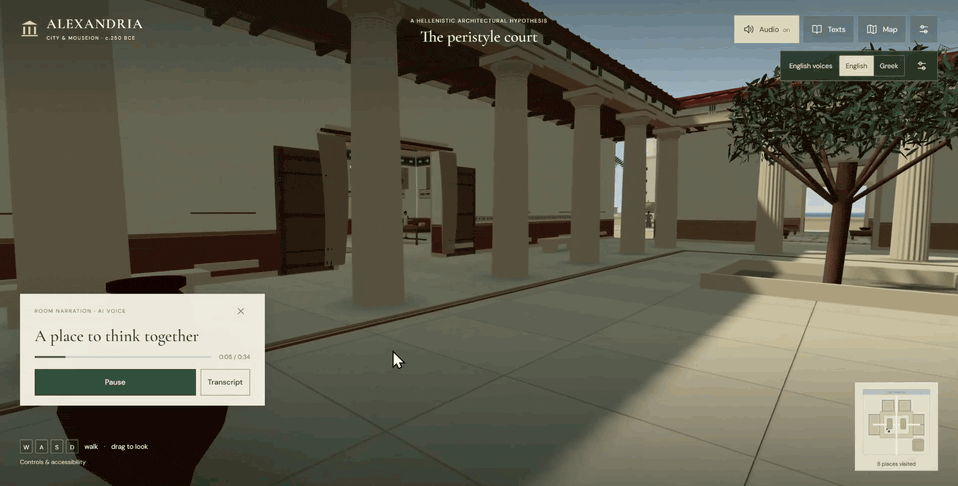
游戏开发是反馈最集中的领域之一:有游戏工作室做过对照测试,让Astra从同一个灰模基础出发一次产出三款可玩原型,人工修复的工作量比传统流程减少了约一半;社区里同时也出现了多个经典游戏的复刻案例。
这些案例背后是Astra的Computer Use能力:它不依赖专属API或定制连接器,而是靠多模态视觉识别界面、模拟键鼠操作直接驱动软件,理论上人能在图形界面里完成的工作,它都能逐步学会——最终产出的还是可编辑的工程文件,能直接接入现有生产流程。
同样依托大语言模型的通用能力,Anthropic早在半年前就布局了MCP连接器生态,把Claude接入Blender、Adobe Creative Cloud等九款专业创作软件,通过Python API直接读写场景数据、批量处理素材。
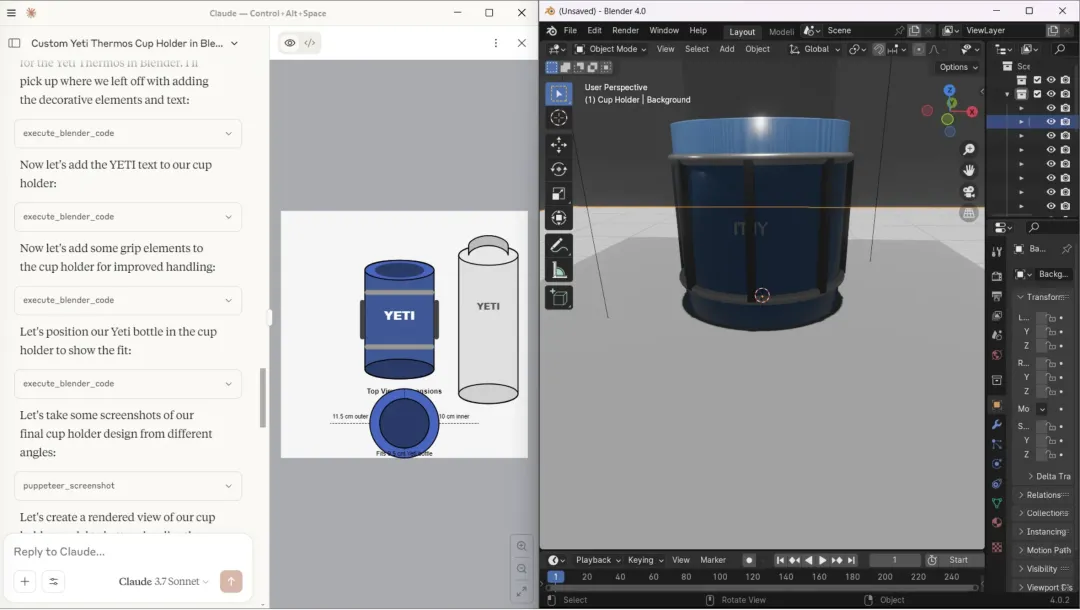
与OpenAI需要通过Computer Use模拟键鼠操作不同,Anthropic的MCP方案直接嵌入了工具的内核,让Claude能更流畅地与专业软件协同。
Fable 5.1发布后,社区里同样跑出了大量3D游戏、场景建模的实测案例,模型能独立完成从素材检索到成品输出的全流程。两家公司的思路高度一致:以LLM为核心,把智能体能力嵌进已经沉淀几十年的工业软件管线里,服务于专业创作者的既有流程,最终产出符合工业标准的可交互三维内容。凭借通用智能体调度全流程的能力,它们天然占据着3D内容生产链路的上游位置。
视频模型走向上游从可视化内容到可交互空间
GPT-6 Astra发布没几天,开发者社区就跑出了一整套影视级工作流。开发者Higgsfield做了一次测试:只给Astra一句总指,在Blender里完成预演,再调用Seedance 2.5生成镜头,最后剪辑成片,全程保持角色与场景一致。
Astra接到任务后,先从零写出完整故事脚本,随后打开Blender,搭出一条日式街巷的简化3D白模,把两个角色放进场景,规划好不同镜头下的站位与走位,完成影视前期预演(Previs)。预演做完,Astra再敲定每个镜头的机位与运镜轨迹,导出对应参考帧,把角色形象、场景画面和动作参考一并交给Seedance 2.5去渲染成片。
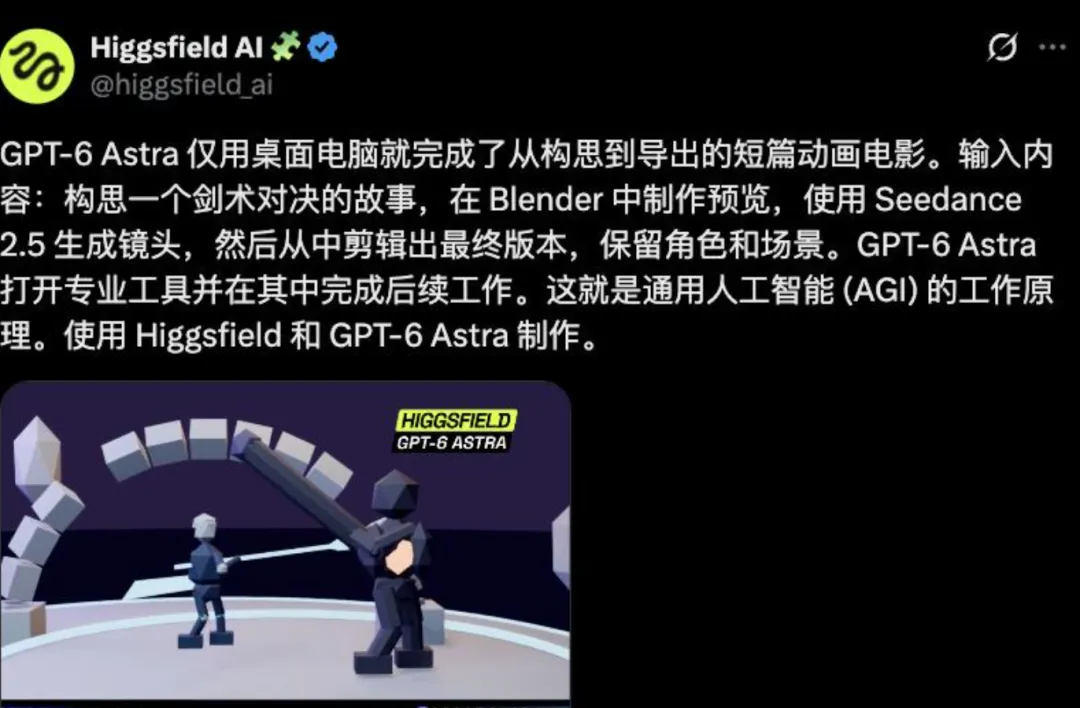
这套组合玩法在社区刷屏的同时,也预示了一种行业趋势:如果视频模型只停留在画面渲染这一环,未来可能就会成为LLM的下游——创意、分镜、流程调度都由上游的大语言模型说了算。某种意义上,GPT-6的全流程能力越强,纯视频模型的位置就越被动。
这正是字节推动Seedance向上延伸的核心逻辑:不甘心只做视频生成器,而是要往空间理解、实时交互的上游走,直接产出可交互的虚拟空间,从“生成内容的工具”变成“承载体验的平台”。
彭博社9月7日独家报道称,字节跳动正在开发一款实时空间视频生成模型,项目由创始人张一鸣亲自跨部门协调,调集模型研发、云基础设施、Pico硬件与内容业务线的资源,算力优先保障,最快于10月推出。
和市面上已有的模型不同,这款产品瞄准的不是预先生成好的视频,而是能随用户声音、动作实时变化的虚拟环境:用户向前走,视角就同步推进;转过头,四周的场景依然连贯。应用场景直接指向直播、互动短剧和游戏,并计划适配字节旗下的Pico系列VR头显。
技术路径上,项目以字节已经成熟的Seedance视频生成能力为基础,把大量空间渲染计算放在云端完成,再把画面串流到终端设备,借此压低头显的硬件门槛。据报道援引的测试数据,模型可以按需生成每秒20帧的视频,端到端延迟约50毫秒。
这个数据在实时交互的语境中意义重大——50毫秒的延迟已经接近人类感知阈值,足以支撑流畅的沉浸式体验,而20帧/秒的生成速度则意味着云端渲染与流媒体传输的协同已经达到了可用的工程水准。
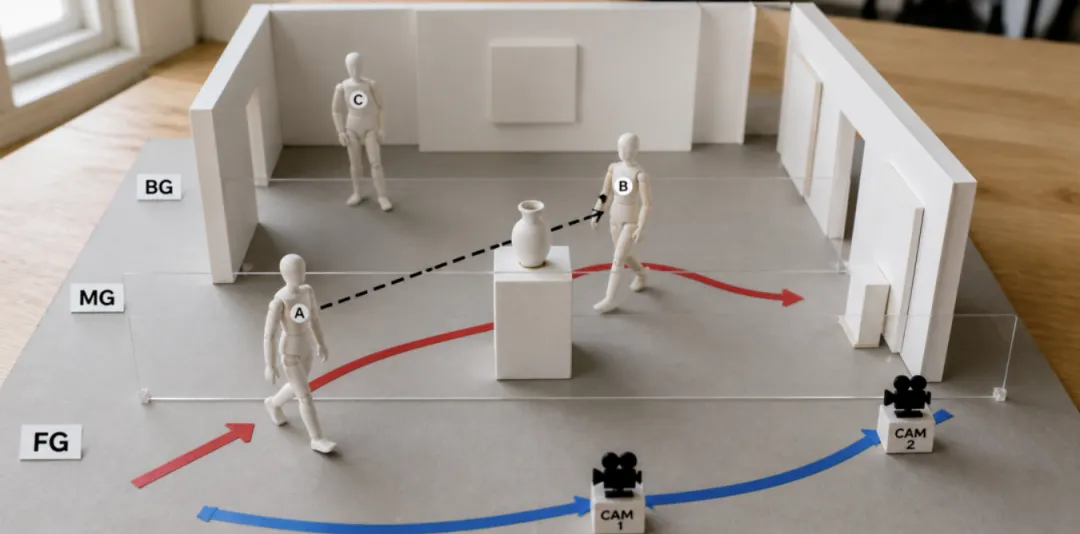
这条向上延伸的路线,其实早就埋下过伏笔。7月底发布的Seedance 2.5已经加入了Clay Render白模参考能力,支持基于3D白模生成贴合空间结构的画面,配套的Blender插件也在创作者群体中被广泛使用。
这次的实时空间模型,相当于把Seedance的能力往前推了一步,变成“实时生成可交互空间”,彻底脱离纯渲染工具的定位,转向承载体验的平台。
把这条路线放到LLM智能体派旁边看,差异会更清楚:一个面向生产端,一个面向消费端。OpenAI、Anthropic做的是替代人工操作软件,产出符合工业标准的工程文件,服务专业创作者的生产流程。字节的空间模型直接产出可观看、可交互的体验,服务直播、短剧、游戏这类大众内容场景,离终端用户更近,还能倚仗抖音/TikTok的内容生态、即梦/小云雀等创作者工具和Pico的硬件终端,形成从生成到分发的完整闭环。
原生世界模型进击从底层重构空间理解
和前两家沿着现有工具链、内容链往外延伸不同,李飞飞联合创立的World Labs选了一条更原生的路:从零训练一个理解三维空间的世界模型,在底层表征层面就做出空间一致性,直接产出可以自由探索的三维虚拟世界。
9 月 1 日,World Labs正式发布新一代原生世界模型Atlas。这是一套从零预训练的原生多模态模型,可统一处理文本、图像、视频和相机位姿信息。所有输入都会被锚定在同一套三维空间坐标系中构建共享空间上下文,全程保持三维空间逻辑一致。
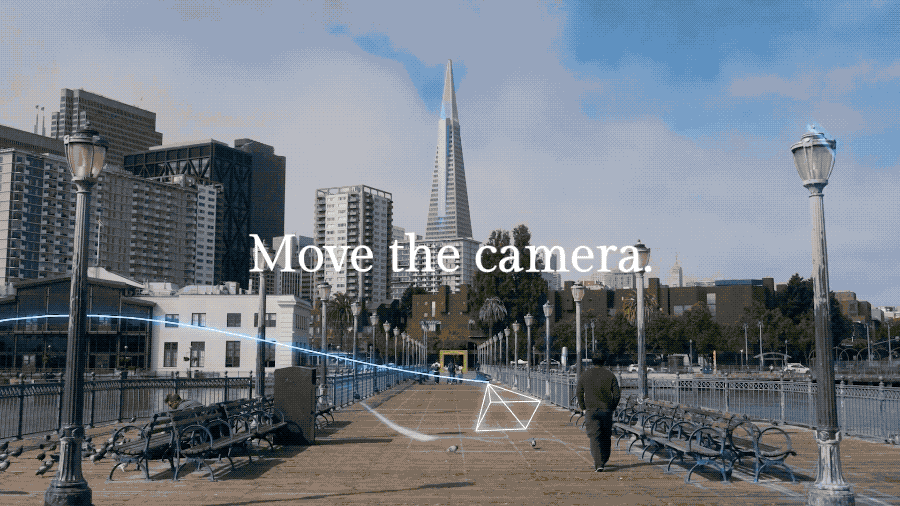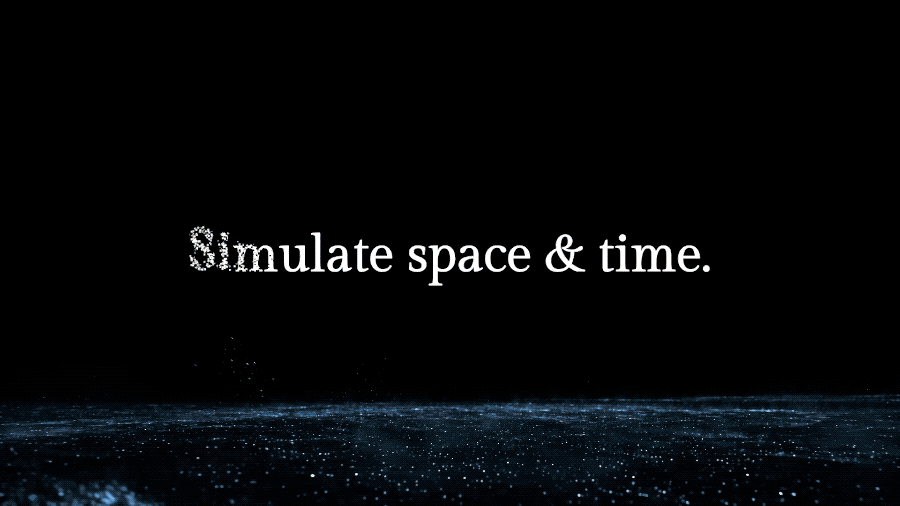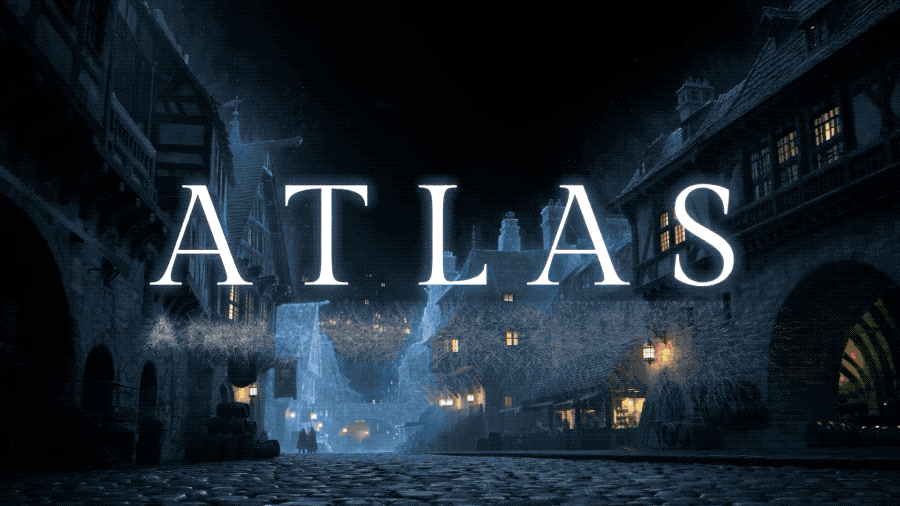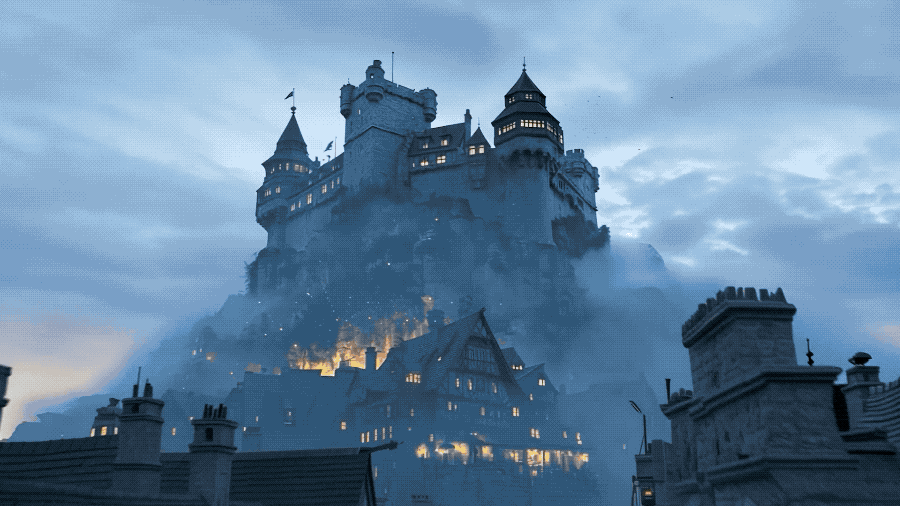
其核心能力聚焦于空间重建与相机可控生成:仅需少量参考图片即可还原真实三维场景、输出新视角画面;也可按指定的精确机位与运镜轨迹生成视频,镜头控制达像素级精度。
和前两条路线产出工程文件或渲染画面不同,Atlas的核心特质是原生的空间一致性。它在意的不只是单帧画面好不好看,而是视角变了之后,物体位置、光影逻辑还连不连贯。这种能力让它天然适合需要空间一致性的场景,官方给出的落地方向包括影视内容制作、游戏关卡原型、数字孪生、机器人仿真训练四大领域。
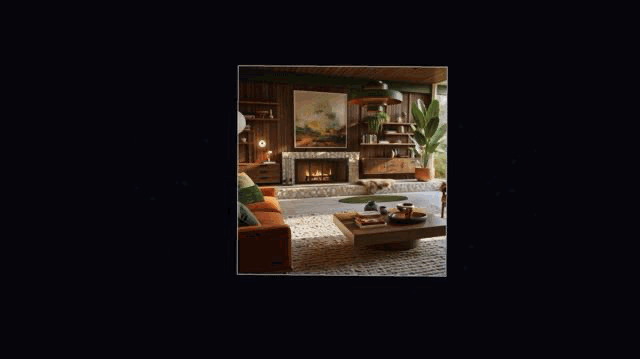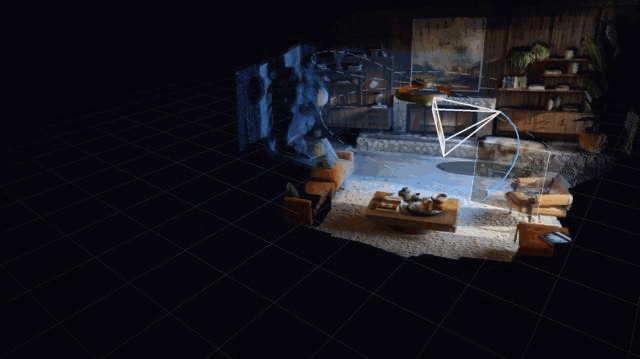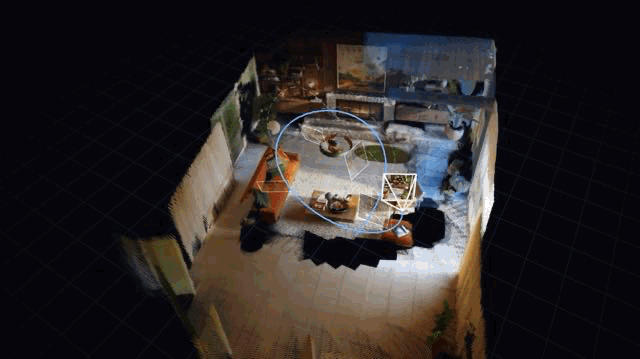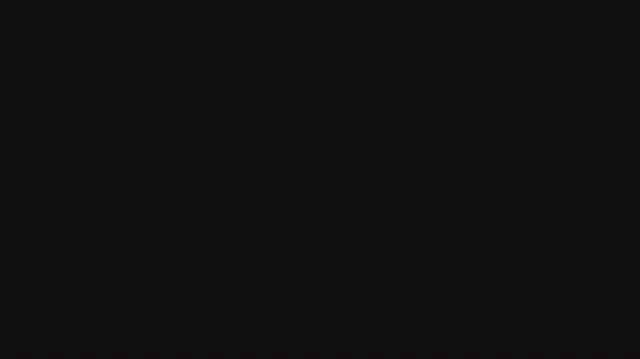
Atlas发布后,最先在影视和游戏从业者圈子里引发讨论。影视行业关心的是虚拟制片与场景重建:传统影视做三维场景重建、子弹时间特效,往往要多机位同步拍摄或激光雷达扫描,成本高、周期长,Atlas只用几张随手拍的照片,就能重建出完整三维空间,补全镜头没拍到的区域,还能按任意路径生成运镜画面。
有影视从业者在社区里表示,这对前期勘景、场景预演、虚拟制片环节的效率提升会很明显,但目前还主要停留在视觉层面的空间重建,离进入成熟的工业制作管线仍有距离。
游戏行业的讨论则更多落在场景产能上。不少游戏开发者认为,Atlas最适合用来快速生成关卡背景、环境白模与概念场景,拿来验证空间布局与动线设计,再导入Unity、UE等引擎补全交互逻辑与细节。虽然Atlas生成的场景还不具备完整的物理属性与结构化资产,无法直接替代专业团队的成品制作,但作为前期创意与原型阶段的效率工具,它已经能够显著降低原型验证的成本。
三线并行3D空间模型的产业分野
梳理三条路线的技术路径与落地进展不难发现,虽然各方都在向可交互三维空间这个方向集结,但彼此的技术底色、能力禀赋与产业定位截然不同,在核心优势、落地场景与成熟节奏上呈现出清晰的分野。
能力上,三条路线的强项并不重合。LLM的核心能力是全流程调度,从创意构思到软件操作、再到工程文件产出,OpenAI和Anthropic都能把整条生产链条走完。在BenchCAD三维重建评测中达到95.9%的几何重合度、在OSWorld 2.0通用计算机操作基准上拿到72.6%的成绩,这些数据证明了这条能力线在持续变强。
视频模型的核心能力是渲染与实时性。字节的优势在于把成熟的Seedance视频生成能力,压缩进20帧每秒、50毫秒延迟这样的实时交互指标里,这是LLM智能体和原生世界模型目前都还没有主打的方向。
原生世界模型派的核心能力是空间一致性:Atlas从底层表征上保证视角变化后画面的连贯,这是单纯靠“调用软件”或“渲染画面”很难天然获得的能力。
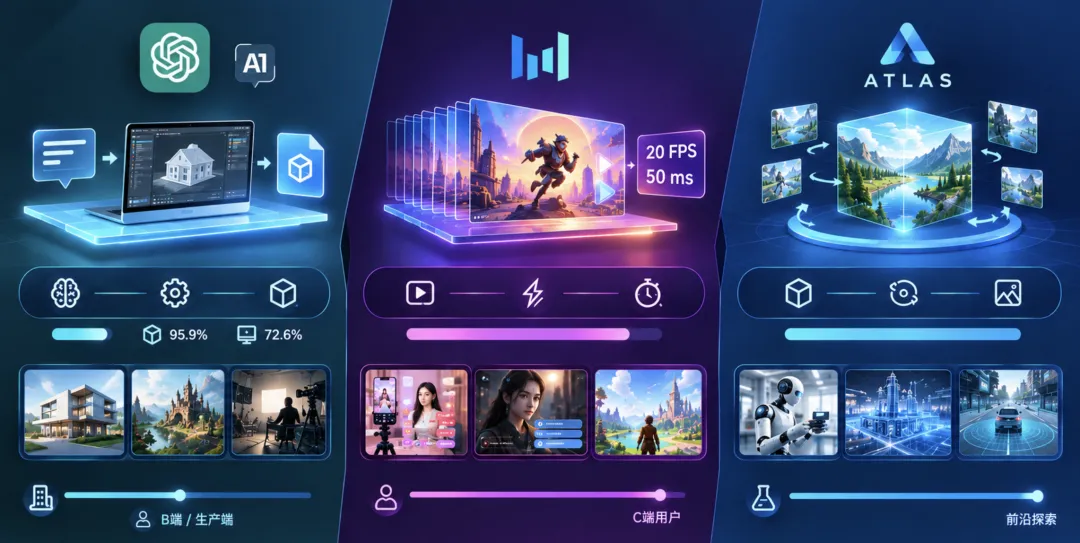
场景上,三条路线离用户的距离也各不相同。LLM智能体派更贴近专业创作者的生产环节:建筑可视化、游戏关卡原型、影视预演,服务的是B端、生产端的效率提升;视频模型更贴近大众消费场景:直播、互动短剧、游戏,字节还能借助内容平台与工具,形成从生成到分发的完整闭环,离C端用户最近;原生世界模型派目前更偏向前沿探索:机器人仿真、工业数字孪生这类需要长期投入的领域,落地周期相对更长。
从目前的能力来看,三条路线都远未走到终点,存在着巨大的提升空间。LLM智能体派的通用前端界面审美判断力仍是公认的短板,长任务的操作精度和稳定性也在持续打磨;字节的实时空间模型仍处于开发阶段,方案细节和上线时间都有变数;原生世界模型派生成的场景离3A游戏、高端影视的工业标准,以及机器人仿真的精度要求,仍有距离。
从文字到图片,再到视频,大模型每一次跃迁,做的都是同一件事:降低内容生产的门槛,拓展内容产业的边界。这一次,它们把目标对准了更复杂、更有价值的虚拟内容——从被动观看的视频,走向可进入、可交互的三维空间。
当然,这个过程并非一蹴而就。工业标准、成本控制、生态协同等现实因素,仍需时间打磨。三条路线目前还谈不上谁会胜出,更可能的情况是,它们会在不同的生产环节和场景里各自找到位置——过程中既相互借力,也相互竞争。短期内,三条路线会各占山头;但长期的融合与竞争格局,仍待观察。