机器人前瞻(公众号:robot_pro)
作者 | 钟宸
编辑 | 漠影
机器人前瞻9月18日报道,今天,Figure发布了新模型Helix 2.5,这是其迄今为止构建的最先进的神经网络模型。
Figure将这一模型带到了30个真实的家庭环境中,并表示模型帮助机器人实现了零样本的全身自主行为(Zero-shot whole-body autonomy),这是在这种规模上,首次实现了人形机器人零样本全身行为泛化能力的演示。
同时,Figure将单一的预训练基础模型应用于三种不同的行为:移动、刚性及可变形物体的操控、双手协调运动,以及主动感知能力。
Figure还透露,只要保持任务特定数据(task-specific data)、架构、训练方法和评估方式不变,仅通过Index(Figure面向全球规模构建的机器人数据集项目)预训练就能将零样本识别的成功率从9%提高到56%,且该模型也验证了人机转换的Scaling Law(A Human-to-Humanoid Robot Transfer Scaling Law)。
另外,在Helix 2.5中,所需的任务特定数据仅为Helix 02的一半。
一、展示四小时实机视频,可整理房间、铺床和叠毛巾
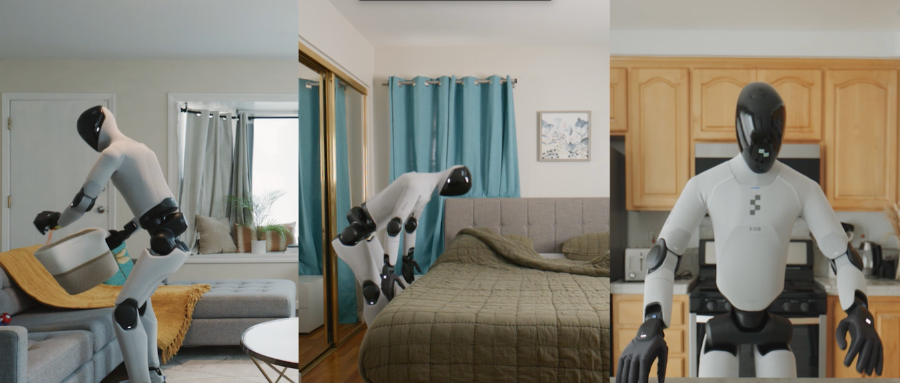
Figure在X上展示了约四个小时的视频,包含Helix-2.5在真实家庭完成整理房间、铺床、叠毛巾的长程任务演示,无需在任何环境或操控物体的过程中进行数据收集、微调或适应处理(collection,fine-tuning,or adaptation)。
Figure表示,这是首次在这一规模上,实现人形机器人零样本全身行为泛化能力的演示。
Figure放出的演示视频中,Helix 2.5的表现较为惊艳。工作人员故意把物品扔得满屋都是,机器人便在整个屋子里来回搜寻,一件一件捡起来,放进人类递来的篮子,最后还不忘记把篮子放到客厅角落里。整个流程耗时约一分半。
真正令人眼前一亮的是一个细节:捡最后一件物品时,机器人第一次抓取失败了,但它没有停下求助,而是换了个角度重新尝试。
Helix-2.5先是摆正枕头,再将被子铺平,甚至还记得把床沿处垂下来的被角也掖好整理。一套动作下来,比人类还要细心一点。
叠毛巾任务中,面对四条毛巾,Helix 2.5都是先摊开、再对折,过程中还不断调整铺平,动作几乎没出过错,只是四条毛巾叠完足足花了五分多钟,精准有余,速度尚待打磨。
另外,据Figure透露,该模型拥有从错误中恢复的能力。
当面临诸如未捡起物体、拿起被子失败的错误时,机器人会后退一步,重新定位自己,然后围绕环境移动,以纠正错误并完成那些需要长期规划的任务。
二、承诺投入超200亿算力,Index预训练产生泛化能力
Figure指出,在训练过程中,模型必须利用已有的知识来解决整个感知与控制问题。在复杂的任务中实现自主行为,即使在熟悉的环境中也极为罕见。该公司称,Helix 2.5是第一个能够在家中、且面对从未接触过的物体时实现这一能力的模型。
Figure还想要弄清楚,Helix 2.5的零样本泛化能力究竟是来自于Index预训练,还是来自于具体的任务数据本身?
于是,Figure在相同的任务特定数据上训练了两种策略,这些数据中并不包含任何评估样本或对象信息。
其中一个策略以随机权重初始化,另一个则基于Index预训练的Helix 2.5模型进行初始化。
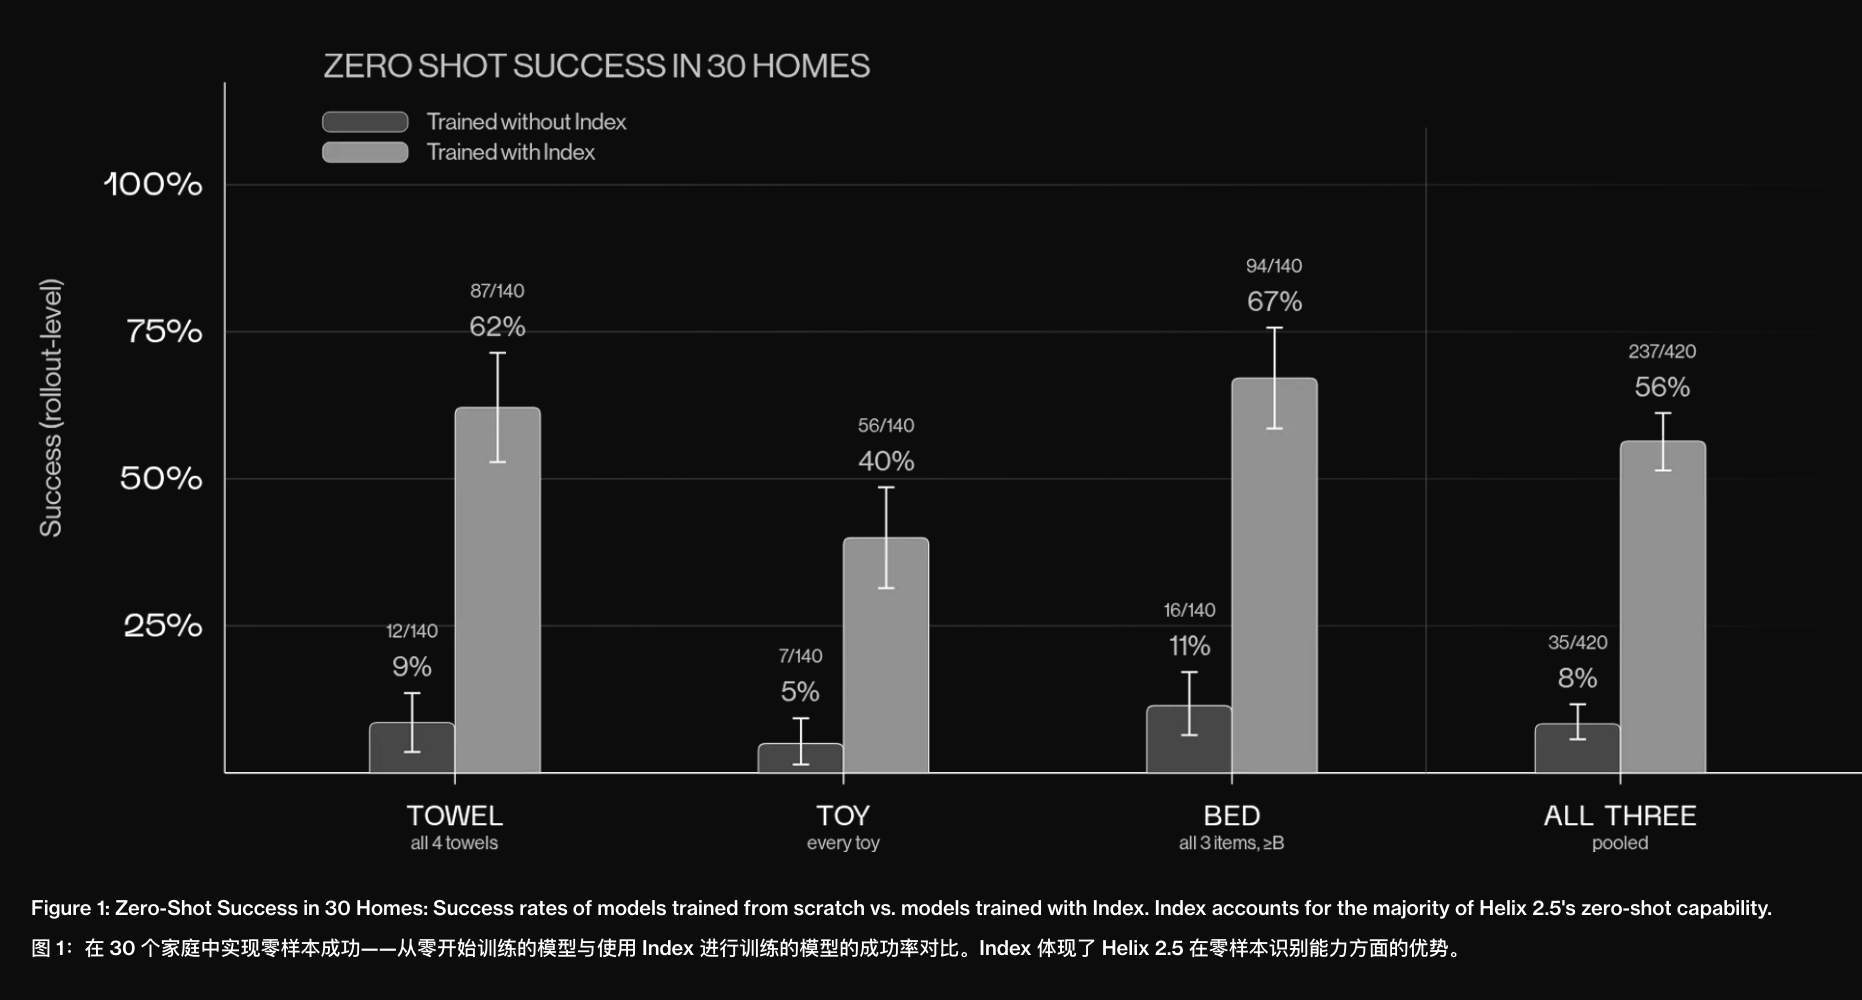
Figure发现,Index预训练是Helix 2.5零样本能力实现的一大因素。在盲测中,从零开始训练的策略在测试中的成功率为9%,而采用Index预训练的策略则取得了 56%的成功率。
Figure还将Helix 2.5与Helix 02进行了比较。Helix 02是通过在评估后的环境中直接收集的数据进行训练的。Helix 2.5在使用的数据量仅为Helix 02的一半的情况下,仍然取得了与Helix 02相当的成功率。
另外,Figure还验证了人机转换的Scaling Law。
该公司在扩展了8倍预训练数据的Index数据集上训练了四个模型,同时保持模型规模不变,也不对下游训练方式进行更改。这些模型都在相同的任务数据上进行微调,并且以相同的动作预测损失(held-out action-prediction loss)作为评估标准。
而随着数据的增加,损失也会相应减少。Figure指出,这是首次在人形机器人身上观察到这种Scaling Law,即Index预训练规模扩大,可以改善后续机器人行为的预测效果。
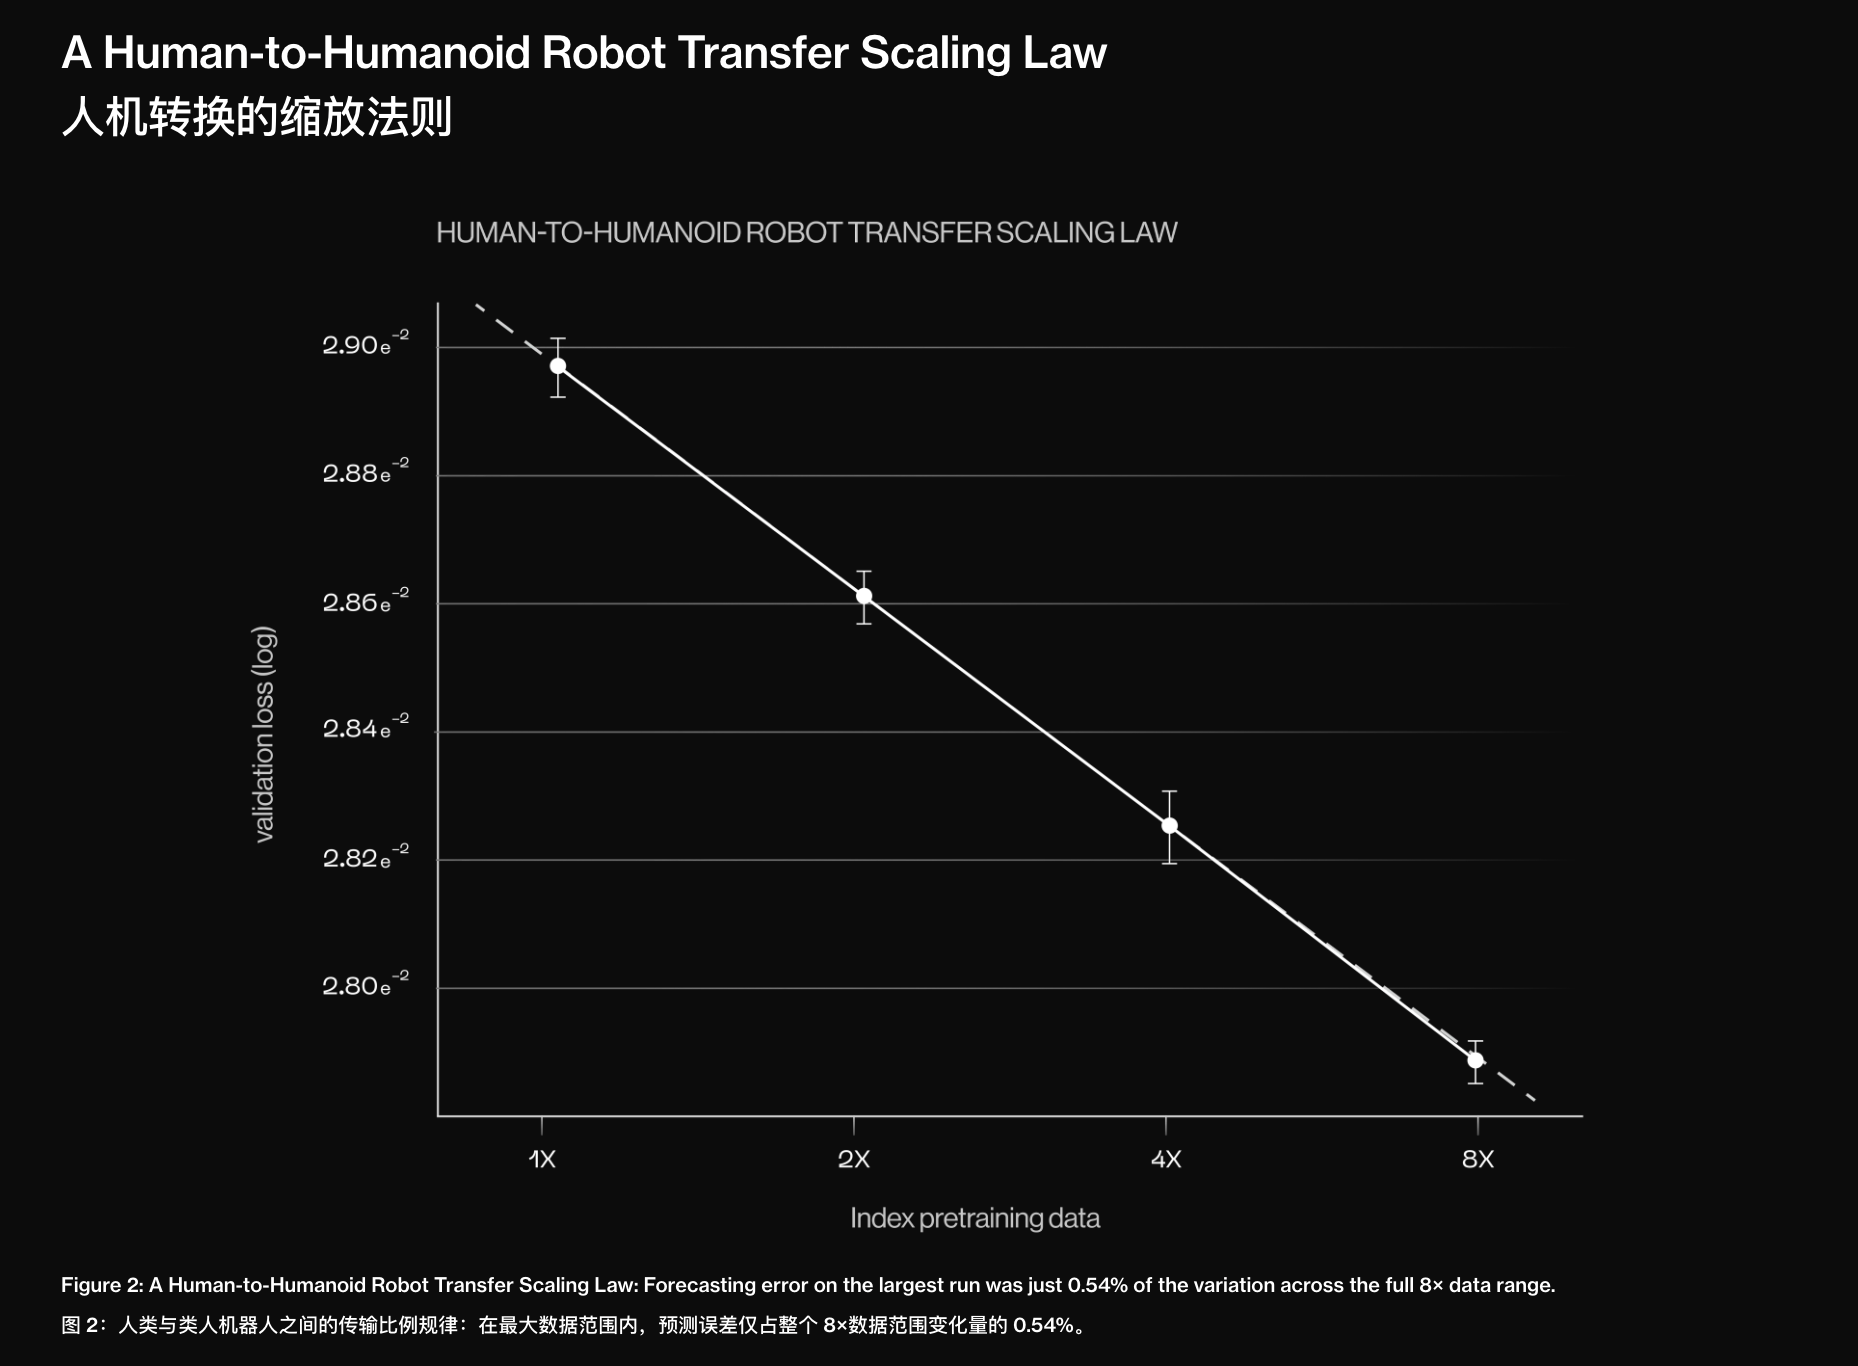
同时,Figure透露,两者的关系相关性足够准确,还可以进行预测。仅通过较小的样本,Figure就能在训练开始之前,将最大值的测试误差预测到四位小数的精度,在数据范围扩大的过程中,预测误差仅为0.54%。
目前,Figure称,Index每秒大约能生成35分钟的新人类经验数据。为了训练Helix模型,其已承诺投入35亿美元(约合234.43亿元人民币)的算力资源。
结语:高额投入,砸出一条Scaling Law
在X(原推特)上,部分网友对这一成果表示认可,还希望能够尽快用上这个机器人。
但也有人表示,需要观察这个模型能不能完成更多的任务。
但不可否认的是,Figure用真实任务证明,Index预训练能将零样本成功率从9%拉到56%,且扩大预训练数据可持续改善下游行为预测,这一定程度上证明,具身智能的数据飞轮开始具备可预测、可扩展的工程范式。
当然,超两百亿的承诺算力投入又提醒着所有人,这条路的门槛极高。但当机器人能用一半的任务数据达到同等效果,具身模型的路线图已愈发清晰。接下来的悬念是:谁能以更低成本,跑通这条Scaling Law曲线?
技术博客:https://www.figure.ai/news/helix-2-5-zero-shot-30-home-generalization
X链接:https://x.com/Figure_robot/status/2100657350952779925