在现代数据中心芯片中,供电已成为制约性能扩展的关键瓶颈。人工智能(AI)和高性能计算(HPC)工作负载的激增,使得供电网络(PDN:power delivery network)面临着远超传统方案设计能力的严峻挑战。随着电流水平的提升,PDN 中的电阻损耗和电压降(voltage droop)效应加剧,仅靠渐进式的改进已无法满足需求。堆叠裸片(stacked-die)多芯片架构进一步加剧了这一问题,因为它导致了有效电流密度增加、布线拥塞以及可靠性挑战。
日前,英特尔发布了一个白皮书,探讨了从加速器、机架到数据中心各个层级的供电挑战,重点分析了扩展趋势如何重塑整个系统层级的供电需求。本文并不主张采用单一的“最优”供电解决方案。相反,它概述了一系列技术途径,资深架构师和技术专家可根据系统需求及架构权衡考量,有选择地应用这些方案。
芯片的供电挑战
芯片、服务器和数据中心领域的设计趋势正将供电能力推向物理极限。随着计算密度的提升,要保持稳健的电源完整性(PI),必须对整个供电网络(PDN)进行优化,涵盖从电路板、封装到芯片的各个层面。
加速器封装设计趋势
现代加速器封装将前所未有的计算、存储和互连资源集成于单一封装内,以满足人工智能(AI)和高性能计算(HPC)工作负载对性能及带宽的需求。
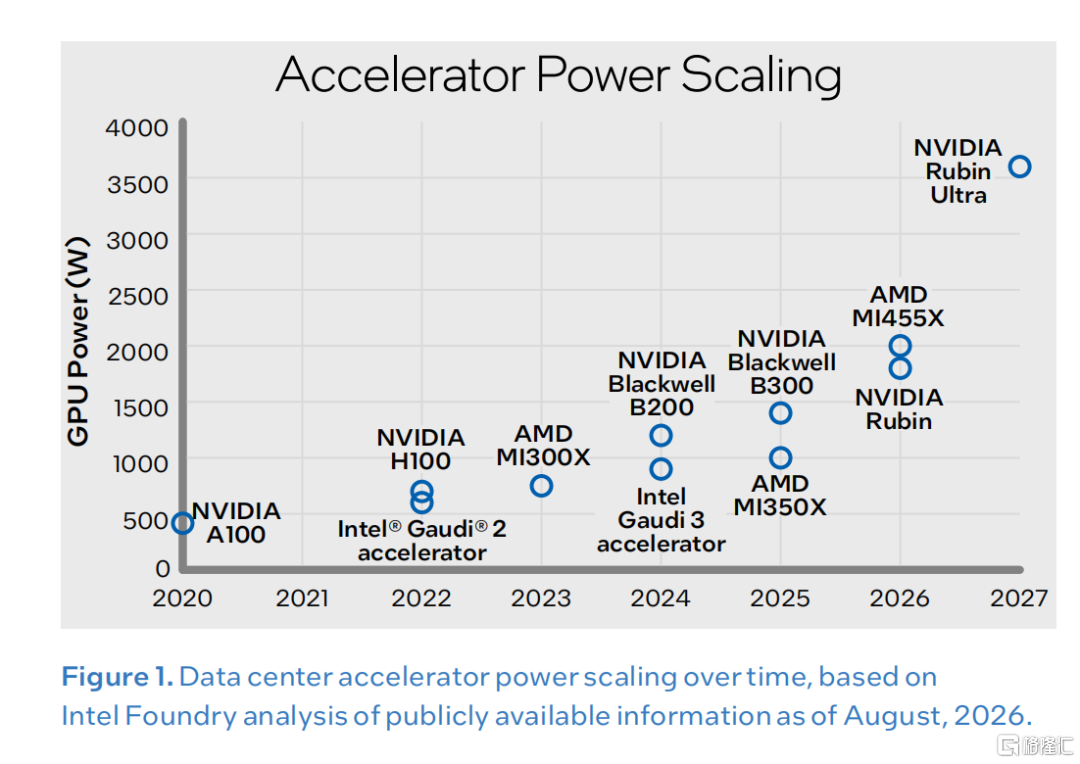
AI加速器通常在低供电电压下运行,需要大电流来提供高功率(见图1)。因此,现代集成水平要求封装级电流达到数千安培(kA)量级。这些趋势带来了两大根本性的供电挑战。
首先,封装必须在有限的占位面积内输送巨大功率,而该区域已被计算芯片、高带宽内存(HBM)堆栈、高速互连和散热基础设施所占据。其次,供电过程必须高效,同时最大限度地减少配电网络(PDN)中的静态和动态损耗。
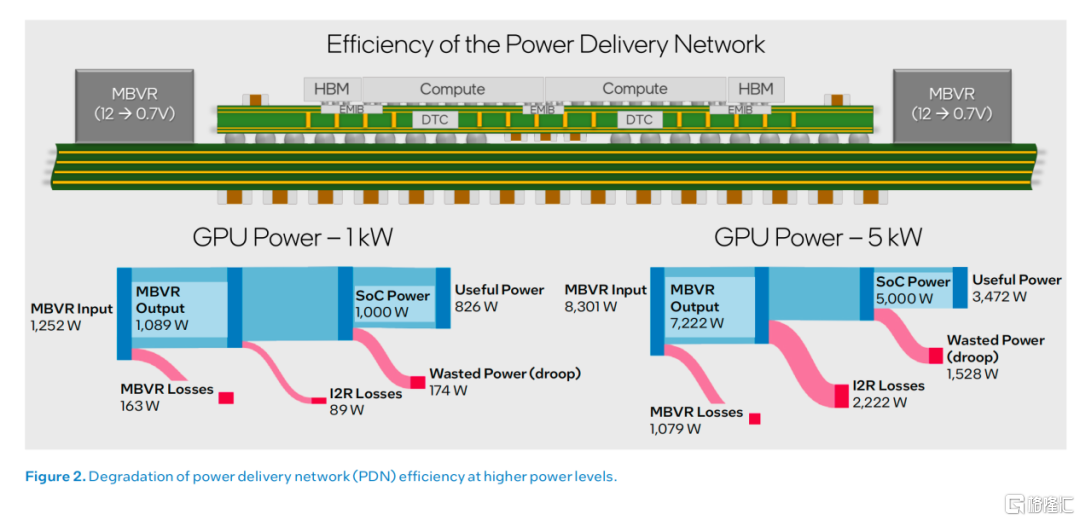
高效输送大电流极具挑战性,尤其是当电压转换位置与负载相距较远时。电流必须通过长距离的电阻性路径传输,这会增加电阻损耗并降低整体供电效率。此外,更高的电流和更快的瞬态变化会加剧电压跌落,迫使设计人员设置电压保护裕量(guard bands)以确保可靠运行。这些保护裕量会增加功耗,并进一步降低系统效率。
图2展示了PDN效率如何随负载电流的增加而下降。尽管电压转换损耗保持相对恒定,但在高功率水平下,电阻损耗和与电压跌落相关的损耗会显著增加。
因此,对于传统供电方案而言,PDN消耗的输入功率占比越来越大,而真正用于计算的有效功率占比则相应减少。
多芯片与堆叠架构
随着传统的单裸片(single-die)微缩技术面临日益严峻的经济与技术挑战,业界正转向先进封装技术——包括芯粒(chiplet)、HBM集成、硅桥和3D堆叠——以持续提升系统级性能与带宽。尽管这些多芯片与堆叠架构实现了更高的性能、带宽及功能集成度,但也给配电、去耦及电压调节带来了新的挑战。
与传统的单片式(monolithic)设计不同,多芯片架构将计算、存储和I/O功能分布在多个硅裸片上,而每个裸片对电压、电流及瞬态响应的要求各不相同。电力必须通过中介层(interposer)、硅桥、封装基板、微凸块(microbump)及硅通孔(TSV)等多种封装结构,输送至各个独立的裸片。与此同时,HBM接口和裸片间互连(die-to-die interconnects)的工作电压裕量日益收紧,且对电源噪声高度敏感。
异构加速器封装日益增加的复杂性,也给硅片本身带来了挑战。计算单元(compute tiles)、存储接口及高速裸片间链路的集成,使得信号布线资源承受着越来越大的压力。在传统的正面供电架构中,电源轨与信号互连必须共用布线资源,这导致了信号带宽与供电能力之间存在根本性的权衡取舍。为了支持不断增加的信号密度,先进技术不断增加布线层数并采用日益复杂的互连结构。
然而,这些额外的布线层也可能增加供电路径的有效电阻,因为电流在到达有源电路之前,必须穿过更多的垂直互连层。在大电流条件下,这种额外电阻会导致更大的电压降(IR drop)、降低供电效率并进一步压缩电压裕量。
这些趋势正推动架构发生根本性转变,即转向背面供电(backside power delivery)技术。该技术将配电网络转移至晶圆背面,从而释放正面的信号布线资源,并降低传统供电网络(PDN)所固有的电阻与布线拥塞问题。
数据中心电力趋势
单机柜功率的提升正在重塑电力输送需求,并带来了严格的空间占用、散热及架构方面的制约。传统数据中心机柜的设计功率通常在 10 至 20 千瓦(kW)之间,主要依赖风冷散热,并预留了充裕的空间用于电源、线缆及气流管理。相比之下,现代人工智能(AI)机柜的功率已超过 100 千瓦,且为应对由此产生的热通量,已普遍转向液冷技术。机柜功率密度的增加不仅压缩了用于电力转换、配电及冷却基础设施的可用空间,还提高了整个电力链条的能效要求。
展望未来,行业路线图预测本年代后期机柜功率将逼近 1 兆瓦(MW);这意味着空间利用效率、损耗最小化以及电力输送与冷却系统的紧密耦合,将不再是可选项,而是必不可少的设计要求。
过去十年间,数据中心的设计前提发生了巨大变化。根据劳伦斯伯克利国家实验室(Lawrence Berkeley National Laboratory)2026 年 6 月的估算,到 2030 年,美国数据中心的用电量可能占全美总用电量的 11.8%(具体比例取决于 AI 部署规模及基础设施假设,预计范围在 9.5% 至 15.3% 之间)。这一预测值较 2024 年报告中的估算有所上调——该报告曾预测到 2028 年数据中心用电量将占全美总用电量的 6.7% 至 12.0%——增长的主要驱动力在于 AI 及基于加速器的设备中高密度计算需求的激增。
与此同时,随着大功率加速器部署规模的不断扩大,供电与散热基础设施面临着日益严峻的挑战,而器件技术路线图也持续推动着封装功率水平的攀升。GPU 是推动人工智能(AI)工作负载增长的主要引擎之一,在提升算力的同时也带来了功耗的增加。更高的功率水平会导致不成比例的效率损耗,并引发严峻的热管理挑战。这些问题推高了运营成本与散热需求,增加了基础设施的复杂性,因此,提升端到端供电效率对于未来的规模化扩展显得愈发重要。
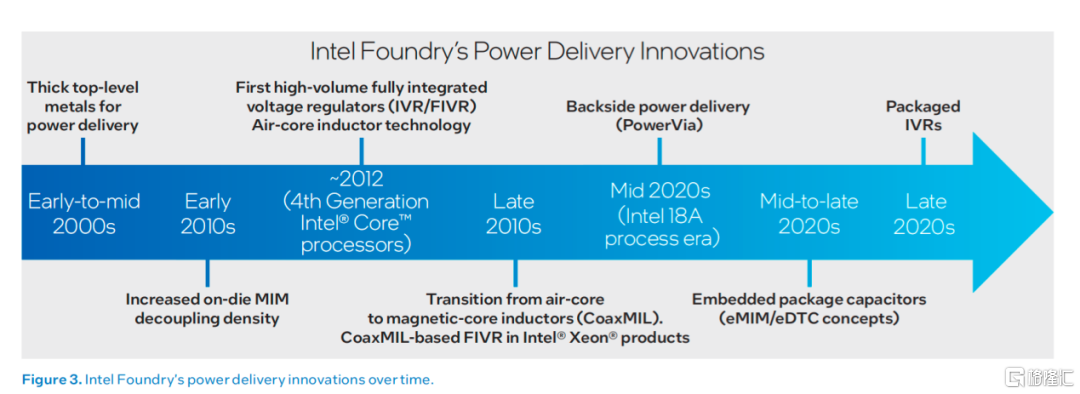
当今AI加速器面临的许多供电挑战,最早出现在英特尔的高性能CPU中;在这些芯片上,日益增长的电流需求将传统的供电架构推向了极限。图3展示了英特尔如何通过一系列开创性的供电创新来应对这一挑战,这些创新后来在整个行业内得到了广泛应用。其中包括用于改善配电的厚金属层、片上金属-绝缘体-金属(MIM)电容器的引入,以及集成电压调节器(IVR)的早期形式。
现代AI加速器的功耗需求正推动着新一代供电技术的创新。为了应对这些挑战,英特尔代工服务(Intel Foundry)正在推进多项技术,包括背面供电(Backside Power Delivery)、先进的封装级去耦解决方案、采用硅通孔(TSV)技术的嵌入式桥接技术,以及将功率转换功能更靠近负载端的新一代IVR架构。下文将详细探讨这些技术。
背面供电:实现电源与信号的分离
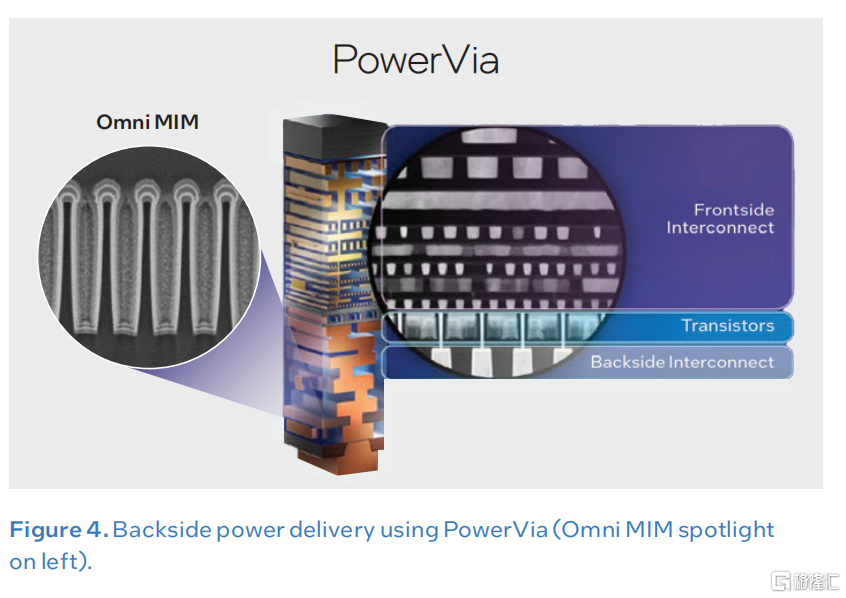
在传统的正面供电架构中,电源轨和信号互连线争用相同的布线资源,导致信号带宽与供电能力之间存在根本性的权衡矛盾。随着金属层堆叠复杂度的增加,电流在到达晶体管之前必须穿过更多的布线层,从而导致更大的IR压降(电压降)。Power Via技术将主电源重新路由至芯片背面,从而在物理上将电源布线与正面信号互连线分离开来(见图4)。这种方法缩短了电阻性电流路径,缓解了正面布线拥塞,使得两个网络能够各自进行独立优化。
Power Via技术能够显著降低片上IR压降,更有效地利用正面布线资源来传输信号,并提高标准单元的利用率。对于大电流逻辑电路而言,背面供电技术直接解决了传统正面供电网络(PDN)在扩展性方面面临的诸多根本性限制。
要实现这些优势,需要在工艺集成、热管理和架构设计等多个层面进行紧密的协同优化。
PowerVia 技术率先应用于 Intel 18A 工艺,同时也为 Intel 18A-P 上的 Power Boost 技术奠定了基础;Power Boost 是一种全新的双触点架构,能够在保持电容不变的情况下实现超过 10% 的频率提升。PowerDirect 是英特尔代工业务(Intel Foundry)计划用于 Intel 14A 工艺的第二代背面供电技术,它将继承 PowerVia 的优势,通过进一步提升面积效率并优化供电架构,从而全面改善功耗、性能和面积(PPA)表现。
Omni MIM:片上(On-Die)去耦电容
尽管背面供电技术最大限度地减少了片上 IR 压降,但要实现稳健的电源完整性,还需要改进片上去耦技术,以支持 AI 工作负载产生的大瞬态电流。英特尔率先将 MIM(金属-绝缘体-金属)电容引入大规模量产的逻辑工艺中,提供片上电容以满足高频去耦需求。
图 4 左侧的特写展示了 Omni MIM,这是 Intel Foundry(英特尔代工服务)最新一代的片上 MIM 电容技术。早期的 MIM 电容采用平面结构,后续几代产品通过增加电极层数来提高电容密度。虽然这种方法行之有效,但由于电容值大致随极板数量线性增加,其带来的提升仅限于渐进式改进。Omni MIM 采取了不同的策略,将电容结构扩展到了第三维度。通过在层间介质中引入垂直沟槽,Omni MIM 在保持与有源电路紧密邻近的同时,实现了电容密度的大幅提升。
eMIM-T 和 eDTC:先进封装去耦解决方案
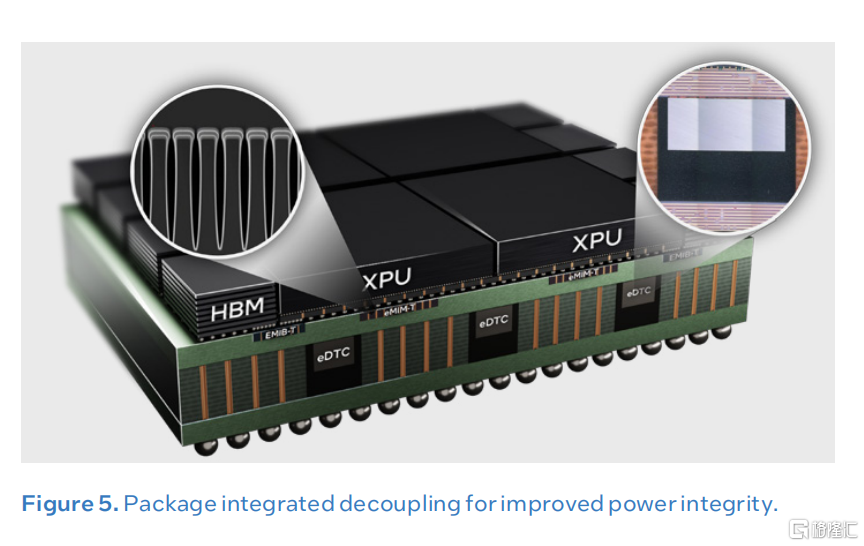
片上 MIM 电容是应对快速电流瞬变的第一道防线。然而,其存储的电荷量有限,必须由下一级去耦电容进行补充。传统上,这一角色由安装在封装焊盘侧(land side)和芯片侧(die side)的分立式陶瓷电容承担。在高密度加速器封装中,顶部区域几乎完全被计算芯片和存储芯片占据;与此同时,焊盘侧密集分布着球栅阵列(BGA)连接,以支持大电流供电和封装外 I/O 传输。这使得传统表面贴装去耦电容的可用空间十分有限,从而凸显了嵌入式电容技术的重要性。
Intel Foundry 正在开发两种互补的嵌入式电容技术,以满足这些需求:
Intel Foundry 专有的 eMIM-T 电容技术将 Omni MIM 技术扩展到了封装内部,通过在封装积层(build-up layers)中集成多层高密度 MIM 电容来实现(见图 5)。通过将电容放置在更靠近负载的位置,eMIM-T 在利用硅通孔(TSV)连接维持直流供电的同时,改善了高频去耦性能。在受限于面积或工艺条件的芯片内电容设计中,eMIM-T 结构可在不占用宝贵硅片面积的情况下,作为芯片内电荷存储功能的补充。
嵌入式深沟槽电容(eDTC)集成于封装内部,可提供额外的去耦电容层级,从而最大化封装内的总电容,有助于满足低频至中频段的去耦需求。
EMIB-T:赋能 HBM4 与高速芯片间(Die-to-Die)互连
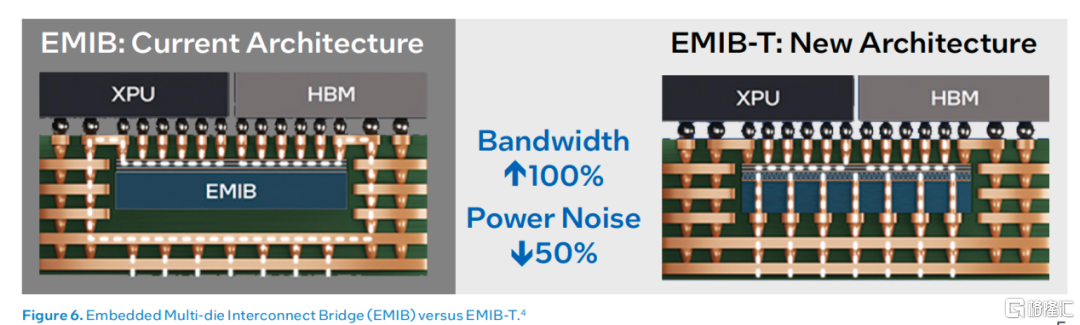
图 6 左侧展示的嵌入式多芯片互连桥接(EMIB)是英特尔代工服务(Intel Foundry)的一项先进封装技术,它能够在无需使用全硅中介层(且避免了由此带来的高成本与复杂性)的情况下,实现多芯片架构。
自 2017 年推出以来,EMIB 在提升先进多芯片封装的带宽和芯片间互连能力方面发挥了关键作用。随着 AI 和 HPC 平台采用 HBM4 及下一代通用芯粒互连标准(UCIe)链路等高带宽接口,电流需求也随之增加。在传统的 EMIB 实现方案中,电源路径需绕过桥接结构,这增加了路径电阻。随着电流密度的升高,IR 压降(电压降)也会增大,并可能在边缘凸点(bump)处引发电流拥挤现象。
这引发了关于能效和可靠性的担忧。
图 6 右侧展示的较新 EMIB-T 架构通过在桥接结构内部直接集成硅通孔(TSV)解决了上述局限性。这些 TSV 为负载提供了更直接的垂直电流路径,使电流能够穿过桥接结构而非绕行。这不仅降低了电阻损耗,还使电流在凸点阵列上的分布更加均匀,从而有助于缓解边缘凸点的可靠性风险。
EMIB-T 还在桥接结构内集成了 MIM 电容器,用于在高速 I/O 电源轨上实现交流(AC)噪声的局部抑制。这些特性共同作用,为下一代高带宽芯粒架构提供了更稳健的供电能力。
台积电在2026年6月举行的IEEE/JSAP超大规模集成电路研讨会上介绍公司首个埃级CMOS平台的同时,也介绍了公司的背面供电。
据介绍,该节点结合了增强型纳米片全环栅晶体管和背面供电技术。其关键集成特性是超强电源轨(Super Power Rail,简称SPR),台积电将其描述为一种背面直接接触供电方案,旨在满足人工智能和高性能计算等具有密集电源网络和复杂信号布线的应用需求。与N2P技术相比,在相同功耗下,A16技术的速度提高了8%至10%,或在相同速度下降低了15%至20%的功耗,同时芯片密度提高了8%至10%,预计将于2026年第四季度实现量产。
A16通过将主电源分配网络移至晶圆背面,实现了电源传输与正面信号布线的分离。这释放了正面资源,用于时序关键型互连,同时为VDD/VSS供电创建了一条低阻抗路径。台积电的A16公开页面指出,SPR通过将正面布线专用于信号传输并显著降低IR压降,提高了逻辑密度和性能。
台积电方案的一个显著特点是背面直接接触式架构。与仅在器件层下方放置大面积背面电源金属不同,SPR 通过背面过孔和触点将背面电源更直接地连接到晶体管的源/漏区。VLSI 技术手册将 A16-SPR 描述为采用背面直接接触式电源传输、正反两面金属以及 3D MIM 电容器,这表明该电源传输系统并非简单的布线重组,而是一个完整的工艺集成模块。
这一点至关重要,因为背面供电方式可能会在单元高度、器件宽度、标准单元架构以及设计技术协同优化等方面造成权衡。台积电强调,其背面接触方案能够保持 N2P 栅极密度和 NanoFlex 设计的灵活性,这意味着设计人员仍然可以针对性能、功耗和面积调整单元布局,而无需受限于单一的单元模板。VLSI 会议摘要特别指出,SPR 能够保持 N2P 栅极密度和 NanoFlex DTCO 的优势,这对于实际产品实现而非仅仅是测试芯片演示至关重要。
对于人工智能和高性能计算芯片而言,A16 的优势尤为显著。大型加速器具有巨大的并发开关电流、较长的全局路由、大量的 SRAM/缓存以及严格的时序收敛要求。降低 IR 压降可以提高晶体管的有效驱动能力,因为到达有源器件之前的电压损耗更少。释放前端布线空间也有助于提高高利用率逻辑块的性能,否则拥塞会导致更长的导线、更多的缓冲区或更大的单元。实际上,SPR 应该能够提高电气效率和物理设计收敛性,尤其适用于计算单元、CPU 内核和加速器架构。
集成电压调节器 (IVR)
随着加速器电流需求攀升至数千安培量级,维持高效的电力输送与精确的电压调节变得愈发困难。
此外,调节器效率往往会随负载电流的增加而下降,从而需要更多的输入功率来维持运行。这种效应在系统规模扩大时会产生叠加影响,进一步加剧了散热和电力输送方面的挑战。
基于 IVR 的架构通过将电压转换环节移至更靠近负载的位置,有助于应对上述挑战。缩短调节器与有源电路之间的距离,既能降低电阻损耗,又能改善瞬态响应。
在较低输出电压下实现更高的局部转换效率,辅以降低的配电损耗,使得电力能够更有效地输送至所需部位。此外,缩短调节器与负载之间的电气路径,有助于缓解现代加速器中常见的电流快速瞬变期间出现的电压跌落现象。
接下来的三个部分将介绍英特尔开发的一系列 IVR 相关技术,旨在支持电流需求更高、密度更大的加速器系统。
FIVR 与 CoaxMIL
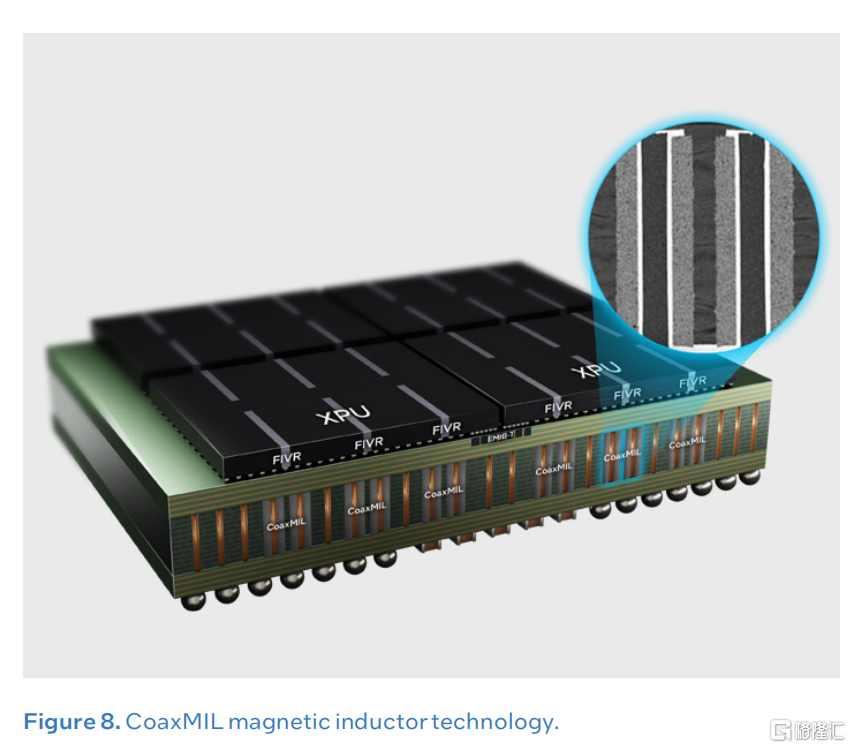
十多年前,英特尔率先在大批量生产中部署了 IVR。最初的全集成稳压器 (FIVR) 架构将电源开关、控制器和输出 MIM 电容器直接集成在处理器芯片上,同时在封装中使用空芯电感器 (ACI) 进行储能。该方法对早期产品有效,但较高的电流密度需要较小的 ACI 占位面积,这会降低电感器质量并导致转换效率相应下降。
为了解决这一限制,英特尔推出了 CoaxMIL,这是一种磁感应器解决方案,首先部署在第四代英特尔至强可扩展处理器上(请参见下页的图 8)。通过显着减少电感器占地面积,CoaxMIL 可实现更高的电流密度,同时提高功率转换效率。新一代 CoaxMIL 已部署在后续的英特尔至强处理器系列中,不断提高转换效率,并引入耦合电感器配置,增强瞬态响应,同时进一步减少占地面积。
C2VR
连续电容式电压调节器(C2VR:continuous capacitive voltage regulator)是一种采用高密度MIM电容而非电感的电压调节器(VR)芯粒,能够将高达2.4V的输入电压转换为典型的内核域电压(见图9)。由于MIM电容直接集成在芯粒上,C2VR提供了一种综合性的VR解决方案,可在单块硅片上实现超过90%的效率和10 A/mm²的电流密度。仅依赖电容,C2VR几乎能瞬时增加输出电流,从而在高di/dt瞬态事件中将电压跌落降至最低。
C2VR具有可扩展性,支持高达数千安培(multi-kiloamp)的电流水平,并可放置在封装的芯片侧或焊盘侧(landside)。根据具体实现方式,C2VR既可以嵌入封装的积层(build-up)中,也可以直接集成到堆叠芯片设计的基底芯片内。
IVR集成架构
将电压转换功能向负载端推进的一个切实可行的第一步,是将调节器集成在封装的焊盘侧(如图9所示)。与传统的MBVR(主板电压调节器)相比,焊盘侧IVR显著缩短了供电路径并降低了配电损耗,同时避免了片上电压调节(on-die VR)所带来的诸多工艺集成挑战。尽管具有这些优势,焊盘侧IVR在高电流密度下仍面临严峻的电气和热机械挑战。焊盘侧IVR的存在及其散热需求,会占用原本可用于供电的BGA(球栅阵列)和印制电路板(PCB)资源。这可能导致输入路径上的布线损耗增加,从而部分抵消了近负载集成所带来的效益。
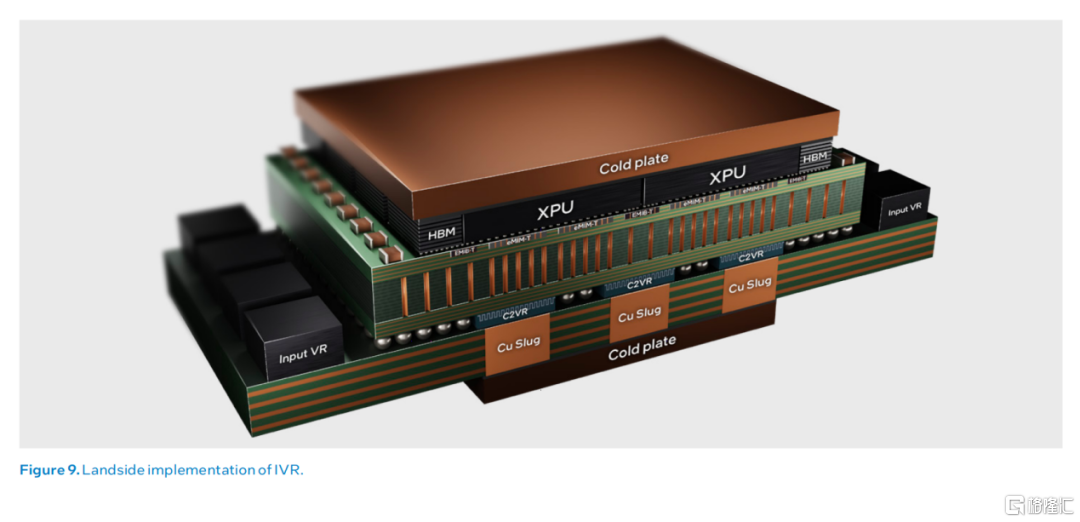
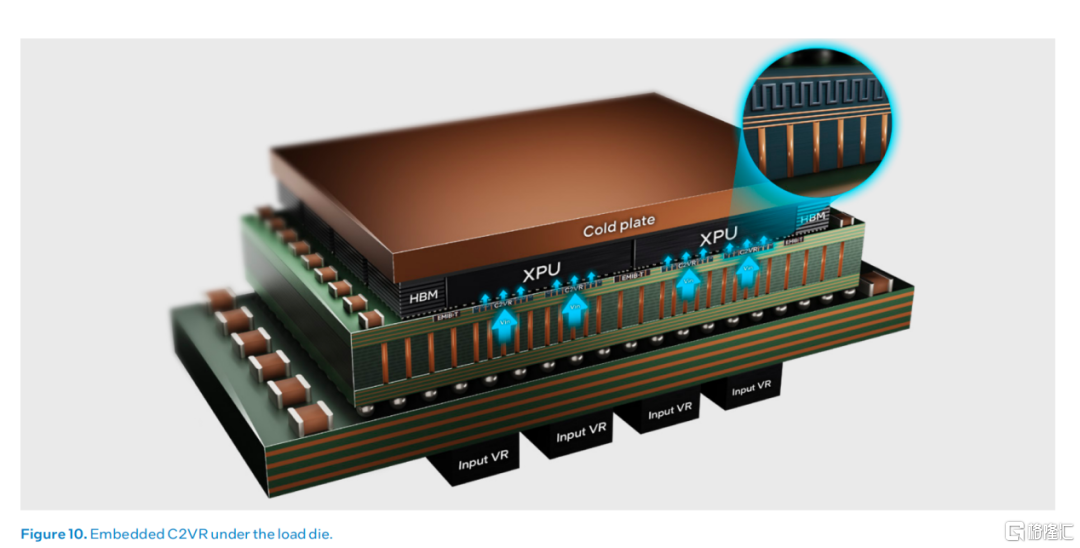
克服“板面侧”(landside)实施局限性的一种方法,是将集成电压调节器(IVR)直接集成在计算裸片(compute die)下方,从而实现垂直供电。然而,这要求 IVR 架构具有极薄的厚度,并能利用硅通孔(TSV)从背面传输输入电源。C2VR 非常适合这种集成方案,因为其全电容式结构在减薄至 100 微米以下时仍能保持功能,从而允许通过 TSV 从结构背面进行输入供电。这种灵活性使 C2VR 既可以嵌入封装的积层(build-up layers)中(见图 10),也可以在堆叠裸片架构中直接集成到基底裸片(base die)上。
来到台积电,他们在去年也展示了一款用于人工智能的集成电压调节器(IVR),其垂直功率密度是分立式设计的五倍。
最新的AI数据中心芯片需要1000A的电流,而下一代芯片的电流需求将达到2000A,也就是千瓦级的功率。提供如此大电流的关键方法之一是采用垂直供电,将电源从AI芯片的背面输入。
台积电开发的 IVR 采用基于 16nm 工艺技术的电源管理 IC (PMIC),该 IC 集成了 2.5nH 或 5nH 的“超薄”电感器,并带有硅通孔 (TSV)。
该 PMIC 将采用陶瓷层来构建电感器,并且该 PMIC 将位于基板上,旁边是使用 TSMC CoWoS-L 工艺制造的中介层中的嵌入式深沟槽电容器 (eDTC)。
稳压器采用 eDTC 构建,可提供 1100 至 2500nF 的电容来滤波电源,稳压器中的 TSV 为印刷电路板与 1.6nm A16 工艺技术中可用的背面电源焊盘提供连接。
功率放大器集成电路 (PMIC) 和电容器的组合,加上一千瓦的功率,还需要借助 Synopsys、Ansys和 Cadence Design Systems等 EDA 公司提供的工具进行详细的热建模。
然而,台积电尚未确认这款电源管理集成电路(PMIC)是其自主设计制造,还是由合作伙伴设计制造。无论哪种情况,这都给集成电压调节器的实现带来了挑战。
台积电是一家纯粹的芯片代工厂,不寻求与芯片设计客户竞争,也不推荐特定的第三方芯片,但这款芯片的设计非常特殊,属于前沿的电源芯片设计。它很可能通过台积电的合作伙伴生态系统作为一种可选方案提供,同时也将激励其他电源管理集成电路(PMIC)设计商生产此类芯片。
写在最后
随着AI加速器功率持续攀升,供电已经不再只是芯片设计中的配套环节,而正在成为决定芯片性能、能效和系统扩展能力的重要因素。从背面供电、片上及封装级去耦,到EMIB-T、IVR以及更靠近负载端的电压转换,不同技术路线实际上都在解决同一个问题:如何在越来越高的电流密度下,以更短、更低阻、更高效的路径,将电力送达计算单元。
更值得关注的是,这一变化正在打破芯片、封装和电源之间原有的边界。未来的AI芯片,供电网络很可能与计算、存储、互连一样,成为架构设计的一部分。随着单颗加速器从千瓦级继续向更高功率迈进,以及数据中心机柜进一步走向数百千瓦乃至兆瓦级,单纯依靠提高芯片性能来获得算力增长的模式将面临越来越明显的电力约束。谁能够率先解决“电从哪里来、如何送进去、如何高效转换以及如何把热带走”这一整套问题,谁就更有可能在下一代AI计算的规模化竞争中占据主动。