智东西
编译 | 杨京丽
编辑 | 心缘
智东西10月1日消息,今天凌晨,谷歌发布新一代旗舰模型Gemini 4 Argon,重点面向软件工程、法律与金融等企业知识工作,以及网络安全防御等复杂、长周期任务。
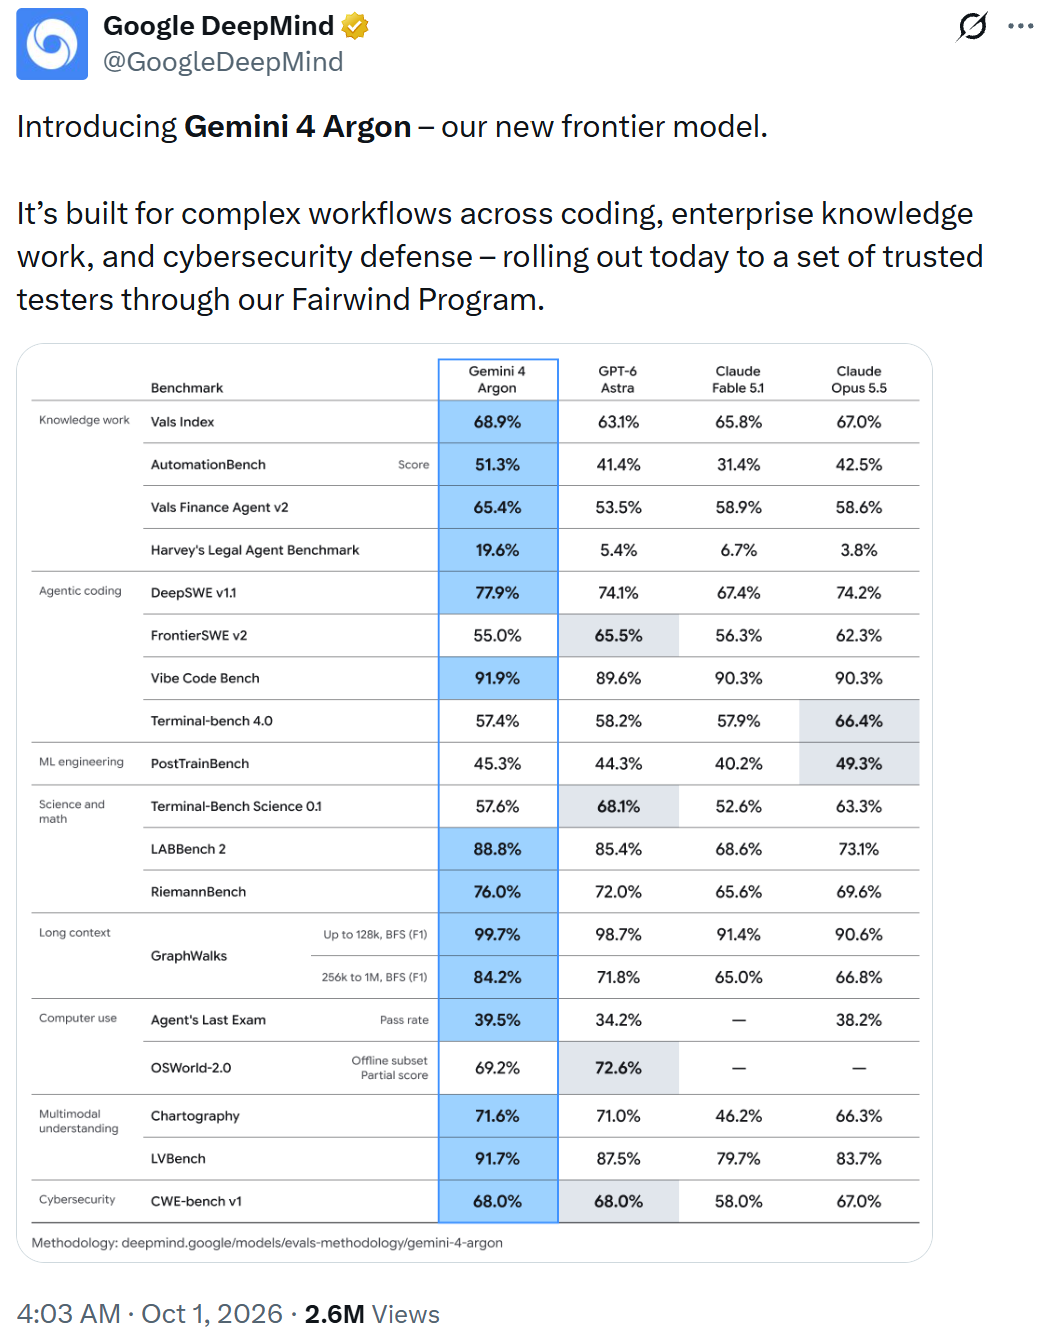
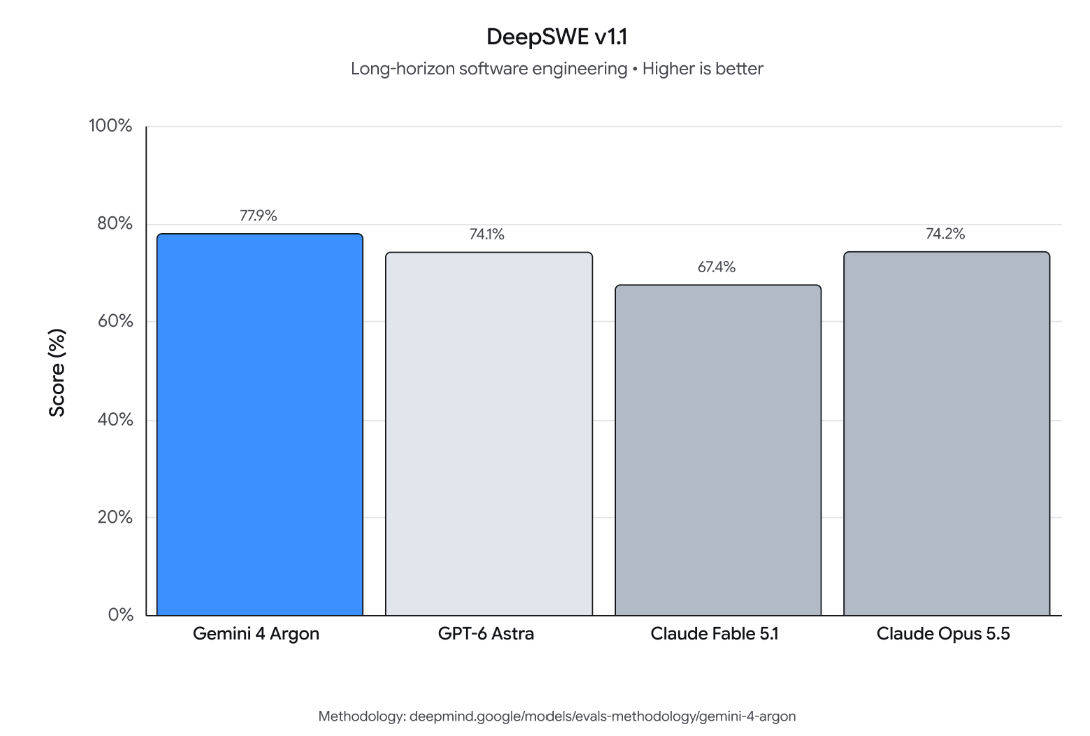
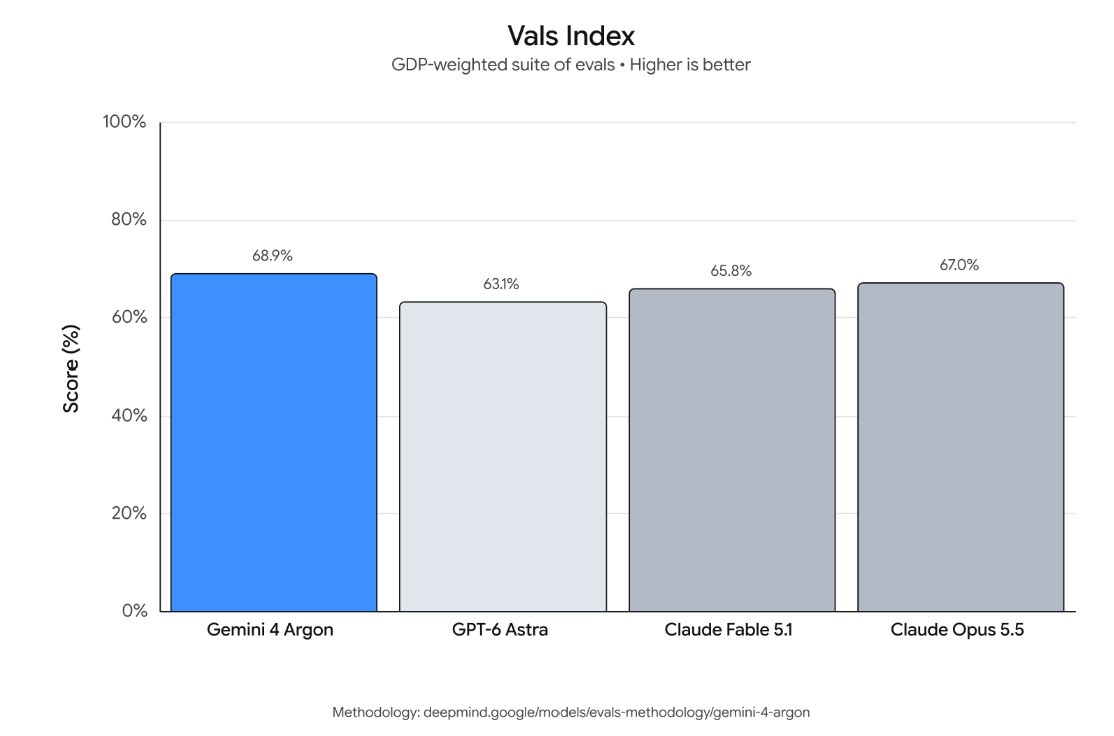
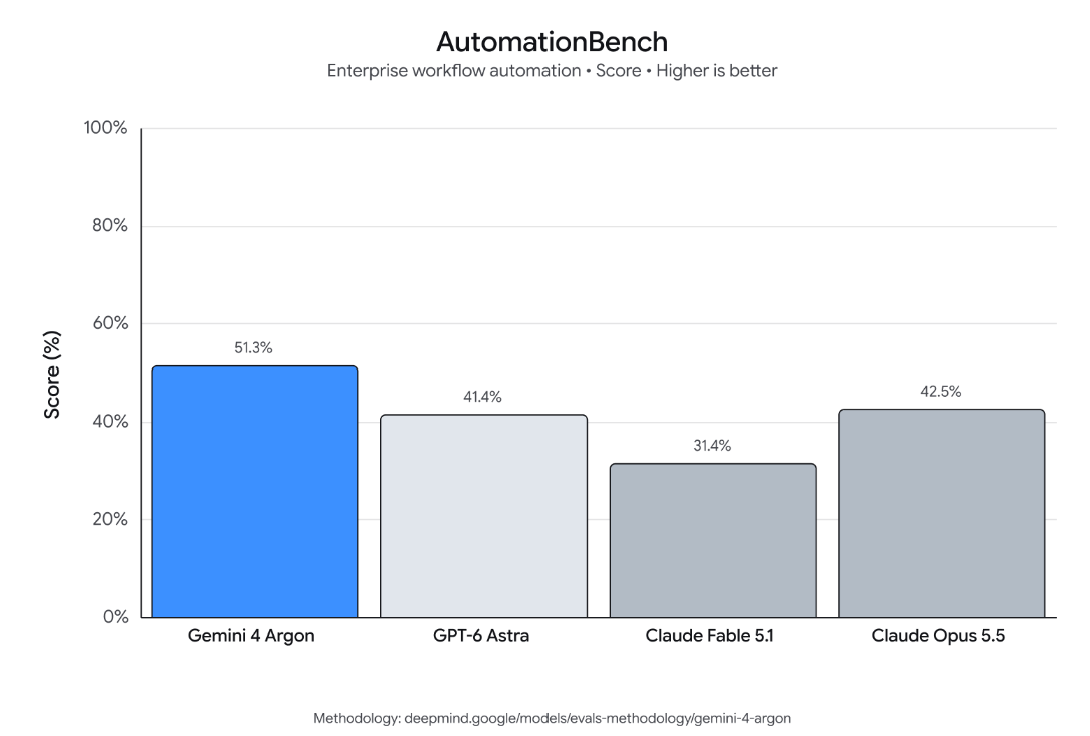
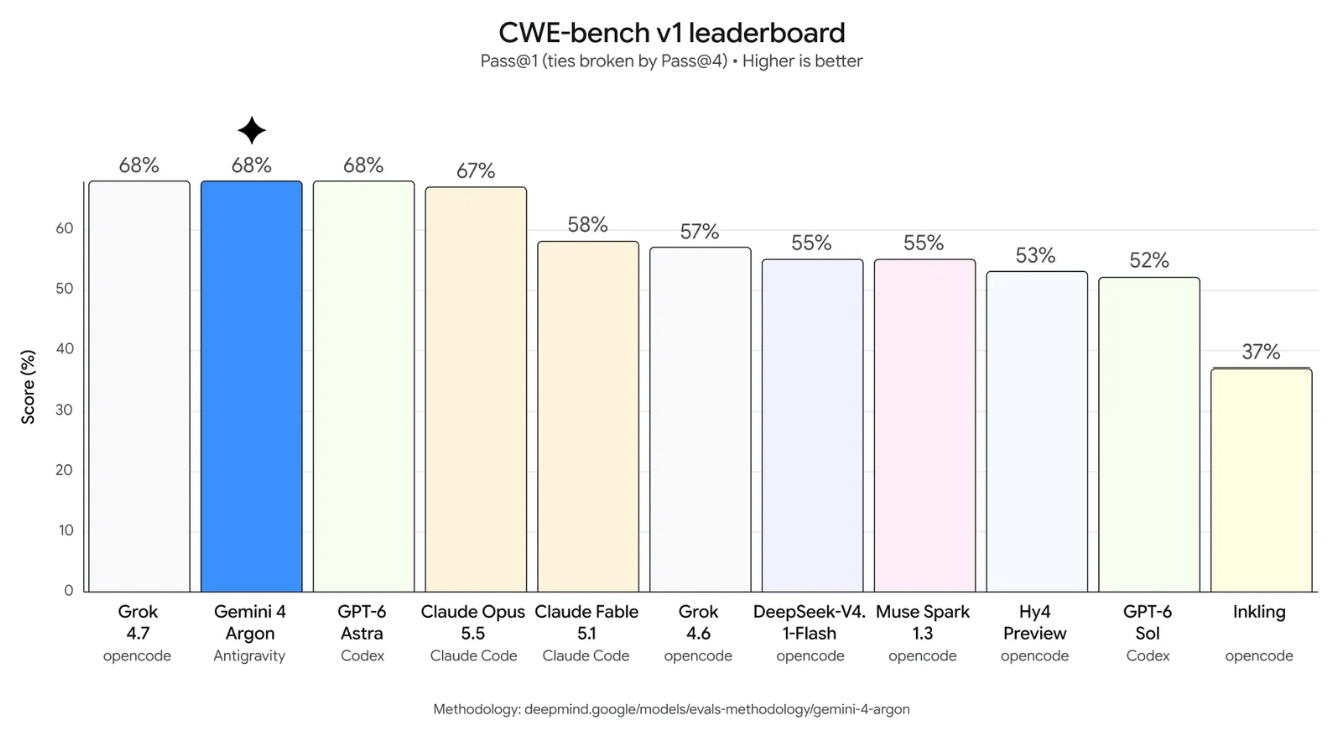
在衡量长程软件工程能力的DeepSWE v1.1测试、评估金融、编程、法律和税务等企业知识工作的Vals Index、测试企业端到端自动化执行能力的AutomationBench,以及考察长视频理解能力的LVBench中,Gemini 4 Argon均领先GPT-6 Astra、Claude Fable 5.1和Claude Opus 5.5等模型;在评估漏洞修复能力的CWE-bench v1中,Argon以68%的成绩与GPT-6 Astra并列第一。
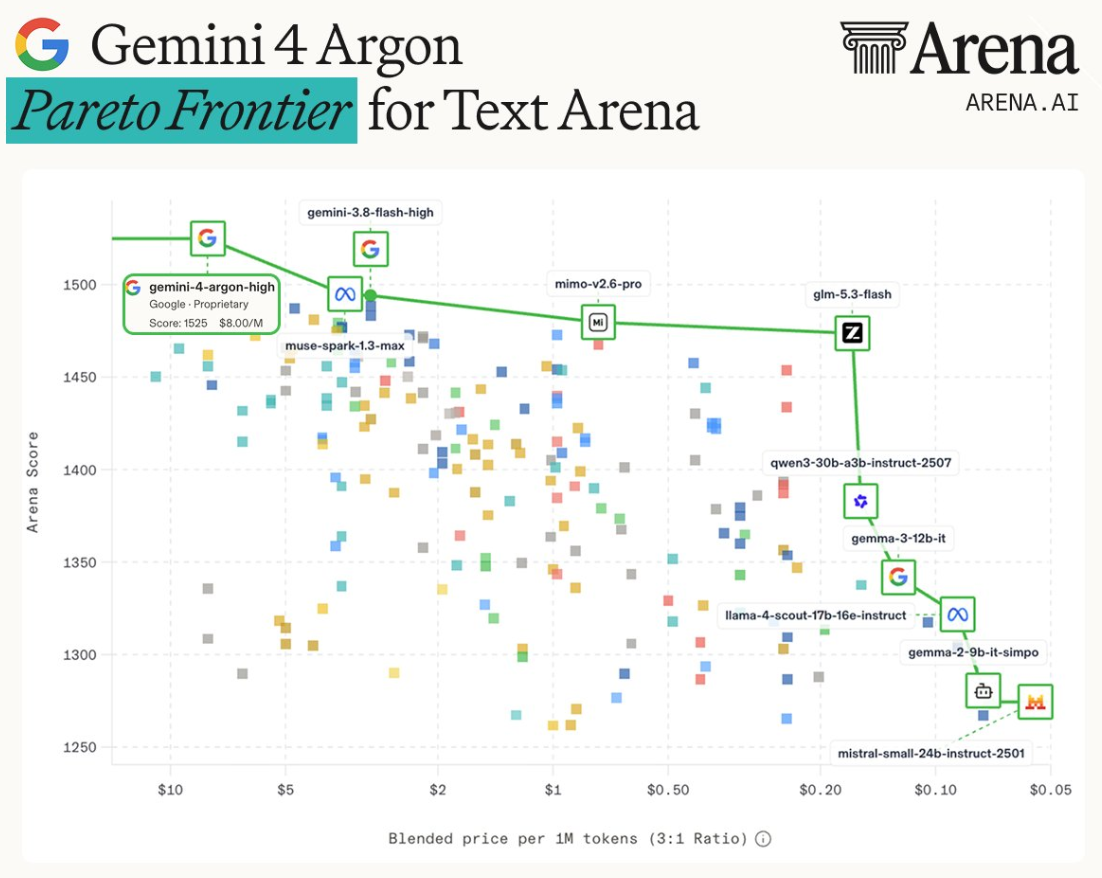
在Text Arena的模型成本与得分对比中,Gemini 4 Argon High以1525分和每百万Token 8美元的混合价格,进入成本-性能前沿。
目前,在Artificial Analysis Intelligence Index中,Gemini 4 Argon得分53分,仅落后于Claude Opus 5.5和Claude Sonnet 5.5,得分与Claude Fable 5.1、GPT-6 Astra并列。
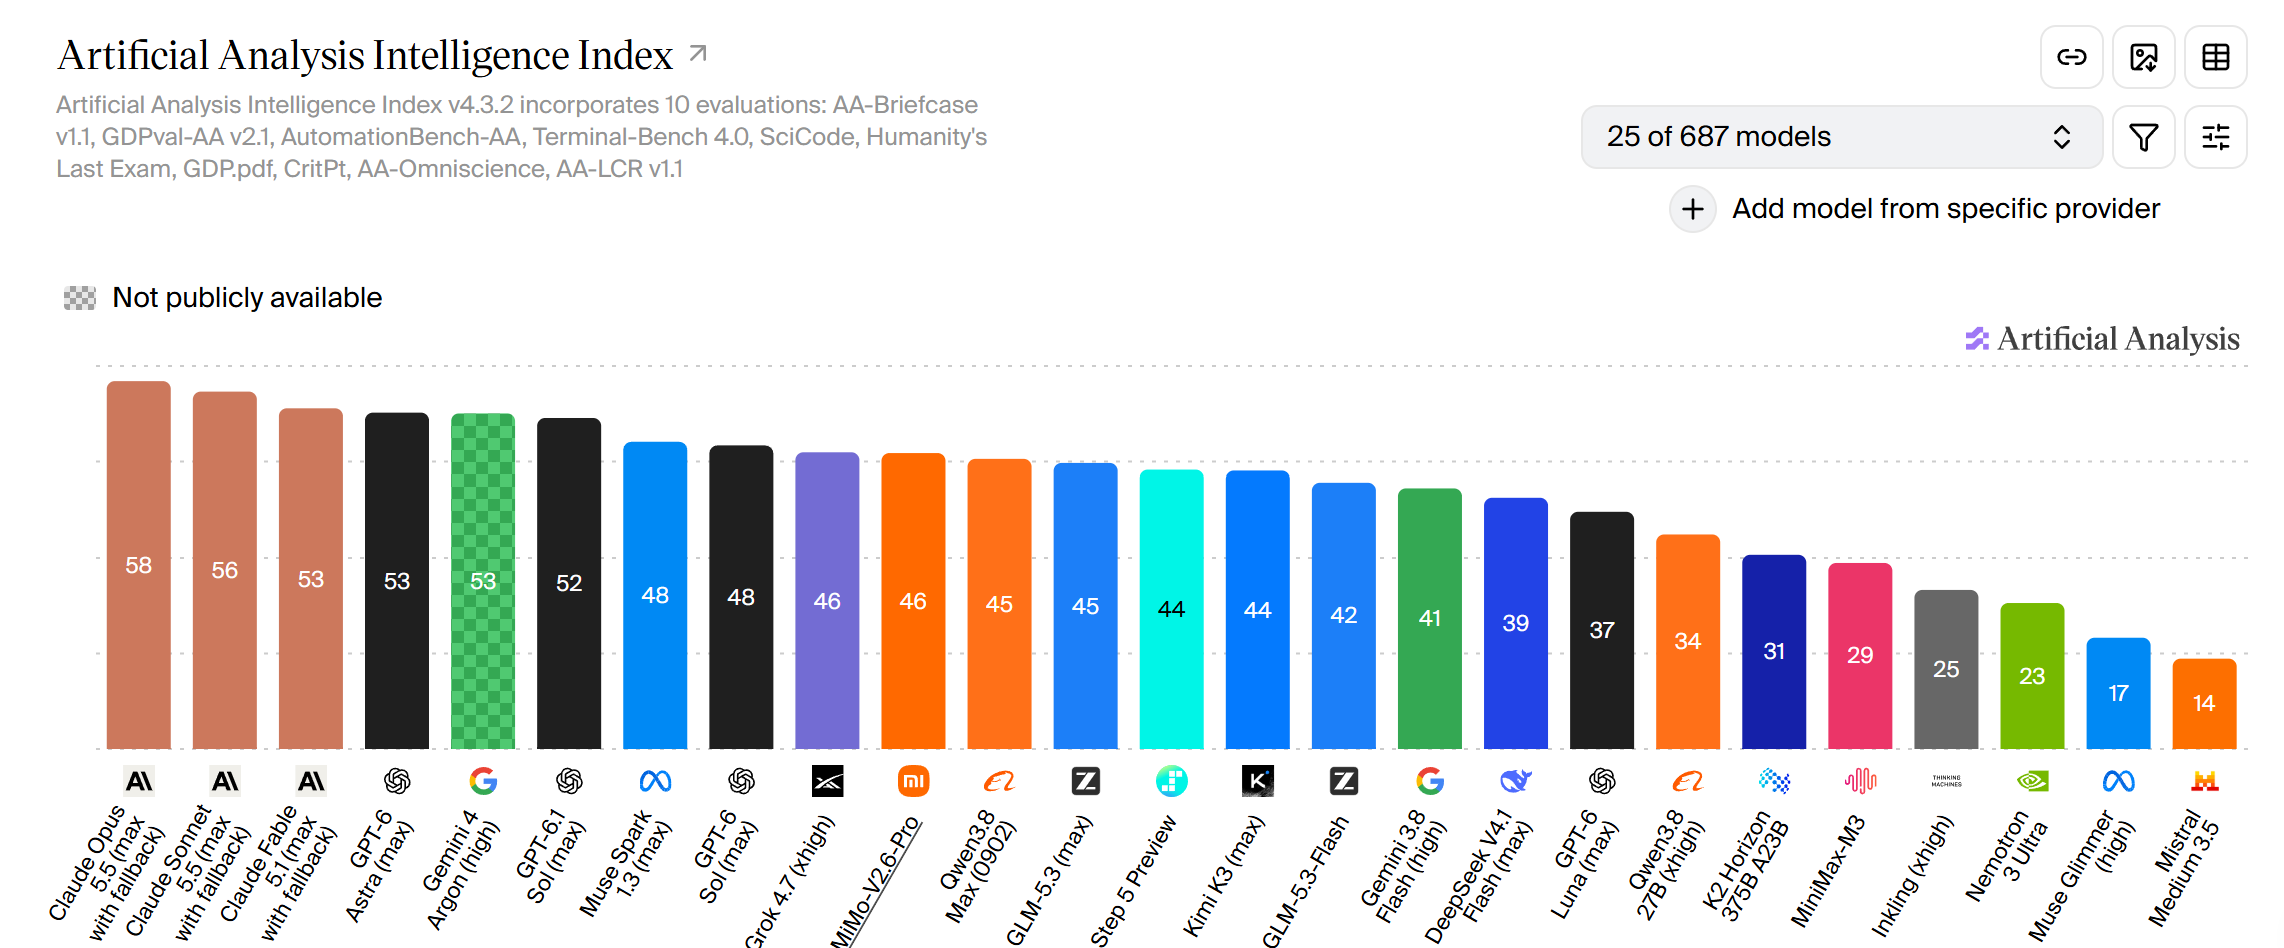
▲Gemini 4 Argon在Artificial Analysis上测评情况(图源:Artificial Analysis)
不过,彭博社援引知情人士称,部分谷歌员工认为,Gemini 4虽然在行业基准测试中表现亮眼,但在实际工作中并不总能达到同等水平,尤其是在部分编程任务上仍较为吃力,这与谷歌当天发布的测试成绩形成反差。
Gemini 4 Argon现已通过“Fairwind计划”向一批经过筛选的网络安全防御团队开放。谷歌计划先收集早期测试反馈、继续完善安全护栏,随后逐步向开发者、企业和消费者开放,首批用户将包括付费API客户和Google AI Ultra订阅者。
Argon API初始价格为每百万输入Token 2美元(约合人民币13.4元)、每百万输出Token 10美元(约合人民币67元),缓存输入Token价格在输入Token基础上降低95%,即每百万Token约0.1美元(约合人民币0.67元)。
根据Artificial Analysis,按折扣定价,Gemini 4 Argon的每任务成本为1.99美元,较GPT-6 Astra(max)降低40%。
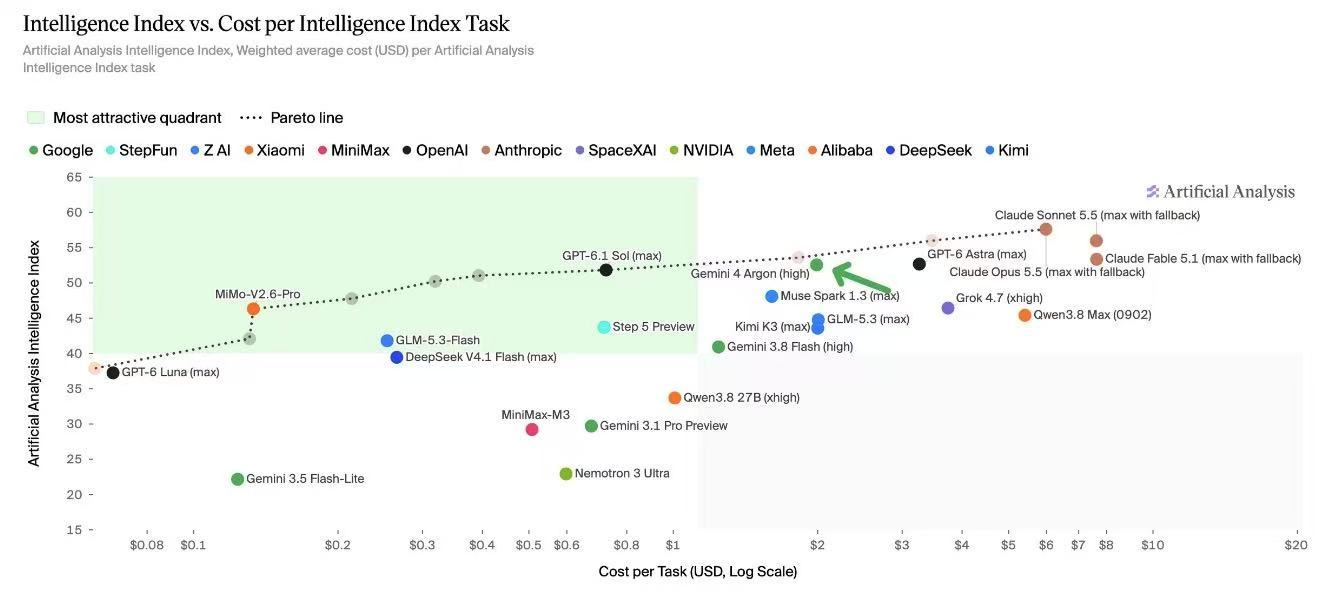
▲Gemini 4 Argon每任务成本与其他模型对比(图源:Artificial Analysis)
谷歌首席执行官桑达尔·皮查伊(Sundar Pichai)称,外界对下一代模型的讨论很多,因此希望尽早展示Gemini 4 Argon。谷歌内部团队已广泛将其用于编程、量子计算等工作,反馈良好。
▲皮查伊发文官宣Gemini 4 Argon(图源:X)
一位X用户认为,Gemini 4对提示词格外敏感,输出内容和风格受提示词影响的程度超过其他模型,默认风格不佳,但增加一句提示词就容易改善。他还展示了用不同提示词复刻《乐高星球大战》关卡的效果。
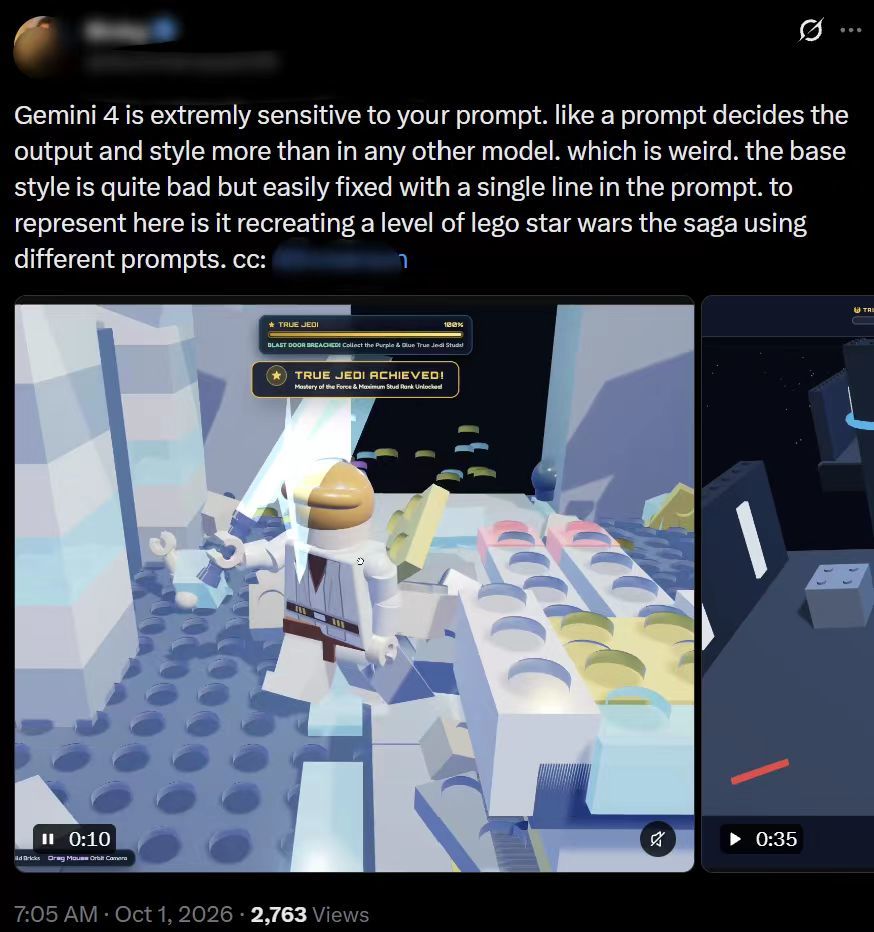
▲开发者对于Gemini 4 Argon的评价(图源:X)
另一位开发者认为,在一次生成细节丰富、美感出色的3D场景方面,Gemini 4 Argon尚未达到Opus 5的水平。Gemini 4 Argon在画面细节上,效果略显粗糙。
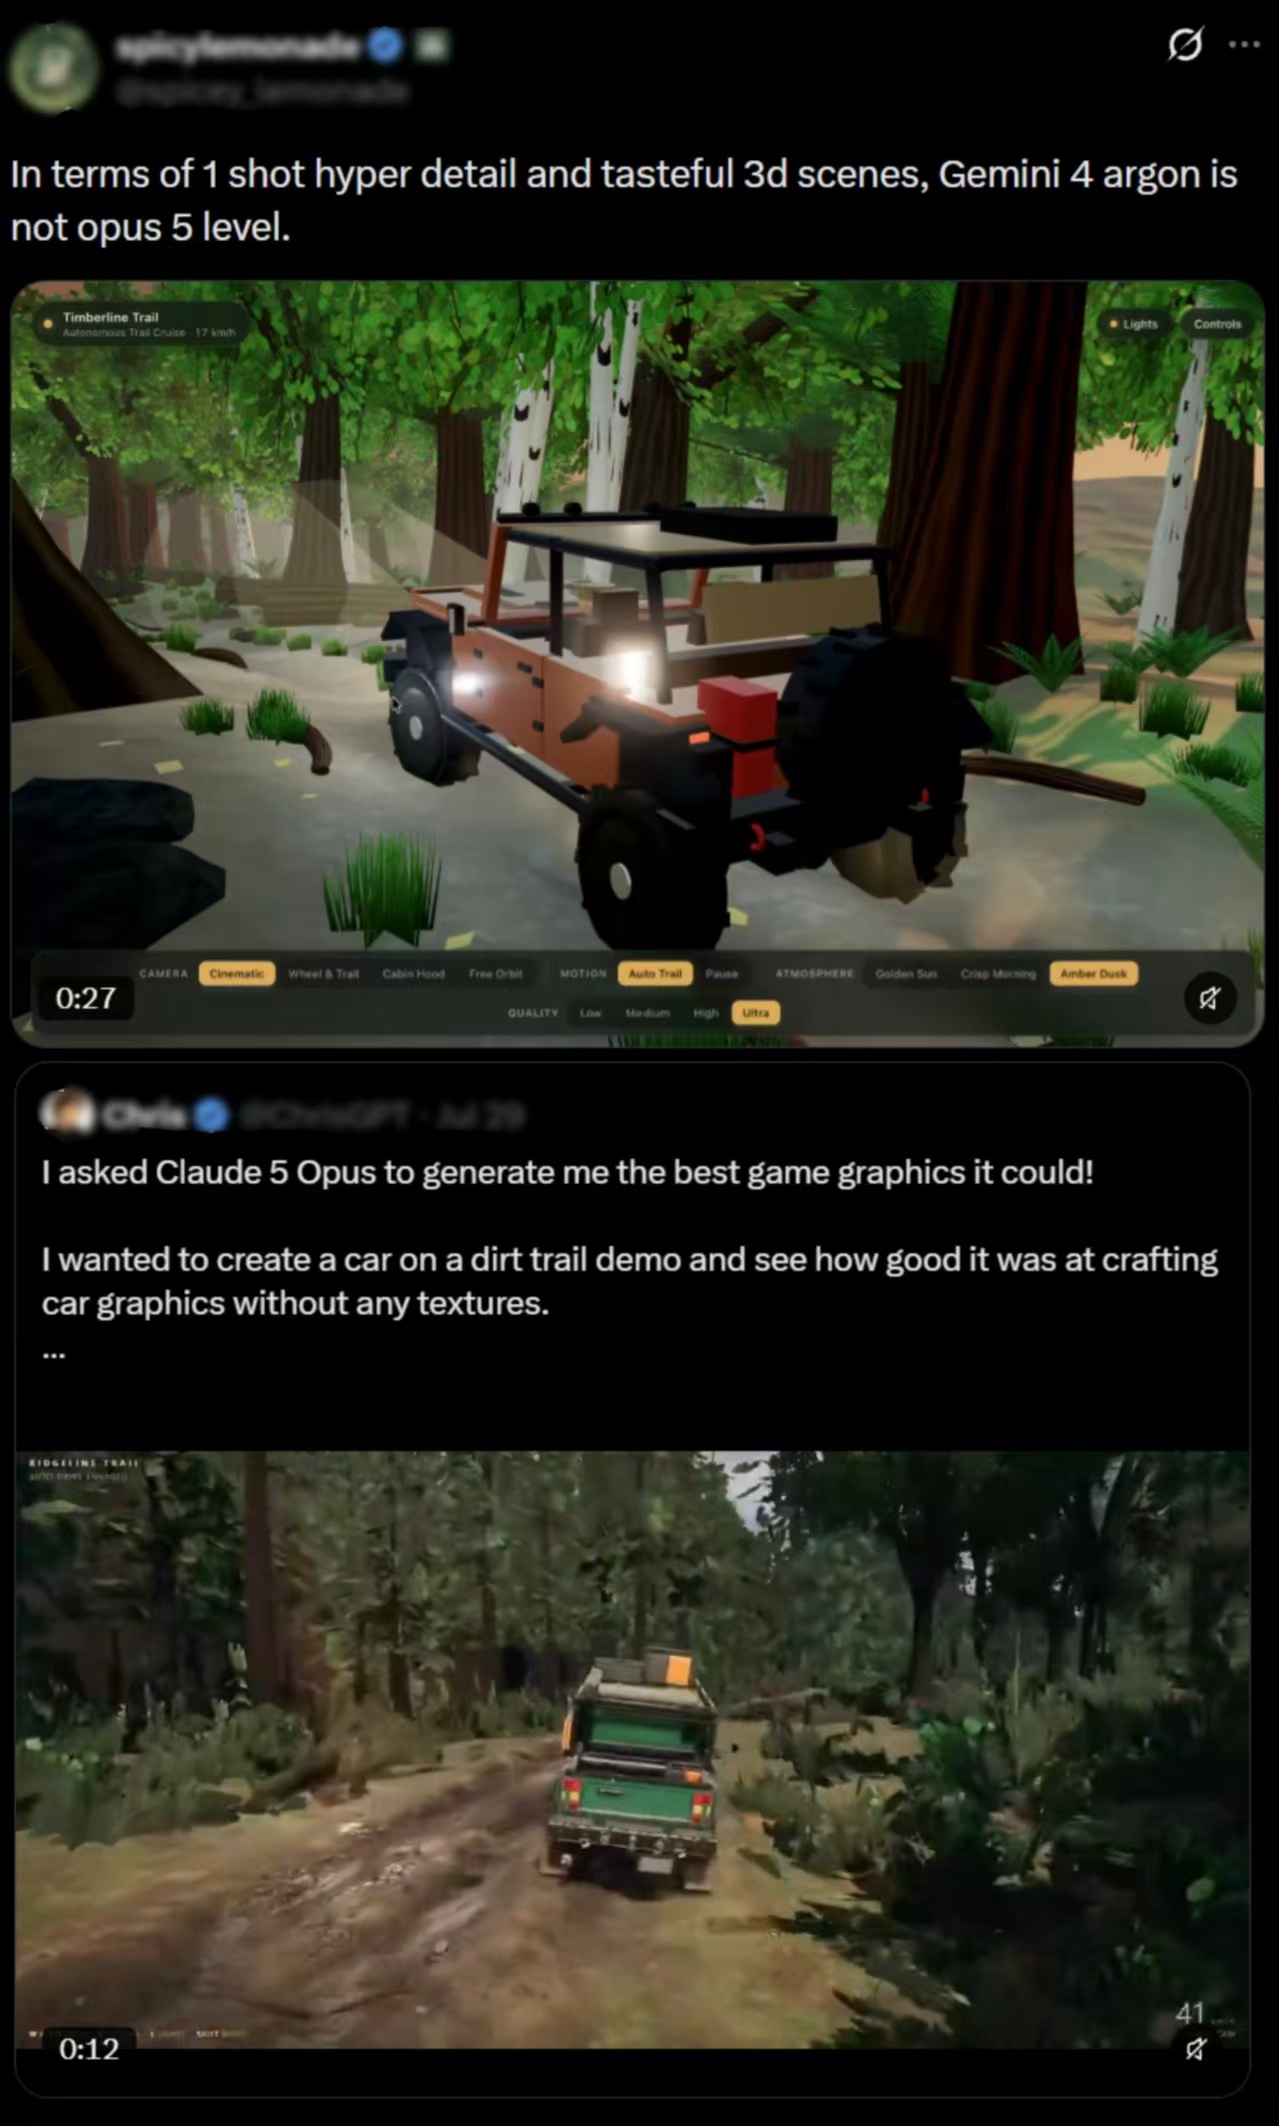
▲开发者对比Gemini 4 Argon(上)和Claude Opus 5(下)的生成效果(图源:X)
一、输出上限提升至100万Token,编程能力与企业任务测试突出
Gemini 4 Argon将模型输出Token上限从此前的6.4万Tokens提升至100万Tokens,成为目前业内输出容量最高的模型之一。更大的输出空间允许模型在单次任务中深度思考,并生成数十万甚至上百万Token,用于处理大型代码库、复杂研究和多步骤企业流程。
编程方面,Gemini 4 Argon在衡量真实世界长期软件工程能力的DeepSWE v1.1测试中取得77.9%的成绩,刷新该测试的最好纪录。
在覆盖金融、编程、法律和税务等工作的Vals Index中,Argon排名第一。Argon还在Vals Finance Agent v2测试(多步骤金融研究)、Harvey法律Agent测试(法律研究与起草)中取得领先成绩。
在Zapier用于评估企业端到端自动化执行能力的AutomationBench中,Argon得分51.3%,位列第一,明显领先GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5等模型。
Argon的多模态能力也被用于长视频和专业图表分析。在评估长视频理解能力的LVBench中,该模型得分91.7%,达到现有模型最优水平。
二、深入谷歌内部工作流,完成量子算法优化与大规模代码迁移
在谷歌内部,数千名员工已将Gemini 4 Argon用于日常调试、算法设计、研究和大规模代码迁移等工作。
谷歌举例称,Argon曾帮助量子计算研究人员优化量子算法的时空资源,在数分钟内将一项公开基线结果提升40%。另外,一组Argon Agent分析了覆盖谷歌整个服务器集群的性能分析遥测数据,自主识别并实施数据中心内存优化方案。相关方案部署后,可释放超过300TiB内存,预计总节省量将达到500TiB至1PiB。
Argon Agent还参与了谷歌内部C/C++代码向Rust的迁移,覆盖数万行的核心库代码,以及超过80万行的Fuchsia Zircon内核。考虑到相关系统的重要性,谷歌称,所有大规模重写都必须经过自动化和人工审计、仿真测试及代码审查,确认安全后才能部署到生产环境。
以开源视频解码器libgav1为例,Argon Agent通过多轮性能分析和实验,重写了约3.2万行SIMD代码,使编译器能够自动完成向量化。迁移后的Rust版本在保持视频输出完全一致的情况下,运行速度达到原Rust版本的2.7倍,性能进一步接近经过优化的C++版本。
三、强化网络安全能力,可自主发现和修复漏洞
谷歌还针对网络安全防御能力对Gemini 4 Argon进行了专项训练。Argon可以自主发现、验证并修复软件漏洞。对于经过信任认证的网络安全防御团队和谷歌内部团队,谷歌将提供不带网络安全护栏的Argon版本,以便其发挥完整的漏洞分析和防御能力。
网络安全公司Wiz已通过“Scan for Good”项目使用Argon,为关键公共基础设施免费发现和修复高风险暴露。谷歌称,在一次早期测试中,Argon发现了一个影响全球医院所使用医疗软件的严重漏洞,该漏洞可能导致敏感个人信息暴露,且此前的前沿模型没有识别出这一风险。
在评估漏洞修复能力的CWE-bench v1中,Argon以68%的成绩并列第一,得分与Grok 4.7和GPT-6 Astra相当。
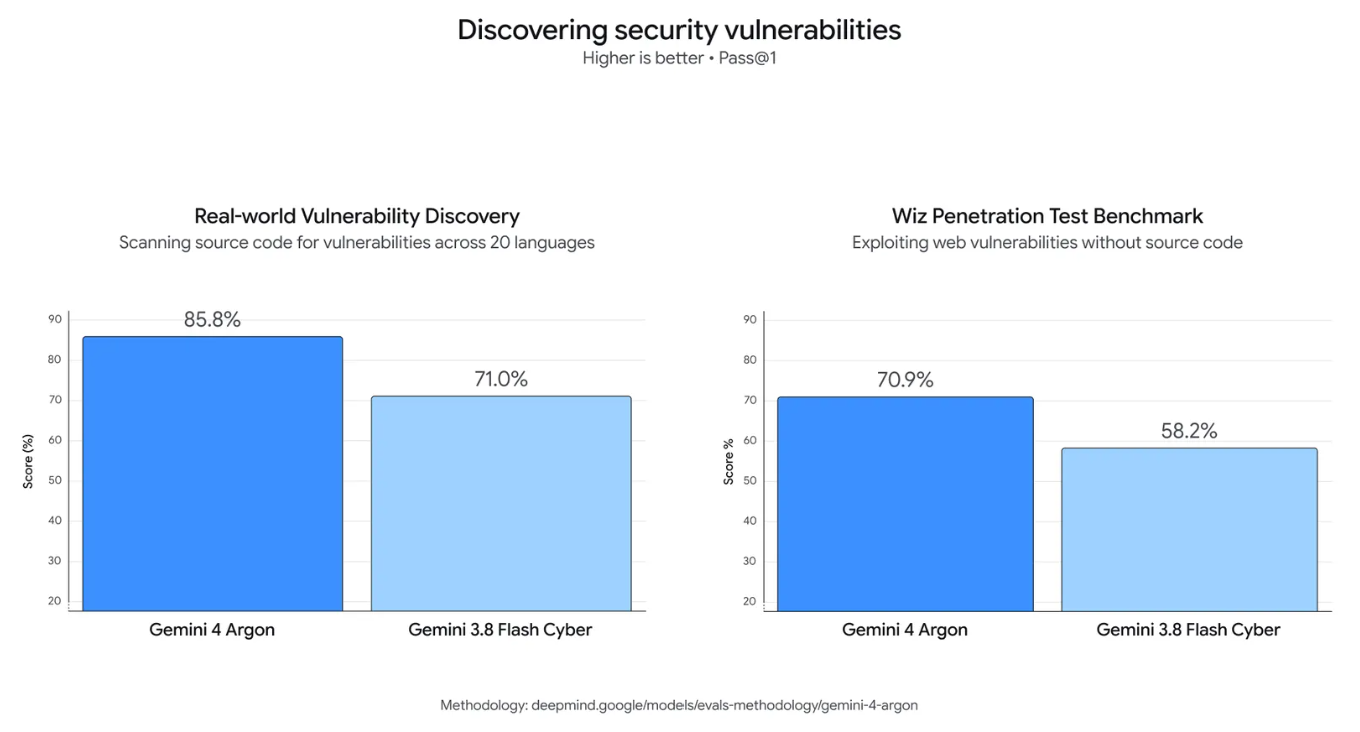
谷歌内部的综合漏洞基准测试显示,Argon可以在覆盖20种编程语言的复杂代码库中发现多类安全暴露。在Wiz的黑盒渗透测试中,Argon在识别真实网站攻击面、发现漏洞以及生成概念验证方面,也超过了此前的Gemini 3.8 Flash Cyber。
四、扩大安全测试,重点防范模型滥用与提示注入
在正式扩大开放前,谷歌将继续强化四类前沿安全能力。
防范滥用方面,Argon会拒绝可能用于网络攻击以及化学、生物、放射性和核武器攻击的有害请求,同时保留合法的双重用途科学研究能力。谷歌还在加强对模型内部激活状态的监测,以识别潜在的滥用行为。
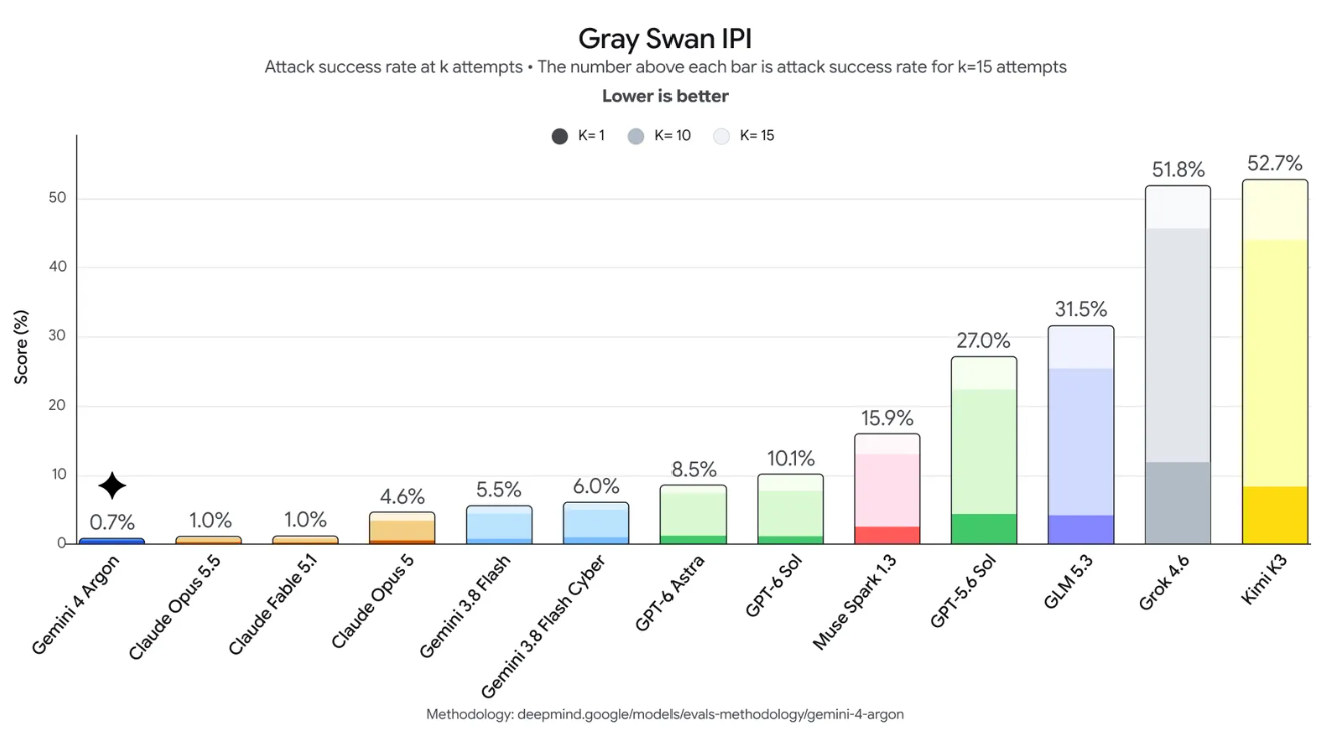
Argon在防御间接提示注入方面也取得进展。此类攻击会通过恶意指令或外部上下文劫持模型行为。经过自动化红队测试和对抗训练后,Argon在Gray Swan的间接提示注入测试中取得领先成绩。
监测目标偏离方面,为防止Argon在执行任务时越过边界、采取超出用户意图的行动,谷歌部署了目标偏离缓解机制,对Argon的思维链和行为进行监测,并在必要时停止执行。谷歌还使用类似系统监测模型训练过程,并在发现异常时向专门的事件响应团队发出警报。
强化系统环境方面,随着前沿模型的能力不断增强,安全测试也需要与模型能力相匹配的安全环境。按照Agent控制路线图,谷歌将在高风险训练或评估开始前,对沙盒环境进行隔离和封闭,以进一步强化安全性。
结语:瞄准复杂Agent任务,实际效果仍待验证
Gemini 4 Argon在长周期软件工程、金融和法律Agent任务、长视频理解及网络安全防御等测试中取得多项领先成绩,100万Token输出上限也增强了其处理大型代码库和复杂工作流的能力。
不过,当前多数成绩仍来自谷歌披露的内部案例和基准测试,模型尚未全面开放。Argon在真实使用中的稳定性、调用成本、漏洞修复可靠性及安全边界,仍需等待开发者和企业用户进一步验证。
来源:谷歌、Arena、X