
停更长达七个半月的 Gemini 旗舰模型,终于更新了。
就在刚刚,多个 Google 相关账号同步宣布:Gemini 4 Argon 正式发布。
并且,这可能是最近唯一一个写作、知识和长文本能力明显强于编程与 Agent 能力的前沿模型。
士别三日,Gemini 4 连命名方式都改变了,一眼看上去甚至像是 OpenAI 家的某个模型。官方并没有解释这个名字的由来,我们只知道这是把测试期间的内部代号沿用到了正式版。
而从字面来看,它代表第 18 号元素氩,一种惰性气体,倒是和 Chrome(铬)形成了某种有趣的对仗。
先不用急着去 Gemini App 试用——延续最近流行的“安全”叙事,Gemini 4 Argon 目前只通过 Fairwind 计划对少量网络安全合作伙伴开放。
官方也并未列出全面公开的时间点,只说明“届时首先向付费 API 用户和 Google AI Ultra 订阅者开放”,普通订阅用户还要等上一段时间。
此前在测试场里流出过据称是 Gemini 4 的模型版本,但鉴于官方从未认领、没人知道它是不是真的 Gemini 4,也不知道里面有没有掺了 Fable 和 Astra,那些所谓的比对测试结果实际上不太可信,我们暂时只能列举一下官方释出的数据(也让这篇文章的工作量少了很多)。
至少,从官方跑分来看,Gemini 4 Argon 是极其强悍的:
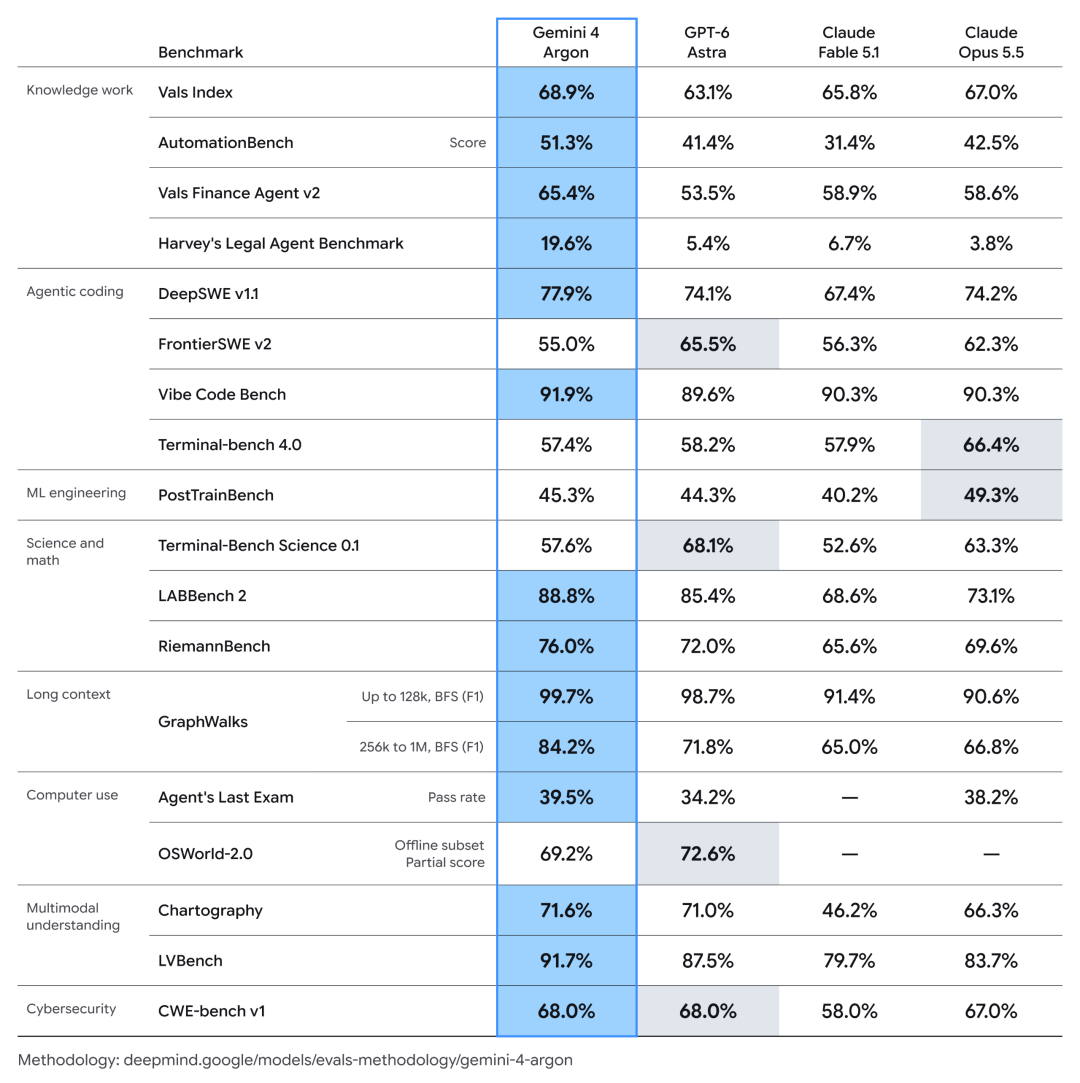
你没看错,列举出来的 18 项测试中,Gemini 4 在其中 13 项都取得了领先成绩。
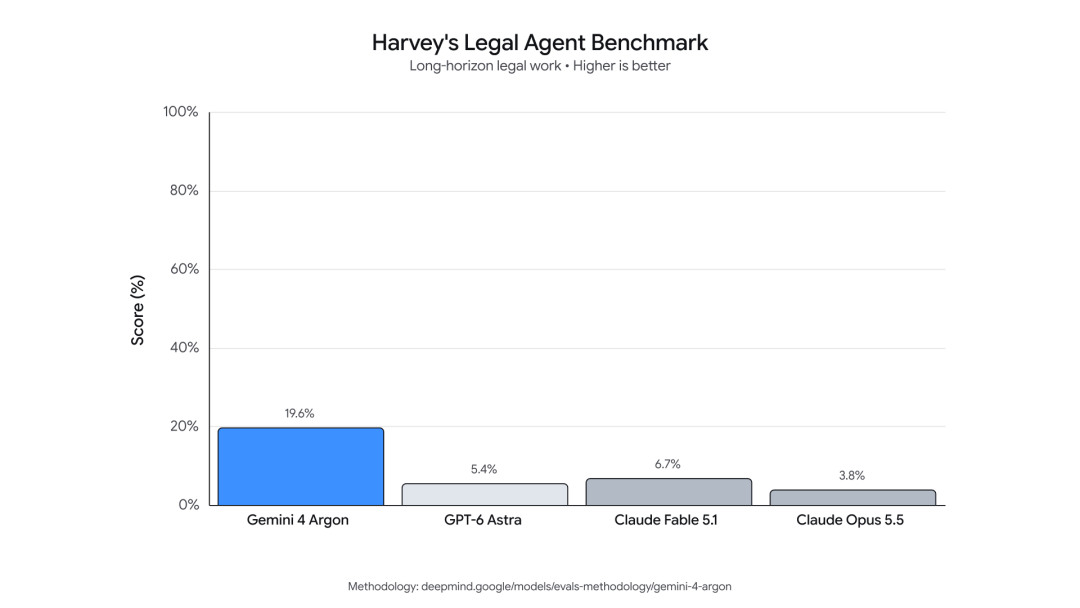
最大的领先出现在知识工作方面。在涉及真实金融分析和真实律师工作的 Vals Finance Agent v2 与 Harvey's Legal Agent Benchmark 两个测试上,甚至可以不夸张地说 Gemini 4 领先其他任何模型两档。这一点倒是不奇怪——即使在最拉的时候,也从未有人怀疑过 Gemini 的世界知识能力。
另一个 Gemini 传统优势领域是长上下文。在测试能不能用好 256k—1M 超长上下文的 GraphWalks 测试中,Gemini 4 同样领先其他旗舰模型超过 10%。
一个新特性可以解释这种领先幅度。
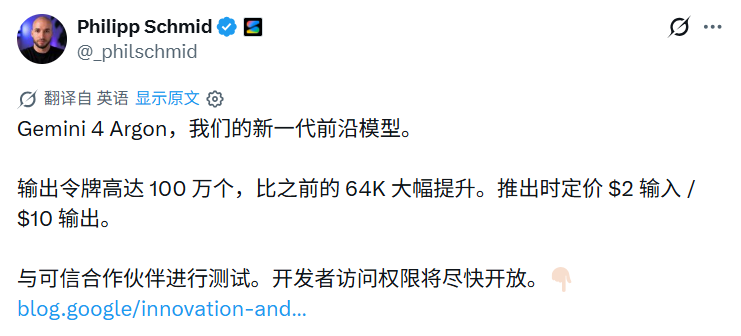
Gemini 4 Argon 将输出上限从上一代的 6.4 万 token 拉升到了 100 万 token,也就是说只要你钱包扛得住且 Gemini 足够有倾诉欲,它可以一口气输出约 70 万到 100 万个汉字,对思维链构建而言算得上是个史诗级升级。官方解释是:
当模型拥有足够的空间进行深入思考,并在单次推理轨迹中生成数十万个词元时,它将为推理带来全新的深度,从而一次性解决棘手问题。
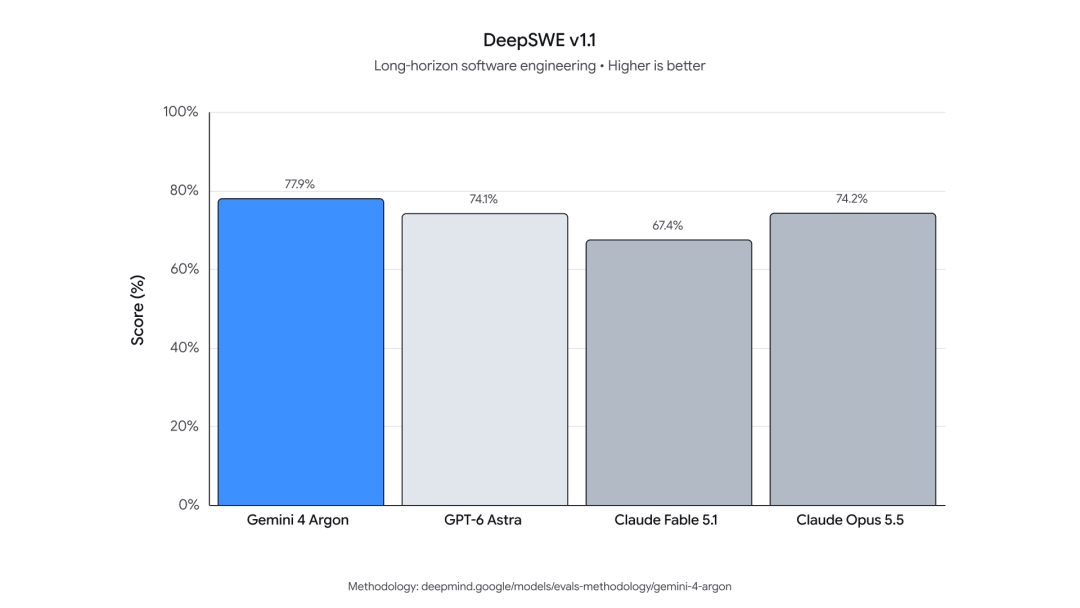
相比之下,Gemini 4 编程表现就有些起伏不定。在最常用的真实世界长周期软件构建测试 DeepSWE v1.1 上,Gemini 4 成绩达到 77.9%,领先 GPT-6 Astra 和 Claude Opus 5.5 接近 4 个百分点。
但在需要从零构建项目解决问题的 FrontierSWE v2 和操作 Linux 终端处理复杂任务 Terminal-Bench 4.0 上,Gemini 4 都处于垫底水平。
我们大概可以这样总结 Gemini 4 的特性:知识/写作\>编程\>终端。
第三方测试也可以佐证这种判断——
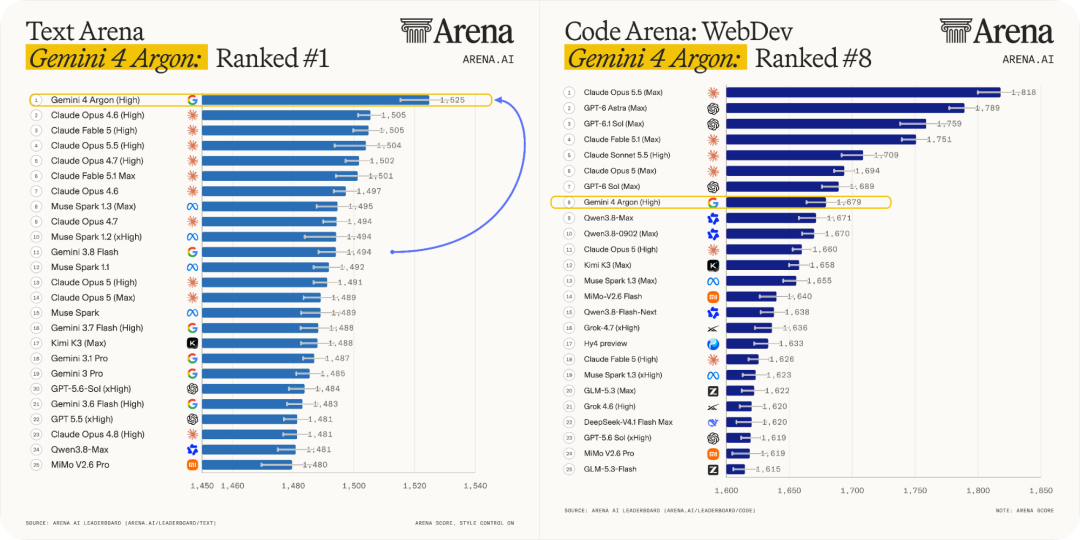
在通过盲评投票来决定成绩的 Arena.ai 评分里,Gemini 4 因为处理高难度提示词、指令遵循、创意写作等项目都取得高分,在 Text Arena 中排名第一;但回到更注重工程能力的 Code Arena: WebDev 和 Agent Arena 中,Gemini 4 就只能排到第 8。
某种意义上,一个编程能力落后的 Gemini 称得上是时代之幸。过度优化 Agent 编程能力,似乎让很多前沿模型开始变得“不说人话”,包括 GPT-5.3 时期延续至今的疯狂分行和 Opus 4.7 开始的神秘黑话问题。这种时候,一个因为编程能力一般而保留有文字审美的 Gemini 模型,可以解决很多写作上的难题。
另一个值得关注的变化是幻觉率大幅下降。
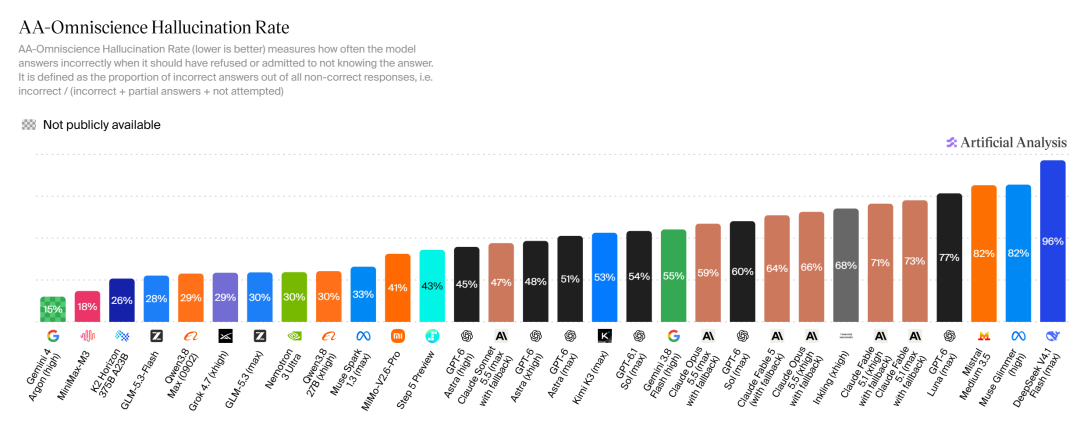
在 Artificial Analysis 的测试中,Gemini 4 的幻觉率只有 15%,在所有前沿模型中是最低的。这代表它在面对不确定的回答时,会更倾向于说“不知道”,而不是编造答案。
但对普通用户来说,最重要的问题当然是定价,而 Google 在这方面一向非常大气。
Gemini 4 Argon 的官方 API 定价是每百万 token 输入 2 美元,输出 10 美元,命中缓存的价格是 5% 亦即 0.1 美元。
官方公告表示首发优惠期结束之后价格会翻倍,但根据经验,大概率在下一代模型出来之前优惠都不会结束。
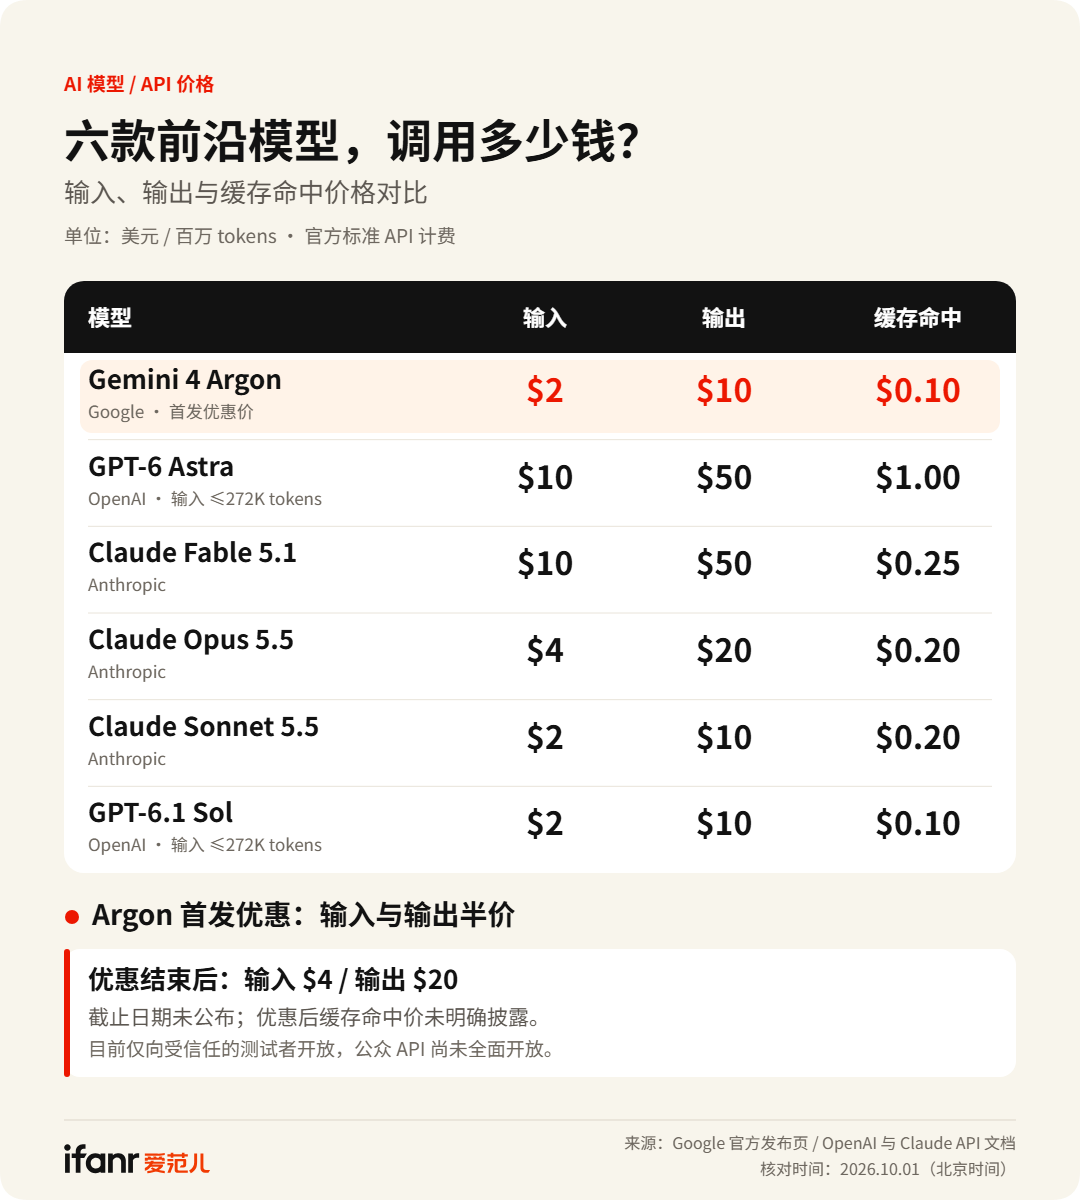
以优惠期价格来算,Gemini 4 的价格是 GPT-6 Astra 和 Fable 5.1 的五分之一,大致上持平 GPT-6.1 Sol 和 Sonnet 5.5。
换句话说,只要能力没有虚假宣传,Gemini 4 就是当前“智价比”最高的模型,用中端模型的价格就能让你用上旗舰的智能。
Gemini 4 Argon 的发布也终结了一个尴尬的纪录:在过去近半年的时间里,Google AI Pro 套餐的权益描述是“获享 Gemini 3 Pro 模型”……考虑到 3.5 Flash 时代之后连 Flash 模型都能暴打 Pro,这个会员套餐更显得相当幽默,很大程度上人们买会员只是为了那个 5T 的 Google Drive。
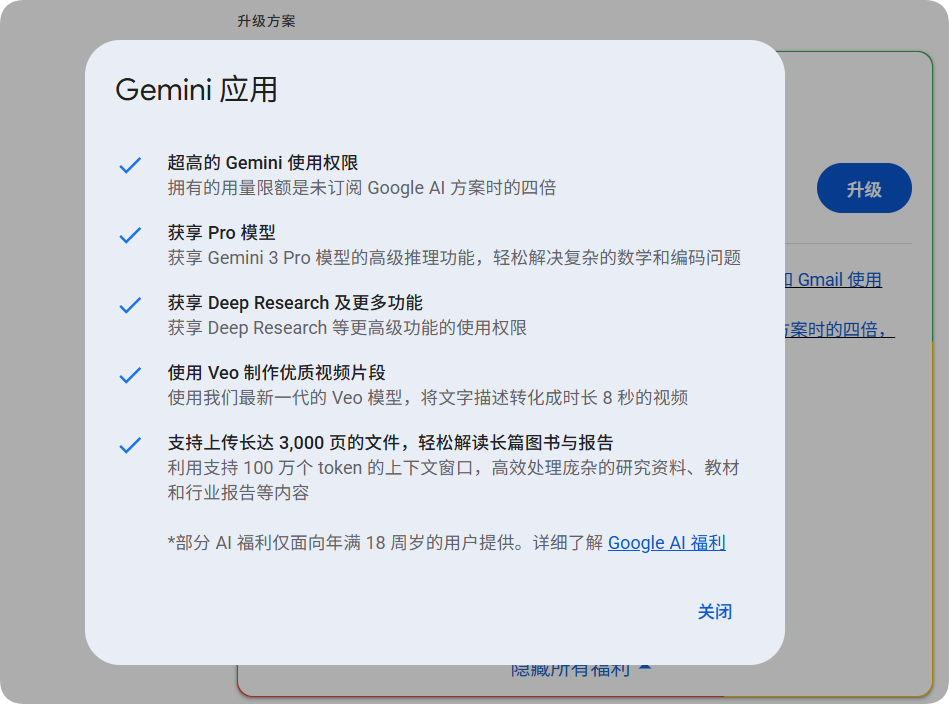
至少现在,Google 终于可以光明正大地宣传自己的会员了。
写到这里,我也想说几句题外话。
每个人心里都有自己的白月光,而我在 AI 领域的白月光就是 Gemini 2.5 Pro。去年年初,2.5 Pro 文字能力的确是惊为天人,也正是在那之后,我才正式把 AI 加入了自己的工作流程之中。后来看见 Gemini 3 发布,我更是第一时间转发到朋友圈。
从这个意义上说,没有人比我更希望 Gemini 4 能支棱起来。
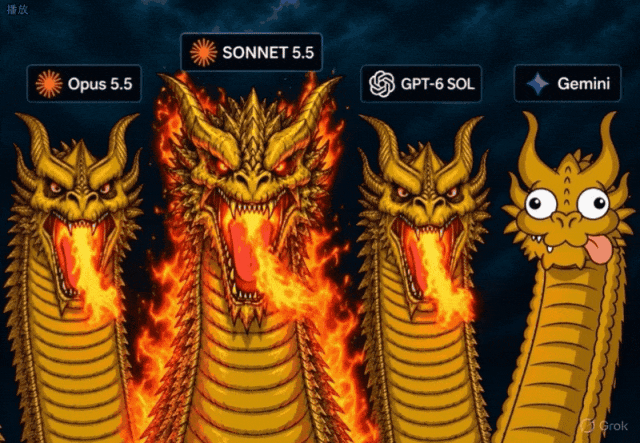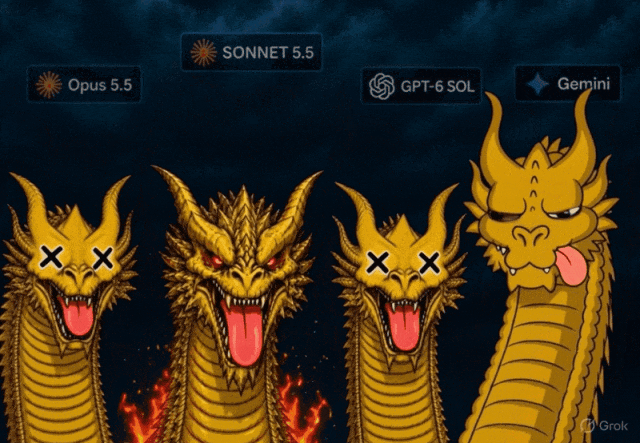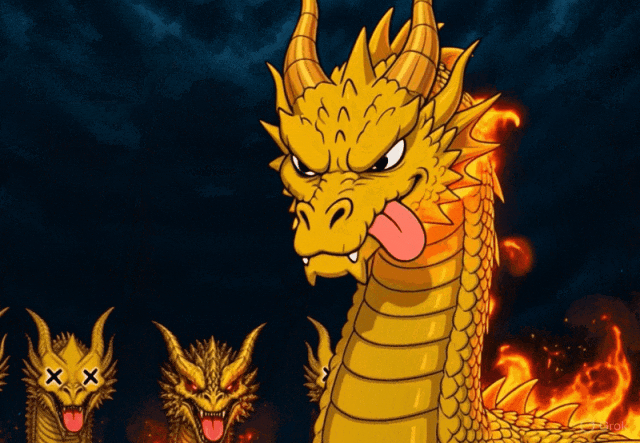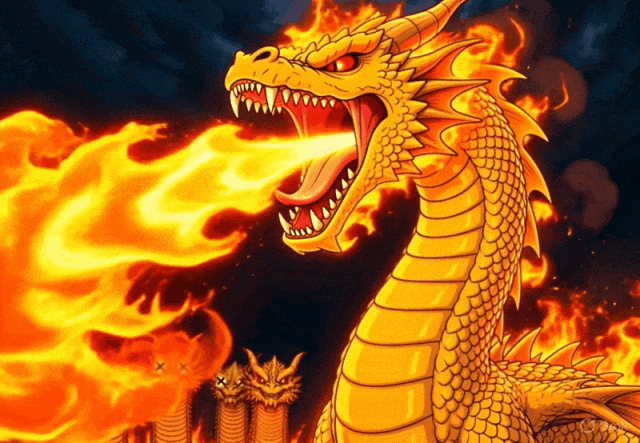
本 Gemini 粉丝的幻想
但我们还是要尊重客观规律。像很多人评论的,大模型归根结底是一种制造业,像手机和芯片一样的制造业。我们不能期待一个长久没有更新的模型,突然就力压群雄,这跟一个长期停留在 10nm 的芯片厂突然拿出了 2nm 芯片一样不现实。
Gemini 3.8 Flash 跑分和实测效果的巨大落差,也表明这段时间 Google 为了掩饰尴尬,有可能做了一些跑分刷榜的“特殊优化”。同理,Gemini 4 在大多数基准测试中达到 SOTA 水平也是相当可疑的——
几乎就在 Gemini 4 公布的同时,彭博社也发出报道称,Google 内部员工对 Gemini 4 的实际性能持怀疑态度。他们援引的“知情人士”表示,Gemini 4 在真实任务中的效果不尽如人意,“难以处理某些编码任务”。
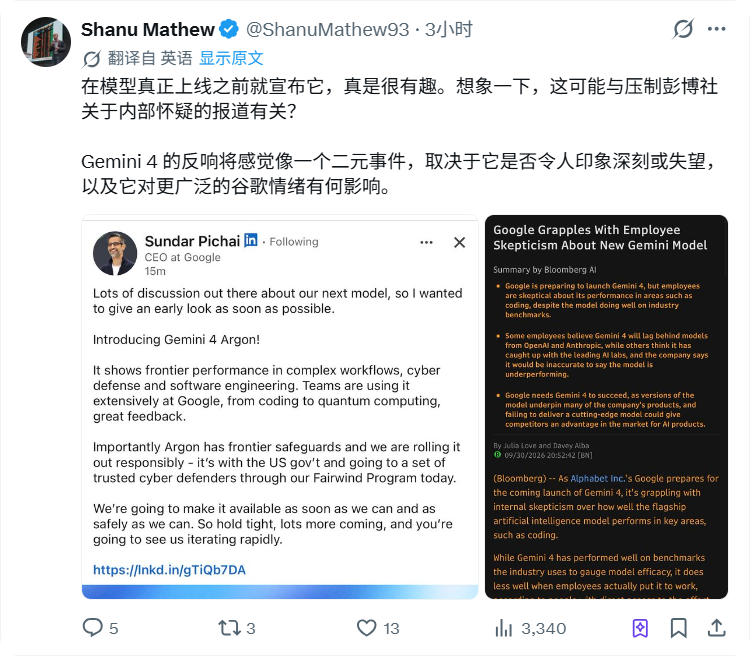
虽然 Google 方面迅速反驳,也有一些员工表示 Gemini 4 很不错,但我们大概可以相信,最终来到我们面前的 Gemini 4 不会像跑分里那么强。更何况等待 Gemini 4 实装这段时间,又足够 ChatGPT 和 Claude 模型迭代一个版本了。
不管怎么说,往好的方面想,Gemini 4 Argon 的发布毕竟代表 Google 终于回到了赛场上。
它的上限未必很高,下限还是可以保证。之后要做的事,就是用大模型制造业的方法,一步一步地赶上来。
作者|彭海星
