OpenAI最近真是频频往数学界扔重磅炸弹。
上个月,OpenAI宣布其AI模型仅用88小时,便攻克了困扰人类百年的千禧年七大顶级数学难题之一——N-S方程;昨天,又放出722篇数学手稿,千禧难题又有仨。
但在UniPat AI发布的PaperBenchX测评中,面对93个真实论文复现任务,表现最强的GPT-6 Astra,完整复现率却只有13.98%。
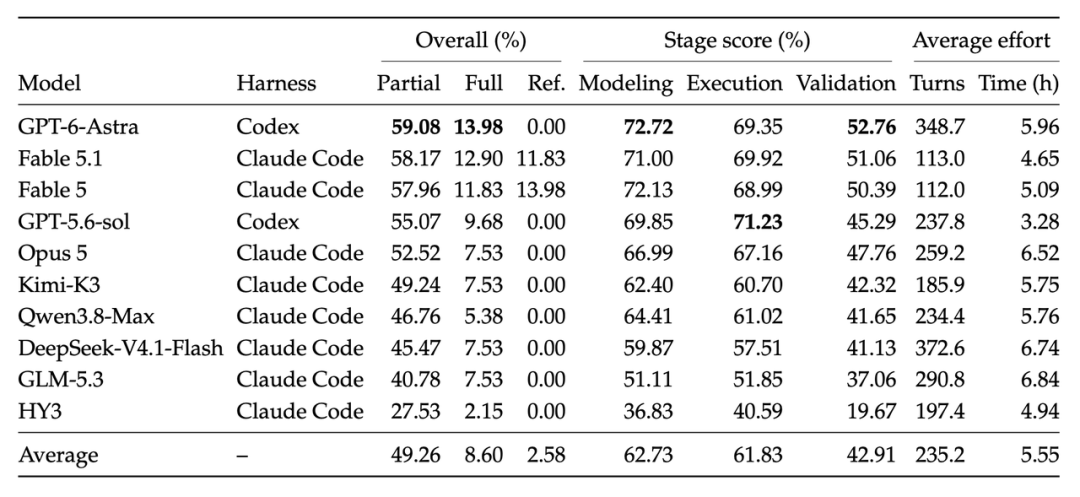
△10组受测配置在93个复现任务上总体与分阶段表现
随橙想!当前模型已经能取得破解千禧年数学难题这样的伟大突破,但很少能完成一次可靠的端到端科学复现。
(正经脸)这引发了一些思考:在广泛的AI for Science领域中,我们要以什么标准判断“做对了科学”?本着严谨踏实的科研态度,迈向AI数学家乃至General AI Scientist的第一步到底是什么?我们又该如何形成一套可验证、可比较的标准,真正衡量AI在科学研究上的进步?
该用什么尺子衡量AI在科学里的进步?
此时此刻,让我们再细品陶哲轩、邓煜等25位菲尔兹奖得主联名发布的公开信。
他们肯定了大语言模型的数学能力急剧提升,已经能解决数学领域的重大难题,但也提出了更关键的问题:AI公司把解决数学问题当作基准测试,这对数学这门科学、对数学共同体都是有害的。
所以,这不是一封反对AI的信,它问的是一个更朴素的问题:衡量AI在科学里的进步,到底该用什么尺子?
信里还有一句分量更重的话:把解决数学问题当作基准测试的错位问题,只是更广泛的错位问题的一部分,这种错位同样影响着其他科学与创意职业,乃至整个社会。
的确,上面提出的问题从数学领域扩展到自然科学乃至社会领域,只会更难回答。
数学至少还有最后一道防线:Lean。证明对不对,机器可以逐步检查,答案的真假有兜底。
可放到其他科学领域里,一个电磁仿真的反射系数、一条能带、一个收敛后的带隙,都没有Lean。一个和论文对得上的数字,背后可能是错误的物理模型、没收敛的仿真,或者碰巧凑出合理值的无效后处理。
所以,在衡量AI自主提出问题、设计实验、做出新发现的General AI Scientist能力之前,有一个更基础的问题:它能不能可靠地把一项已经发表的科学工作重做一遍,并证明自己做对了?
这个问题的逻辑在于,由于复现有唯一正确的答案,因此可以被准确评估。
UniPat AI最近发布的一项工作“PaperBenchX”,瞄准的正是这件事——它从93篇研究论文中构建了93个复现任务,这些任务横跨电磁、光子、化学、材料、生物、机器人等12个研究方向和10种领域原生科学环境,含3168条专家校验的评分项,是国际上第一个多学科端到端论文结果复现的Benchmark。
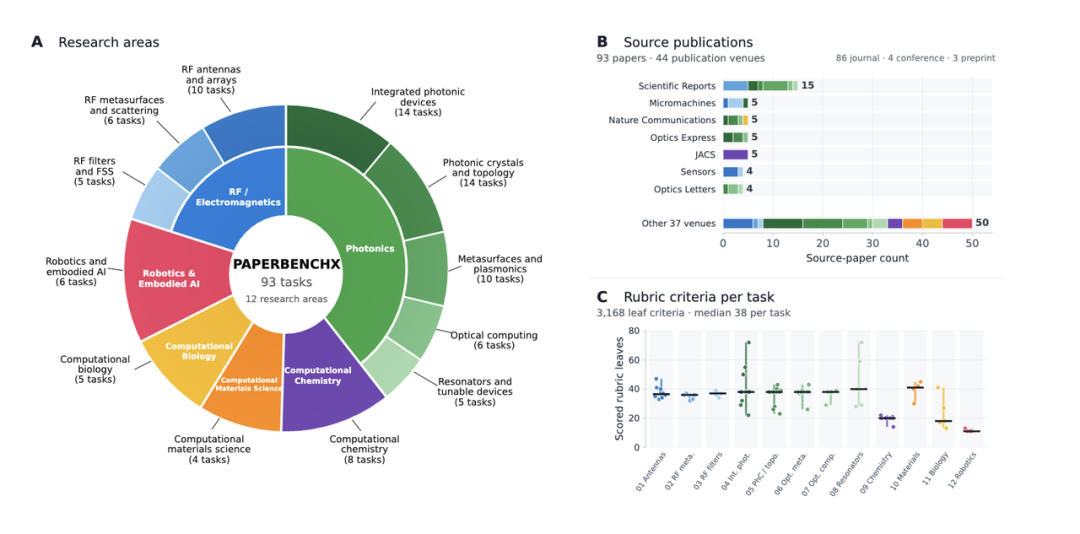
△PaperBenchX 的任务分布、来源论文与评分项构成
PaperBenchX的考试规则很简单:
Agent拿到一篇真实论文、一个装好了对应科学软件的容器化环境、以及一份说明“要复现哪部分”的任务书;
Agent交回一份可执行的复现工作流;
评分标准、容差、参考答案全部对Agent隐藏。
需要特别注意的一点是,论文本身是公开的,Agent当然能看到论文里的结果数字,但很明显的是,这场考试考的不是“猜答案”,而是考验AI能不能重建一条科学上成立的流程,并自己跑出支撑那个结论的证据。
所以,PaperBenchX测的到底是什么?
答案是:不测“得到了多少数字”,只认重新生成的证据。Agent交卷后,系统删掉全部输出、断开网络,在隔离环境里把工作流从头重跑一遍,评分器只相信重放产物。可以说,在某种意义上,就是为科学仿真搭的一道“Lean”。
测得结果怎么样?
结果是:在93个论文复现任务里,表现最强的GPT-6 Astra,完整复现率只有13.98%。
这意味着,模型能够在不少任务中产出看起来合理的结果,但真正从头跑通完整工作流、生成与论文一致且可验证的证据,成功率还不到七分之一。
这就是今天的AI与能够跨越不同领域科学边界的General AI Scientist之间的距离。
PaperBenchX的意义在于第一次把这段距离量了出来。
目前,UniPat AI团队从每个研究方向中选取1个代表性任务,共开源12个测试任务。这些任务覆盖不同研究方向和科学软件栈,可用于评测Agent、调试复现工作流,以及研究模型在真实科学环境中的端到端复现能力。